AgentVQA 用一千題測視覺代理:最高 58.5%,為什麼會推理仍可能按錯按鈕?
AgentVQA 將23個資料來源的一千個代理情境整理成五領域離線評測。本文解析最高58.5%正確率、視覺定位失誤、與線上排名的相關性,以及用來挑模型時的限制。

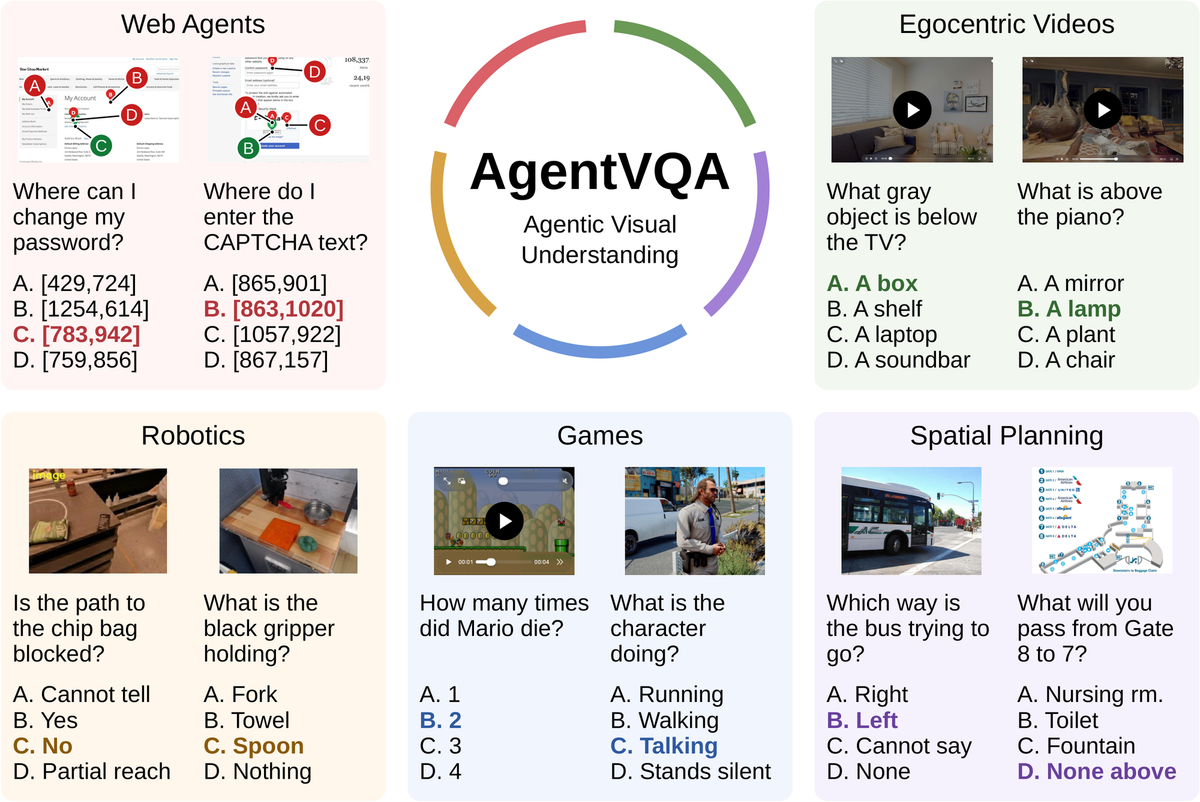
AI 代理知道你想刪除帳號,仍可能點錯畫面上的按鈕。AgentVQA 想測的正是這種落差:問題有時不在任務理解,而是沒有看準當下狀態。
要找出這類失敗,逐一跑真實網站、機器人和遊戲很花時間,也不容易讓所有模型遇到相同畫面。
研究者在 2026 年 10 月公開 AgentVQA,把一千個人工核對的代理情境整理成可離線比較的視覺問題。
評測涵蓋五個領域,作者測試的最佳整體正確率為 58.5%,卻沒有同一個模型在所有領域都領先。
我的判斷是,它適合幫團隊先找出視覺弱點,再決定哪些模型值得跑互動測試,不能直接把離線分數當任務完成率。
先看這些題目怎麼從真實代理工作轉成選擇題,才能理解分數能回答什麼。
AgentVQA 怎麼把真實代理工作變成可離線比較的題目?
它從二十三個來源挑出一千個困難情境,將當下畫面與任務轉成可核對答案的問題。模型看到觀察與選項後作答,研究者不用每次都重新開啟完整互動環境。
這和讓代理真正完成工作不同。真正刪除帳號可能要經過登入、選單、確認與狀態變更,離線問題則把其中一個需要看懂畫面的決策抽出來,檢查模型是否知道當下該選什麼。
這樣做的好處,是不同模型可以面對相同條件。網站不會剛好換了版面,機器人也不會因前一次操作改變物件位置,比較時比較容易知道差異來自哪個回答。
它也降低測試準備成本。互動評測需要架設環境、處理失敗與重跑,離線題目則能先讓團隊快速檢查一批模型,找出值得投入下一階段的候選。
但選項本身也提供資訊。模型只要從現有答案中挑選,不必真的產生完整操作,也沒有經歷自己按錯後的環境回饋,所以分數不能直接當成整段任務的完成率。
五個領域又需要不同觀察。網頁任務要找到介面元素,影片需要看懂動作變化,空間規劃則可能得把不同視角接起來,不能只用一般圖片問答代表全部能力。
作者把這些情境放進共同基準,目的是補上現有評測分散的缺口。它沒有把所有代理能力壓成一種真實工作,而是讓不同視覺弱點可以在同一份材料裡被看到。
把工作改成選擇題省掉互動成本,也讓題目品質直接影響結論。
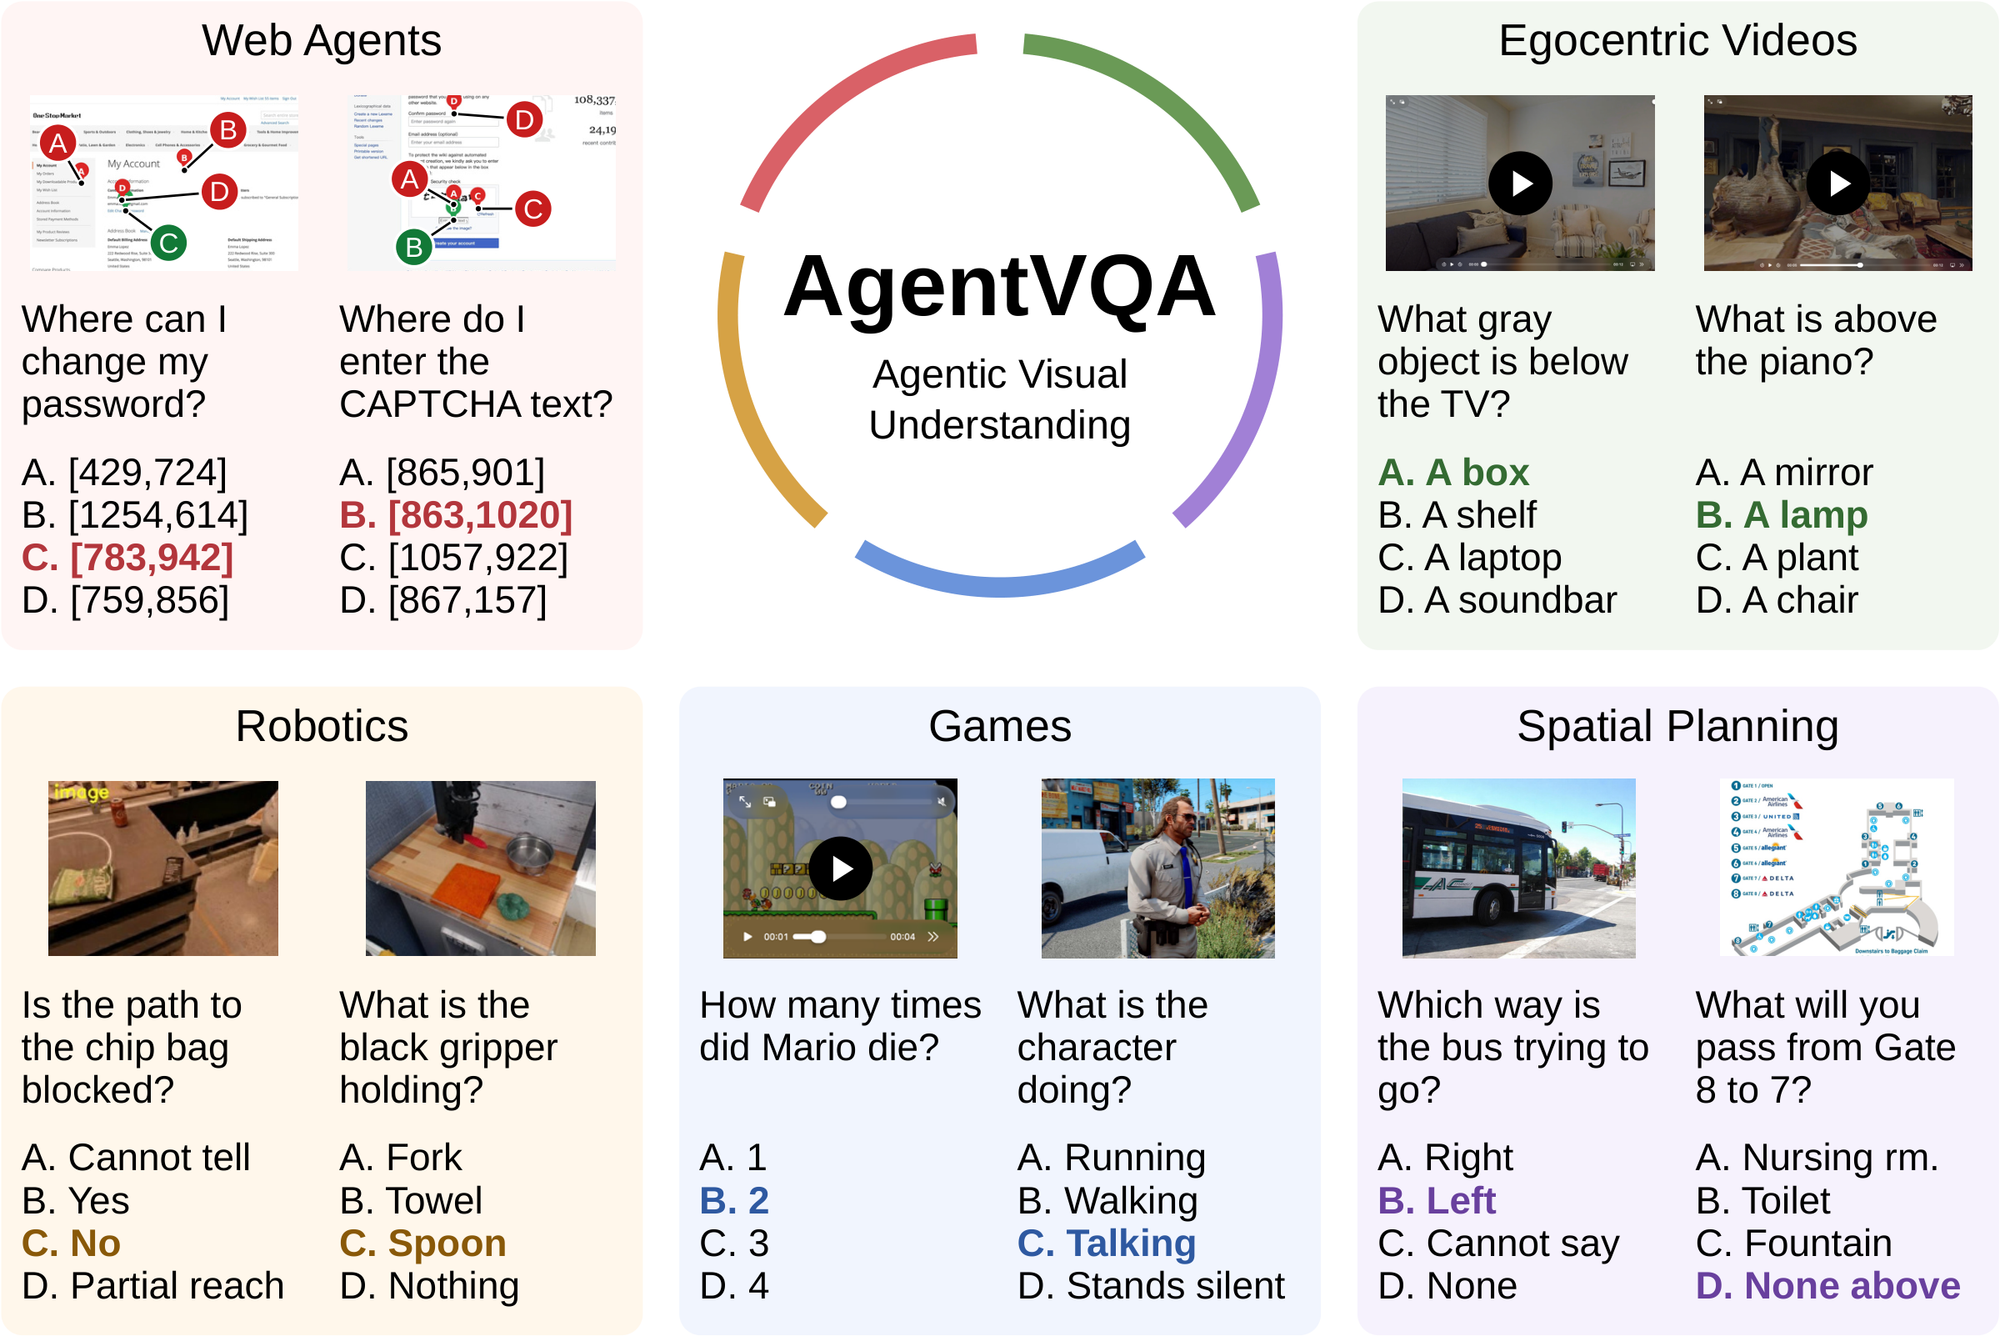
只留下百分之二十二候選題,人工核對在修什麼?
研究逐步篩除太容易、不清楚或有多個合理答案的問題,要求保留題有單一明確正解。最後留下初始候選的約百分之二十二,並不是把全部來源題目原封不動搬過來。
第一步把來源情境轉成選擇題,需要安排題目與干擾選項。干擾選項是看似可能、但不符合要求的答案,若它們太容易排除,就測不到原本困難的視覺判斷。
模型篩選可以協助找出候選,但人工仍要檢查畫面、答案與題意是否一致。否則,答案格式雖然整齊,模型實際上可能是因題目錯誤而被判失敗。
官方舉出剪刀框選的例子。若正確範圍的框包含背景,點到框內空白處也可能被原始規則接受,但那不代表代理真的找到剪刀,評測就會高估視覺定位能力。
另一個例子是刪除應用帳號。先點應用圖示和先打開所有應用清單,都可能走向目標。如果題目沒有要求最短路線,就不能只因第二條路多一步而把它判錯。
這類問題需要移除或修正,才能保留單一明確答案。人工核對的價值不只是校對文字,而是確認模型被要求解決的問題,和評分規則真的相同。
但嚴格篩選也會形成特定測試分布。它刻意保留較困難的情境,因此最高分低,不代表一般使用者每天所有畫面都同樣難,也不應當成整體產品失敗率。
題目條件固定後,模型表現仍會隨任務領域出現不同排序。
最高 58.5% 為什麼不等於每個領域都最好?
整體平均把網頁、機器人、第一人稱影片、遊戲與空間規劃放在一起,領域強弱可能被平均掩蓋。作者測試二十二個模型設定,沒有同一個模型在全部五個領域都領先。
主表的最佳整體正確率是 Gemini 3.7 Flash 的 58.5%,Qwen3.8 27B 為 50.9%,差七點六個百分點。這能描述這一份題目的整體差距,卻不能直接推論所有應用都應選前者。
如果團隊只做網頁操作,就應再看網頁欄位。某個模型可能在空間題很強,平均分因此較高,但對真正要用的畫面定位未必有同樣優勢,選擇順序可能改變。
第一人稱影片也有自己的要求。模型得理解使用者視角下的動作和狀態變化,而不是只辨認單張圖裡有什麼物件。這和遊戲畫面需要的線索又不完全相同。
機器人情境則可能需要讀懂距離、相對位置與可操作對象。整體平均沒有直接告訴你,它是否能在特定相機角度、夾爪和物件組合下作出可靠判斷。
這不表示總分沒有用途。它能先提供跨領域概況,但進入採用決策後,還要沿著實際工作縮小範圍,避免把別的領域優勢算進自己的預期收益。
同時,這些分數都是研究報告的結果,本文沒有重新執行二十二個設定。真正部署使用的模型版本、圖片處理和推理選項,仍需要與測試條件核對。
選對應用領域之外,還要確認離線題目和真正互動表現有多少關係。
和線上評測的高度相關,支持到哪一種用途?
在十二個共同模型的空間規劃比較中,排名高度相關,支持把這部分用作較便宜的初篩。共同模型指兩份評測都測過的對象,不是主榜全部二十二個設定。
作者把 AgentVQA 的空間規劃結果,和 SpatialWorld 的實際互動評測比較,得到 Spearman 排名相關係數 0.895。這個指標越接近一,代表兩邊把模型排出的順序越相近。
這個數字描述排名順序,和任務成功率或逐題答案是否相同是不同量測。兩個測試可以把模型大致排成類似順序,卻仍測量不同工作和不同錯誤。
這種關係對模型篩選有用。若離線較弱的模型,在相近的互動領域也往往較弱,團隊就可以先用較便宜的測試縮小候選,再把時間花在剩下的對象。
不過,這個證據來自匹配的空間領域,不能直接延伸成所有網頁或機器人任務都不必再跑。工具權限、執行錯誤與多步恢復,也沒有全部包含在選擇題裡。
研究還和一般推理基準比較排名,相關程度沒有同樣高。這提醒開發者,一個模型很會回答學科問題,不代表它也很會在介面上找到下一步。
一般基準的比較使用十個共同模型,得到的排名相關係數分別是 MMMU-Pro 的 0.67、GPQA-Diamond 的 0.59,以及 ChartQA-Pro 的 0.44。這些對照不是和線上空間比較相同的十二模型集合,不能把差距全當成題型本身造成。
這份結果仍有採用上的意義:原本以學科或圖表成績挑模型的團隊,可以多看一份接近代理情境的材料。但它提供的是另一個觀察面向,而不是宣布原來所有基準都沒有價值。
相關性沒有涵蓋所有任務,因此還要回到錯誤本身判斷缺了什麼能力。
按錯位置、看錯動作和空間關係,哪一種問題最多?
錯誤分析指出視覺定位與狀態理解是主要瓶頸,但各比例只描述受分析的錯誤樣本。這部分不能和主榜正確率放在一起,當成同一個分母的數字。
作者抽樣 Gemini 3.1 Pro 的錯誤回答,盡量涵蓋不同來源,再由模型輔助分類、人工核對。因此,結果說明的是這批錯誤通常怎麼發生,並非全部模型共享同一種失敗比例。
網頁領域中,定位相關錯誤占分析錯誤的百分之七十八。定位是把語言裡的對象對到畫面上的實際位置,例如知道要找設定,卻沒有正確指出哪個按鈕是設定。
第一人稱影片則常見動作誤判。模型可能認出畫面中的物件,卻沒讀懂它如何移動,或沒有掌握前後發生什麼變化,單張圖片辨識能力就不夠用了。
機器人與空間規劃也暴露不同缺口。一種是混淆物件之間的空間關係,另一種是從目前視角推想別的視角時出錯,這些都可能讓後續推理建立在錯誤位置上。
遊戲領域裡,視覺誤解占受分析錯誤的百分之七十一,也提醒人們,讀懂規則和讀準當前畫面仍是兩回事。即使後續推理流程合理,最初看錯狀態也可能把整條判斷帶向另一個答案。
這使改善方向更具體。如果主要問題是找錯位置,一味增加長篇文字推理未必能補救。若缺少的是狀態變化,額外提供先前動作可能比較有幫助。
知道錯在哪裡後,多給思考時間或補動作歷史才有可檢驗的改善方向。
增加思考和動作歷史,為什麼不一定讓所有模型進步?
歷史能提供畫面以外的狀態線索,更多推理的收益卻依模型而異,甚至可能出現思考循環。思考循環是反覆走相近的推理,沒有持續增加可用資訊。
同一張畫面不一定能看出剛才發生什麼。若先前已經按過某個選單,下一步就應考慮那次操作帶來的狀態,而不是每次都把目前圖片當成全新任務。
作者在 AitW 與 MONDAY 的五個模型比較中發現,提供動作歷史能改善決策。這支持保留相關過程的價值,但沒有證明把所有舊對話都塞進去就一定更好。
增加推理則有更明顯差異。GPT-5.6-sol 從未加長推理的 38.2% 提高到較高設定的 55.0%,但 GLM-4.1V 的思考版反而略低於基礎版。
因此,同樣標成思考模式,不能推定每個模型都獲益。開發者需要看改善是否出現在自己的領域,再考慮等待時間和資源,而不是只勾選最長推理就結束評估。
還要避免把資訊補充和推理增加混在一起。前者可能讓模型看到原本缺少的狀態,後者主要給它更多處理機會,兩者解決的問題不同,也應分開比較。
這讓模型選擇需要同時看領域、輸入條件和推理設定。
開發團隊怎麼用這份基準挑模型,又避免誤讀?
可以先在相符領域比較正確率與錯誤類型,再用保留的真實互動任務確認是否能完成工作。離線初篩的目的,是減少無效測試,不是把後面的執行問題直接省略。
例如介面代理若在定位題頻繁失敗,後續應檢查自己的圖片解析度、目標大小和狀態資訊,確認弱點是否也出現在實際畫面。這比只記一個總分更容易找到可以改善的位置。
如果團隊依同一份測試反覆挑模型和調提示,最後還需要另一批未參與調整的情境。否則模型可能只是更適應這些題目,不能說真正改善了新工作。
我會把 AgentVQA 當成共同起點,再用實際任務驗證它指出的弱點。如果離線結果能預先指出互動測試會遇到的失敗,它才真正替團隊省下篩選成本。
延伸閱讀:OpenVLHarness 視覺代理框架:不重訓模型,工具與多模態記憶能改善哪些看圖工作?
延伸閱讀:Meta-Video 發現評測設定可差 19.5 個百分點:AI 看影片榜單該怎麼比?
AgentVQA 常見問題
AgentVQA 的 58.5% 是代理任務完成率嗎?
這是指定離線題目的正確率,並未包含全部互動操作、狀態變更與失敗恢復。
排名相關 0.895 代表所有領域都能取代線上測試嗎?
該比較來自十二個共同模型的匹配空間規劃領域,不涵蓋全部五個領域。
給模型更多思考時間一定更好嗎?
研究中的效果依模型而異,部分設定提高正確率,也有思考版本略降的結果。