AI 音樂 × AI 影片 2026 全景:從《過來人》看一個人怎麼做出 1.24 億播放的 MV,成本、工具、版權一次拆解
以喆FILM《過來人》為例,整理 2026 年 AI 音樂與 AI 影片的工具版圖、一支 AI MV 的完整工序、成本試算,以及版權與平台標示規則。

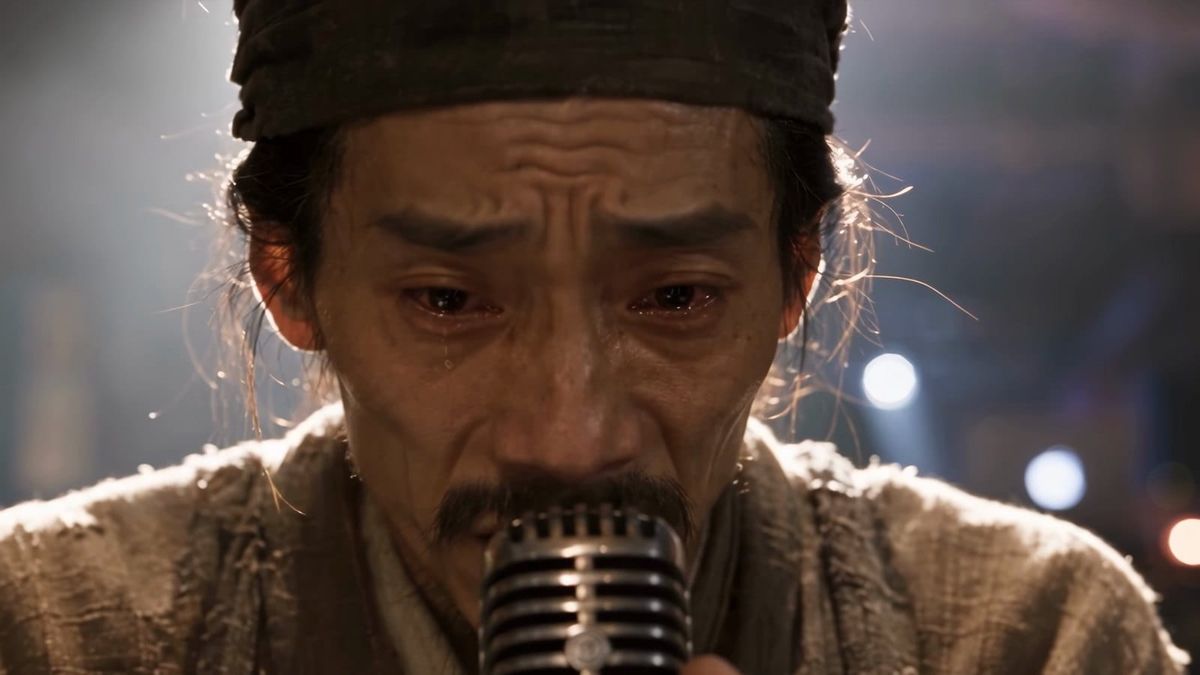
10 月 13 日,武漢 90 後創作者喆FILM(王琨喆)發出 AI 音樂 MV《過來人》:十位古人在現代酒吧裡輪流開麥。依紅星新聞,截至 10 月 22 日 21 時,全網累計播放約 1.24 億次;他說自己是一個人、一台電腦,集中做了三四天,成本大約幾千元(報導沒有標示幣別)。
這個案例值得拆,不只因為數字大,而是它剛好站在 2026 年 AI 創作的交叉口:AI 音樂和 AI 影片這兩條線,都已經好用到「一個人做得出一支 MV」,同時也都被官司、版權和平台標示規則卡著。這篇用《過來人》當主線,整理五件事:AI 音樂與 AI 影片的工具版圖、一支 AI MV 的完整工序、成本大概多少、做完能不能發,以及怎麼標示。
先說結論(這是 AI郵報的整理,不是創作者的說法):生成已經便宜到可以重拍十次;真正稀缺的是兩件事,一是決定「留哪一句、留哪一鏡」的人,二是能說清楚「這支作品哪些部分是人做的」的紀錄。
《過來人》是什麼?一個人、三四天、1.24 億次播放
《过来人 The OGs》是喆FILM「古人開麥」系列的最新一支。系列之前是兩兩對戰的 freestyle battle(例如李清照對蘇軾),這次改成杜甫、蘇軾、劉邦、項羽、勾踐、孫悟空、曹操、李白、諸葛亮、司馬懿十個人輪流開口、最後合唱。依報導,三段主歌分別給杜甫、蘇軾、劉邦,代表三種人生境遇;之後其他人物一人一兩句接力,節奏加快,進入群像大合唱。
影片:喆FILM_Official 官方頻道《过来人 The OGs》,本文只以嵌入方式引用,版權屬於作者。
| 指標 | 數字 | 時間與來源 |
|---|---|---|
| 全網累計播放 | 約 1.24 億次 | 截至 10/22 21:00;紅星新聞(新浪科技轉載) |
| 抖音/視頻號播放 | 7,500 萬以上/4,500 萬以上 | 新京報專訪稿(採訪日 10/22) |
| 製作 | 一個人、一台電腦,集中約 3 到 4 天;成本數千元 | 新京報、紅星新聞(創作者自述,未標幣別) |
| YouTube 官方版 | 約 15.2 萬次觀看 | 10/23 查看 |
這些是報導與平台公開的數字,各平台口徑不同,而且還在增加,AI郵報沒有核對過後台。更完整的案例細節(為什麼杜甫第一個開口、聽眾是誰)放在後面的工序章節裡。
2026 年的 AI 音樂走到哪了?工具、授權與官司
先看工具版圖。下表只列這篇會用到的幾個,日期與說法都來自公開報導;《過來人》用了哪個音樂工具,創作者沒有公開,所以不要把它對應到任何一個:
| 工具 | 近況(查詢日 10/23) | 授權狀態 |
|---|---|---|
| Suno | 9 月 9 日推出 V6;據報導新模型家族以 Warner、BMG、Believe 授權的曲庫訓練 | Warner 已和解並授權(2025 年 11 月);UMG 與 Sony 仍在訴訟,9 月又提出新訴訟 |
| Udio | 2025 年 10 月與 UMG、11 月與 Warner 和解,宣布要做「授權、封閉」的新平台,原訂 2026 年上線 | 和解轉授權;我沒有找到正式上線的確認,現行服務仍在改版 |
| ElevenLabs Eleven Music | 2025 年 8 月推出,與 Merlin、Kobalt 合作;官方稱輸出已清除廣泛商用 | 主打「先授權再訓練」;Kobalt 說藝人要自願加入並分潤 |
| Google Lyria 3 | 2026 年 2 月 18 日進入 Gemini app(beta):文字或圖片生成歌曲,附歌詞與封面,每首含 SynthID 浮水印;也進 YouTube Dream Track | TechCrunch 的報導沒有 Google 對訓練資料授權的說明;Google 說這不是用來模仿特定藝人 |
這張表看得出兩個趨勢,是 AI郵報的整理:
- 從官司走向授權。三大唱片公司裡,Warner 已經分別和 Suno、Udio 和解並授權,UMG 也和 Udio 和解;UMG 與 Sony 對 Suno 的訴訟還在波士頓聯邦法院進行。依報導,兩家在 9 月提出新訴訟,主張 Suno 開發 V6 時用了舊模型的輸出與使用者互動,涉及超過 6 萬首錄音,並指控繞過技術保護從 YouTube 取得音樂;Suno 的立場是訓練可以構成合理使用,授權合作是新產品的商業協議,不是承認先前需要授權。這個案子的關鍵動議,據訴訟追蹤整理要到 2027 年才會處理(未經法院文件確認),所以今年內不太可能有結論。
- 數量暴增,把關轉向偵測與標示。Deezer 在 7 月 21 日的新聞稿說,6 月高峰時,AI 生成曲目超過每日新上傳音樂的一半(約每日 9 萬首);但 AI 曲目只占平台串流的 1% 到 3%,2025 年全 AI 曲目的串流中,最高 85% 被判定為詐欺。Deezer 從 2026 年 6 月起明確標示 AI 音樂、從演算法推薦中移除,並下架用於串流詐欺或 6 個月沒人聽的 AI 曲目。
對做 MV 的人來說,這代表選工具時多了一個問題:這個模型的訓練資料有沒有授權說明?沒有授權說明的工具不是不能用,但風險由你自己承擔;而且就算工具有授權,也不等於你的成品自動擁有著作權(後面「版權」一節再談)。
2026 年的 AI 影片:模型各自擅長什麼?
AI 影片這一年的變化是「單鏡頭變長、參考素材變多」。下面是和 MV 製作最相關的幾個(規格來自報導與廠商說法,實際可用範圍以各平台為準):
| 模型 | 近況 | 對做 MV 的意義(AI郵報整理) |
|---|---|---|
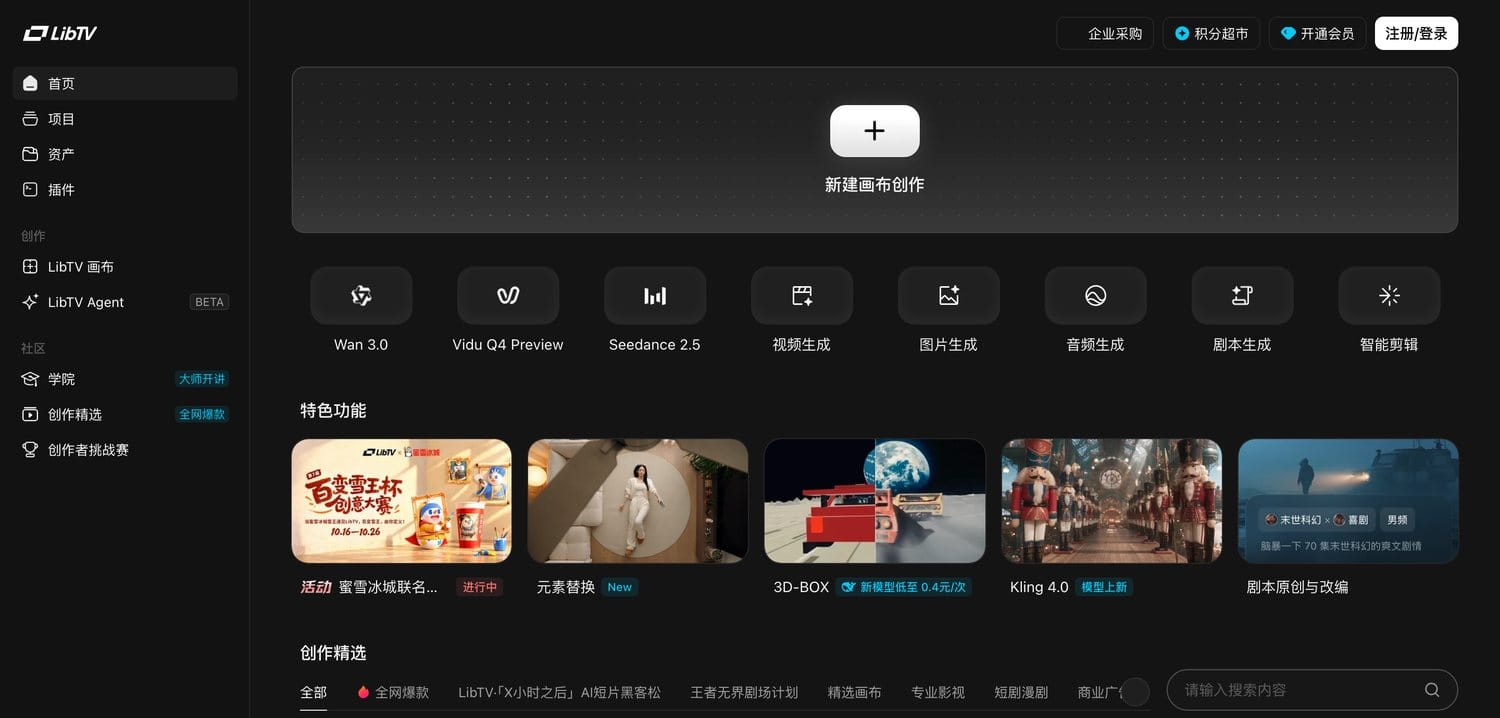
| Seedance 2.5(字節跳動) | 6 月 23 日發表;單次可生成 30 秒;一次輸入最多可放 30 張圖、10 段影片、10 段音訊當參考(TechNode 引述第一財經);先在即夢與豆包 Pro 推出,API 預告將上火山引擎 | 參考多、時間長,適合固定角色與帶音樂的鏡頭;LibTV 官網(10/23)列出 Seedance 2.5 720P 限時 0.19 元/秒 |
| 可靈 Kling 4.0(快手) | 9 月 28 日推出;單次最長 30 秒、最多 10 個關鍵影格;3.0 版(2 月)已有原生 4K | 關鍵影格可以控制動作從哪個姿勢開始、到哪個姿勢結束,對要對節奏的唱歌鏡頭有幫助(推測) |
| Wan 3.0、Vidu Q4 Preview | LibTV 官網首頁列為可選模型 | 同一張畫布上可以混用不同模型,鏡頭失敗就換模型重拍 |
| Sora(OpenAI) | 3 月 24 日宣布停止 Sora app;報導指出 API 預定 9 月 24 日結束 | 提醒:別把整條工序綁在單一模型,要把角色圖、提示詞與分鏡存在自己能帶走的地方 |
另一個變化是工作介面:從「一個鏡頭一個提示詞」變成節點式畫布,把文字、圖片、影片、音訊節點連在一起,角色和參考圖放在資產庫,失敗的鏡頭局部重拍。《過來人》用的 LibTV 就是這一類。創作者說他最難處理的是角色一致性與對口型;Seedance 2.5 的多參考輸入與 Kling 4.0 的關鍵影格,看起來正是衝著這兩個問題來的,但這是 AI郵報的推測,不是廠商或創作者的說法。
一支 AI MV 的完整工序:《過來人》每一步是誰做的?
把新京報專訪與紅星新聞的描述,對到一般 AI MV 的工序上,大概是下面這樣。「誰決定」那一欄是創作者的自述,沒有第三方驗證:
| 步驟 | 做什麼 | 誰決定 | 《過來人》的做法(報導) |
|---|---|---|---|
| 1 題目與歌詞底稿 | 決定要講什麼、哪幾句留下 | 人 | 底稿與取捨由他決定;主題來自他手機備忘錄裡存了幾年的句子 |
| 2 歌詞試錯 | 批量試句子、押韻、組合 | AI 做、人挑 | 一開始讓 AI 直接寫,強行押韻、邏輯不通;後來改讓 AI 大量試句子,由他選 |
| 3 音樂與人聲 | 編曲、十種古人音色 | AI 做、人調 | 具體工具沒公開;諸葛亮那段生成了好幾版,加旋律後覺得不對,重新調整編曲 |
| 4 角色與參考圖 | 把每個人物的樣子和狀態釘住 | 人 | 先要求 AI 區分人物形象與狀態再篩選;用資產管理固定角色與參考圖 |
| 5 分鏡與鏡頭生成 | 把每句歌詞變成鏡頭 | AI 做、人挑 | 主要在 LibTV 畫布完成;不同模型的可用性見上一節 |
| 6 局部重拍 | 不滿意的鏡頭只重做那一段 | 人 | 他說最難的是角色一致性與對口型 |
| 7 本機剪輯 | 對節奏、對歌詞、補救 | 人 | 最後回到本機剪輯成片;有些鏡頭和節奏、歌詞對不上,在後期重新剪接 |
| 8 標示與發布 | 標明 AI 生成、選平台 | 人 | 他主動標註「本視頻由 LibTV 生成」;YouTube 說明欄署名「策劃|詞曲|AI 製作」 |
幾個細節值得記下來:
- 為什麼杜甫第一個開口?他說杜甫最接地氣、困境最具體(搬家、租房、中年仍為家奔波);蘇軾代表人生起落與漂泊,劉邦代表起步晚但不服輸。孫悟空入選是「很感性的決定」,因為這十位都出現過在他之前的說唱對戰系列。
- 寫古人的原則是「尊重」:不拿名人開涮、不讓人物說不符合身份的話、不醜化他們的經歷。
- 誰在聽?他原本以為核心聽眾是喜歡說唱與歷史的年輕人;後台數據(創作者提供)顯示是 31 到 40 歲的中年人,之後年齡向上、向下都拓寬。紅星新聞寫到評論區有許多觀眾分享生活經歷、互相安慰,新京報專訪的標題則用了「樹洞」。
- 他說的關鍵句:AI 替代不了做決定這件事;技術很容易複製,但一個人心裡的東西很難複製。
成本到底多少?創作者的數字與一個試算
創作者的說法是「數千元」。紅星新聞說明,成本主要是工具會員訂閱和算力消耗;新京報專訪中他說這是「很粗略的數據」。兩篇都沒有標示幣別。
為了知道這個數字合不合理,AI郵報做了一個粗略試算。這是我們的試算,不是創作者的數據,也不代表他用了這個模型:
| 項目 | 算法 | 結果 |
|---|---|---|
| 成片長度 | YouTube 官方版約 4 分 41 秒 | 約 281 秒 |
| 每「遍」鏡頭費用 | 281 秒 × 0.19 元(LibTV 10/23 列出的 Seedance 2.5 720P 限時價) | 約 53 元 |
| 重拍 5 到 10 遍 | 53 元 × 5 到 10 | 約 270 到 530 元 |
| 其他 | 會員訂閱、更貴的模型或解析度、音樂與人聲工具、歌詞試錯、失敗的整段重做 | 把總額推到「數千元」並不意外 |
這個試算只想說明一件事:單遍生成很便宜,錢花在重拍次數、時間和你願意為品質付多少。真正的限制不是預算,而是他說的那 3 到 4 天裡,要一個人判斷幾百個鏡頭哪個留。
做完能不能發?版權與標示的三層問題
AI郵報不是律師,下面是公開資訊的整理,要商用或接案前請另外請教專業人士。
第一層:這首歌、這支 MV 的著作權是誰的?
- 美國:美國著作權局 2025 年 1 月的報告(Part 2)認為,純 AI 生成、人類沒有對表達方式有足夠控制的作品不受保護;人類的選擇、編排與修改可以受保護,申請時要揭露並排除 AI 生成的部分。管理音樂機械版稅的 MLC 也說,純 AI 生成的音樂作品不能登記。
- 台灣:依經濟部智慧財產局官員的說法(媒體報導),現行著作權法保障自然人或法人;單純由 AI 生成的內容原則上不受保護,但把 AI 當輔助工具、有人類實際思想與心力貢獻的部分,可以主張。我沒有找到智慧局針對 AI 音樂的專門規定。
- 對《過來人》的意思:這種案例裡,能主張的多半是人做的部分:歌詞底稿、人物與結構的選擇、重編曲、後期剪輯,以及一路上的取捨。這是 AI郵報的推論,不是法律意見。
第二層:工具的訓練資料與輸出有沒有爭議?
這就是前面音樂章節的官司。對使用者來說,實務上要留意:用的模型有沒有公開授權說明、服務條款允許哪些商用、成品上傳到串流平台或 YouTube 時有沒有被偵測出與現有作品相似。Suno 的案子還沒有結論,所以目前沒有人能保證「用某工具做的歌一定沒事」。
第三層:平台要不要你標示 AI?
- 中國:《人工智能生成合成內容標識辦法》2025 年 3 月公布、9 月 1 日施行,要求以文字、聲音、圖形等方式顯式標示,並在檔案資料中加隱式標識,禁止惡意刪除或竄改。《過來人》畫面左上角就有「由 LibTV 生成」「AI 生成」的標記。
- YouTube:據 Music Business Worldwide 報導,2026 年 5 月起 YouTube 會自動偵測並標示逼真的 AI 影片,即使創作者沒有揭露;報導說這個標示不影響推薦或營利資格。細節以 YouTube 說明中心為準。
- 音樂串流:Deezer 已明確標示並移出推薦;Spotify 2025 年 9 月的政策針對未授權的聲音複製與垃圾曲目,並要求透過 DDEX 標準揭露 AI 的使用(依報導)。
- 台灣:《人工智慧基本法》2025 年 12 月 23 日在立法院三讀通過,報導說它是框架法、中央主管機關是國科會;我沒有找到要求 AI 生成內容一律標示的具體條文。Instagram 與 Threads 這類平台的 AI 音樂標示規則,我也沒有找到清楚的公告。
實務上的簡單做法是:主動標示。YouTube 自己會標、中國有法規、串流平台在偵測,主動標示的成本幾乎是零,被動被標的風險比較大。
想照著做的人,可以怎麼起步?
以下是 AI郵報依這個案例與公開資料整理的流程,不是創作者的教學:
- 先決定「人的部分」。寫下這支作品裡哪些是你決定的:題目、歌詞底稿、人物、結構、取捨標準。這份清單就是之後說明版權與創作貢獻的依據。
- 先鎖歌,再花影片的錢。歌詞、段落與長度確定後,再生成鏡頭;歌改了,鏡頭就要重做。(這是多數 AI MV 教學的共同建議,來源以廠商部落格為主,請當經驗法則。)
- 選有授權說明的音樂工具,留下紀錄。保存提示詞、版本與時間戳記、你改了什麼,並看清楚服務條款的商用範圍。
- 先做角色參考圖,再做鏡頭。把每個人物的樣子與狀態先釘在資產庫,鏡頭失敗就局部重拍,不要整段重來。
- 用畫布,不要綁死單一模型。Sora 的例子說明了模型會消失,角色圖和提示詞要存在你帶得走的地方。
- 留時間給取捨。《過來人》的瓶頸不是生成,是一個人要挑幾百個鏡頭。排好預算,也排好檢查的時間。
- 發布前做三件事:確認工具的商用條款、在平台上主動標示 AI、確認沒有使用未授權的人像、聲音或曲風模仿特定藝人。
接下來可以觀察什麼?
- Suno 與 UMG、Sony 的訴訟。決定「用未授權曲庫訓練」是不是合理使用,據訴訟追蹤整理,關鍵裁決要到 2027 年之後。
- Udio 與唱片公司的授權平台。原訂 2026 年上線,採「封閉、藝人控制」的模式;如果上線,會是第一個大規模的「授權 AI 音樂」消費產品。
- 影片模型的單鏡頭長度與參考能力。30 秒單鏡頭加上多參考輸入,會讓一鏡到底的唱歌畫面更容易做;也代表角色一致性不再是唯一門檻,取捨與敘事會更像差異。
- 平台偵測與標示。YouTube、Deezer 與中國的標識辦法都在往「自動偵測、強制標示」走;之後用 AI 做的內容,被標示會是常態。
AI 音樂與 AI 影片常見問題
《過來人》用了什麼音樂工具?
創作者沒有公開。報導只說音樂與人聲由 AI 協助、歌詞底稿由他確定。本文不替他推測。
用 Suno 或其他 AI 音樂工具做的歌,可以商用嗎?
要看各工具服務條款的商用範圍,以及你的成品能不能主張著作權。純 AI 生成的部分,在美國與台灣的說法都是原則上不受保護;Suno 與唱片公司的訴訟也還沒有結論。需要商用或接案前,建議看條款並請教專業人士。
一定要標示是 AI 做的嗎?
中國有法規要求;YouTube 會在偵測到逼真的 AI 影片時自動標示。台灣我沒有找到一律要求標示的條文,但主動標示是低成本、低風險的做法。
一支 AI MV 成本多少?
創作者說這支是數千元(未標幣別)。AI郵報的試算顯示,單遍生成可能只要幾十元,成本主要來自重拍、訂閱與時間;實際金額取決於你選的模型與重拍次數。
可以直接複製創作者公開的畫布嗎?
他說畫布與提示詞已公開、可複製後修改,理由是就算不公開,截圖也能被 AI 工具反推。AI郵報 10 月 23 日沒有在 LibTV 上找到那份公開畫布,這點只能算他的說法。
「古人開麥」還會繼續嗎?
他說大概率會繼續,備選人物有陶淵明、辛棄疾、白居易、陸游,目前傾向陶淵明。
資料來源
本文資料查詢日為 2026 年 10 月 23 日;播放數字、模型規格、價格與官司進度都會變動,以各平台與法院最新資料為準。工具與模型的規格以廠商或第三方報導為主,未經 AI郵報獨立測試。
- 新京報(新浪轉載):AI說唱歌曲《過來人》作者:我只是為趕路人打開了一個樹洞(記者徐美琳,採訪日 2026/10/22)
- 紅星新聞(新浪科技轉載):AI歌曲《過來人》播放量破億 90後創作者王琨喆:AI替代不了人的判斷,耗時約4天,成本數千元(2026/10/23)
- 什麼值得買:AI神曲《过来人》创作者回应:AI音乐版权归属与变现真相(2026/10/20)
- YouTube 喆FILM_Official:过来人 The OGs
- YouTube 喆FILM_Official:李清照 vs 苏轼 Freestyle Battle
- LibTV 官網
- Law Commentary:UMG, Sony Hit Suno With New Copyright Lawsuit Days After AI Model Launch(2026/9/20)
- Music Business Worldwide:Universal Music settles Udio lawsuit, strikes deal for licensed AI music platform(2025/10)
- Business Wire:ElevenLabs Launches Eleven Music in Collaboration with Music Industry Partners(2025/8/5)
- TechCrunch:Google adds music generation capabilities to the Gemini app(2026/2/18)
- Deezer 新聞稿:AI music has surpassed 50% of new music uploads for the first time(2026/7/21)
- TechNode:ByteDance launches Seedance 2.5 video generation model(2026/7/31)
- Crypto Briefing:Kuaishou Technology's AI spinoff unveils Kling 4.0 video model(2026/9/28)
- Engadget:OpenAI is shutting down its Sora video generation app(2026/3)
- Music Business Worldwide:YouTube will now automatically detect and label AI videos
- 美國著作權局:Copyright and Artificial Intelligence
- The MLC:AI-generated works
- China Law & Practice:Measures for Labeling Synthetic Content Generated by AI(2025/4/30)
- 科技新報:智慧局討論生成式 AI 的著作與專利疑慮(2023/7/17)