Apple MintAct 是什麼?8B 視覺 Agent 統一操作手機、電腦、網頁與 500 種工具
MintAct 用單一 2B/4B/8B 模型統一畫面定位、手機桌面網頁導航與 500 種工具。本文釐清 48.9 分數、非同步 RL、裝置端與開源狀態。
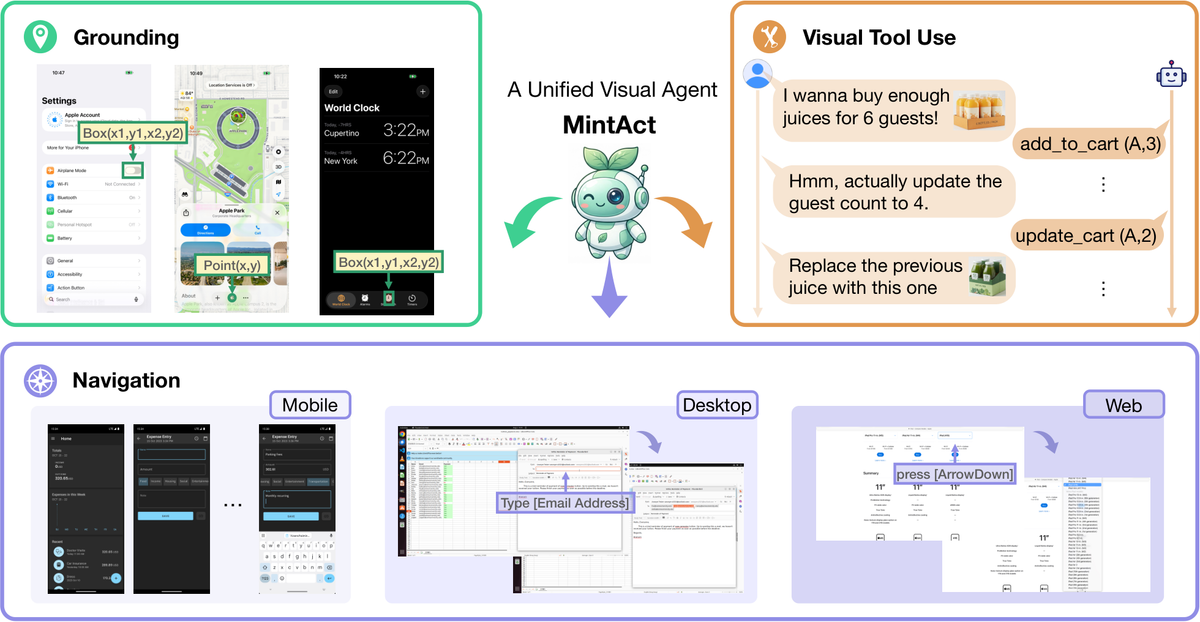
讓 AI 看懂一張畫面並指出按鈕,和讓它連續操作手機、桌面、網頁,再視情況呼叫外部工具,是不同難度的問題。過去研究通常替每個平台訓練專用模型。Apple 研究團隊在 2026 年 9 月提出 MintAct,想用同一組模型權重統一這些能力。模型權重就是訓練後保存下來、決定模型行為的核心參數。
MintAct 有 2B、4B、8B 三種規模。它從原始螢幕截圖找出操作位置,能在 Android、桌面與網頁環境執行多步任務,也能根據圖片和對話呼叫結構化工具。論文的最大 headline 是 MintAct-8B 在 OSWorld-Verified 得到 48.9。
這個 48.9 是特定桌面操作 benchmark 的分數,不是所有裝置任務有 48.9% 成功率。它也不代表 Apple 已把 MintAct 放進 iPhone 或 macOS。研究提供訓練方法、基準成績與系統圖,但截至 2026 年 9 月 28 日,論文頁沒有列出可下載的 MintAct 權重或官方程式庫。
我的判斷是:MintAct 很有研究價值,因為它證明小至 2B、最大 8B 的單一視覺模型,可以同時保留多個平台的專門能力。不過,距離成為一般使用者能安裝的 Apple 裝置 Agent,仍有記憶體、安全、長任務 context 與實機效能等空白。
MintAct 統一了哪三種能力?
第一種是 UI grounding。模型看到畫面與指令後,輸出要點擊的位置或目標框。這是把「打開飛航模式」對應到螢幕上的 switch。
第二種是 multi-step navigation。模型連續讀取畫面、決定動作、接收新畫面,再繼續操作。它涵蓋 mobile、desktop 和 web,而非只在一種作業系統上工作。
第三種是 visual tool use。畫面上的資訊可以轉成結構化 tool call。例如使用者給果汁圖片並說要買足夠六人份,Agent 需要辨識商品,再呼叫購物車工具。之後使用者改成四人份時,系統還要保留狀態並更新數量。
MintAct 的重點在於三種能力使用同一組 weights。weights 是模型訓練後學到的參數。它不需要在手機、桌面、網頁和工具環境各維護一個完全獨立模型。
它如何在不同平台輸出不同動作?
MintAct 直接讀 raw screenshots,不依賴網頁 DOM、accessibility tree 或平台專用 API。DOM 是網頁的結構資料,accessibility tree 則是作業系統提供給輔助功能的介面描述。
模型把座標統一正規化到 999 × 999。無論原始螢幕多大,位置都能用相同範圍表示。這有助於把 grounding 能力從一種裝置轉移到另一種裝置。
但各平台可做的動作不相同。手機有 long press、swipe、home,桌面有 right click、drag 和 key down,網頁則有 hover、go back、go forward。MintAct 沒有把所有 action tokens 塞成一張巨大清單,而是用 domain-specific system prompt 告訴模型當前可用的動作。
system prompt 是系統在任務開始前提供的操作規則。這種設計讓單一模型共用視覺和推理能力,同時避免在手機任務輸出只有桌面才有的滑鼠操作。
四階段訓練:先點準,再學長任務
MintAct 不是只靠一次 supervised fine-tuning 完成。論文採用四個階段。
第一階段用高解析度單步 SFT 建立 grounding。SFT 是 supervised fine-tuning,讓模型模仿正確示範。高解析度有利於辨認小按鈕、圖示和精確座標。
第二階段用較低解析度的多步軌跡教 navigation 和 tool use。解析度下降能控制長任務的記憶體與計算量,因為每一步都會加入新截圖。
第三階段分別訓練 mobile、desktop、web 和 visual tool use 的 RL specialists,再用 rejection sampling fine-tuning,簡稱 RFT,把各專家成功軌跡蒸餾回單一模型。
第四階段是 joint asynchronous RL。RL 是 reinforcement learning,模型在可執行環境中採取行動,再依任務結果獲得 reward。asynchronous 表示環境持續產生軌跡,訓練器不用等待最慢的一批任務全部結束。
為什麼跨平台 RL 需要專門基礎設施?
手機、桌面與網頁環境的速度差異很大。如果直接混在一起訓練,較快的環境會產生更多資料,讓模型實際看到的比例偏離設定。
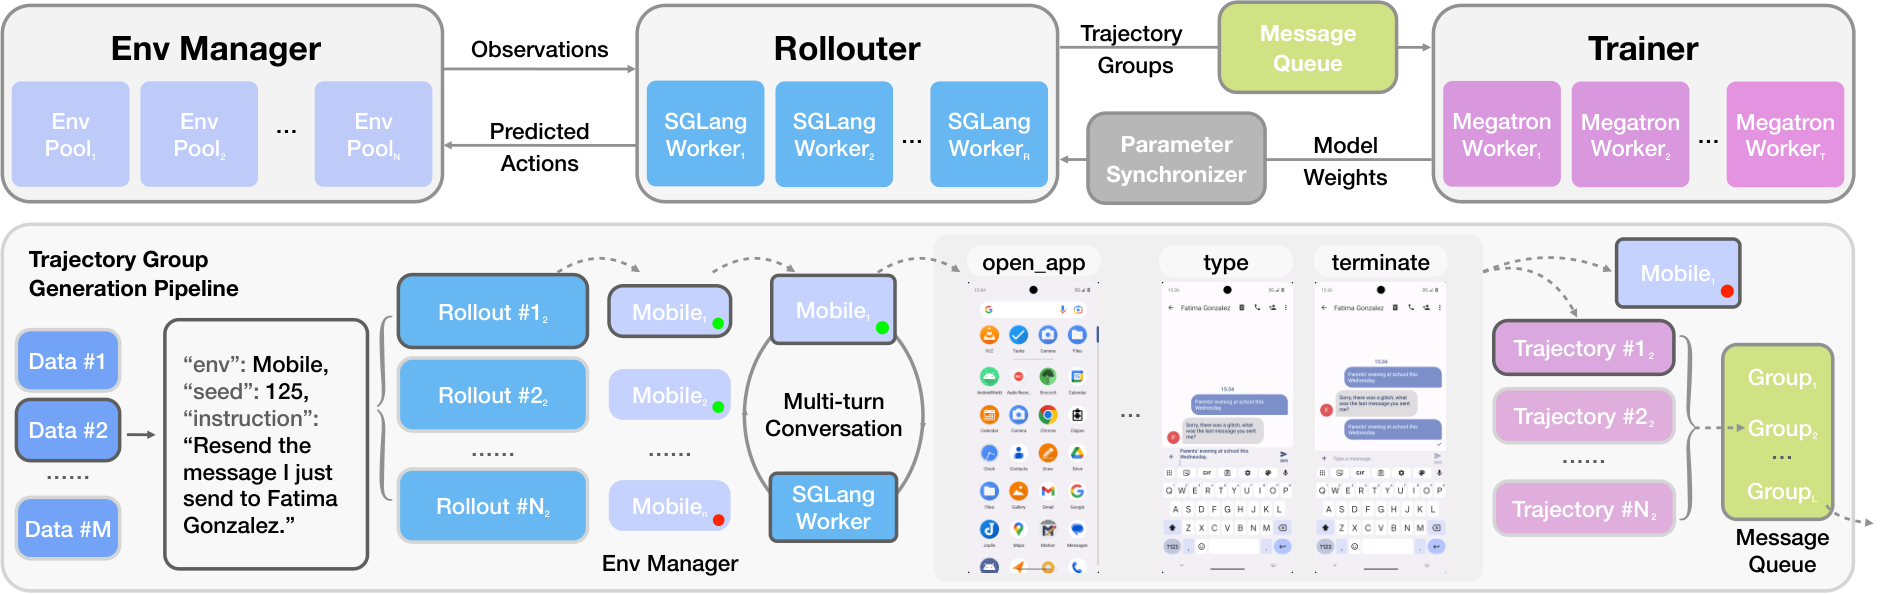
MintAct 的系統用 environment manager 管理不同環境池,rollouter 產生多步 trajectory,message queue 把軌跡送給 trainer,parameter synchronizer 再把新權重發回 rollout workers。訓練器可以控制每個 domain 的取樣比例,也能處理失敗環境和過舊軌跡。
桌面 RL 可同時運行超過 200 個環境,每個 instance 配置 10 個 CPU cores 和 40 GB memory。AndroidWorld 則同時運行超過 100 個 emulator。這說明研究中的「8B 小模型」背後,仍需要相當大的環境與訓練基礎設施。
48.9 到底代表什麼?
OSWorld-Verified 用真實桌面環境測試多步電腦操作。MintAct-8B-Final 得到 48.9,初始化的 Qwen3-VL-8B 是 33.9,MintAct-SFT-8B 為 42.6,完成 RFT 後為 43.1。
joint RL 讓 43.1 再升到 48.9,表示 mobile 與 desktop 的共同訓練確實改善桌面任務。但 OSWorld 只是十項主要 benchmark 之一,不能拿 48.9 概括所有能力。
| MintAct-8B 測試 | Qwen3-VL-8B 起點 | MintAct-8B-Final | 差距 |
|---|---|---|---|
| AndroidWorld | 47.6 | 67.0 | +19.4 |
| OSWorld-Verified | 33.9 | 48.9 | +15.0 |
| Weblica | 55.5 | 74.7 | +19.2 |
| Online-Mind2Web | 26.5 | 39.1 | +12.6 |
| MM-ToolSandBox | 3.1 | 24.5 | +21.4 |
這些 benchmark 的量尺與任務不同,不能把五個分數直接平均成「總成功率」。合理說法是 MintAct-8B 在官方報告的多個對應測試都高於同規模 Qwen3-VL-8B 起點。
一個模型真的沒有犧牲各領域專長嗎?
論文把統一模型和相同規模、各自針對單一領域訓練的 specialists 比較。MintAct-SFT-8B 在 grounding、mobile、desktop、web 和 tool call 上大致維持或超過對應專家。
不過,最終 joint RL 目前只直接訓練 mobile 和 desktop。它讓 OSWorld-Verified 從 RFT 的 43.1 升到 48.9,Weblica 也從 72.8 升到 74.7,但 AndroidWorld 從 68.1 小降至 67.0。這顯示多領域共同訓練仍有取捨,只是整體效益為正。
visual tool use 沒有加入最後的 joint RL,MM-ToolSandBox 維持 RFT 階段附近。研究者也承認,工具呼叫目前大致是分開的能力,尚未做到模型在 pixel navigation 和 dynamic tool calling 之間自然選擇。
超過 500 種工具,怎麼避免 prompt 爆滿?
MintAct 的 visual tool use 建立在 MM-ToolSandBox。這個環境跨 16 個應用領域,提供超過 500 個 tools。若每次把所有工具定義都塞進 prompt,context 會很大,模型也更難選對。
系統提供 search_tool,讓 Agent 先搜尋與任務相關的工具,再把新發現的定義加入後續 context。另有 coding_tool 處理中間計算、資料轉換與圖片檢查。
這個方法也帶來新問題。動態加入工具會改變 prompt prefix,降低 prefix caching 效果。prefix caching 是重用相同提示開頭的運算結果,減少延遲與成本。論文目前把長軌跡切成 segments,將整體 reward 分給各段,作者承認這只是較粗略的 credit assignment。
合成環境能不能取代真實手機和電腦?
MintAct 另外建立 synthetic mobile 與 desktop environments。研究者先從真實操作軌跡整理約 3,000 種 capabilities,再讓 coding agent 生成可互動環境與任務,用於 SFT、RL 和 held-out evaluation。
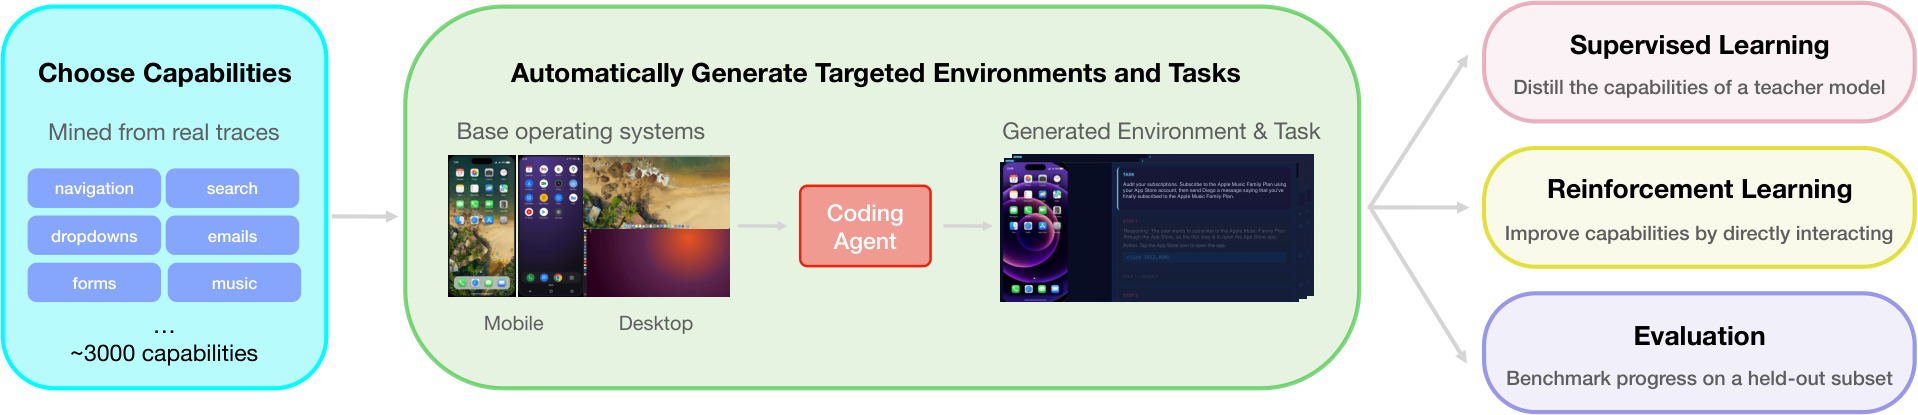
只在合成環境做 RL,Qwen3-VL-8B 的 AndroidWorld 從 47.6 升到 60.3,OSWorld-Verified 從 33.9 升到 38.6。沒有使用真實 iOS 資料時,iOSWorld 也從 2.3 升到 18.8。
這證明合成環境可以教會可轉移的操作技能,尤其適合缺少真實資料的平台。但有真實 in-domain RL 時,成績仍較高。論文中 AndroidWorld 是 66.7 對合成 RL 的 59.8,OSWorld 是 48.3 對 39.4。合成資料是補充,不是完整替代。
2B 到 8B 是否代表能在 iPhone 上執行?
論文稱這個規模適合 on-device deployment,並把裝置端與 server 協作列為未來方向。這是研究潛力,不是已完成的產品證明。
論文沒有提供 iPhone、iPad 或 Mac 上的實測 latency、RAM、電量、熱量、量化精度與 Core ML 部署結果。8B 參數若使用 16-bit 權重,光權重就可能需要約 16 GB;較低 bit 量化可以縮小,但會影響效能與相容性。實際記憶體還要加上 vision encoder、KV cache 與執行框架。
因此不能把「8B 級模型」直接寫成「可在 iPhone 本機執行」。只有 Apple 公布特定硬體、量化與效能結果後,才能評估裝置端可行性。
長任務與安全仍是上線門檻
MintAct 在訓練時把每張新 screenshot 都加入 context。任務越長,圖片數、memory 和計算量成長越快。作者把摘要舊畫面、刪除過期 observation 等 context management 列為未來工作。
此外,直接從像素操作的模型沒有 DOM 或 accessibility metadata 可用,面對相似按鈕、彈出視窗、畫面縮放與動畫時更容易誤點。付款、刪除、寄信、帳號設定等不可逆動作,仍要由外部系統做權限與人工確認。
企業評估時至少要分開量測 grounding accuracy、end-to-end task success、錯誤動作率、完成步數、p95 latency 和人工接管率。公開 benchmark 高分不能取代自己產品上的安全測試。
MintAct 常見問題
MintAct 是 Apple 已推出的產品嗎?
不是。它目前是一篇 Apple 研究團隊署名的 arXiv 預印本,沒有對應的一般消費者產品公告。
MintAct 已經開源模型嗎?
截至 2026 年 9 月 28 日,arXiv 與 Hugging Face paper page 沒有列出 MintAct checkpoints 或官方 code repo。不能因為論文公開就推定權重已開源。
48.9 是成功率嗎?
它是 OSWorld-Verified benchmark 的報告分數,應放在該 benchmark 的評測定義中理解,不能延伸成所有電腦操作有 48.9% 成功率。
MintAct 能同時操作 Android、桌面和網頁嗎?
同一組權重接受不同 domain prompt,能在對應研究環境輸出 mobile、desktop 或 web actions。這不等於任意真實 App、網站與作業系統都已支援。
它會自己決定點畫面還是呼叫工具嗎?
目前 navigation 和 visual tool use 仍大致分開。作者把兩者按需無縫切換列為尚未完成的研究方向。
結語:統一模型成立,通用裝置 Agent 還沒完成
MintAct 提供了一個重要證據:2B、4B、8B 的單一視覺模型,可以同時學會 grounding、手機/桌面/網頁 navigation 與 visual tool use,且官方測試顯示沒有必然犧牲每個領域的專門表現。
MintAct-8B 把 OSWorld-Verified 從基礎模型的 33.9 推到 48.9,也在 AndroidWorld、Weblica、Online-Mind2Web 和 MM-ToolSandBox 明顯提升。它背後依賴多階段 SFT、專家 RL、RFT 蒸餾、mobile/desktop joint RL,以及數百個並行環境。
這仍不是一個已開源、已在 iPhone 實機驗證、可以放心處理付款與刪除的通用 Agent。最準確的定位,是 Apple 對「小型統一視覺 Agent」提出的一套完整訓練與環境方法,並用多平台 benchmark 證明這條路可行。