AWS 開源 Infinity:7.5 萬個等待中的 AI 代理,為何不等於 7.5 萬個模型?
AWS 與 UC Berkeley 的 Hydro 專案開源 Infinity,以保存對話、訊息佇列與有界片段恢復 AI 代理。解析七萬五千個閒置代理的測試口徑、Lambda 部署、非同步事件與早期研究限制。

代理送出建置後等二十分鐘,另一個代理等人工批准一整晚。如果每段等待都保留程序,任務越多,資源開銷也越高。
AWS 與加州大學柏克萊分校合作的 Hydro 專案,在 2026 年 10 月 23 日介紹開源 Infinity,以保存對話再暫停的方式,重新安排代理等待工具的流程。它目前是早期研究版本。
官方以樹莓派 5 的 8GB 記憶體說明約七萬五千個代理的容量,但這個數字來自伺服器上使用模擬模型的記憶體測試推算,並不是在樹莓派同時執行同等數量的模型。
代理的資源需求,取決於它交出工具工作後如何結束這一段執行、結果抵達時如何恢復,以及同一段對話的訊息如何保持順序。
我的判斷是,Infinity 提供了有價值的長任務架構範例,卻還不足以用單一密度數字證明實際應用的成本或可靠性。事件真偽與交錯推理也仍是官方列出的研究問題。
從一個正在等待建置的代理開始,較容易看清楚它省下的是什麼,又把哪些責任交給儲存與佇列。
代理等待工具時,Infinity 保存什麼、釋放什麼?
Infinity 在工具呼叫後保存對話歷史並結束執行片段,讓等待中的代理不必持續保留程序、堆疊或連線。程序是正在執行的程式,而堆疊保存它一路呼叫函式的狀態,兩者都會占用資源。
想像代理正在問「建置四十二號通過了嗎」。它已經送出查詢,在工具回來之前沒有新的資訊可推理。若仍保留整套執行狀態,只是為了等回覆,便會隨等待任務增加而累積開銷。
官方架構介紹借用非同步程式的概念:到達需要等待的地方,先存下之後繼續工作所需的資料,把運行資源交給其他工作。
對語言模型代理來說,工具呼叫出現時,對話歷史包含了接續工作需要的脈絡。執行環境把它保存後,就可以讓當下程序離開,日後由能讀取相同儲存位置的程序恢復。
這種安排適合工具等待很長、而代理本身暫時無事可做的情境。若外部建置仍在跑,那個建置本身需要的運算不會因此停止,省下的是代理守在原地等待的資源。
等待狀態既然變成保存的資料,下一步就是決定什麼訊息能把它喚醒。
結果進入佇列後,如何恢復同一段工作?
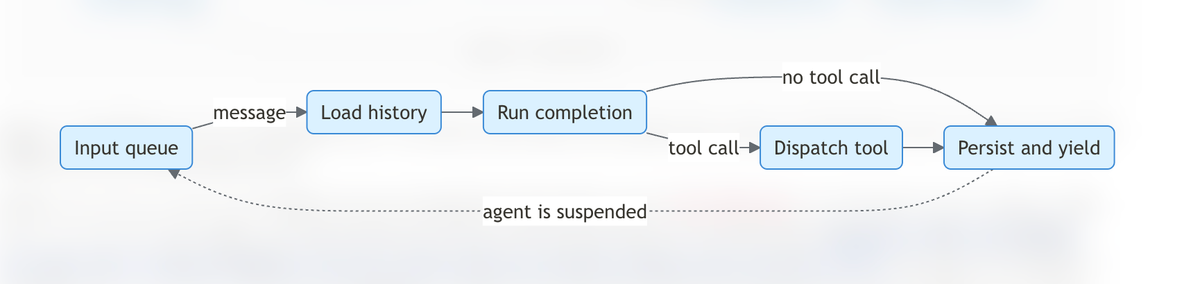
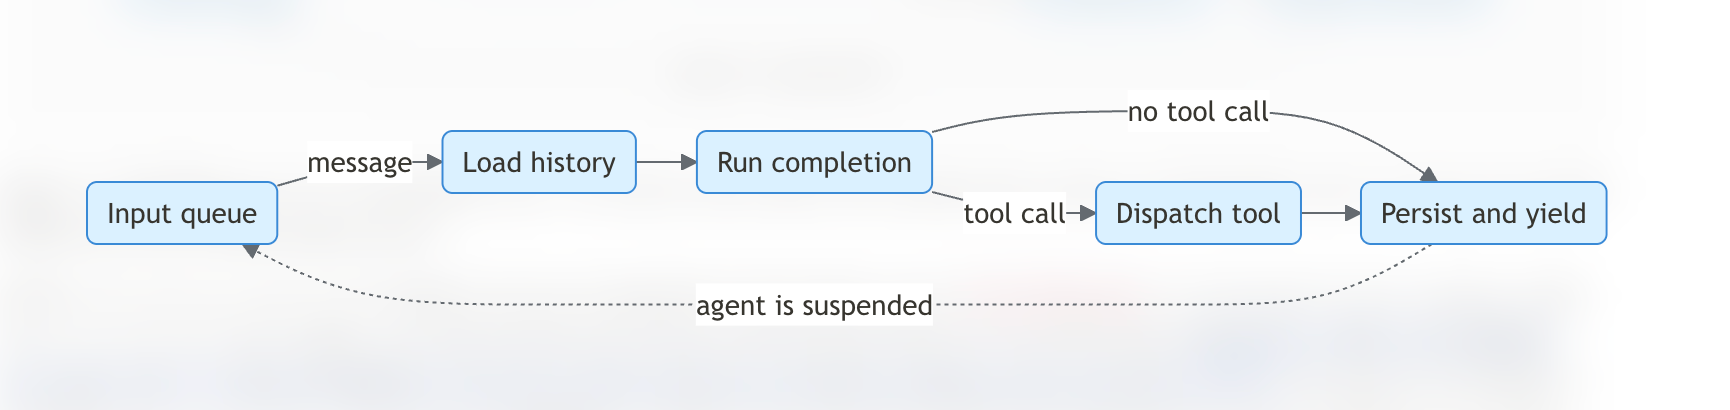
每個有界執行片段會載入歷史、跑一次模型回應、保存輸出並最多派送一個工具呼叫,再等待後續訊息。有界表示這段工作有明確結束點,不會把外部工具的無限等待也包進來。
訊息佇列負責暫存尚未處理的輸入。使用者文字、工具結果與其他事件,都能成為下一段執行的起點,因此代理可以離開,訊息仍有地方等待接收。
例如建置工具收到請求後,可以先開始工作並立即返回。等建置真的完成,再把結果與原工具呼叫的識別送進佇列,喚醒讀取該段對話的代理。
這要求開發者改變工具的寫法。工具不必在原呼叫裡等到最後才交出答案,而是負責啟動工作,再安排完成後送回結果。若只是把原本阻塞的函式包起來,等待方式並不會自動改變。
每個對話執行緒都有自己的訊息順序。執行緒在這裡指一條獨立對話,系統一次只處理其中一段,避免兩段工作同時讀舊歷史,又各自把對方的新內容蓋掉。
不同對話可以同時推進,因為它們透過訊息溝通,不共用可任意改寫的對話狀態。這讓併發數量和每條對話的順序要求可以一起考慮。
同一對話必須逐段處理,而這種輕量狀態到底能放多少,得回到官方測試使用的條件。
七萬五千個代理的測試,實際測了哪件事?
官方實測用 AMD EPYC 單執行緒、記憶體內儲存與模擬模型,觀察到每個閒置代理約占一百 KB。這是執行環境保存代理狀態的密度測試,沒有測量真實模型同時產生答案的能力。
實驗啟動八萬個代理,每個跑二十輪,每輪經過工具呼叫與回傳,再以第二次模型回應結束。總共三百二十萬次回應,都由模擬模型提供,讓研究者集中觀察執行環境開銷。
根據這個記憶體增長速度,官方推算八 GB 大約容得下七萬五千個代理。樹莓派五代被用作八 GB 容量的參照,實際測試機器則是伺服器處理器。
如果把標題讀成「樹莓派同時跑七萬五千個模型」,就會把保存對話與模型推論混在一起。模型生成答案的速度,以及保存模型參數和呼叫服務的費用,都沒有由這個測量得到答案。
代理狀態描述它做到哪裡,模型參數則是生成答案需要的核心資料。兩者的大小與執行位置並不相同,所以不能用前者的容量取代後者。
這個結果仍有研究價值:等待狀態大多由對話歷史構成,沒有每個代理各占一條長期連線或程序的額外負擔。但歷史變長時,狀態大小也會改變,不能把一百 KB 當成所有任務的固定常數。
對正在估算系統規模的團隊,應把「多少任務正在等待」與「多少任務正在請模型生成」分開。前者關係保存狀態,後者則受到模型服務、速率與運算資源限制。
這種密度說明等待狀態很輕,卻沒有回答真實模型、外部工具和持久資料服務要花多少錢。
部署到 Lambda 後,哪些費用與責任仍存在?
參考部署以先進先出的訊息佇列排列工作,由 Lambda 雲端函式執行一步後結束,並把對話歷史與去重紀錄放進資料服務。每條對話使用自己的訊息群組,保持該條對話的處理順序。
官方無伺服器部署文件使用 SQS FIFO 作為這種佇列。無伺服器表示開發者不必長期管理一台專用伺服器,仍會依實際使用到的服務計算用量。
一次交付的訊息觸發函式,函式完成模型回合與保存工作後就能離開。工具如果花三天才回報,代理不需要為了接收三天後的答案,一直保留同一個函式執行。
對話歷史在參考架構裡交給 Aurora DSQL,已處理訊息的狀態交給 DynamoDB。它們分別負責保存工作內容與辨認重複訊息,讓下一次函式不必靠前一次的記憶體繼續。
定時喚醒也透過佇列延遲與排程服務安排,不能假設程序離開後仍有一個本機計時器等著叫醒它。這些保存與喚醒環節,都是架構能否長時間運作的一部分。
因此,等待期間沒有代理函式持續運算,與整套系統零費用是兩件事。對話儲存、訊息交付、模型回應及外部工具仍各有自己的資源需求。
若已看過 TanStack AI 的長任務框架,可以把這裡理解為更靠近底層的執行安排:保存狀態之後,還要確保訊息回來時能安全接續。
延伸閱讀:TanStack AI 1.0 穩定版:現有聊天應用升級,為何要一起搬動前後端?
重送、串流失敗與事件先後,如何維持對話一致?
Infinity 用穩定訊息識別與已處理紀錄跳過重送,模型串流則等一個回合完整結束才提交。去重就是辨認同一件輸入是否已處理,避免佇列重送時再做一次相同的回合。
訊息服務可能因交付確認失敗而再次送出同一個訊息。若只看到「又收到一筆」便繼續對話,模型可能重複回應,所以輸入要保留可供辨認的識別值。
模型回應也可能在傳到一半時中斷。執行環境先把串流放在暫存區,完整回合結束才寫入。若中途失敗,就丟掉那段暫存並重試,避免把半個答案當成完整歷史。
工具回合則先保存呼叫,再派送工具工作。這樣工具結果即使很快回來,對話也已有對應的請求紀錄,不至於看到一個找不到起點的答案。
這些安排保護的是執行環境的處理流程。若工具已向外部系統發出一次修改,外部副作用仍需要工具自己的識別與防重做設計,不能把訊息去重直接當成任何交易都只會執行一次。
回合順序能保住,仍需要讓模型分得清楚新事件來自工具,還是使用者提出的新要求。
合成工具呼叫如何帶回背景事件與子代理報告?
執行環境把非同步事件包成合成工具呼叫與結果,標明它對應的原始工具請求,再送回指定對話。這些呼叫由系統補入,並非模型自己決定再呼叫一次工具。
這種包裝是為了配合模型既有的對話格式。若把背景事件寫成使用者訊息,模型會難以分清誰提出要求。若為同一工具呼叫硬塞第二個結果,又可能違反介面對結果配對的要求。
Infinity 使用專用名稱,並在資料裡保留原工具與呼叫識別。該名稱不提供給模型選用,若模型自行嘗試呼叫,執行環境會拒絕,讓事件入口與一般工具操作分開。
子代理也走同一條訊息路徑。父代理建立子對話後可以繼續工作,孩子稍後回報時,報告會對應到原本的建立請求,因此父代理能知道是哪一項分工送回結果。
大量訂閱事件預設可以交給臨時子對話處理,只把必要報告送回父對話,減少原始事件塞滿主要歷史。若事件是背景測試進度,也能選擇直接加入正在追蹤它的對話。
這與 Claude MCP 長任務的讀者需求相近,都要讓工作稍後有路徑回來,但此處更關注執行環境如何表達事件與維持對話。
延伸閱讀:Claude MCP Tasks 與 Elicitations:長任務交給外掛,何時回來問你?
事件也能交給暫時子代理處理,但格式正確仍不等於事件來源已可信。
早期研究版還有哪些不能省略的問題?
官方仍在研究交錯事件對推理的影響、排程優先順序、長對話樹壓縮與事件真實性。這些都與真實應用可靠性有關,不能用記憶體密度取代答案。
排程仍缺少優先順序的取捨。官方現階段依訊息抵達順序處理,但使用者眼前的對話可能比背景事件更急,系統如何表達優先程度,仍是後續研究方向。
例如,同時抵達的事件先後不同,可能改變模型下一步決定。把一個事件送到子對話處理,或直接加入主要對話,也會改變模型看見的脈絡與資訊量。
對話變長還會遇到壓縮。父代理把歷史縮成摘要後,早先建立的子代理可能需要還原自己繼承的舊背景,官方也指出,大型長期對話樹該如何處理仍有待研究。
執行環境知道事件對應哪個請求,仍不代表網路送來的內容是真的。官方把來源驗證列為開放問題,因為系統還需要知道誰送出事件,以及後續動作如何留下可追查的根據。
我的採用判斷會落在能否重建一次完整等待:工作交出後是否確實結束,程序消失後能否接回結果,重送時又是否保留同一段歷史。這比先追求最大代理數更接近長任務需求。
若想比較程序消失後如何恢復工作,可延伸閱讀 Vercel durable-harness。Infinity 可以從官方程式庫與部署範例開始研究,若準備接入自己的系統,應先沿一條真實工具資料流理解保存與恢復責任,再決定是否擴展到更大的代理群。
延伸閱讀:Vercel durable-harness 是什麼?程式代理雲端當機後如何接著做
常見問題 FAQ
Infinity 是由 AWS 代為運行的雲端服務嗎?
本次是 Hydro 專案的早期開源研究發布,可研究程式與參考部署。官方沒有把它描述為由 AWS 代為運行的正式服務。
Infinity 需要把模型放進樹莓派嗎?
不需要由那個密度說明推導模型部署方式。文中的八 GB 是保存代理狀態的容量參照,實驗使用伺服器與模擬模型。
工具一定要改寫成 Rust 嗎?
Runtime 本身是 Rust 框架,工具接法要依官方介面安排。專案另提供 Reactive Agent Protocol,讓工具結果與事件經網路送回。
MCP 是代理連接外部工具的協定,現有伺服器可透過相容層接入,仍需按自己的環境設定。