Claude Opus 5.5 發布:創意編程亮眼,成本與評測該怎麼看?
Claude Opus 5.5 主打長程編程與代理任務,Anthropic 稱典型任務成本較 Opus 5 低約 40%。本文整理創作案例、計價條件與評測限制。
Claude Opus 5.5 發布後,社群最容易看到的是一張張互動網站與動態作品。這些展示說明模型能把文字需求轉成可操作的作品,卻不能單靠一段影片判斷它在真實專案中的穩定性。更實用的問題是:它適合哪類工作?同樣結果要花多少成本?需要人工修正多少次?
創意編程:先看作品,再看製作條件
開發者 Ryan Sael 分享了以 Opus 5.5 製作的互動式相機焦點實驗頁。它能讓讀者直接調整參數、理解鏡頭焦點,而不是只看一段解釋文字。這類成果顯示 AI 已能協助製作具視覺與互動性的原型;但要評估可維護性,仍須檢查程式結構、無障礙設計、效能與後續修改成本。
Claude 官方也轉分享了這個作品。若想看動態展示,可點開創作者的影片與作品來源,並留意它是單一案例,而非代表所有提示詞都能一次成功。
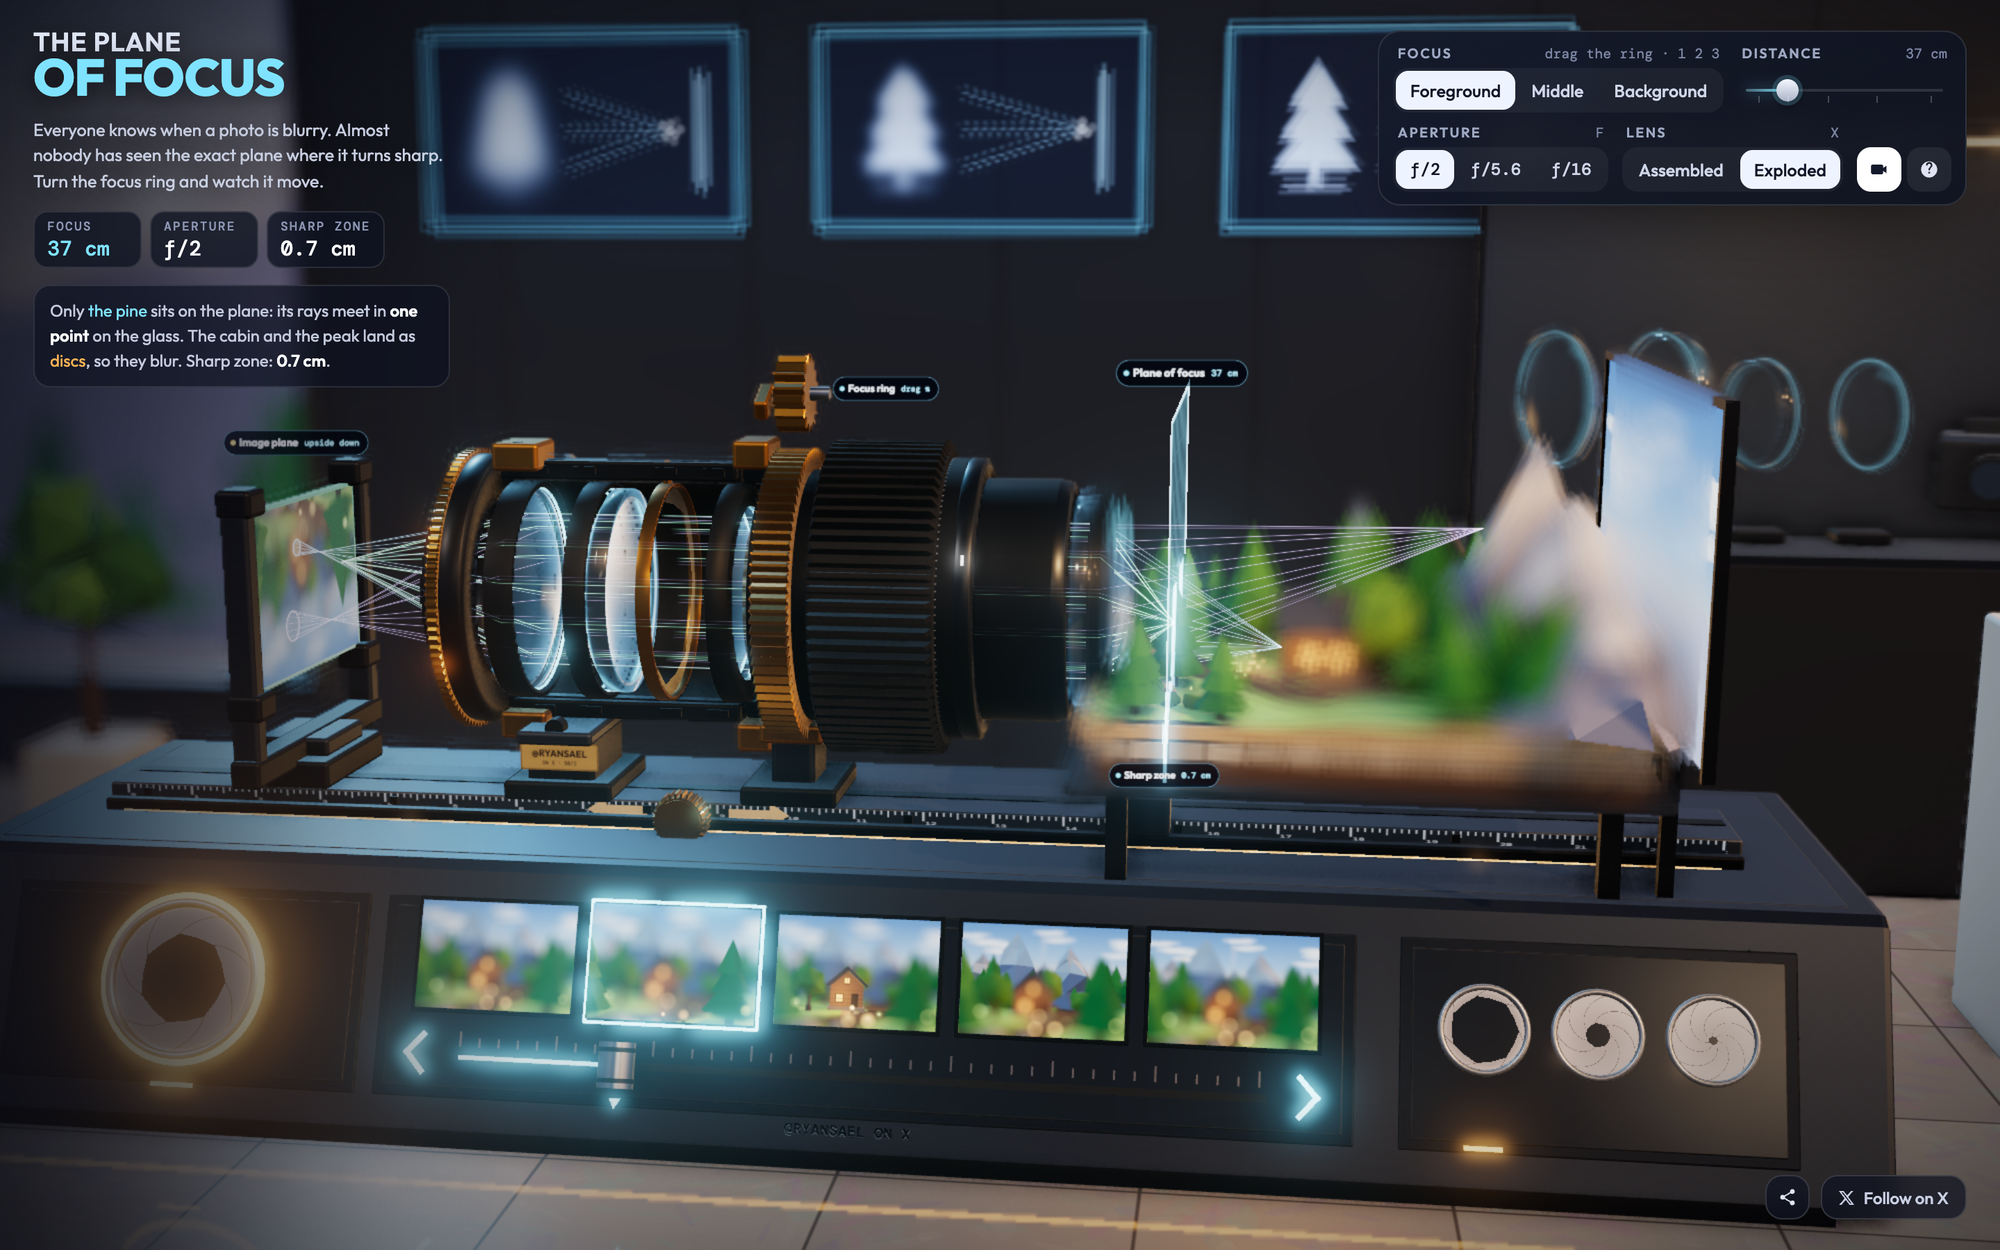
I asked Opus 5.5 to explain camera focus by building an interactive lens lab
— Ryan Sael (@RyanSael) September 23, 2026
Here’s what it came up with after 1 hour 26 minutes in one shot, $25.66 API cost
lens.lab.sael.net
Move the focus ring and you can see the glass elements shift the sharp plane through the scene
Ryan Sael 發布的實作展示影片,Claude 官方曾轉分享;X 影片可能需登入才能播放。
價格下降,不等於每個任務都便宜 40%
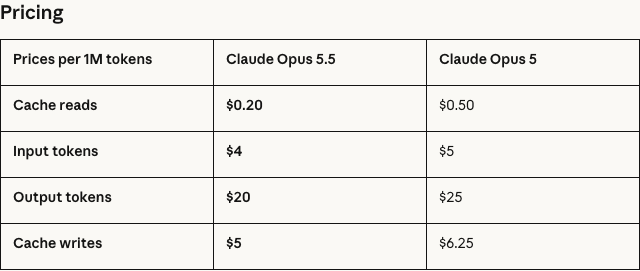
Anthropic 公布的 Opus 5.5 API 定價是每百萬輸入 token 4 美元、輸出 token 20 美元,分別比 Opus 5 低 20%;快取讀取降至 0.20 美元,降幅為 60%。公司估計典型任務整體成本下降約 40%,原因還包括完成任務時使用的 token 數變少。實際帳單仍取決於上下文長度、快取命中率、工具呼叫與重試次數。
評測能告訴我們什麼?
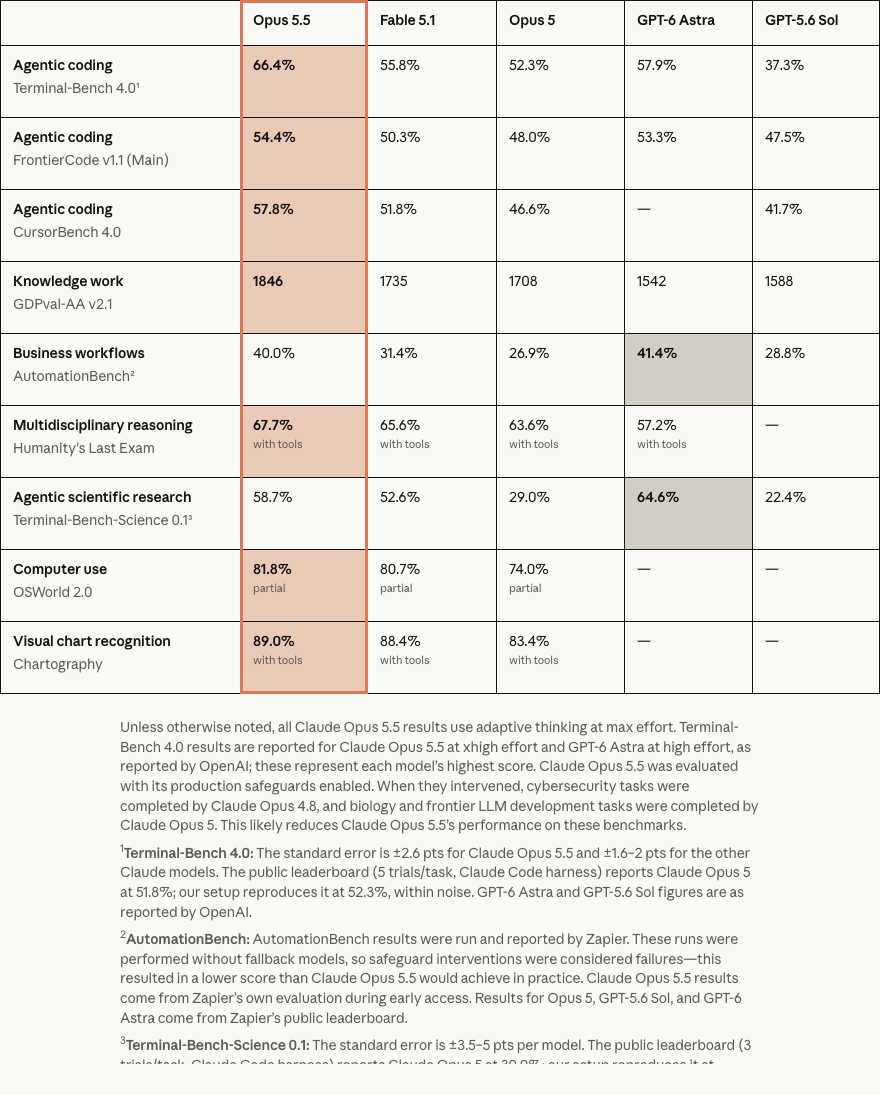
Anthropic 公布了 Terminal-Bench 4.0 等測試結果,用來說明模型在多步驟終端任務上的表現。官方註腳也指出,不同模型採用的推理強度、執行環境與成績來源並不完全一致,因此不宜把單一分數解讀為所有情境的勝負。若團隊要換模型,最好拿自己的程式庫與任務清單比較完成率、審查時間和總成本。
Opus 5.5 的價值主張更接近「在長任務中維持能力,同時降低每次交付成本」。創意作品值得看,但真正的採用決定,仍要由可重現的任務測試來支持。
一段漂亮的影片,能證明哪些事?
Ryan Sael 的鏡頭實驗頁值得看,因為它不只是一張靜態截圖。讀者能拖動焦點環,看到鏡片與清晰平面跟著變化;這能檢查模型是否把抽象概念轉成可探索的互動。但這仍是創作者挑選後公開的成品。它不會告訴我們同樣需求重做十次的成功率,也不會顯示原始程式在半年後是否容易維護。
對設計團隊,這類示範最有用的地方是縮短「想法到可討論原型」的距離。產品負責人可以拿它測試概念是否能被理解,設計師再修正資訊層級與互動細節,工程師最後檢查效能、鍵盤操作、資料與部署。把原型當成討論材料,比把它直接當成正式產品更符合目前證據。
40% 成本下降,怎麼拆開算?
若只看標準 API 單價,Opus 5.5 每百萬輸入 token 為 4 美元、輸出為 20 美元;Opus 5 分別為 5 美元與 25 美元。假設兩個模型都剛好使用一百萬輸入與一百萬輸出 token,單價合計會從 30 美元降到 24 美元,差距是 20%。Anthropic 所說的典型任務成本降低約 40%,還包含新模型完成任務時可能使用更少 token,以及快取讀取降價。
這也解釋了為什麼不能只看一次問答價格。長程編程會反覆讀取既有檔案、呼叫工具、修正測試失敗;快取命中率與返工次數可能比每百萬 token 的牌價更影響總帳單。團隊試用時,應以「完成一個驗收合格任務的成本」作比較,而不是只比單次回覆。
評測比較的盲點在哪裡?
官方基準測試能提供方向,但測試環境、推理強度和外部模型成績來源都會影響結果。Anthropic 的 Opus 5.5 發表頁在 Terminal-Bench 4.0 圖表下列出這些條件,因此「某張圖領先」不應被寫成所有使用情境全面勝出。對真正要採購 API 的團隊,能不能在自家程式碼上穩定通過測試,比排行榜名次更重要。
什麼團隊最可能從 Opus 5.5 受益?
若團隊常做跨多個檔案的修改、長時間程式碼稽核或可驗證的原型製作,Opus 5.5 的能力與成本變化值得試。Anthropic 在發布文中把長程遷移、審核和代理編程列為強項,也提供了早期測試者的案例。這些案例說明可能的用途,但仍應在自家程式庫重做測試,因為專案架構、測試覆蓋率與工具設定都會影響結果。
若工作只是固定格式改寫或短問答,選擇更便宜的模型也可能足夠。最好的模型不一定是基準測試分數最高的模型,而是能在指定品質與時間內,以最低總成本完成工作的模型。對使用者來說,這也避免為了展示效果而把每個小任務都交給最昂貴的選項。
從示範作品走到正式產品,還差哪幾關?
以互動教學頁為例,除了畫面與動畫,正式上線還要檢查手機尺寸、文字對比、鍵盤操作、效能和錯誤狀態。若頁面涉及真實數據,還要確認來源、更新日期與數值計算。AI 可以讓第一版更快出現,但驗收標準並不因此降低。Ryan Sael 的展示最適合作為創意編程的入口,真正的團隊導入則需要一份可重現的測試紀錄。
如果要實際試用,先設計一個可重複的題目
創意編程可以選一個有明確互動要求的頁面,例如「可調整參數的教學示範」,同時要求鍵盤可操作、手機版不溢出、圖表標示清楚。讓兩個模型在相同時間、相同工具與相同驗收標準下完成,再記錄首次可用版本花了幾輪、哪裡需要人工修正。這比只看最漂亮的展示,更能回答團隊是否值得換模型。
長程工程任務則要分開觀察「看懂原有程式」「做出變更」「通過測試」「留下可審查差異」四個環節。模型能快速寫出畫面,不等於能安全修改既有系統;模型在某個基準測試表現好,也不保證符合你的程式碼風格與部署約束。