EnvHarness 研究解析:Google 讓 AI 練習環境跟著弱點改變,分數如何公平比較
EnvHarness 用外部元件調整代理練習環境,保留原始成功判定。本文解釋 Setup、Rule、Link 與診斷循環,解讀未修改環境上的評測結果,整理開發者重現與採用條件。
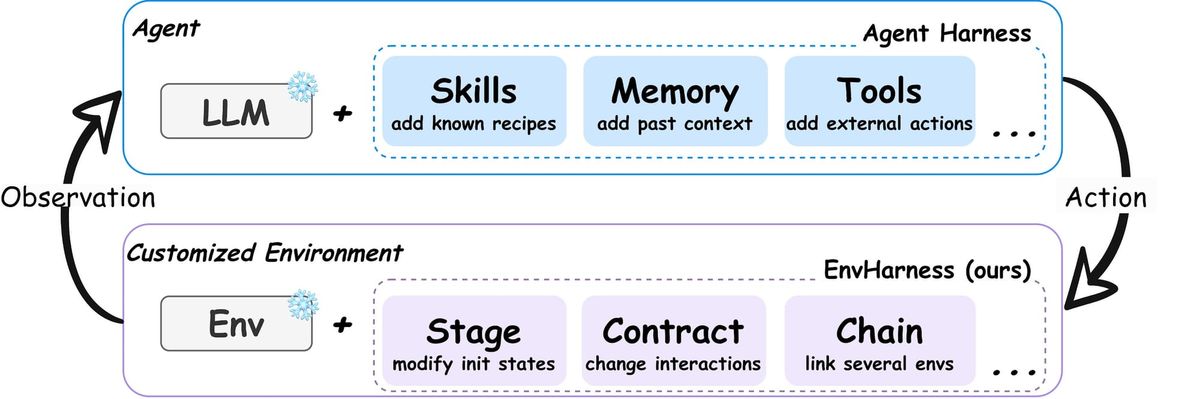
EnvHarness 在 Google Research 的會議貼文裡,提出了一個不同的訓練方向:如果代理一直在同一個世界練習,環境能不能跟著它的弱點改變?
這不是讓 AI 任意改考卷答案,而是把環境外圍變成可配置的教學層。原本任務的成功判定仍然保留,變動的是起始情境、互動方式和可看到的資訊。
Google Research 於 10 月 7 日分享 COLM 展示,研究本身則已在八月公開。這次是會議資訊再分享,適合結合既有論文與程式庫一起閱讀。
對代理開發者,固定環境的問題很具體:同一批練習如果已被解完,繼續執行未必增加能力。如果任務太難,代理也可能反覆卡在相同地方,留下一堆相似失敗。
我的判斷是,EnvHarness 最值得借用的是先讀失敗、再調整練習的結構。它讓訓練環境也有設計者,但成效仍要回到沒有修改的測試環境確認。
如果你正在改善瀏覽器、程式或試算表代理,這項研究提供了一條可探索路徑。先分清楚哪些層可以變、哪些規則應固定,才能判斷分數提升來自學習,還是考試被改得更容易。
EnvHarness 改的是練習入口,保留原本的成功條件
原始論文把 Environment Harness 定義為包在靜態環境外的可程式化元件層。
它透過標準互動介面工作,而不直接重寫底層環境程式。
可以把環境理解為代理做事的地方:一個模擬房間、測試網站、程式庫或試算表。代理看到資訊、選擇動作,再取得結果,反覆走完這個循環。
外層包裝的好處是減少重新建世界的工程。若每次想針對弱點設計練習,都要重寫整套網站或模擬器,維護負擔很大。可組合元件則能重用既有環境。
但是,重用不代表可以任意改變評分。官方設計保留原本判斷成功的條件,讓代理學到的技能仍需要完成同一類真實任務,而不是靠新規則取得獎勵。
這個區分對評測非常重要。訓練時可以調整觀察與互動,測試時卻要知道什麼被恢復原狀,才能說明能力是否真的轉移到原本的工作。
Setup、Rule、Link,分別解決哪一種練習需求
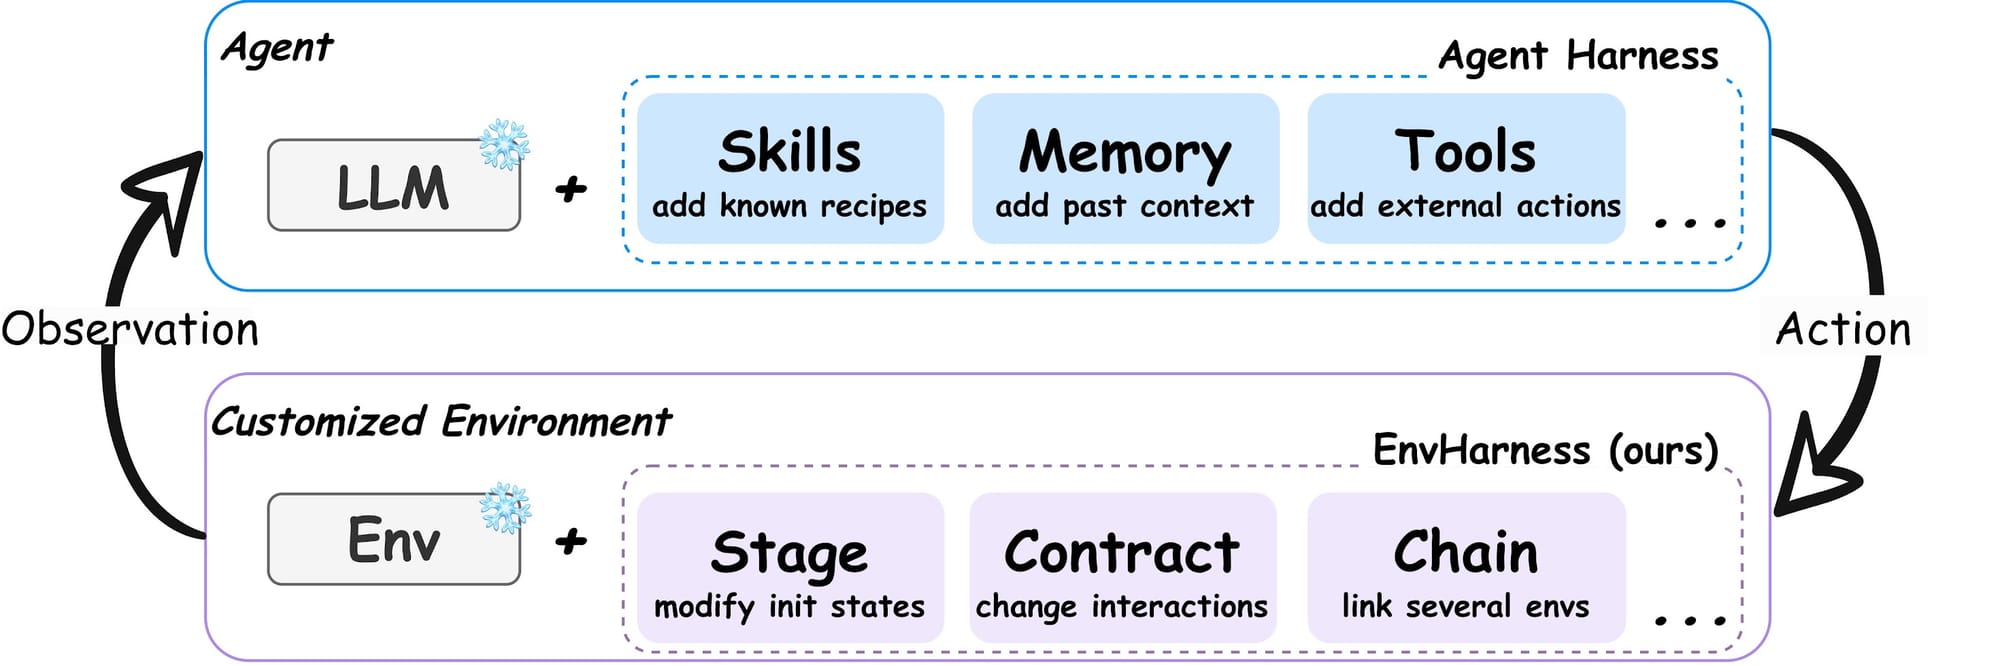
官方程式庫把外層拆成三種元件:Setup 調整初始狀態,Rule 調整互動,Link 連入另一個環境的任務。名稱不同,是因為它們改變的時間與位置不同。
Setup 可以理解為安排練習從哪裡開始。假設代理每次都卡在某個操作階段,從相關狀態練習,比重做全部前置步驟更可能把時間花在真正弱點上。
這是本文用來解釋機制的假設例子,不代表所有環境都自動支援任意中途狀態。實際能調整多少,仍取決於該環境如何提供狀態與重置介面。
Rule 改的是互動過程,例如可採取的動作、動作效果或觀察資訊。這讓設計者可以針對行為缺陷安排條件,但不能拿它當成直接改掉驗證器、讓錯誤結果算成功的工具。
Link 則讓不同環境的任務能被連接。它關心練習之間的組合,而不是隻把同一個任務的難度調高,對需要多種能力接力的代理尤其值得研究。
三種元件可疊在一起,但越多變動越需要保存版本。如果同時改起點、工具與任務組合,最後表現提升,團隊仍要能回頭辨認是哪一層提供了有效學習。
設計者先讀軌跡,再決定如何調整環境
代理的軌跡,是一次任務中看到了什麼、選了什麼動作、取得哪些結果的紀錄。它比最後成功或失敗的一個標記更有診斷價值,因為同樣失敗可能來自不同原因。
例如瀏覽器代理找不到資料,可能是搜索不精確,也可能是找到頁面卻沒有讀關鍵段落。只看最終失敗,兩者都一樣。讀互動過程,才知道練習應針對哪一段。
EnvHarness 的設計者角色根據這些紀錄辨認弱點,產生元件,測試新的環境,再依結果修改。它不是事先固定一個難度選單,而是嘗試用程式表達針對性練習。
這也提醒開發者,設計者本身需要可檢查的材料。如果軌跡缺少工具輸入、回應或錯誤,新的環境可能只是針對猜測調整,會把原本不清楚的問題轉成另一個不清楚的問題。
本文建議,先挑一種反覆出現的錯誤,確認它有清楚發生位置,再測試一項環境改動。這比同時修所有弱點更容易知道設計者到底改善了哪種行為。
而且,錯誤類型也會改變。代理學會基本搜尋之後,下一個問題可能是資訊比較。因此診斷循環要重複,以新軌跡決定新練習,不是永久套用第一次生成的環境。
學技能與訓練模型,是兩種不同的成效路徑
官方程式庫同時提供技能生成與強化學習的研究路徑。技能可以理解為從執行經驗整理出的操作知識,在後續任務中取用。強化學習則用互動回饋調整策略。
技能改善不一定意味模型權重已經更新。如果代理靠額外的指引做得更好,這仍有價值,但應說明知識如何提供,而不是把它全算成模型本身已經學會。
對實務團隊,這個差異影響維護方式。技能可以查看、修改與換版,模型訓練則有資料、運算與部署需求。在選擇路線前,應知道自己有能力維護哪一種成果。
如果只是要改善某類程式問題,可以先檢查從練習提煉的技能是否可用。若目標是整體策略提升,才需要對照強化學習資料與訓練流程,不能從技能表格直接推導訓練收益。
兩條路徑也可能互相支持,但評測不能混用。取得外部技能的代理,與沒有同等知識的基準比較,需要說明這項差異,才能讓使用者估計實際部署要提供哪些額外材料。
延伸閱讀:HarnessSQL 研究讓 AI 在資料庫環境裡練習:生成 SQL 之前,先學會查證
回到未修改環境測試,才知道練習有沒有轉移
官方結果的關鍵是,從調整環境提煉出的技能,回到未修改的原始基準接受測試。這比只在新的練習世界取得高分,更能支持「學到可轉移能力」的判斷。
結果表比較沒有技能、原始環境取得的技能,以及 EnvHarness 取得的技能。這三組能分開看出額外知識本身的幫助,以及環境調整是否比原本練習再多帶來改善。
作者報告的最高加九個百分點,對應 ALFWorld 的分佈外測試與原始環境技能比較,不是所有任務平均都提升九點。
分佈外指測試情境與訓練常見情境有差異,能提供另一種轉移觀察。
同樣地,約減少 9.8% 互動步驟,來自 SWE-bench Verified 表格中 55.01 降到 49.61 的比較。
步驟減少不等於所有任務完成時間都縮短同樣比例,每一步的計算或等待仍可能不同。
官方表格使用固定模型比較技能來源,並報告三次執行的平均與變異。若自行換模型、取用不同環境或修改題數,數值自然不能直接對上原表,需要重新建立可比較條件。
這種讀法可以避免把不同領域的結果攤平成一個漂亮數字。瀏覽器操作、程式修改與試算表處理有不同難度,開發者應先看接近自己的任務,再判斷是否值得花時間重現。
重現前,先確認環境、模型與資源三者匹配
程式已公開,不代表一條指令就能跑完所有基準。官方 README 要求讀各實驗目錄的說明,因為網站、容器、資料和評分流程會隨任務類型改變。
一般模型配置也不一定等於產生論文表格的配置。官方說明指出,倉庫預設模型與結果表使用的 Gemini 配置不同,重現者要對照設定,不能跑默認值後直接判定論文結果不成立。
模型存取還會受到額度限制。README 提醒,過高併發可能造成請求限制,任務中途被截斷後看起來像成功率低。因此設定應跟隨可用服務額度,而不是隻看本機有幾個核心。
對開發者,最低成本的開始是選一種基準、確認環境啟動,再用少量任務跑通同一流程。這是重現前的準備建議,不是本站已完成全部基準測試或保證你的裝置可以執行。
若要接新環境,官方要求實作共同介面,包含重置、動作、觀察與評估。新增環境的工程仍然存在,只是讓後續設計者與元件可以重用,而不是完全免去適配工作。
狀態保存尤其需要注意:資料與執行中的瀏覽器、容器連線不同。官方要求傳遞的狀態只帶資料,這有助於讓生成元件在獨立行程裡運作,避免把暫時的執行對象誤當可還原環境。
讓練習變難,也要能說明教的是什麼
難度不是愈高愈好。若代理幾乎每次都在第一步失敗,留下的資訊可能不足以學到新策略。若每次都輕鬆完成,新的環境也沒有真正針對弱點。
團隊可以從軌跡查看,改動之後是否出現更多與目標能力相關的決策。例如想練資料比較,環境應讓代理需要辨認不同證據,而不是單純把無關操作步驟加長。
這個判斷仍要回到原始測試。新練習看起來更複雜,卻沒有提升實際任務,可能表示教學訊號沒有對準。此時應修正診斷,而不是把更長軌跡當成更多學習。
實際採用,先選一種明確且可驗的弱點
如果代理目前主要因權限不足或資料缺失而失敗,調整練習不一定是最先要做的事。先修復輸入與工具條件,才能把剩下的失敗視為可以學習的能力問題。
若軌跡已顯示反覆犯同一種行為錯誤,再設計針對性練習比較合適。比如總是忘記查看現有測試,可以先建立需要辨識測試資訊的情境,觀察是否在原始任務也改善。
這個例子是團隊可自行設計的方向,並非官方已證實能修正所有程式代理。採用時仍要保留原始任務組,避免只驗收新環境裡表現好看。
一個實用的停止點,是新練習不再改善原始測試。此時繼續生成更複雜元件,可能增加成本而沒有轉移收益,應重新讀失敗軌跡,確認是否已換成另一種問題。
官方亦標示這不是受正式支援的 Google 產品。團隊可以研究與改用公開程式,但需要自行評估維護、適配和執行環境,不能把研究倉庫當成附服務承諾的企業方案。
延伸閱讀:GitSwarm 是什麼?Meta 用共享 Git 記憶讓 AI 代理接力,團隊如何借用這套方法
EnvHarness 常見問題
環境會變,評分不就不公平了嗎?
官方設計保留底層成功條件,並把取得的技能放回未修改的原始基準測試。讀者應檢查訓練與測試的邊界,不能只看調整環境本身的成功率,就判定代理能力提高。
最高加九點,能套到所有代理嗎?
不能。它對應指定模型、技能來源與 ALFWorld 分佈外測試的比較。其他資料庫、網站或模型需要重做對照,百分點也不能改寫成整體能力成長九成。
是每個使用者都能直接套用的 Google 服務嗎?
這是公開研究程式,官方說明不是正式支援產品。需要準備環境、模型與各基準資料,適合能檢查研究設定的開發者,不能用產品開通流程理解它。
讓環境成為教學工具,也讓測試維持可信
EnvHarness 提供的方向,是讓代理的練習世界能夠回應它的弱點。能力改善的證據,是學到的技能回到原本工作後仍然有效。
我會先用一個明確錯誤與一種基準試驗,再決定是否擴大。能同時保留診斷紀錄、環境版本與原始測試,才有機會把動態練習變成可信的能力改善。
若你想持續追蹤代理訓練與評測,歡迎免費訂閱 AI 郵報。