FAHR-FaceAge 如何估癌症患者存活風險?生物年齡、模型預測與臨床界線
FAHR-FaceAge 與 FAHR-FaceSurvival 是 Mass General Brigham 的臉部健康研究工具。本文拆解逾 4,000 萬張訓練影像、生物年齡與癌症患者存活風險的差異,說明熱區圖能告訴我們什麼,以及為何研究結果不能直接當成自拍診斷或個人壽命預言。

一張自拍能不能看出健康狀況,最近又因 FAHR-FaceAge 研究受到討論。但「看起來幾歲」與「是否患癌症」,是完全不同的問題。
Mass General Brigham 於 2026 年 10 月 19 日介紹新的臉部健康 AI 研究。團隊先用超過 4,000 萬張臉部影像建立基礎模型,再發展估計年齡與分析癌症患者存活風險的工具。
基礎模型是先從大量資料學習共同特徵,再調整成不同用途的 AI。這次同一個起點產生兩種工具,因此不能把所有成果都簡稱為「看臉診癌」。
研究關心的是照片包含哪些可量化的健康訊號。因為人體狀況會影響外觀,影像可能提供額外資訊,卻不會因此取代病史、檢查與醫師判斷。
對一般讀者而言,最值得理解的是預測的對象與範圍。癌症患者群體中的存活風險,無法直接回答一個健康的人有沒有癌症。
這項研究適合用來觀察醫療 AI 如何尋找新指標。要判斷它離日常診療有多遠,得先分清楚兩個工具各自在估什麼。
FAHR-FaceAge 與 FaceSurvival 分別預測什麼?
年齡工具與存活工具使用不同目標訓練,因此輸出回答的問題不同。依 Mass General Brigham 官方介紹,前者估計生物年齡,後者直接學習癌症患者的存活結果。
日曆年齡是從出生算起的年數,生物年齡則試圖描述身體的老化狀態。研究以臉部特徵估計相關訊號,但它仍是一個模型估計值。
如果某個人的估計值高於實際歲數,能提出的是值得研究的差異。單憑這個落差,無法知道是哪一個器官、哪一種疾病造成。
存活工具則把訓練問題換成患者後續的存活資料。它不必先把臉轉成一個年齡,再透過年齡間接推算,因此可能抓到不同線索。
以下把兩種目標分開,較容易看懂新聞標題省略了什麼。
| 工具 | 主要研究目標 | 不應直接推論的事情 |
|---|---|---|
| FAHR-FaceAge | 從臉部照片估計年齡相關健康訊號 | 外觀落差等於特定疾病 |
| FAHR-FaceSurvival | 分析癌症患者的存活風險 | 一般人自拍可以診斷癌症 |
| 兩者結合 | 檢查是否提供互補資訊 | 每個人都能得到準確死亡日期 |
表格裡的差別也解釋了,為什麼團隊同時研究兩種輸出。官方報告指出,兩者相關程度較弱,但各自仍與存活結果獨立相關,合併後在外部驗證族群改善了存活模型的擬合。
模型擬合描述分析方式與觀察資料對得上的程度。這項結果支持兩種訊號具有互補價值,但仍需要另外驗證,醫療人員實際使用後是否改善照護。
但「互補」不等於任何人上傳照片都適用。研究對象、拍攝條件與後續追蹤方式,仍然決定結果能用在哪一群人。
4,000 萬張影像,為何不能當成 4,000 萬名癌症患者?
訓練影像的數量描述學習資料規模,臨床患者人數描述醫療驗證範圍。兩者分母不同,因此數字再大也不能互換。
團隊以大量影像學習臉部表徵,也就是能供後續模型使用的特徵。之後才用帶有年齡或健康結果的資料,調整特定任務。
例如學會辨認臉部輪廓,與學會判斷治療後的結果,需要的標籤不同。前一階段可以使用大量一般影像,後一階段則需要臨床資料配合。
這使研究的證據至少有兩條路徑。一條確認模型能否處理臉部影像,另一條確認影像推算出的數值,是否與患者後續結果有關。
讀者若只看到資料量,容易把兩條路徑合在一起。但模型看過很多照片,仍可能在特定醫院、年齡或疾病族群表現不同。
預印本與正式論文的數字要分開
這項工作已有 2025 年公開預印本,後來於 2026 年刊登正式研究。因此 10 月新聞是正式發表脈絡,並非所有方法都在當天首次出現。
預印本是正式期刊審查前公開的研究版本。資料整理、分析與文字可能在後續改動,引用時應註明版本,而不是把不同版本的人數混成同一張表。
例如舊版摘要列出的年齡微調影像和存活訓練影像數,不能直接拿來替正式版補齊未列出的細節。想重做計算的人,需要對照同一版本的方法與結果。
這也提供一個判讀醫療新聞的習慣。先確認報導連到哪篇論文,再看新聞數字是否出自相同研究階段,才能避免把舊結果包成新突破。
風險較高,為何不等於某個人的死亡機率?
群體風險比較的是一組患者相對另一組的情況,無法直接換算成單一個人的結局。因為個人結果還受到病情、治療與其他健康因素影響。
研究常使用危險比,描述追蹤期間兩組事件發生速率的相對關係。這個比較需要保留群體與時間背景,才能理解結果,個人壽命和死亡機率則需要不同資訊。
要讀懂一個危險比,至少需要知道比較哪兩組、追蹤多久,以及分析調整了哪些差異。只留下「風險增加幾倍」,會把必要背景拿掉。
同樣地,平均年齡誤差也不是每張照片都差同樣歲數。它把許多樣本的誤差彙整,個別照片可能更接近,也可能差得更多。
排序能力與個人預測,還差了什麼?
模型能把一群患者排成較高與較低風險,和能準確給出每個人的風險數值,是不同要求。前者排序正確,並不保證後者的數字已經準確。
假設兩個工具都把同一人列為較高風險,但給出的絕對機率差很多。臨床若要依數字安排後續處置,便需要知道哪個估計更接近實際結果。
所以醫療應用還需要校準,也就是檢查模型說的風險與後續觀察是否對得上。這一步會影響醫師如何使用輸出,而不只是研究分數好不好看。
患者來源也會影響校準。若新醫院的病情組成、治療方式或追蹤條件不同,原先模型可能需要重新驗證,才能知道數字是否仍可靠。
對讀者來說,這就是「研究有關聯」與「可以依結果採取醫療行動」之間的重要距離。兩者需要不同層次的證據。
延伸閱讀:Google AI 濕實驗室研究:VERID、適體與蛋白質設計的三個進展
臉部熱區圖,能不能解釋疾病原因?
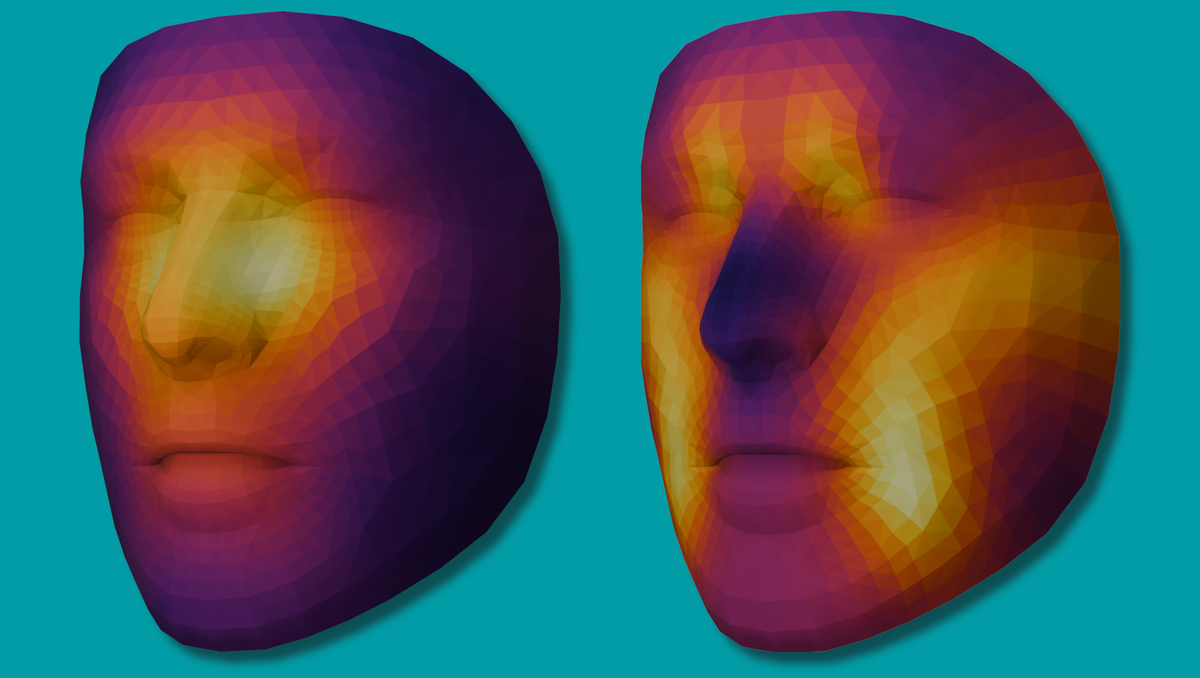
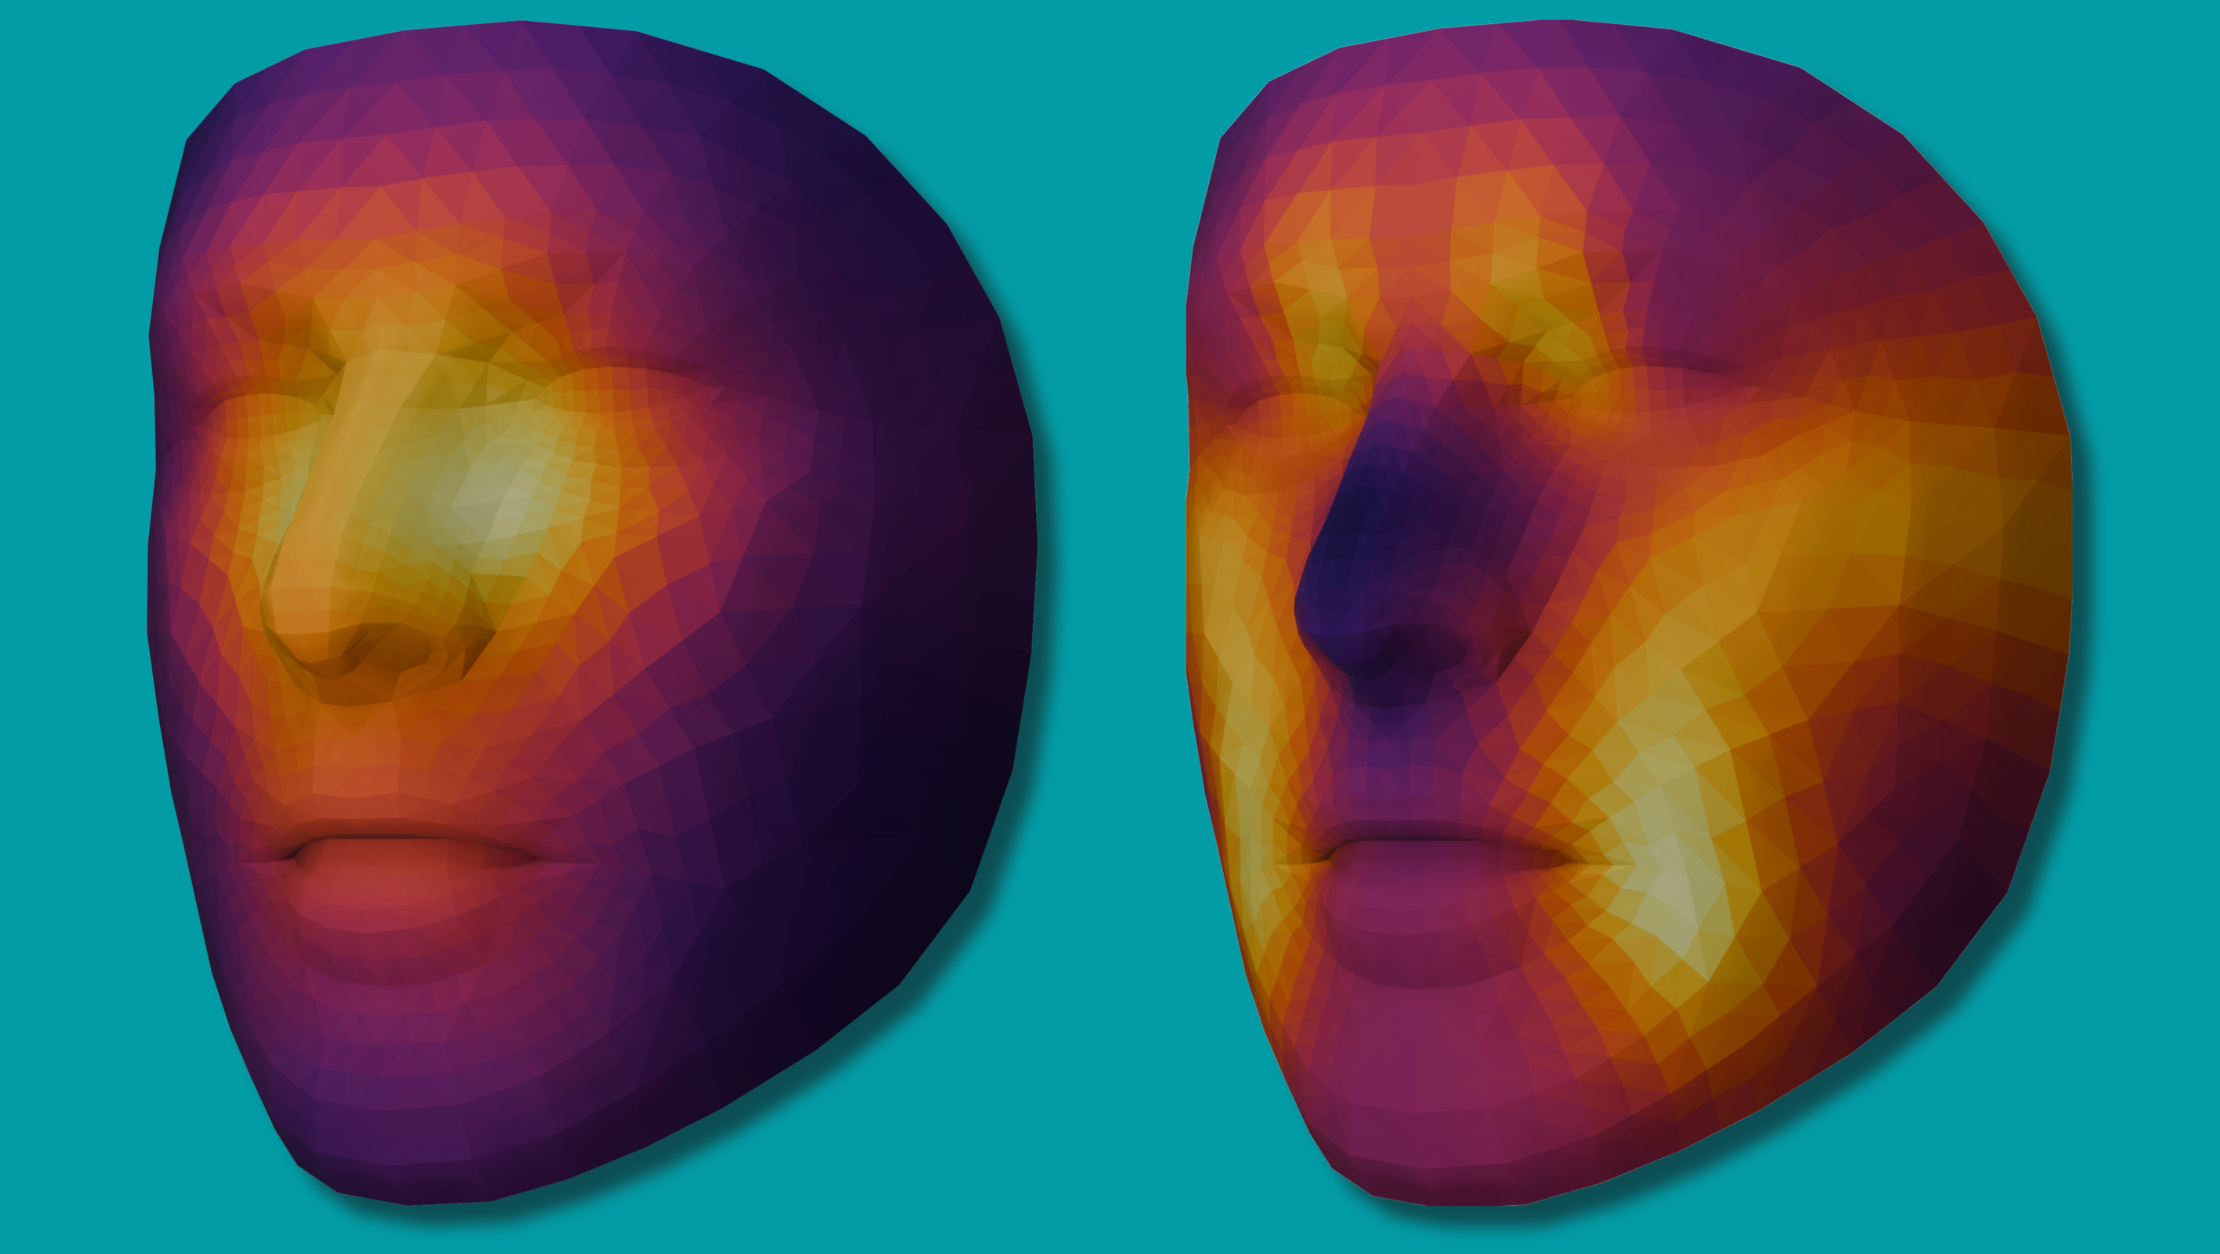
熱區圖顯示哪些影像區域對模型輸出影響較大,讓研究者比較工具如何利用照片。但重要區域不會自動成為疾病原因。
官方圖示顯示,存活工具與年齡工具關注的臉部位置不同。黃色區域代表對各自預測較有影響的部分,因此看圖時也要先辨認左右對應的模型。
這類圖有助於提出研究問題。例如兩種工具關注位置不同,是否支持它們學到互補訊號,可以再配合統計分析確認。
但從「模型看這裡」走到「這裡造成疾病」,中間缺少因果證據。外觀也可能與年齡、生活因素、治療或拍攝環境共同變化。
如果把熱區誤當成病灶,便可能讓讀者開始自行檢查臉上某條紋路。這已超出圖示能支持的結論,也偏離研究本來的用途。
照片品質則是另一個獨立問題。模型若對光線或角度敏感,可能把攝影差異算進健康估計,所以測試常見拍照變化有實際意義。
團隊表示已檢查姿勢、光線、表情與化妝等條件下的穩定性。但涵蓋測試條件,仍不等於所有手機、族群與使用場景都已證實相同表現。
因此好的圖說應交代它是模型影響區域的示意。讀者知道圖在解釋預測過程,就比較不會把視覺化當成診斷畫面。
從研究工具走到診療,還需要回答什麼?
醫師是否因為多看這個數值,做出更適合患者的決定,是比預測分數更接近臨床的問題。即使統計表現改善,工作流程仍需要另外驗證。
例如新指標可能使風險討論更一致,也可能帶來更多誤報或額外檢查。研究要比較實際好處與負擔,才能知道增加的資訊是否值得使用。
工具放在哪個時間點,也會改變用途。治療前評估、治療後追蹤和一般健康檢查,面對的問題不同,不能因為都使用照片就視為同一任務。
如果模型結果與醫師原本判斷不同,系統還需要清楚呈現不確定性與適用範圍。只給一個年齡數字,可能使人對精確程度產生過高期待。
對醫院而言,導入還涉及照片取得、資料保存和誰可以查閱。因為臉部照片能辨識個人,方便拍攝也不能省略對資料用途的說明。
研究參與與取得醫療診斷的差別
團隊另外提供 FaceAge Research Study。官方把它描述為研究參與入口,目的是收集更廣泛資料,協助改善與驗證臉部老化指標。
研究回饋與醫療服務需要分開理解。收到估計值,並不表示完成癌症篩檢,也不表示原先檢查、回診或治療安排可以改變。
有興趣了解研究的人,可以先閱讀參與條件與資料用途,再決定是否提供照片。本文沒有上傳任何人的影像,也沒有替讀者做個人健康評估。
這項技術能否走進日常診療,仍要靠後續研究證明。現階段最有用的閱讀方式,是看清楚每項數字究竟支持哪個問題。
為什麼回頭分析與實際使用,需要不同驗證?
回溯研究使用已經留下來的照片和結果,能檢查過去資料中的關聯。但資料當初為何被收集,可能影響哪些患者有照片、哪些人有完整追蹤。
若只有某種治療的患者經常拍照,模型分析的範圍便不等於所有患者。因此閱讀研究時,要先看納入條件,才能知道哪些人沒有出現在結果裡。
前瞻性驗證則先設定方法,再觀察後續結果。它可以更接近工具預計使用的環境,也比較容易記錄實際操作中的缺圖、重拍與判讀問題。
兩種研究各有用途。前者有助於找出值得繼續測試的訊號,後者則更接近回答,醫療人員在真實工作中使用它時會遇到什麼。
另一個問題是模型隨時間是否仍適用。治療方式、患者組成與攝影設備都可能改變,因此驗證不能只停在最初發表的一次成績。
對關心醫療 AI 的讀者,後續值得追蹤的便是這類證據。相較於再增加多少訓練照片,工具能否在新的醫院與流程保持可靠,會更直接影響實際用途。
延伸閱讀:Antigravity 抗菌肽研究:Google 如何串起蛋白質資料,為什麼還要做實驗?
FAHR-FaceAge 常見問題
自拍可以判斷自己有沒有癌症嗎?
這項研究不能支持這種使用方式。存活分析針對癌症患者資料,與對一般人做癌症診斷或篩檢是不同任務。
看起來年輕,就代表一定比較健康嗎?
外觀是可能包含健康訊號的資料來源,但不足以決定個人健康。模型估計也會有誤差,因此不能用一次輸出取代醫療檢查。
FAHR-FaceAge 與舊版 FaceAge 是同一份研究嗎?
兩者屬於相關研究方向,但新工作採用更大規模的基礎模型與不同下游任務。比較成果時,要先對照論文版本與研究對象。
黃色熱區代表癌症長在哪裡嗎?
熱區描述影像哪些位置影響模型判斷,不能定位腫瘤。它是理解模型使用訊號的工具,與人體檢查影像的意義不同。
這項進展對一般人最有意義的是什麼?
它展示低成本影像可能提供新的健康量化方式。是否能改善醫療決策,還要看外部驗證與臨床流程研究。
把自拍研究看成新指標,才能理解它的價值
FAHR-FaceAge 這類工作值得追蹤,因為它嘗試把主觀外觀觀察變成可檢驗的數值。但數值是否可靠、能用在哪裡,需要和模型規模分開判斷。
閱讀類似新聞時,可以先找預測對象、驗證族群與用途,再看驚人的數字。免費訂閱 AI 郵報,持續追蹤醫療與科學 AI 研究如何從模型走向實際驗證。