FastH3 Omni 是什麼?MiniMax H3 影片最多快 11.9 倍的條件與授權
FastVideo 開源 FastH3 Omni,把 MiniMax H3 的參考圖、影片與聲音生成壓到 8 次評估,官方在八張 GB200 上量到 5.6 到 11.9 倍的端到端延遲改善。本文整理測試口徑、本機硬體、授權的地區限制與導入前檢查。

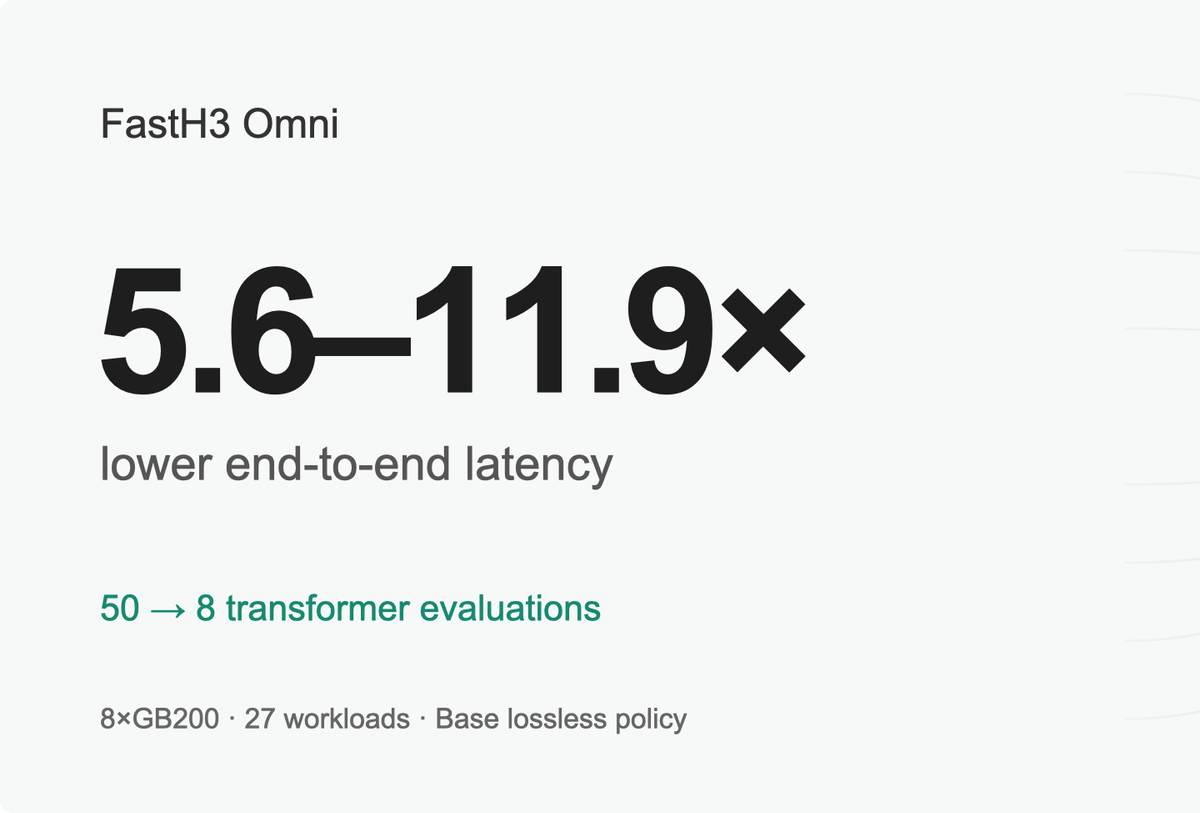
用一張人物照加一段提示詞,生成 10 秒帶人聲的影片,在八張 GB200 顯示卡上,MiniMax H3 原始版本平均要 78.53 秒,FastH3 Omni 只要 9.37 秒,比片長還短。
FastVideo 團隊在 2026 年 10 月 20 日公開這項成果,Hao AI Lab 的官方 X 帳號在台灣時間 10 月 21 日凌晨 3 點多發文,內容是在 NVIDIA Blackwell 上即時生成、快 12 倍。
這句話很容易被讀成所有 Blackwell 顯卡都能快 12 倍。但官方部落格把條件寫得很細:這個倍數來自八張 GB200 組成的伺服器,量的是端到端延遲,而且「約 12 倍」是 27 組測試裡的最高值。
我從官方表格重算,27 組倍數的簡單平均大約是 8.2 倍,中位數約 7.9 倍,最低 5.6 倍,最高 11.9 倍。
FastH3 Omni 是 MiniMax H3 影片模型的蒸餾版本,蒸餾是讓小而快的學生模型去模仿原模型的結果。它接受提示詞加上圖片、影片與聲音參考,一次生成帶同步聲音的影片,訓練程式碼也一起開源。
我的判斷是,有 Blackwell 伺服器、要做參考素材生成服務的團隊,值得現在就評估。想在家用顯卡上追求相同倍數的人,要先接受官方沒有給家用卡的速度數字,而且模型授權對使用地區有限制。
要判斷這個「12 倍」能不能用在你身上,得先弄清楚它比較的是什麼。
FastH3 Omni 是什麼?提示詞加參考素材,一次生成影片與聲音
FastH3 Omni 解決的是「參考素材生成」,也就是你提供人物照、動作影片或聲音樣本,模型照著生成新影片,並同步配音。
底層的 MiniMax H3 是 MiniMax 在 8 月 2 日釋出權重的影片模型,授權日期標在同一天。FastVideo 是加州大學聖地牙哥分校 Hao AI Lab 維護的開源影片加速框架。
FastH3 Omni 由 FastVideo 團隊與 Nuva Lab 合作完成,Reactor 提供運算資源,並採用 NVIDIA FastGen 團隊提出的方法。這些合作夥伴的名字,會在風險章節回頭說明,因為成果與推廣出自同一批人。
依 Hugging Face 上的模型說明,輸入是一段提示詞,加上最多 9 張圖片、3 段影片與 3 段聲音,總共不超過 12 項參考,其中至少要有一張圖或一段影片。
輸出是 24 幀每秒的影片,附 32 千赫的立體聲。片長為 124、243 或 362 幀,也就是約 5、10 與 15 秒,實際能做多長取決於執行環境與記憶體。
部落格的對照範例有廚房做早餐、對著鏡頭說話的場景。但這些影片是官方挑選的範例,部落格也註明它們用於直接檢視,並不是量化的品質評估。
本文附的 28 秒示範片來自官方部落格,官方說整支影片都由 FastH3 Omni 生成。它只能說明模型的輸出形式,不能代表你的素材也會有同樣的效果。
了解它做什麼之後,就能看那個備受討論的倍數是怎麼量出來的。
12 倍怎麼來的?27 組測試、八張 GB200 與比較口徑
「12 倍」其實是一個範圍的上緣,真正的結論是 5.6 到 11.9 倍,而且只在特定硬體與測試條件下成立。
官方設計了 9 種參考素材組合,各自搭配 5、10、15 秒三種片長,共 27 組。每組先暖機一次,再用三個隨機種子量三次,所以表格上的數字是三次的平均。
輸出規格是 1344×768、每秒 24 幀。量的時間從編碼參考素材開始,經過生成與解碼,直到完整的 MP4 產出,不含載入模型與啟動伺服器的時間。每次只送出一個請求,所以這是單一請求的延遲,並不代表同時服務很多人時的吞吐量。
下表摘出幾組官方數字,單位是秒。
| 條件 | 片長 | 原始 H3 | FastH3 Omni | 倍數 |
|---|---|---|---|---|
| 1 張圖 | 5 秒 | 35.44 | 5.67 | 6.25 |
| 1 張圖 | 10 秒 | 78.53 | 9.37 | 8.38 |
| 1 張圖 | 15 秒 | 139.69 | 14.14 | 9.88 |
| 1 段短影片 | 15 秒 | 140.29 | 11.76 | 11.93 |
| 9 張圖 | 5 秒 | 121.61 | 21.59 | 5.63 |
| 9 張圖加 3 段影片 | 15 秒 | 422.20 | 59.77 | 7.06 |
表格呈現了兩個規律。片長愈長,倍數愈高,例如 1 張圖從 6.25 倍升到 9.88 倍,我查過 27 組,每種參考組合都是如此。
圖片參考愈多,倍數愈低,5 秒片長時 1 張圖是 6.25 倍,3 張是 5.88 倍,9 張只有 5.63 倍。我推測是參考素材的編碼與前置處理占了較大比例,但官方表格沒有拆出這一段的時間。
比較對象也要看清楚。基準組是 MiniMax H3 的 Ref2VA 版本,做 50 次去噪評估,而且使用 SGLang 的 lossless 設定,不是更嚴格的 exact 設定,官方也說前者可能改變中間運算的捨入。
官方明確寫道,這比較的是完整的模型與服務方案,不是單獨量測蒸餾或核心運算的效果,也沒有證明兩者輸出完全一致。所以這是釋出團隊自己的測試,官方頁面沒有附第三方重現。
兩邊的模型權重、注意力方式與服務實作都不同,基準組用原始未量化權重與稠密注意力。八張 GB200 是研究團隊自己的環境,官方說 GB200 是 B200 的代用品,B200 並沒有另外量測。
「即時生成」的說法也要小心,因為官方的說法是「在特定的 FastH3 Omni 任務上,UniServe 對 768p 的 5、10、15 秒影片達到即時生成速度」。
我依官方表格檢查,生成時間短於片長的只有 6 組,都是 10 秒與 15 秒的單圖、圖加語音與單一短影片,其餘 21 組仍比片長長。
所以較合理的讀法是:在伺服器級硬體、較簡單的參考素材與較長的片長下,才接近即時。官方說的「特定任務」是哪些,部落格沒有逐一列出。
FastH3 Omni 為什麼快?用 8 次運算取代 50 次
它快的主因是把生成所需的運算次數從 50 次降到 8 次,再配上稀疏注意力。
影片生成模型多半靠反覆去噪,從雜訊逐步還原成畫面。原始 H3 要做 50 次完整的變換器評估,FastH3 Omni 只做 8 次,所以評估次數的減少,是速度提升最直接的來源。
官方說明,做法結合兩種技術。PDD 讓模型在一次評估裡預測好幾步的更新,輸出端從一個預測拓寬成 32 個時間區間,推論時以每 4 個區間為一組,共 8 組。
DMD 則是訓練時讓一個評審模型比對學生與原始老師模型的最終輸出,讓學生的成品分布接近老師,而不只是每一步的數值接近。
參考圖片、影片與聲音在整個過程中不加雜訊,始終當作乾淨的條件輸入。我的理解是,這樣參考素材的特徵就不會被雜訊蓋掉。
另外還用了影片稀疏注意力,也就是只計算畫面中比較重要的部分之間的關聯,訓練與推論使用同樣的稀疏設定,所以不是只在推論時才硬砍運算。
訓練成本官方也列了出來:64 張 NVIDIA B300,3,500 步,估計約 7,800 個 GPU 小時。我依官方數字相除,大約是每張卡跑 122 小時,約 5 天。
這個規模代表它屬於實驗室或企業級的訓練工作,個人團隊更可能是直接使用釋出的權重,而不是重現訓練。
看完訓練與推論的做法,要問的是不在機房的人能不能使用。
延伸閱讀:DMAD 是什麼?MiniMax-H3 影片生成壓到 4 步,24GB 顯示卡也有研究路線
在自己的機器能跑嗎?DGX Spark、RTX 5090 與 ComfyUI
能,但官方給的是「能跑」的設定,沒有給速度,預設解析度也只有 480p。
FastVideo 文件列了四種單機設定,差別主要在記憶體,因為記憶體大小決定模型能不能整個放進去。
DGX Spark 有 128 GB 統一記憶體,所有元件常駐,預設 480p。RTX 5090 有 32 GB,需要把文字編碼器移出顯示記憶體,並預先算好一張轉換表。
RTX PRO 6000 有 96 GB,可以跑 768p。RTX 4090 只有 24 GB,沒有 FP4 硬體,要用 FP8 版本,並讓模型逐層載入,文件還提醒要一個片段開一個程序。
這些設定的權重叫 NVFP4 QAD。NVFP4 是 Blackwell 世代顯示卡支援的 4 位元數值格式,QAD 是為了這種格式而訓練的量化感知蒸餾,用較少記憶體換取速度。它需要 Blackwell 的 FP4 硬體,所以 RTX 4090 不能用同一份權重。
官方部落格說得很清楚:八張 GB200 的時間,不能用來描述這些本機設定的速度。所以你在 5090 上能多快,需要自己量。
若你偏好圖形介面,官方也釋出 ComfyUI 用的權重。貼文說 ComfyUI 第一天就支援,我查 Hugging Face 的檔案列表,確實有 BF16、INT8 ConvRot、FP8 與 NVFP4 QAD 四種擴散模型檔,大小約 44、22、23 與 14 GB。
另外還要搭配文字編碼器與 VAE 檔,這些下載量也不小。官方提醒 ComfyUI 用自己的模型布局與運算核心,輸出可能和 FastVideo 不同。部落格則說本機版的完整文章排在 10 月 21 日。
要部署成服務,官方提供 UniServe,GitHub 說明寫它是預覽版的服務引擎,支援 GB200、B200、RTX PRO 6000 Blackwell,Hopper 系列則附需求與設定說明。
要特別注意安裝步驟。官方範例裡有用 curl 下載後直接交給殼層執行的指令,用來安裝 uv 與 Rust,因為這類指令會直接執行網路上的內容,所以我建議改成先下載、讀過內容再執行,或用作業系統的套件管理器。
授權與使用範圍:MiniMax H3 社群授權的地區限制
程式碼與權重的授權不同,權重適用 MiniMax H3 社群授權,其中對使用地區有明確限制。
FastVideo 與 UniServe 的程式碼是 Apache-2.0。但 Hugging Face 上的 FastH3 Omni 權重,授權欄寫的是 other,並指向 MiniMax H3 社群授權。
這份授權把「適用地區」定為全球,但排除歐盟、英國、南韓與美國。條文寫明在適用地區之外使用 MiniMax H3 的作品或其輸出,不在授權範圍內。
台灣不在被排除的名單裡,但團隊的客戶或發布對象若在這四個地區,就需要找法務判斷。我不是法律專業人士,這裡只是把條文標出來。
其他條件也影響商用。商業產品年營收超過 2,000 萬美元,要另外取得 MiniMax 的書面授權。商業產品的使用者介面要顯示「MiniMax H3」。
授權還禁止用這些作品或輸出去改善其他 AI 模型,所以拿生成的影片當訓練資料,也在禁止範圍內。再散布時要附上授權副本與 NOTICE 文字,並讓使用者受同等保護的使用限制約束。
可接受使用政策另外列了 20 項禁止用途,包括不得冒充他人,也不得在公開場合發布機器生成的內容而不清楚標示。這點對用聲音參考生成人物影片的團隊特別相關,因為成品常會公開發布。
爭議由香港法律管轄。MiniMax 聲明不主張輸出內容的權利,所以輸出內容出問題時,責任在使用者這一邊。
延伸閱讀:MiniMax H3 Max 是什麼?AI 影片生成快過播放,離即時直播還差什麼?
適合誰、不適合誰與導入前檢查
適合有 Blackwell 或 DGX Spark 等硬體、想評估參考素材生成速度的團隊,不適合期待在一般顯卡上達到官方倍數、或客戶主要在被排除地區的人。
如果你只是想偶爾做幾支短片,這個模型的門檻偏高,光是 RTX 4090 用的 FP8 變換器就約 47 GB,預設解析度又只有 480p。已經使用 ComfyUI 的創作者可以先照官方倉庫的說明試,但光是擴散模型檔就有 14 到 44 GB,要先留好硬碟與記憶體。
決定試用前,我會做這幾件事。先用自己的硬體實測一組最小任務,例如 1 張圖加 5 秒,記錄端到端時間,而不是引用官方倍數。
再把輸出和原始 H3 並排比對,看人物特徵與聲音有沒有走樣。因為官方只提供了質性對照,也說相同種子不保證兩個模型的輸出相同,所以只能自己比。
然後讀完授權與可接受使用政策,確認使用地區、營收門檻與標示義務。最後才考慮服務化,並規劃誰負責內容審核與舉報機制。
授權第 V 節要求,如果你提供讓第三方生成輸出的服務,就必須維護合理的技術與組織防護措施,並有可回報違規的管道。這不是小事,團隊要預留人力。
限制與風險:自家評測、合作利益與預覽狀態
最大的風險是目前所有數字都來自釋出團隊自己,沒有第三方重現,其次是服務引擎仍是預覽版。
部落格的聲明很直接:樣本使用同一個種子,是質性對照,不是輸出一致的證據。另外,基準組只量了官方選定的一種設定,也就是 lossless 數值策略加上特定的平行方式,換成別的設定會是什麼結果,官方沒有給數字。
合作關係也值得知道。Nuva Lab 與 FastVideo 共同開發模型,並定義與整理參考資料集,Hugging Face 說明頁還附了 Nuva Lab 的專屬部署與微調服務連結,看起來是它們的商業服務入口。
Reactor 提供運算,NVIDIA 的團隊貢獻了方法與核心運算。這些都是研究合作常見的安排,但讀者應該知道,推廣與技術成果由同一批人發布。
UniServe 在 GitHub 上的說明是「預覽版」,倉庫建立於 6 月底,所以正式環境要預留介面變動的空間。RTX 4090 與 5090 的設定也標明只用於特定硬體,服務設定尚未在每種裝置上驗證成伺服器。
UniServe 的 README 範例用 --host 0.0.0.0 啟動服務,也就是讓它監聽所有網路介面,我在 README 裡沒有看到驗證設定的說明。要對外開放之前,得自己加上驗證與防火牆。
還有一個不是技術的風險:聲音參考可以讓人物說出參考聲音的音色。授權禁止未經同意的冒充,所以任何使用真人聲音的流程,都應先取得本人同意。
FastH3 Omni 常見問題
FastH3 Omni 的 12 倍是在什麼硬體上?
在八張 NVIDIA GB200 上,比較對象是 50 次評估的原始 H3,結果是 5.6 到 11.9 倍。
官方說明 B200 沒有另外量測,本機顯卡也沒有給倍數。
一般家用顯卡能達到 12 倍嗎?
官方沒有給家用卡的速度數字,部落格也明說 GB200 的結果不描述本機設定。
可以確定的是,RTX 5090 與 DGX Spark 有 480p 預設設定,RTX 4090 需要 FP8 版與逐層載入。
FastH3 Omni 可以商用嗎?
程式碼是 Apache-2.0,權重適用 MiniMax H3 社群授權,允許商用,但有地區限制、營收門檻與標示義務。
在歐盟、英國、南韓與美國使用,不在授權範圍內,建議先請法務確認。
FastH3 Omni 和之前的 FastH3 有什麼不同?
之前的 FastH3 是從 MiniMax H3 蒸餾出的 4 步與 8 步模型,官方 README 就把它描述成能同步生成影片與聲音。Omni 這版的重點是加入圖片、影片與聲音參考。我沒有逐一核對舊版是否支援參考輸入。
官方 README 的更新紀錄列出 8 月 27 日的 FastH3 Preview v1、9 月 15 日的 8-Step V2 與 10 月 6 日的 Trim,Omni 則是 10 月 20 日部落格公告的新版本,短短兩個月已經陸續釋出多個變體。
先量自己的硬體,再決定要不要相信倍數
FastH3 Omni 讓 15 秒單圖影片的生成從 139.69 秒縮短到 14.14 秒,這是在特定伺服器、特定測試下的成果,值得認真評估。
如果你有 Blackwell 硬體,先用最小任務實測一次,把授權的地區與標示條件讀完,再決定要不要往服務化走。
想持續追蹤開源影片模型的實用更新,可以免費訂閱 AI 郵報,也建議回頭查看 FastVideo 官方部落格,確認本機版文章是否已經發布。
資料來源
- FastVideo 官方部落格,FastH3 Omni:https://haoailab.com/blogs/fastvideo-omniref-update/
- FastVideo GitHub(Apache-2.0):https://github.com/hao-ai-lab/FastVideo
- FastH3 Omni 本機推論指南:https://github.com/hao-ai-lab/FastVideo/blob/main/docs/inference/fasth3_omniref.md
- UniServe GitHub(Apache-2.0,預覽版):https://github.com/hao-ai-lab/uniserve
- Hugging Face,FastH3 Omni BF16 權重說明:https://huggingface.co/FastVideo/FastVideo-FastH3-Omni-8-Step-V1
- Hugging Face,FastH3 Omni NVFP4 QAD 權重:https://huggingface.co/FastVideo/FastH3-Omni-NVFP4-QAD
- Hugging Face,FastH3 Omni ComfyUI 權重:https://huggingface.co/FastVideo/FastH3-Omni-Comfy
- MiniMax H3 社群授權:https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/LICENSE
- Hao AI Lab 官方 X 貼文(熱度線索):https://x.com/haoailab/status/2112625528805208257