Flash-dLLM 是什麼?擴散語言模型推論快 11 倍,速度、記憶體與品質代價拆解
Flash-dLLM 用 fused KV cache 與 self-verify 加速 dLLM。本文釐清 HumanEval 11 倍、GSM8K 5.1 倍的基準、A100 設定與品質取捨。
大多數聊天模型從左到右,一個 token 接一個 token 生成文字。Diffusion Large Language Model,簡稱 dLLM,走另一條路:先放入一段被 mask 的序列,再經過多次 denoising,逐步把遮住的位置填回文字。
這種設計理論上可以同時處理多個位置,卻不代表實際推論一定更快。dLLM 會反覆重看整段序列,Key-Value cache 的讀寫和 GPU 記憶體搬運,可能吃掉原本省下的計算。
MBZUAI VILA Lab 在 2026 年 9 月提出 Flash-dLLM,將 KV cache 的 I/O 最佳化與平行 draft-and-verify 合在一起。論文報告,在單張 NVIDIA A100 80GB、LLaDA-1.5、512-token 設定下,它相對 Elastic-Cache 在 GSM8K 快約 5.1 倍,在 HumanEval 快約 11.0 倍。
我的判斷是技術亮點很扎實,但「快 11 倍」必須綁定模型、硬體、batch、生成長度與 benchmark。Flash-dLLM 是推論框架,不是新的基礎模型,也不保證每項任務都保持最高準確率。
dLLM 和一般自回歸模型有什麼不同?
Autoregressive LLM 依序生成第 1、2、3 個 token。前面的 token 確定後,後面才接著產生。它很容易使用 KV cache,保存先前 token 的 attention state,避免每一步全部重算。
dLLM 將許多位置維持為 [MASK],每一輪同時預測多個位置,再挑選部分高信心 token 固定下來。剩餘位置繼續 denoise,直到序列完成。
它的優勢是可以平行預測,並利用雙向 context。難點是每輪被更新的位置不同,已解碼 token 也可能需要刷新 representation。直接套用自回歸模型的 cache 方法,會造成大量 Key/Value 讀取、寫入和中間 tensor 搬運。
KV cache 是注意力機制中保存過去 Key 和 Value state 的記憶區。HBM 則是 GPU 上的高頻寬記憶體。當運算本身不多、資料搬得太頻繁時,瓶頸就從計算變成 memory I/O。
Flash-dLLM 由 Flash-Cache 和 Flash-Verify 組成
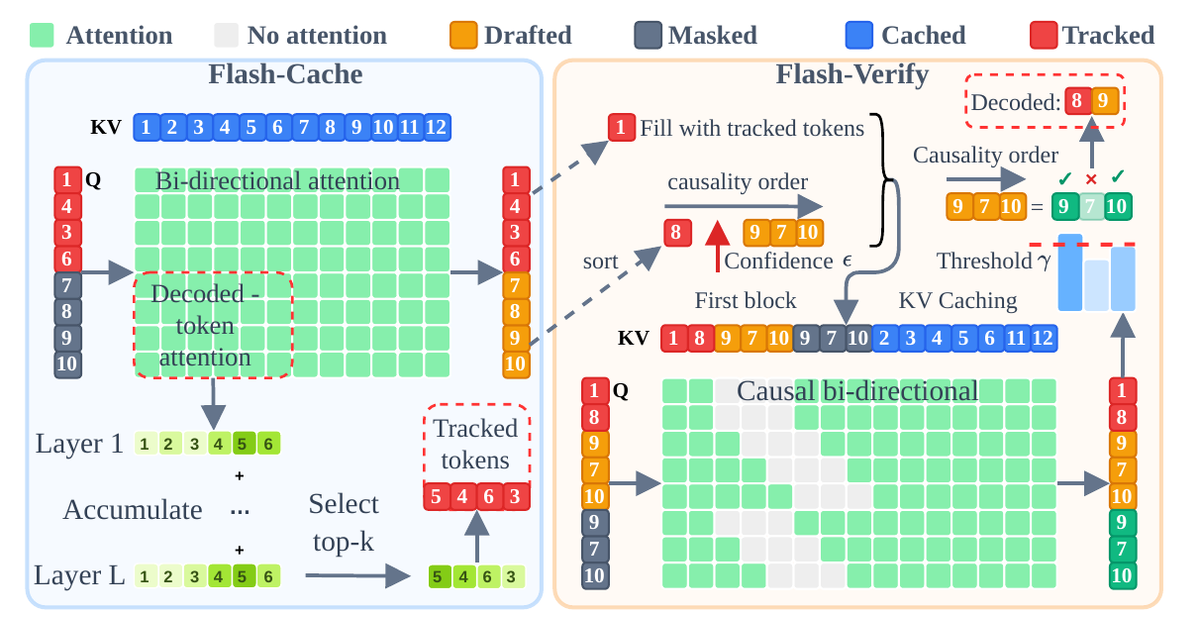
Flash-Cache 負責降低 cache update 成本。一般實作會分別啟動 QKV projection、RoPE、cache write 與 attention kernels,中間結果反覆寫回 HBM。RoPE 是把 token 位置資訊加入 attention 的方法。
Flash-dLLM 用 fused Triton kernel 把 QKV projection、RoPE 和 cache write 合在同一次 GPU kernel 中。Key/Value 在較快的 SRAM 完成處理後直接寫進 cache,減少中間 tensor materialization。
它還用 block table 排程不同長度的 query。dLLM 同一個 batch 裡,有些樣本只要更新小視窗,有些要刷新更多 token。Scheduled Flash Attention 讓這些不等長工作以 blocks 排列,減少 padding 和同步等待。
Flash-Verify 則負責一次接受更多 token。模型自己先 draft,再用另一個 view 驗證,不需要額外的小型 drafter model,也不需要重新訓練。
Selective refresh:不必每輪更新所有已解碼 token
研究者觀察 LLaDA-1.5 的 middle layers,top-32 最受注意的 decoded tokens 可取得約 50% attention weight。這表示少數位置對下一步預測影響較大。
Flash-Cache 每輪更新 current masked window、新解碼 token,以及固定數量的高 attention positions。其他位置繼續從 cache 取得 state,不再全部重算。
這是一種近似。Tracking budget 太小可能漏掉重要 context,太大又會增加計算。論文用 attention score 每一步重新挑選 positions,讓選擇能隨生成狀態變化。
官方 RTX 3090 microbenchmark 顯示,單看 fused cache pipeline 可達 1.37 倍 per-layer speedup。這不是整個 Flash-dLLM 在 A100 的 11 倍 headline,兩者測量範圍不同。
Flash-Verify 如何讓模型自己 draft、自己驗證?
對高於 confidence threshold epsilon 的 token,系統直接接受。對尚未達門檻的 search tokens,Flash-Verify 把每個候選複製成兩個 views:一個放入 draft prediction,另一個保留 [MASK]。
特殊 causal attention mask 會防止 mask view 偷看同位置的 draft,同時允許它使用更早、已通過的 draft 作為 context。當 draft view 和 mask view 選到相同 token,而且 mask-view confidence 高於 gamma,該 token 才被接受。
接受按照信心排序進行,遇到第一個 mismatch 就停止後續接受。這能避免錯誤 draft 影響後面的候選,也讓多個位置在一次 verify pass 中完成。
論文提供 bounded-deviation guarantee,但參考對象是同一模型依序解碼時的 distribution,不是正確答案或真實資料分布。兩個 views 同意,代表接近模型自己的 sequential decision,不代表內容一定正確。
5.1 倍和 11 倍是怎麼算的?
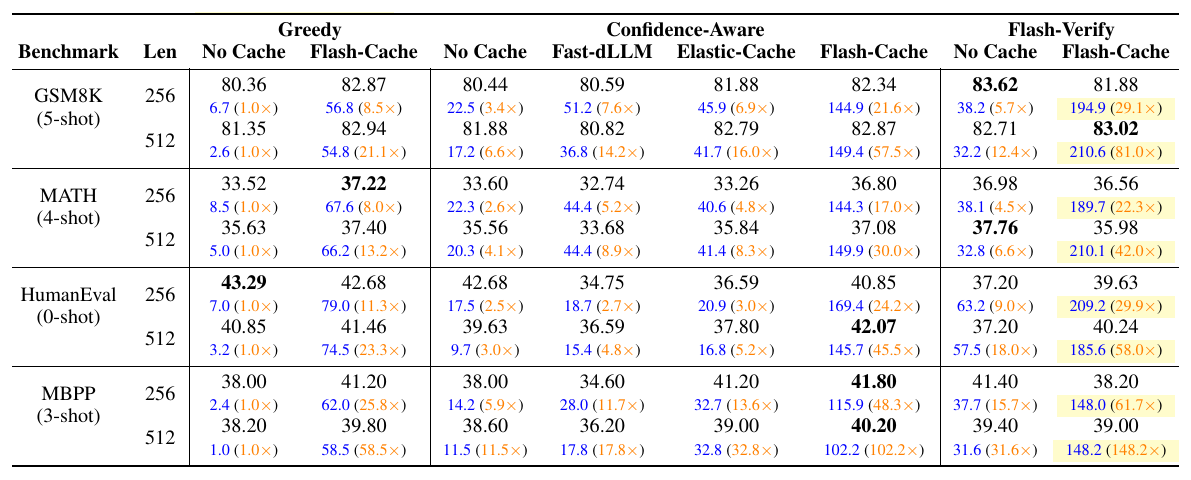
主要實驗使用單張 NVIDIA A100 80GB、LLaDA-1.5 與 Triton 2.0。研究者在相同 hardware/software configuration 重跑 No Cache、Fast-dLLM 和 Elastic-Cache,測 GSM8K、MATH、HumanEval、MBPP,生成長度為 256 或 512。
| Benchmark,512 tokens | Elastic-Cache | Flash-Cache + Flash-Verify | 速度比 |
|---|---|---|---|
| GSM8K | 41.7 tokens/s,82.79 | 210.6 tokens/s,83.02 | 約 5.1x |
| HumanEval | 16.8 tokens/s,37.80 | 185.6 tokens/s,40.24 | 約 11.0x |
| MATH | 41.4 tokens/s,35.84 | 210.1 tokens/s,35.98 | 約 5.1x |
| MBPP | 32.8 tokens/s,39.00 | 148.2 tokens/s,39.00 | 約 4.5x |
表格中每組先列 throughput,再列 task score。GSM8K 使用 5-shot exact-match 類評分,MATH 為 4-shot math verification,HumanEval 與 MBPP 是 code pass@1。不同 benchmark 的 score 不能互相比大小。
為什麼還有人引用 81 倍、148 倍?
Flash-dLLM 相對 greedy decoding without cache 的 speedup 更大。GSM8K-512 是 81.0 倍,MBPP-512 到 148.2 倍。
但 greedy no-cache 是非常慢的基準。以 GSM8K-512 為例,它只有 2.6 tokens/s。較實際的比較是目前強 baseline Elastic-Cache,因此論文摘要選擇 5.1 倍和 11.0 倍。
閱讀效能新聞時,先問 denominator 是誰。用不同 baseline 算出的倍數可以同時正確,卻會給讀者完全不同的成熟度印象。
更快是否完全沒有品質代價?
不是每一列都由 Flash-Verify 拿到最高 score。HumanEval-512 中,confidence-aware Flash-Cache 是 42.07,Flash-Verify 是 40.24;MBPP-512 則是 40.20 對 39.00。
另一方面,GSM8K-512 的 Flash-Verify 同時取得該列最高 throughput 210.6 tokens/s 和最高 score 83.02。MATH、HumanEval 和 MBPP 的差距也不是單向崩落。
正確結論是 Flash-dLLM 提供可調整的 accuracy-throughput trade-off。epsilon、gamma、tracking budget 和 masked-window size 都會改變一次接受多少 token、需要幾輪、速度與結果。部署者應根據品質門檻選 configuration,不能把加速視為普遍 lossless。
記憶體與 batch scaling 有什麼改善?
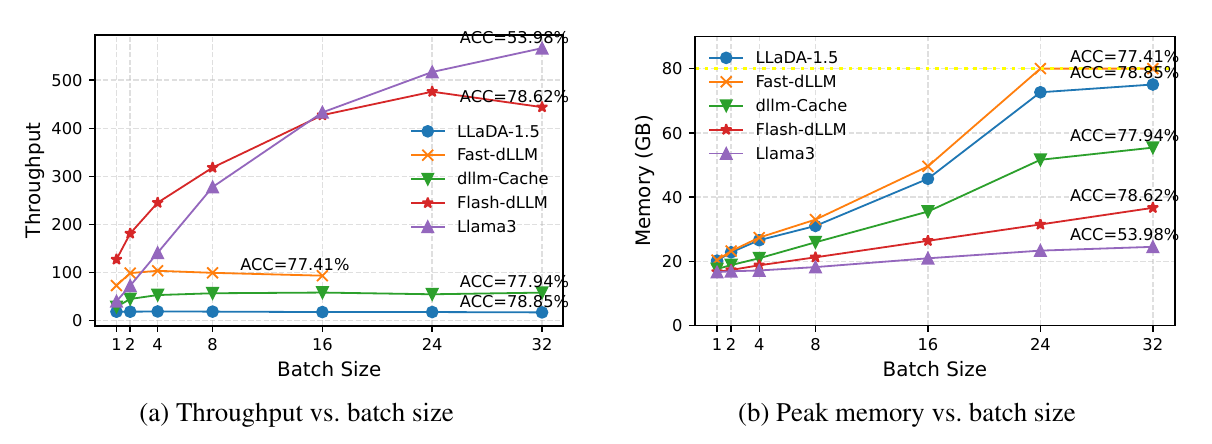
GSM8K-512 的 1-shot scalability test 顯示,Flash-dLLM throughput 能一路擴到 batch size 32,而 Fast-dLLM 在 batch 24 出現 out-of-memory。Batch 16 時,論文報告 Flash-dLLM 約 26 GB peak GPU memory,Fast-dLLM 約 50 GB,減少約 48%。
原因包含預先配置 flat KV cache、fused writes 與 block-based scheduling,避免反覆 allocation、padding 與 intermediate buffers。
這組 scalability test 是 1-shot,主要 Table 1 的 GSM8K 是 5-shot,不能把兩者當成完全同一實驗。Llama3-8B 在圖中是 autoregressive reference,也不是 accuracy-matched diffusion baseline。
Training-free 代表什麼?
Flash-dLLM 不需要為加速重新訓練 LLaDA,也不需要另外訓練 drafter model。它改的是 inference algorithm 和 GPU kernels,因此稱為 training-free。
這不表示部署零成本。使用者仍要下載支援的 diffusion model、編譯與安裝依賴、配置 GPU,並針對 workload 調整 thresholds、window、batch 和 tracking budget。
官方 code 已在 GitHub 以 Apache-2.0 公開。預設腳本涵蓋 GSM8K、MATH、HumanEval 與 MBPP。HumanEval 和 MBPP 會執行模型生成的 Python,官方 README 特別提醒要在 isolated environment 中跑 code evaluation。
它適合一般聊天或長文生成嗎?
目前證據主要來自數學推理與程式碼這類 structured-output tasks。論文限制章節指出,long-form writing 和 dialogue 的 token confidence 可能更平坦,較少候選能通過提前接受門檻,加速效果可能下降。
作者也只驗證 masked diffusion LLMs,尚未在 continuous-space diffusion language models 上測試。後者的 cache update pattern 可能不同。
另外,gamma 和 masked-window size 在生成過程中固定。根據即時 confidence 動態調整,可能有更好的品質與速度平衡,但目前仍是未完成方向。
Flash-dLLM 常見問題
Flash-dLLM 是一個新的聊天模型嗎?
不是。它是 dLLM 推論加速框架,主要在 LLaDA-1.5 等既有模型上改進 cache 與 decoding。
快 11 倍是和一般 GPT 類模型相比嗎?
不是。11.0 倍來自 HumanEval-512 上相對 diffusion baseline Elastic-Cache 的 throughput ratio,硬體是單張 A100 80GB。
它需要再訓練模型嗎?
不需要。Flash-Cache 和 Flash-Verify 都是 inference-time 方法,但仍要安裝官方實作並調整推論設定。
速度提升會改變答案嗎?
可能。Flash-Verify 有 confidence 與 agreement 檢查,也有相對模型 sequential distribution 的偏差界線,但並非對 ground truth 正確性的保證。官方表格中部分設定的 score 低於較慢配置。
程式碼是否公開?
是。VILA-Lab 官方 GitHub 提供 Apache-2.0 implementation、benchmark scripts、設定說明與論文 figures。
結語:dLLM 的瓶頸不只在算力,也在搬資料
Flash-dLLM 的核心洞察是:減少數學運算不一定會讓模型真的變快。如果 KV cache 反覆在 HBM 讀寫,中間 tensor 與 kernel launch 就可能成為主瓶頸。
Flash-Cache 用 fused kernel、block scheduling 和 selective refresh 減少 memory traffic。Flash-Verify 再讓同一 dLLM 擔任 drafter 與 verifier,一次接受更多可信 token。這套組合在 A100 上把 Elastic-Cache 的 GSM8K-512 41.7 tokens/s 提到 210.6,HumanEval-512 從 16.8 提到 185.6。
它仍需面對 accuracy-throughput 取捨,且尚未證明在長文、聊天、其他 GPU 與 continuous-space dLLM 同樣有效。對開發者來說,最值得複現的不是單一 11 倍數字,而是在自己的模型、輸出長度、batch 與品質門檻下,量出真正可用的 throughput、memory 和 task score。