Harness-Zero 是什麼?把 AI Agent 的 Harness 教進模型,23.3% 如何升到 44.3%
Harness-Zero 用審查 Agent 產生訓練軌跡,把專用 harness 行為蒸餾進 Qwen3.5-9B。本文釐清 44.3% 成績、2.4 倍成本與部署界線。
AI Agent 的能力不只由模型決定。它能用哪些工具、怎麼保存記憶、遇到錯誤是否重試、完成後如何驗證,往往由外部 agent harness 控制。harness 可以理解成模型與環境之間的操作框架。
問題是,每個領域最有效的 harness 可能不同。試算表需要保護既有儲存格,App 操作需要處理分頁與失敗重試,化學逆合成又要呼叫分子驗證工具。企業如果替每種工作維護一套專用框架,部署、路由與更新成本會持續增加。
2026 年 9 月的 arXiv 預印本 Harness-Zero 提出另一條路:讓強大的 harness 在訓練階段擔任老師,把它誘發的行為轉成模型可學習的軌跡。訓練完成後,移除專用 harness、參考資料與審查 Agent,只用固定的最小 harness 執行學生模型。
論文報告,Qwen3.5-9B 在三個領域的 macro-average 從 23.3% 提升到 44.3%,甚至高於基礎模型掛著專用 harness 時的 41.7%。我的判斷是這個方向很值得關注,但名稱中的「Zero」不能解讀成零訓練或零成本。
先釐清:AI Agent 的 harness 是什麼?
harness 是包在模型外面的系統。它可以提供工具、管理 context、保存 memory、加入 skills、攔截危險動作,並決定每一步如何和環境互動。
把模型想成駕駛,harness 就像車輛的方向盤、儀表、導航、煞車與交通規則。相同駕駛換到不同車上,能完成的動作和錯誤率都會改變。
論文把最終固定使用的簡單框架記為 target harness h,把針對領域演化出的專用框架記為 h*。專用框架可能包含工具、middleware、skills 與 memory。middleware 是介於模型和工具之間的程式規則,例如阻擋覆寫既有欄位,或要求儲存後重新讀取。
既有做法通常把 h* 一直掛在模型外面。Harness-Zero 想把其中可學的行為轉進模型權重,讓部署時只留下 h。
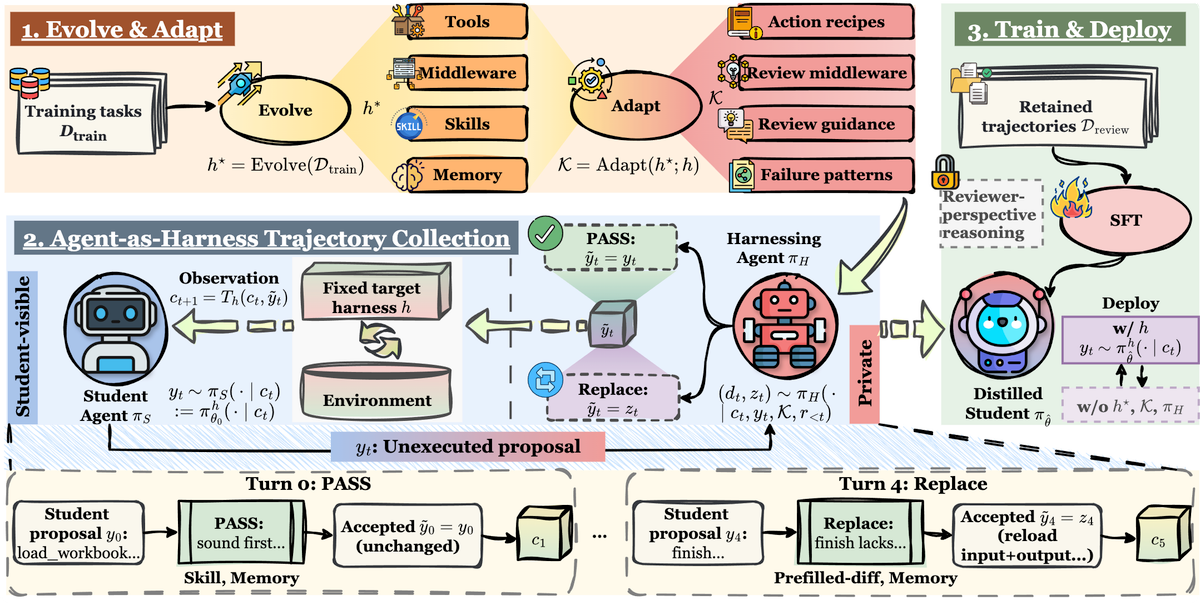
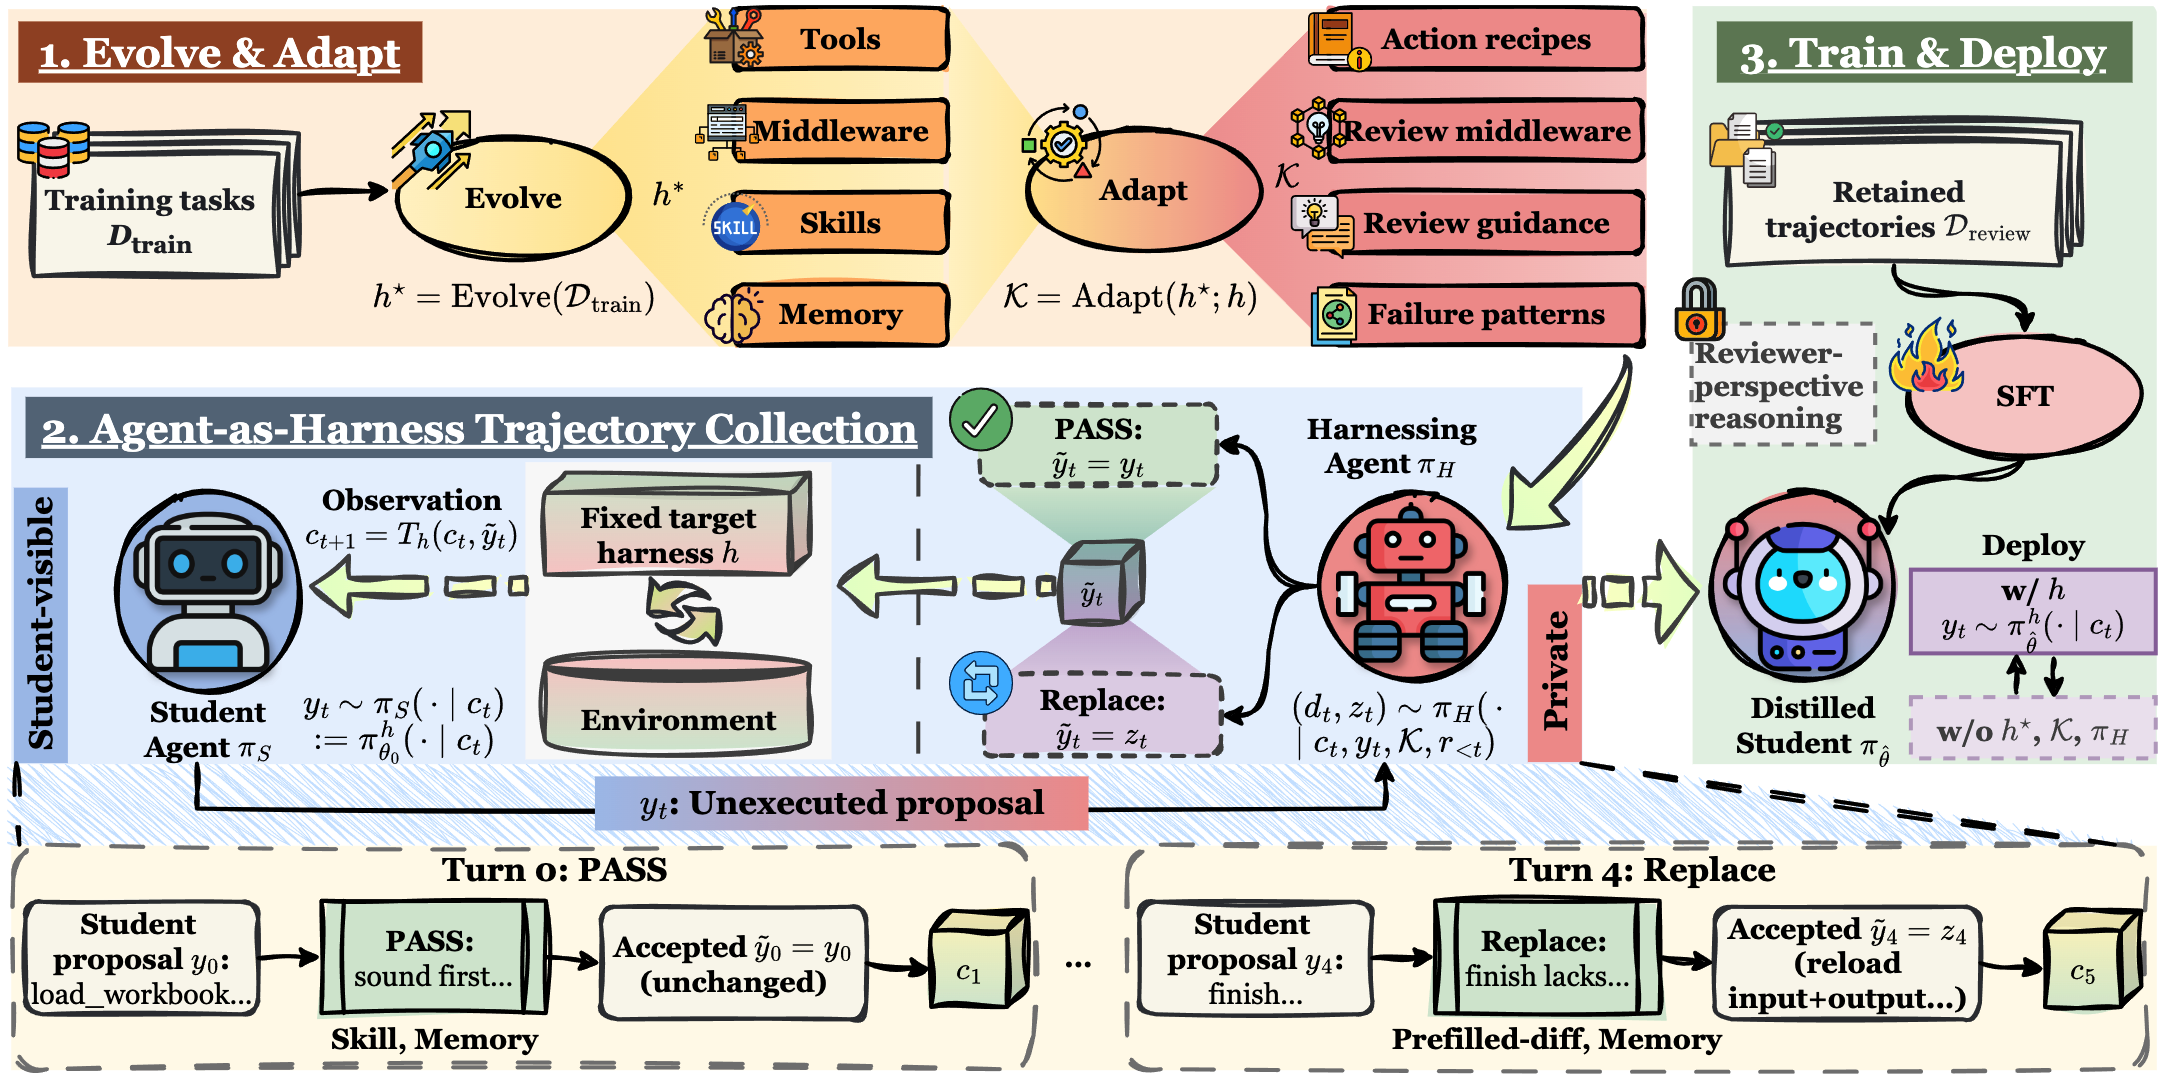
Harness-Zero 的三階段流程
第一階段是 evolve and adapt。研究者先用訓練任務演化出專用 harness,再把它改寫成 private reference harness K。工具會變成可供審查者參考的動作配方,middleware 變成審查警告,skills 和 memory 則變成診斷準則。
第二階段是 agent-as-harness。學生模型在最小 target harness 中提出下一步,但回覆不會立即執行。另一個 harnessing agent 先查看學生可見的歷史、尚未執行的提案,以及私有參考 K,再做兩種決定:
- PASS:提案合理,原樣送去執行。
- REPLACE:提案有問題,改成 target harness 能執行的完整回覆。
只有通過或替換後的回覆會進入學生看得見的軌跡。被拒絕的版本與審查討論保持私有,避免把「老師正在批改」的視角教給學生。
第三階段是 train and deploy。研究者把成功的 reviewed trajectories 整理成 SFT 資料,再用 LoRA 微調學生模型。SFT 是 supervised fine-tuning,也就是讓模型模仿經過審查的示範。部署時移除 h*、K 和 harnessing agent,只留下蒸餾後的學生與最小 h。
為什麼不能直接模仿專用 harness 的軌跡?
最大的困難是 action space 不同。專用 harness 可能有「驗證分子」、「載入試算表」或特製記憶工具,最小 harness 卻只有一個 Bash 指令工具。直接把老師的工具呼叫貼給學生,學生根本無法執行。
harnessing agent 扮演翻譯者。它理解專用 harness 想達成的效果,再用學生原本可用的動作重寫。例如專用工具會自動檢查輸出,審查者可以把學生過早宣布完成的回覆,換成一段先讀回檔案、確認結果的 Bash 操作。
這個差異也是 Harness-Zero 和一般知識蒸餾不同之處。它要轉移的不是一個答案,而是多步互動中何時檢查、何時呼叫工具、何時停止的行為模式。
23.3% 到 44.3%:三個領域怎麼測?
distillation 實驗使用 Qwen3.5-9B 作為基礎模型。target harness 是一個固定 system prompt 加一個 Bash execute tool 的 mini-SWE-agent 風格框架。GPT-5.6 Sol 擔任 harnessing agent,harness evolution 則使用 Kimi K3 與 Kimi Code。
三個測試領域分別是:
- SpreadsheetBench Verified:300 題用於演化與蒐集資料,100 題測試試算表操作。
- AppWorld:147 題訓練,168 個 test_normal tasks 組成 56 個情境,測多 App 工具操作。
- USPTO Retrosynthesis:500 題訓練、100 題測試,預測化學反應的前驅物。
| 設定 | SpreadsheetBench | AppWorld | USPTO | Macro avg. |
|---|---|---|---|---|
| 基礎模型 + 最小 harness | 31.0 | 26.8 | 12.0 | 23.3 |
| 基礎模型 + evolved meta-harness | 39.0 | 48.2 | 38.0 | 41.7 |
| Harness-Zero 模型 + 最小 harness | 44.0 | 58.9 | 30.0 | 44.3 |
44.3% 比 23.3% 高 21.0 個百分點,換算相對提升是 90.1%。但「提高 90.1%」不能寫成準確率增加 90.1 個百分點,兩種說法差很多。
44.3% 高於 41.7%,代表模型吸收了什麼?
研究團隊把專用 harness 才會誘發、而基礎模型在最小 harness 下從未展現的行為整理成 28 種 patterns。它們包括先檢查再修改、儲存後重新讀取、避免覆寫預填欄位、用 RDKit 驗證分子,以及避免重複失敗呼叫。
蒸餾後模型平均恢復 82.3% 的這些行為。SpreadsheetBench 某些規則達 100%,例如避免脆弱座標和重新載入已存檔工作簿。AppWorld 的完整分頁擷取則只有 40%,變更後 readback 是 50%。
這證明模型確實學到部分外部框架行為,但 82.3% 也有特定統計條件。研究只在「基礎模型加專用 harness 做得到、基礎模型加最小 harness 從未做到」的任務上評分,所以基礎模型的起點是由篩選規則決定為 0%。這不是所有任務的整體成功率。
Agent-as-harness 為什麼可能比程式規則更強?
論文另用兩個 frontier models 做無參數更新的測試。套用相同 evolved guidance 時,agent-as-harness 在六個 benchmark-model 組合的平均是 81.1%,code-as-harness 是 78.1%,最小 harness 則是 68.6%。
Agent 審查者能根據當下軌跡解讀規則,適應不同模型產生的回覆。固定程式只會執行預先寫好的條件,因此對模型能力改變較不敏感的說法有其合理性。
但 81.1% 是六種設定的平均,不代表每個模型、每個領域都勝出。以 AppWorld 的 GPT-5.6 Sol 為例,agent-as-harness 與最小 harness 都是 96.4%,meta-harness 反而是 94.6%。平均值需要搭配逐項結果閱讀。
「Zero」不代表 zero-shot,也沒有移除所有 harness
Harness-Zero 仍要先演化專用 harness、逐步呼叫 reviewer、收集成功軌跡,再執行兩個 epochs 的 LoRA SFT。三個領域經過過濾後分別使用 487、282 和 500 條 rollouts。
所以它不是 zero-shot,也不是零資料、零 API 或零算力。API 是讓不同程式透過網路交換請求與結果的介面。名稱比較接近「部署時不再需要 specialized harness」。最小 target harness 仍然存在,論文也明確承認沒有把所有外部框架消除。
官方 repo 要求 Python 3.12–3.13、Docker,rollout 透過 Harbor sandbox 執行。模型路由可用 OpenAI、Azure AI Foundry、OpenRouter,訓練範例則使用 Tinker。這是一套研究工程管線,不是一行指令就能讓任何 Agent 自我進化的產品。
訓練成本會先上升:每一步都多一次審查
論文限制章節指出,reviewer 必須足夠強。弱模型的批改可能有害,agent-as-harness 也會失去對 code-as-harness 的優勢。
蒐集軌跡時,每個學生提案都要多一次模型呼叫,而且 reviewer 要讀取軌跡與私有參考。USPTO 的平均延遲因此增為 2.4 倍。這筆 overhead 在蒸餾後部署時消失,但資料蒐集、強模型 API 與微調成本仍要先支付。
對經常重複、流量大的任務,先付訓練成本再降低部署複雜度可能合理。對需求常變、每週更新工具或任務量很小的團隊,維護可編輯 harness 可能比重新蒸餾模型更實際。
研究結果還有哪些限制?
第一,這是 arXiv v1 預印本,尚未看到正式同儕審查或外部複現。
第二,論文報告 single-run 結果。SpreadsheetBench 與 USPTO 使用 pass@1,AppWorld 使用 scenario goal completion。把不同 metric 做 macro-average 有助於總覽,但不是單一一致的成功率。
第三,SFT 不一定能吸收深層領域知識。context management 等外部機制也不容易改寫成學生的一次回覆。需要強制阻擋、權限隔離、資料庫交易與審計紀錄的功能,仍應保留在程式層。
第四,模型權重較難即時修正與追蹤。改一份 skill 或 middleware 可以 code review、回滾和 hotfix。改進已蒸餾模型通常需要新資料、重新訓練與版本驗證。
企業應該怎麼評估 Harness-Zero?
先找一種高頻、穩定、成功條件清楚的工作,不要一開始就蒸餾所有 Agent。保存一組未參與 harness evolution 或 SFT 的 private test set,並比較四種設定:基礎模型、專用 harness、reviewer 包覆、蒸餾後模型。
除了 task success,還要量測錯誤類型、工具呼叫數、p95 latency、訓練成本、部署成本與安全違規。蒸餾後若只是分數提高,卻更常越權或更難回溯,就不能算上線成功。
安全規則也要分類。偏好、工作技巧和驗證習慣可以嘗試蒸餾。權限、金流、資料刪除、法遵與不可逆動作必須留在 deterministic enforcement,也就是不依賴模型判斷的固定執行規則。
Harness-Zero 常見問題
它是新的 AI 模型嗎?
Harness-Zero 是訓練方法與開源研究程式。作者也公開三個以 Qwen3.5-9B 為基礎、分別針對三個領域的 LoRA checkpoints。
部署時真的完全不需要 harness 嗎?
不完全。專用 evolved harness、private reference 與 reviewer 會移除,但模型仍在固定的 minimal target harness 下執行。
為什麼蒸餾後 44.3% 會高於掛著專用 harness 的 41.7%?
研究者的解釋是 reviewed trajectories 把有用行為轉成模型習慣,減少 9B 模型處理複雜工具與長 context 的負擔。這是三個特定 benchmark 的結果,仍需不同模型與多次實驗驗證。
這等於 AI 自己訓練自己嗎?
不宜這樣簡化。管線使用人工設計的方法、明確 benchmark、演化 skill、強模型 reviewer、資料過濾與 SFT。人類仍決定任務、評分、權限與部署標準。
結語:把 harness 當成可蒸餾的訓練資產
Harness-Zero 最有意思的觀點,是把外部 Agent 工程從部署負擔變成訓練訊號。好的工具流程、檢查習慣、記憶與 middleware,不一定永遠只能留在模型外面。其中一部分可以透過審查過的軌跡,轉成模型本身較穩定的行為。
研究在三個領域把 Qwen3.5-9B 的 macro-average 從 23.3% 推到 44.3%,並恢復 82.3% 的 28 種 harness-exclusive patterns,提供了具體證據。同時,它也需要強 reviewer、較高蒐集成本、SFT 與最小 harness,且目前仍是 single-run 預印本。
對企業最務實的解讀是:繼續維護 Agent 系統,同時把穩定、高頻、可驗證的操作習慣逐步蒸餾進模型,將必須強制執行和容易變動的規則保留在外部。模型與 harness 應該重新分工,而非二選一。