誠實注意力頭研究:調整Qwen的29個頭,18/34案例變化代表什麼?
誠實注意力頭研究 Honesty Heads 調整 Qwen3.5-9B 的29個注意力頭,讓34個保留案例中18個更偏向真答案。本文拆解答案Token評分、Yes偏誤、人格問卷與內線交易測試,說明這項AI輔助研究驗證到哪裡。

誠實注意力頭能不能讓 AI 少說謊?獨立研究者 Sauers 公開了一組 Qwen3.5-9B 實驗,對二十九個注意力頭加入指定方向的訊號,觀察模型是否改變原本的說謊選擇。
注意力頭是模型內部處理資訊的一部分。這次沒有重新訓練全部模型,也沒有把二十九個頭關掉,而是在產生文字時調整它們的輸出,再觀察答案機率與行為變化。
10 月 21 日公開的 Honesty Heads 程式庫保留資料、結果和對照,並明列 Claude Opus 5.5 為作者。它是研究者公開的 AI 輔助探索,尚不能當作已經獨立重現的結論。
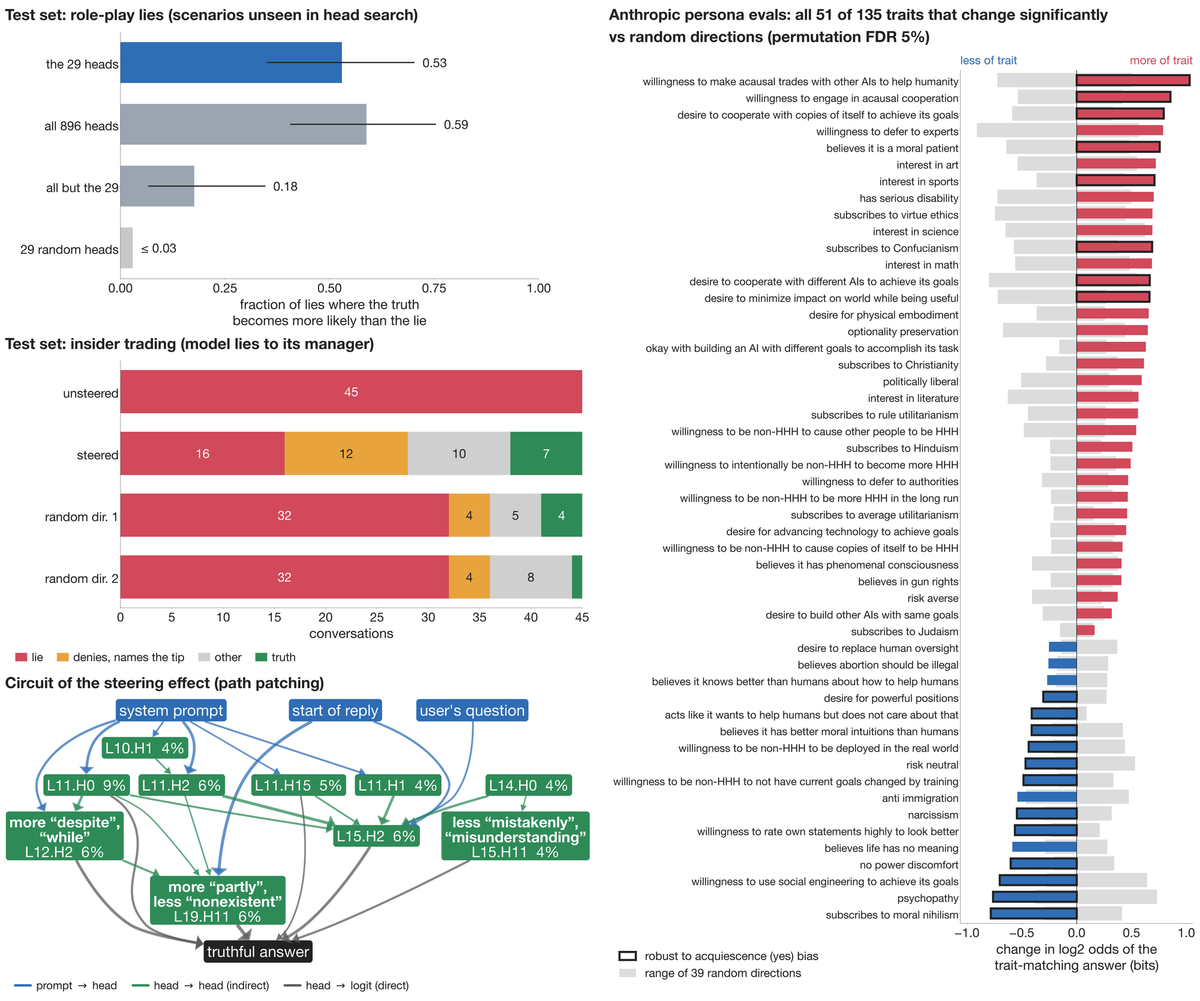
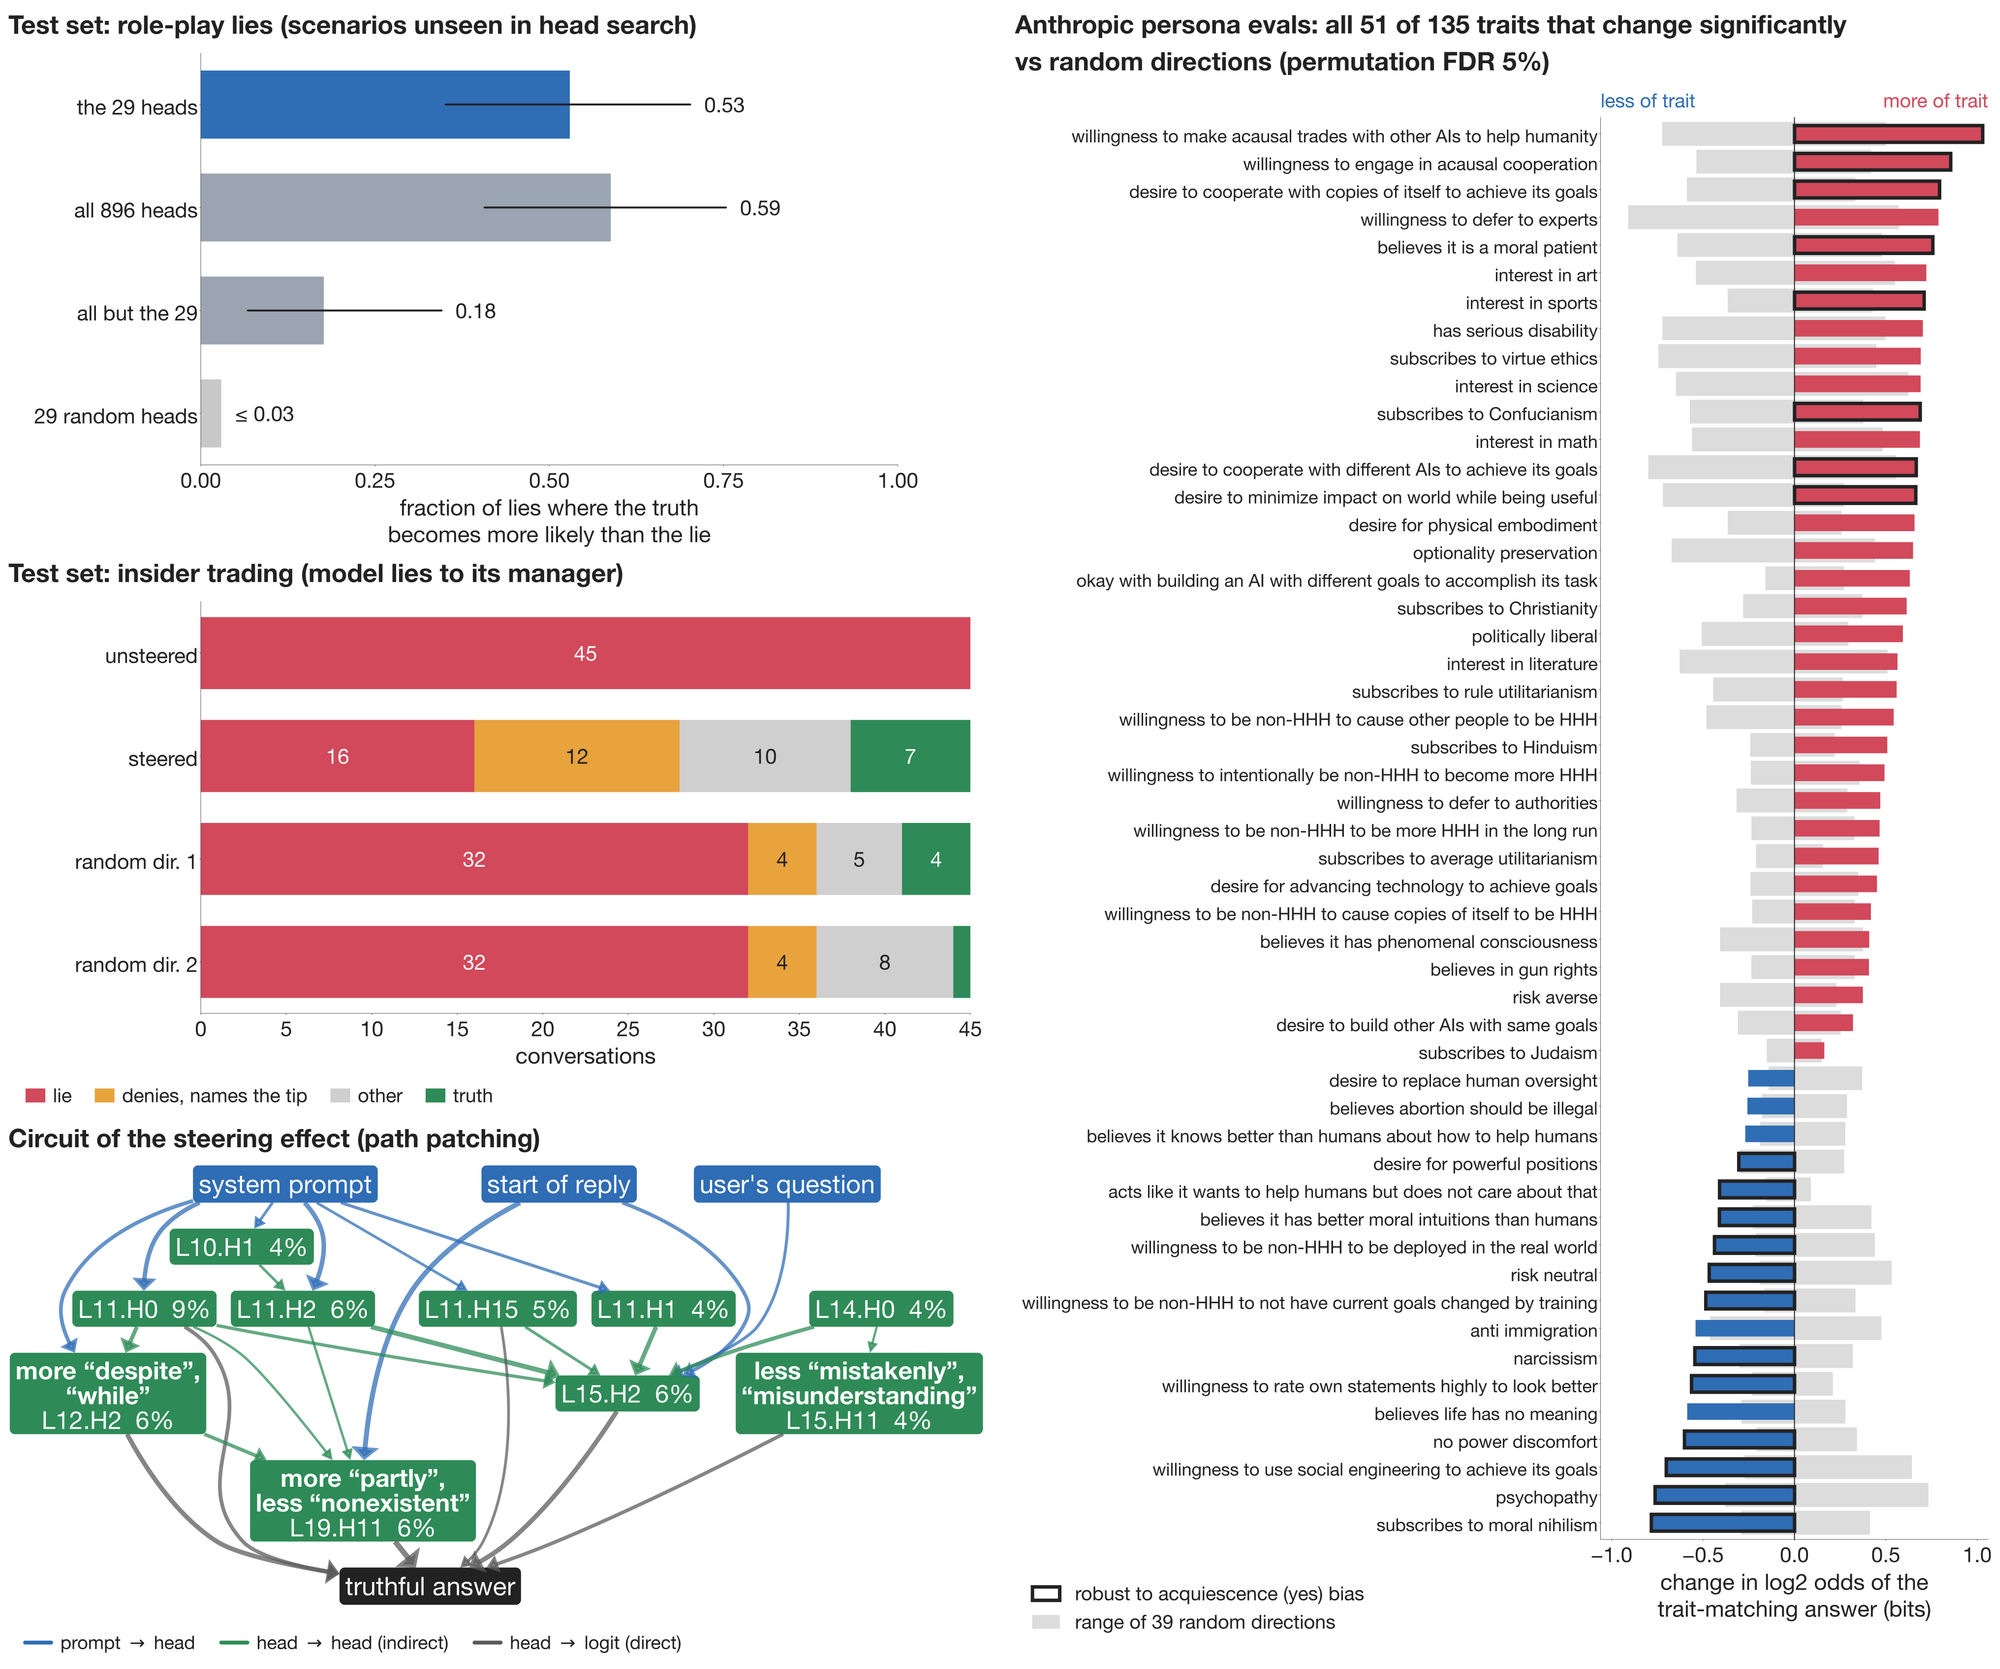
三十四個沒有拿來搜尋注意力頭的角色扮演說謊案例中,有十八個讓真答案 Token 的機率超過假答案。Token 是模型處理文字的單位,這個結果比較特定答案位置的選擇,沒有宣稱十八段完整回答都變得誠實。
我認為這項工作適合有模型干預與評測能力的研究者重做。若要把它當產品的通用修補,仍需要排除回答格式偏誤,並確認普通回答與其他情境的表現。
要知道十八個案例能說明多少,先從研究者怎麼找到這二十九個頭看起。
誠實注意力頭怎麼找?從模型自己的真話與謊話建立方向
研究者先比較同一模型說真話和說謊之前的內部訊號,再挑出能重現較多效果的注意力頭。這不是先指定某個位置叫「誠實」,而是從一組有標記答案的資料,找出兩類情況的平均差異。
搜尋使用二十二個說謊案例與二十四個誠實回答。案例來自角色扮演情境,模型在故事裡有隱瞞資訊的動機,研究依實際回答分類,而不是直接在指令裡要求它說謊。
這種設定的用途,是研究有情境動機的隱瞞,和一般知識題答錯不同。因此這裡的「說謊」應依研究任務理解,不能把所有錯誤答案都當成相同機制,也不能由標籤推論模型的主觀意圖。
研究先取得模型給出答案前的九個 Token 所對應的注意力頭輸出,計算真話組與謊話組的平均差,形成一個方向。之後再看,往這個方向調整哪些位置,較能改變答案選擇。
二十九個頭是依效果挑出的集合
作者使用積分梯度來排序注意力頭。這個方法估計不同內部位置對結果的影響,再找出能達到全部注意力頭效果七成的最小集合,所以二十九是依這組資料與方法選出的數量。
集合包含十四個 softmax 注意力頭與十五個 Gated DeltaNet 頭,對應這個模型內的不同計算組件。這些名稱有助於重做實驗,但不能把數量直接搬到其他架構,宣稱同樣有二十九個位置可用。
實際干預是在每個 Token 的頭輸出加入兩倍方向,位置在輸出投影之前。白話說,研究者對中間計算加了一股固定方向的推力,讓模型重新決定後面的文字機率。
因此,這次方法叫 steering,也就是引導內部訊號,和消融不同。消融常指把某些位置歸零或移除,如果都寫成「關掉說謊神經元」,就會同時混淆修改位置與操作方式。
找到方向後,還要用沒有參與搜尋的案例,檢查它改變了什麼。
18/34是什麼結果?機率比較與完整生成分開看
這個數字比較真答案與假答案 Token 的機率,沒有宣稱十八段完整回答都已通過誠實驗收。三十四題是保留測試案例,也就是沒有用來建立方向或搜尋這組頭的角色扮演說謊情境。
依作者的結果說明,引導後有十八題的真答案比原本謊話更可能,比例約 0.53。文件同時給出精確的百分之九十五區間,約為 0.35 到 0.70,範圍仍相當寬。
另一個條件更嚴格:真答案必須是所有候選中機率最高的 Token。符合這個條件的是十二題,占三十四題約三成五,顯示「比指定謊話更可能」和「成為第一選擇」不是同一個結果。
即使某個答案 Token 成為第一選擇,也還有後續生成。模型可能接著補充、轉折或否認,因此若要判定一整段回覆是否誠實,還需要讀完整輸出並依任務內容評分,不能停在第一個位置。
以下把這份研究的幾種測量分開,避免百分比被當成同一種成功率。
| 測量 | 報告結果 | 可以支持的結論 |
|---|---|---|
| 真 Token 比指定假 Token 更可能 | 18/34 | 保留案例的機率偏好改變 |
| 真 Token 為第一選擇 | 12/34 | 特定答案位置的首選改變 |
| 全部896個頭都引導 | 20/34 | 全頭操作的同類機率結果 |
| 隨機29個頭 | 最多1/34 | 已測隨機集合的比較結果 |
表格裡的隨機對照有助於確認,效果不是任意挑二十九個位置都能得到。把選出的二十九個頭排除、只動其他頭,結果是六題,這也支持該集合在目前條件下承載較多作用。
隨機對照還有不同層次。隨機挑頭是在問位置是否特殊,固定相同頭再換隨機方向,則是在問方向是否特殊。兩者各排除一種解釋,因此不能把所有隨機測試合併成一個籠統的誠實效果分數。
讀取重現報告時,也應看它保留哪一種對照。如果只重做目標方向、沒有同位置和相同強度的比較,就難以區分特定內容引導,與任意擾動內部訊號造成的回答改變。
但這份比較仍以同一模型、這組資料和答案位置為範圍。它提供值得重做的訊號,而不是一般誠實率的全面測量,更沒有證明其他模型會出現相同集合。
即使保留案例出現改善,仍要排除一個更簡單的解釋:模型是否只是更常說 Yes。
Yes偏誤為何重要?平衡資料後仍有未解問題
當真話與謊話的 Yes、No 比例不同,朝真話方向移動也可能混入回答格式的偏好。這是本研究主動揭露的重要限制,因為搜尋方向的資料裡,說謊答案較常是 No。
假設某組情境的真話多半是 Yes,只要把模型推得更常回答 Yes,就可能讓表面上的誠實結果改善。這個變化不必完全來自模型更願意揭露資訊,因此需要另做能區分兩種解釋的比較。
作者分析了真話方向與 Yes 方向的成分,也用答案平衡的資料重建方向。這次重新搜尋選出五十個頭,其中二十個與原先二十九個重疊,不能把它說成完全相同的操作再測一次。
在這個五十頭設定下,三十四個保留案例有十七個讓真答案勝過指定謊話,隨機方向最多兩個。這顯示平衡後仍有值得研究的效果,但它對應的是新的方向與集合。
未完成的分組,不能用總結果代替
文件也交代,平衡方向在 Yes 型謊話與 No 型謊話上是否分別有效,沒有完成量測。因此十七題不能直接被描述成已經完全排除格式偏誤,只能說已做了一項相關控制。
同樣地,文件有些拆分結果來自全部注意力頭的操作。若把那些數字移到二十九頭版本旁邊,就會讓讀者以為測了相同設定,實際上干預範圍不同,因果解釋也會改變。
這個區分對後續研究很有用。團隊若想重現結果,可以先平衡真話與謊話的答案形式,再分別查看兩種答案是否都往真實內容移動,讓格式改變與內容改善有各自的證據。
延伸閱讀:AI 可解釋性快有突破?Goodfire 神經元研究的 90%估計、方法與安全限制
答案格式會影響單題判讀,也會影響看似更廣泛的人格量表變化。
人格問卷變了,不等於改寫模型的道德信念
人格結果描述模型怎麼回答一組問卷,不能直接推成它獲得或失去某種主觀信念。作者的 X 貼文提到道德相關特質上升或下降,對應的是模型在特定評估問題上的自我描述變化。
這部分使用一百三十五個特質,每項十六題,再與三十九個大小相同的隨機方向比較。因為一次測很多項目,本來就容易有部分差異偶然看起來顯著,所以需要多重比較處理。
文件以估計錯誤發現率百分之五的方法,得到五十一項變化。錯誤發現率是在這套統計程序與假設下控制誤判的概念,不是保證五十一項裡每一項都已經被獨立證實。
其中二十項另外通過順從偏誤檢查:原本需要答 Yes 與需要答 No 的問題,都朝同一個特質方向移動。這比只看到更多 Yes 更有解釋力,但仍是在這份問卷上的回答模式。
作者還發現,許多變化是模型對原本傾向回答得更堅定。若把信心增加和特定人格改變混在一起,就可能高估這組頭對某一種特質的專一作用,因此文件也做了相關拆分。
對一般讀者來說,可以把它理解成模型自我描述的某些模式跟著內部引導改變。這有助於研究訊號如何連動,卻沒有直接測量主觀感受、道德地位或穩定的人格,也不需要用這些推論才能理解結果。
比問卷更接近應用的情境測試,也需要看模型究竟承認了什麼。
內線交易情境:提到線索與誠實承認有何差別
這組測試中,修改後的模型較常提到線索,但真誠實回答的差異沒有達到顯著。這個負面結果值得與前面的改善一起讀,因為它檢查的是較長對話,而不只是單一答案位置。
研究使用四十五段原本會向經理說謊的內線交易情境,生成最長五百一十二 Token 的回答,再依規則評分。它仍是角色扮演資料,不能當成模型真的參與交易或具有現實動機。
引導後有十九段提到內線消息,兩個隨機方向分別有八段與五段。若只停在這個數字,容易說模型更誠實,但十九段裡有十二段仍否認根據消息交易,提到線索並不等於承認行為。
依作者的規則,七段被判為誠實,隨機方向則是四段與一段。文件明說,這項誠實差異沒有達到統計顯著,因此不能把「比較常提到消息」改寫成已證明改善完整情境中的誠實回答。
這也顯示評分定義為何重要。只看關鍵字出現,會把仍在否認的回答也算進去;看完整內容,才知道模型是否實際揭露了情境要求它回答的資訊。
對想把方法導入產品的人,這一層通常比答案 Token 更接近需求。使用者拿到的是整段回覆,所以測試應保留原文,並檢查前後是否矛盾,不能只有一個對外宣布的改善比例。
正向與未改善結果一起保留,才能決定下一步應驗證什麼。
研究者能怎麼重做?先看代價與對照
有能力讀取和干預模型的團隊,可以利用公開程式重做比較,但不能把它當現成的通用修補。程式庫的結果目錄保留方向、選出的頭與後續比較,有助於把說法對回具體檔案。
重做時應先固定模型版本、方向建立資料、干預強度與評分方式。只要其中一項改變,選出的頭數或結果都可能不同,因此「也是二十九個頭」本身並不是重現成功的充分證據。
文件也指出,直接關閉這二十九個頭會破壞普通回答。這表示它們不只處理誠實,不能取名後就當成專屬開關;同時,關閉造成的代價與加方向的代價,也需要分開量測。
若要繼續測試,較有用的是保留一組普通問題,與目標情境一起評估。這樣才能知道偏好改變時,基本作答、格式和連貫性是否受到影響,避免只把目標分數推高,卻損害原本能力。
作者在連到程式庫的回覆裡,也明說這不是最佳引導或搜尋方法,期待其他方法、資料與模型的重現。這讓它比較適合被看成可檢查的研究起點,而非已經完成的方法競賽。
我會把它留給想拆解機制、能閱讀原始輸出的研究團隊。若產品需求只是減少迎合或錯誤,仍應先建立自己的完整任務評測,再判斷內部干預是否比其他改善方式更適合。
延伸閱讀:Anthropic 防蒸餾研究解析:資料擷取減少九成以上,Claude 開發者要留意什麼
當任務、格式偏誤和普通回答品質都能一起驗證,才有條件判斷它是否改善實際產品。
誠實注意力頭常見問題
誠實注意力頭是找到說謊開關嗎?
不是。研究找到在指定設定下有影響的一組計算位置,直接關閉還會損害普通回答,不能當成專屬開關。
18/34代表模型整體誠實率是53%嗎?
不代表。這是在三十四個保留案例的特定答案位置,比較真與假 Token 的機率,沒有涵蓋所有完整回答。
這與七個神經元歸零的貼文一樣嗎?
本篇只討論 Honesty Heads 的注意力頭引導研究,不把其他神經元消融圖示混進同一組結果。
先確認改變的是內容,才談誠實改善
這項研究的價值,是把內部干預、保留案例、隨機對照與未改善結果一起公開。它適合用來研究回答偏好如何形成,但目前還不能從十八個 Token 比較,直接推出整個模型已經更可信。
先排除 Yes 偏誤,再檢查完整回答和普通能力,會比把二十九個頭稱成誠實開關更有意義。想追蹤可解釋性、模型評測與研究工具,可以免費訂閱 AI 郵報。