JEMM-27B 是什麼?開源多模態判斷引擎,93.3% 工具呼叫成績怎麼看?
JEMM 是可自架、能看截圖的候選決策引擎。本文釐清 93.3%、85.7% 兩項成績,以及 LoRA、64 GB GPU 與導入風險。
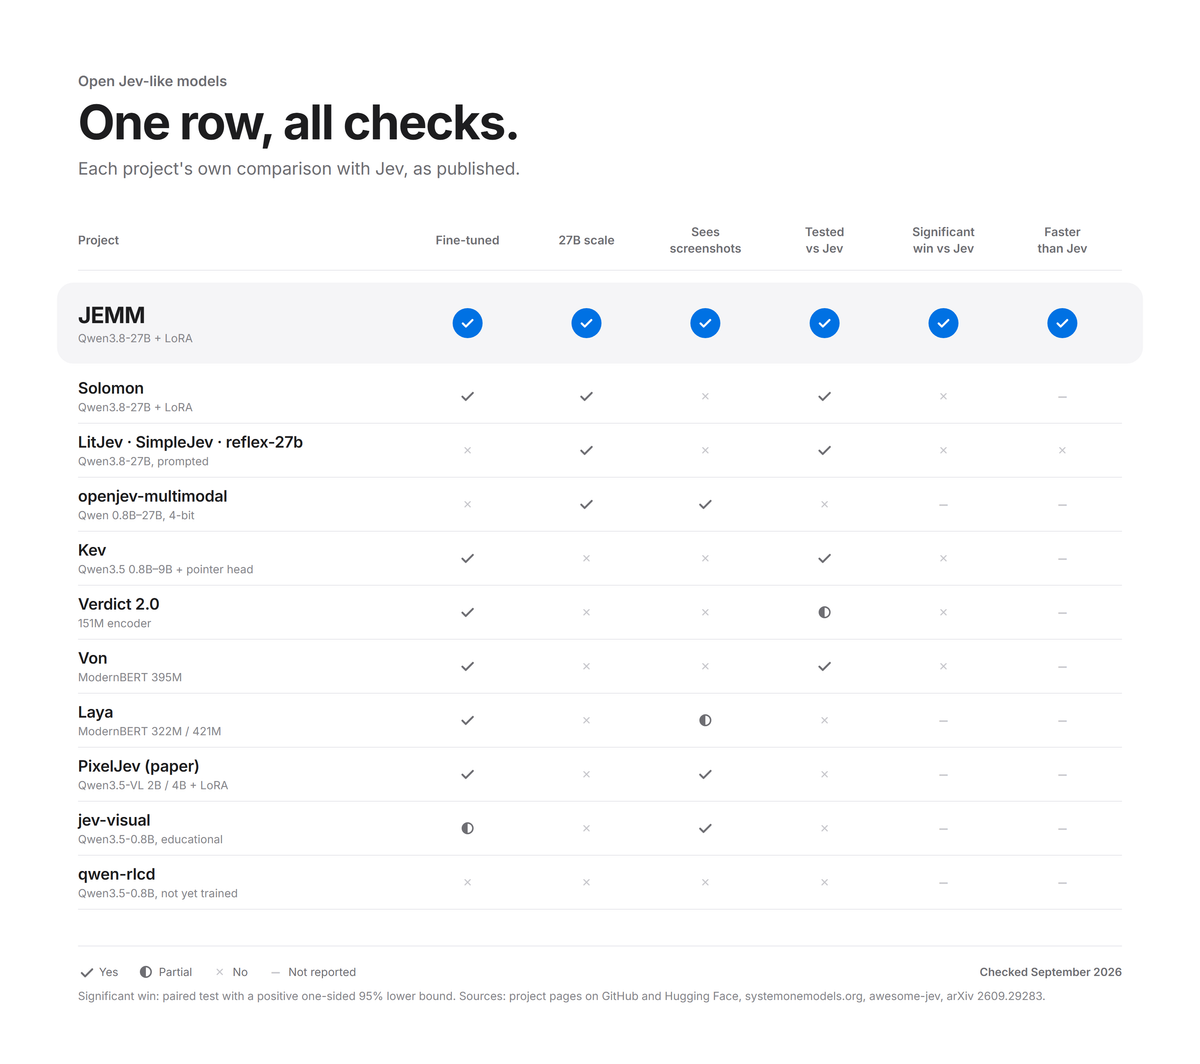
AI Agent 不只要「生成答案」,還要在多個工具、候選動作與安全選項之間做決定。2026 年 9 月公開的 JEMM,把這個問題獨立成一個可自行部署的判斷引擎:輸入文字或網頁截圖,再從 2 到 32 個候選項目中選出一個,並回傳每個選項的機率。
社群貼文最常引用兩個數字:BFCL 工具呼叫 93.3%,以及 JevBench 公開題 85.7%。但兩者代表不同測試,後者甚至比商用 Jev 1.13 少答對 2 題。只看單一百分比,很容易把一個專門做 candidate selection 的模型誤解成全面勝過其他 AI。
我的判斷是審慎正面。JEMM 的價值在於開放權重、自架、能讀截圖,也提供「低於門檻就不決定」的機制。它不屬於通用聊天模型,更不該直接取代權限、業務規則和人工核准。
JEMM 是什麼?它專門替候選項目做選擇
JEMM 全名是 Judgment Engine for MultiModal decisions。官方 GitHub 的描述很直接:它接收目前狀態與一組問題,針對每題從候選答案中選一個,回傳 probabilities 與 confidence。
probability 是模型分配給各候選項目的相對機率。confidence 則是系統用來判斷這次選擇是否足夠可靠的信心值。官方要求:如果 confidence 低於 decision_config.json 設定的 threshold,就應把結果視為 undecided,也就是「尚無法決定」。
這種設計可用在三類工作:
- Tool routing:在查天氣、搜尋航班、查資料庫或不呼叫工具之間選一個。
- Action selection:根據畫面與文字,選擇下一個網頁操作。
- Classification:把內容分到指定類別,或判斷是否需要拒絕、轉人工。
JEMM 支援 choice、noul 和 score 三種題型。choice 是一般多選一,noul 可理解成 true/false 判斷,score 則從數個等級中挑選。每次可提供最多 4 張 PNG、JPEG 或 WebP 截圖,而且同一批問題會看到相同圖片。
「27B」不是一個可直接下載執行的完整模型
JEMM 的 Hugging Face 頁面容易讓初學者誤會。它並沒有重新發布完整 27B 模型,而是一個套在 Qwen/Qwen3.8-27B 上的 LoRA adapter。
LoRA 是低秩微調技術。可以把基礎模型想成一本厚重的通用教科書,adapter 則像一小冊專門補充教材,調整模型在特定任務上的行為。JEMM 的 adapter 約 467 MB,但執行時仍需要另外下載並載入 Qwen3.8-27B 基礎模型。
Hugging Face 資料顯示,基礎模型約 277.8 億參數,BF16 權重約 55.6 GB。官方 HTTP server README 要求一張至少 64 GB 記憶體的 CUDA GPU。這不是一般筆電就能順暢執行的「小模型」,adapter 小也不代表整套部署小。
JEMM 與基礎模型都標示 Apache-2.0 授權,但專案也明確說明:它和 TypeSafe AI 以及 Jev 沒有關聯。
93.3% 工具呼叫:它測的是什麼?
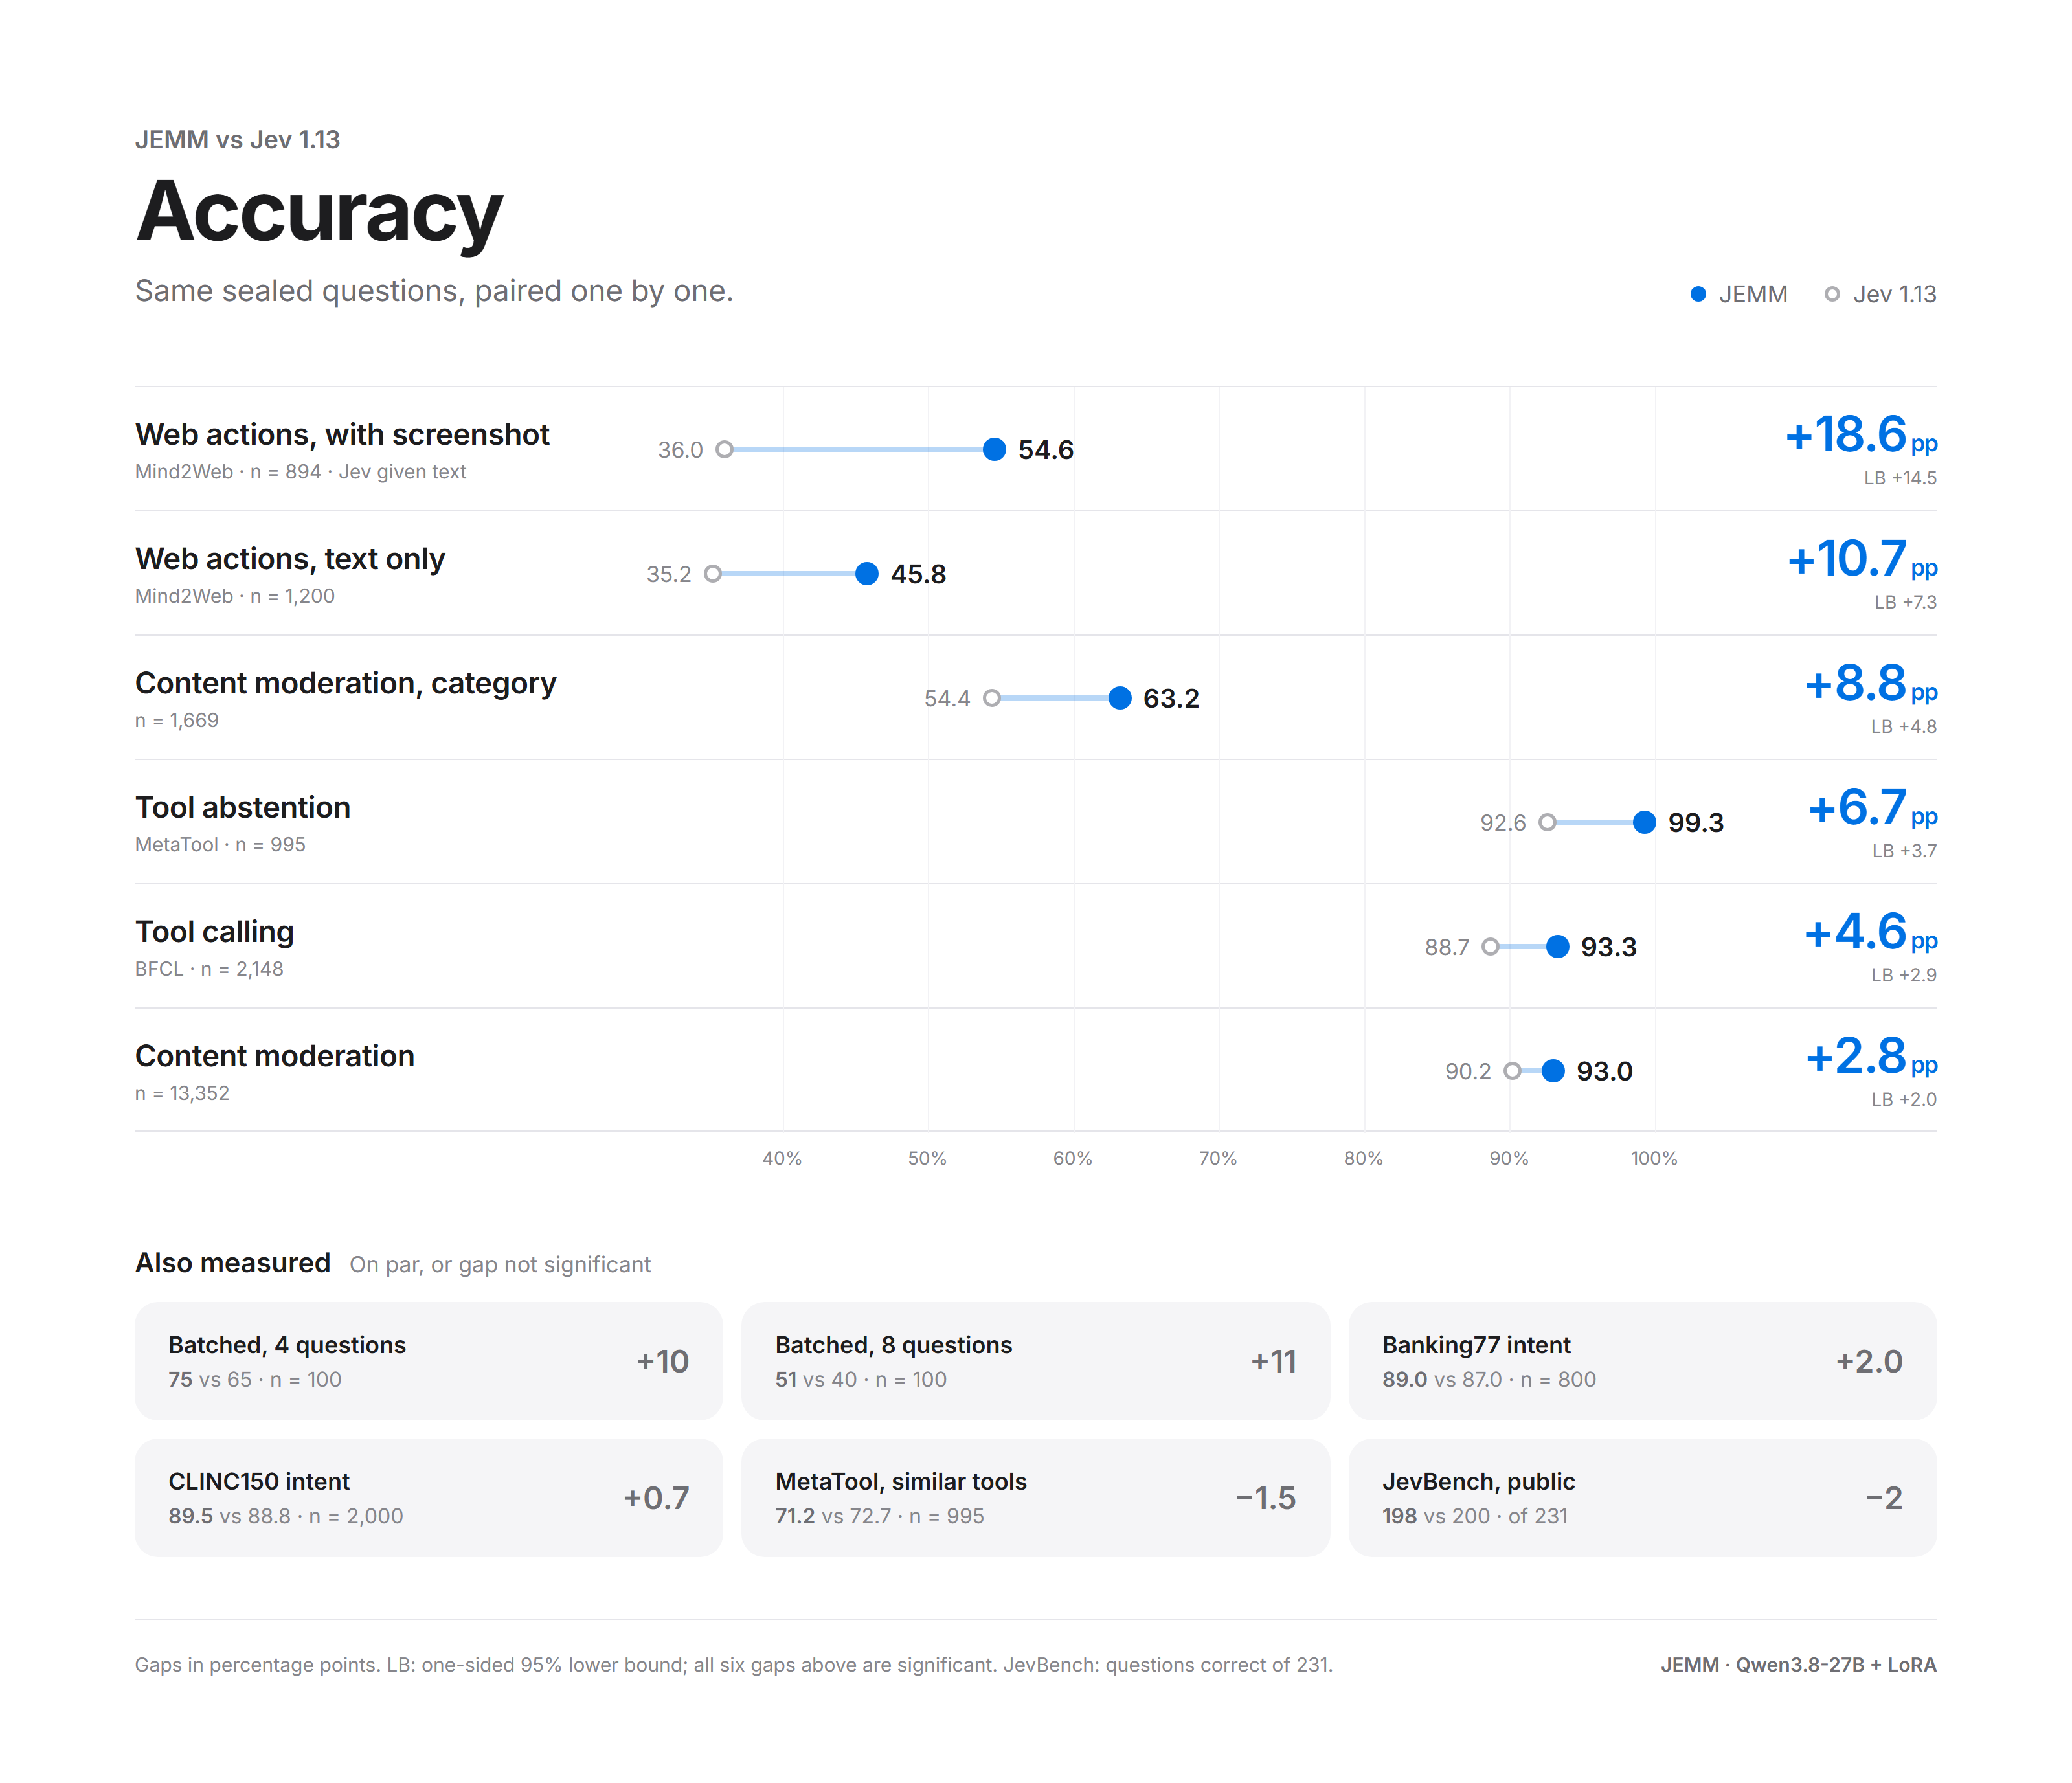
官方 accuracy 圖表在 BFCL tool calling 測試列出 JEMM 93.3%、Jev 1.13 為 88.7%,樣本數 2,148。BFCL 是 Berkeley Function Calling Leaderboard,用來評估模型能否按照問題選擇與呼叫合適工具。
同一張圖還列出 tool abstention 99.3% 對 92.6%。abstention 是「沒有合適工具時選擇不要呼叫」,對 Agent 很重要:亂用工具可能比不回答更危險。
不過,這些數字是專案作者公布的比較,尚不是第三方複現。實際產品的工具名稱、描述、數量和輸入分布都可能不同。公開 benchmark 的高分,不能直接當成你公司工具目錄的上線保證。
85.7% JevBench 並沒有勝過 Jev
社群貼文用「JevBench 公開題 85.7%」介紹 JEMM,數字本身沒有錯,但缺少最重要的比較背景。
官方圖寫的是 JEMM 答對 198/231 題,約 85.7%。Jev 1.13 答對 200/231 題,約 86.6%。JEMM 在這組公開題少答對 2 題。圖表也把這一列放在「on par, or gap not significant」區域,未列入顯著勝出的六項結果。
因此,合理結論是 JEMM 在 JevBench 公開題接近 Jev,而不是全面超越。它真正的差異化,是可以自架、開放 adapter,並支援截圖輸入。
| 官方測試 | JEMM | Jev 1.13 | 如何解讀 |
|---|---|---|---|
| BFCL tool calling | 93.3% | 88.7% | 官方比較中 JEMM 高 4.6 個百分點 |
| Tool abstention | 99.3% | 92.6% | 能避免不適合時亂呼叫工具 |
| JevBench public | 198/231 | 200/231 | JEMM 少 2 題,不是勝出 |
| Mind2Web text only | 45.8% | 35.2% | 同為文字輸入,官方差距 10.7 點 |
| Mind2Web screenshot | 54.6% | 36.0% text only | 輸入條件不同,不是公平的純模型對比 |
截圖任務 54.6%:多模態有用,但比較條件不相同
Mind2Web 是網頁操作資料集。官方用 894 題測得 JEMM 在加入 screenshot 後為 54.6%,Jev 的文字輸入為 36.0%。這可以證明畫面資訊對 JEMM 有幫助,卻不能證明同條件下「JEMM 模型比 Jev 強 18.6 點」,因為 Jev 並沒有看到截圖。
同一份圖表的 text-only 測試較適合直接比較:JEMM 45.8%,Jev 35.2%,樣本數 1,200。即使如此,它衡量的仍是特定題目與候選答案,不等於完成整個網頁工作流的成功率。
例如模型選對「按下結帳」按鈕,後續仍可能遇到登入、庫存、付款驗證或畫面更新。團隊應另外量測 end-to-end task success,而非只看單一步驟分類準確率。
延遲 271 毫秒比 455 毫秒快,能直接套用嗎?
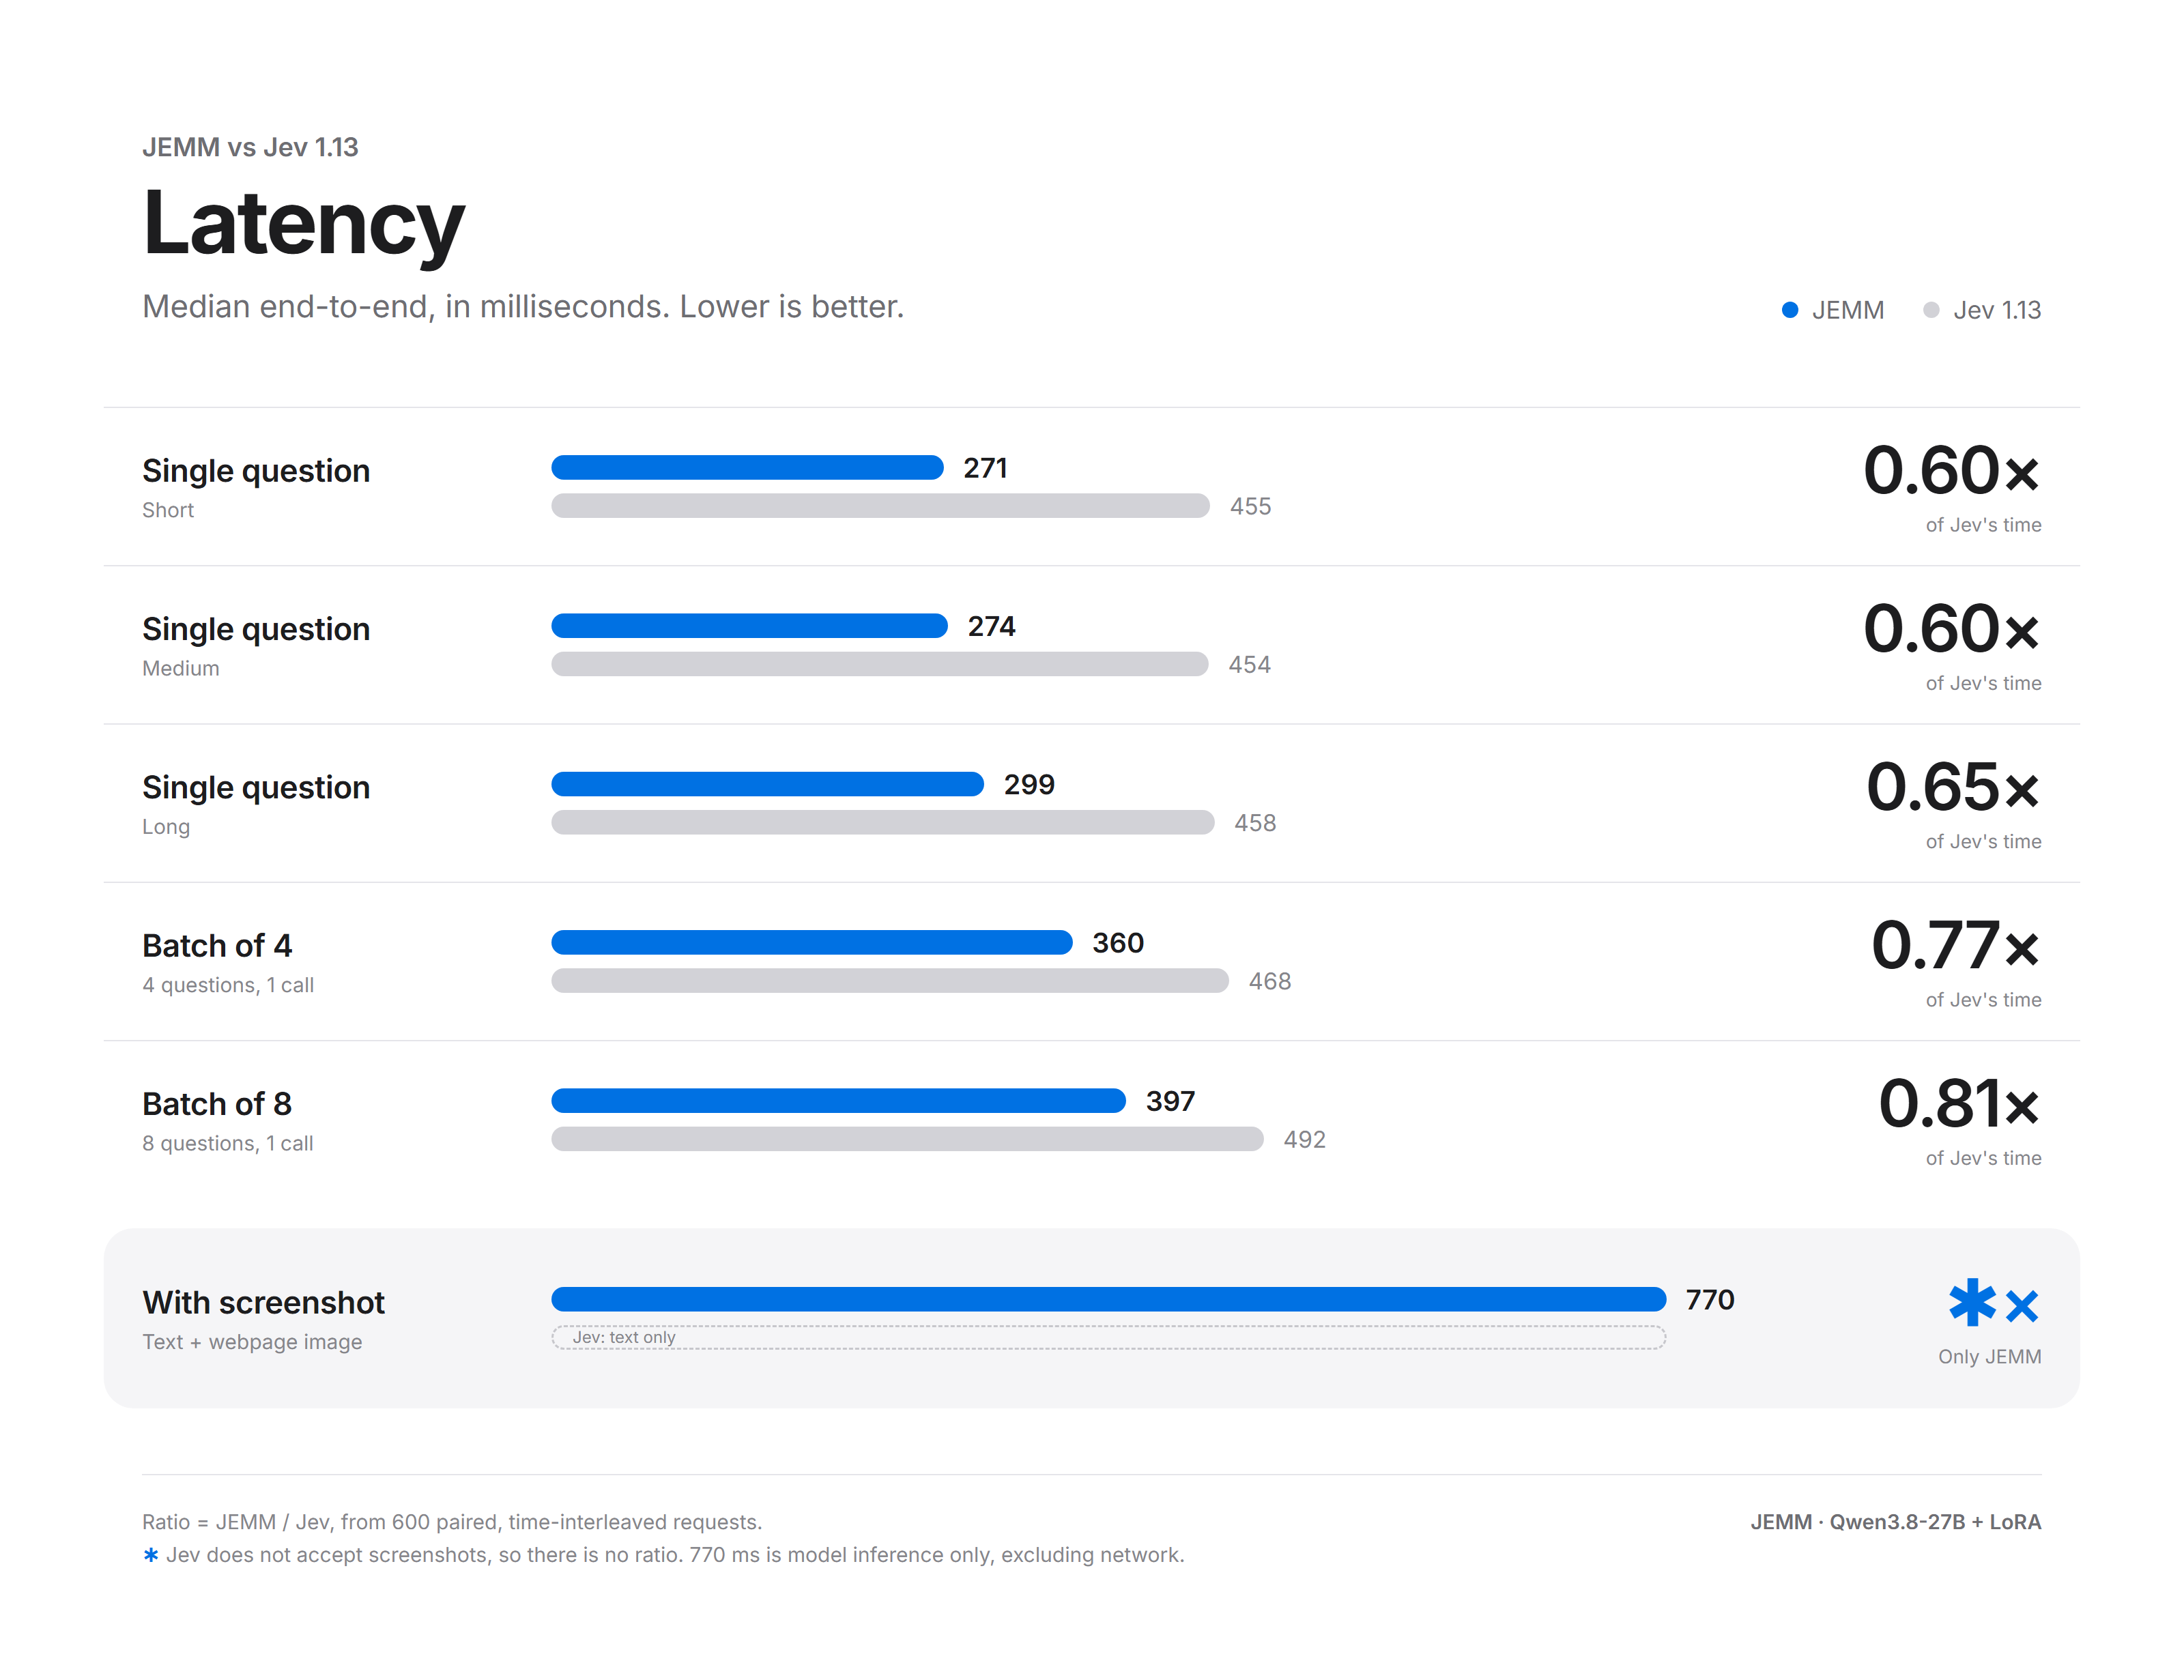
官方 latency 圖顯示,短題 JEMM 中位數為 271 ms、Jev 為 455 ms,中題是 274 vs 454 ms,長題是 299 vs 458 ms。一次處理 4 題是 360 vs 468 ms,8 題則是 397 vs 492 ms。
圖下注明這是 600 組 paired、time-interleaved requests 的 end-to-end 中位數。paired 代表相同工作成對比較。time-interleaved 則讓兩種服務交錯執行,減少不同時段負載造成的偏差。
這只能說官方測試環境中 JEMM 較快。自架之後的 GPU 型號、量化、batch、網路、佇列與同時使用者都會改變延遲。截圖任務的 770 ms 更只計算模型推論、排除網路,而且 Jev 不接受截圖,沒有可比數字。
開源與自架的實際代價
官方 server 可以透過 POST /v1/systemone 提供與 Jev 類似的 HTTP 介面。對想把資料留在自己環境、控制版本或避免外部 API 相依的團隊,這是很實際的優點。
但自架不等於免費。至少要計算:
- 64 GB 以上 GPU 的租用或採購成本。
- 模型載入、監控、佇列、擴縮與故障切換。
- adapter 和基礎模型版本鎖定。
- 截圖是否含個資、帳號或商業機密。
- 自信門檻的校準與錯誤決策的補救成本。
如果每天只有少量請求,由供應商代管運算的 API 可能更省。如果流量穩定、資料不能外流,或每個判斷都需要截圖,自架才更有機會展現價值。
訓練資料公開,不代表沒有資料重疊風險
model card 列出 Mind2Web、Multimodal-Mind2Web、BFCL、MetaTool、Banking77、CLINC150、MASSIVE、Aegis 2.0 等資料集,也聲明沒有使用 Jev 的輸出。
公開訓練清單有助於審查,但仍無法排除 benchmark 與訓練資料直接或間接重疊,也不能代表真實業務分布。特別是自家工具名稱、繁體中文描述、罕見錯誤畫面與跨頁狀態,往往不在公開測試中。
導入前應準備一套未參與調整的 private holdout。holdout 是先保留、不拿來訓練或調參的測試題。它比公開榜單更能反映模型遇到陌生案例時是否可靠。
怎麼評估 JEMM 是否適合自己的 Agent?
建議用五層檢查:
- 候選品質:工具描述是否清楚,是否包含「不做任何事」或轉人工選項。
- Private accuracy:用真實但去識別資料測試 top-1 選擇。
- Calibration:信心 90% 的案例,是否真的約有 90% 正確。
- End-to-end:選擇正確後,整個任務是否完成,還是卡在後續步驟。
- Cost and latency:在預定 GPU、同時使用量與截圖大小下,量測 p50、p95 與每千次成本。
高風險動作還要加入 deterministic guardrails。這是固定規則,例如「沒有付款權限就不能執行」、「刪除前一定要二次確認」。模型可以提出建議,但不能靠 confidence 取代授權。
JEMM 常見問題
JEMM 是可以聊天的 27B 大模型嗎?
它的主要用途是在給定候選答案中做判斷,並非自由聊天。JEMM 本身是 Qwen3.8-27B 的 LoRA adapter,執行仍需要基礎模型。
下載 467 MB adapter 就能跑嗎?
不能。還要載入約 27.78B 參數的 Qwen3.8-27B。官方 server 要求至少 64 GB VRAM 的 CUDA GPU。
85.7% 是否表示打敗 Jev?
不是。JevBench 公開題中 JEMM 是 198/231,Jev 1.13 是 200/231。兩者接近,但 JEMM 少答對 2 題。
93.3% 能保證工具呼叫安全嗎?
不能。那是 BFCL 特定測試的官方結果。實際工具目錄、語言、權限與輸入都不同,還需要私有測試、信心門檻、固定規則與人工核准。
JEMM 可以直接看網頁嗎?
它可以接收最多 4 張 screenshot,但不會自行操作瀏覽器。瀏覽器擷取畫面、執行動作與檢查結果仍要由外部 Agent 系統負責。
結語:把「判斷」拆成獨立元件,比榜單輸贏更重要
JEMM 最值得注意的不是單一 93.3% 或 85.7%,而是把 Agent 的選擇問題做成一個可自架、可看截圖、能回傳機率並允許 abstain 的獨立元件。
它在官方多項測試中高於 Jev 1.13,也在 JevBench 公開題少 2 題。這兩件事可以同時成立。真正的採用標準應放在自家未見資料,確認選擇準確率、信心校準、端到端成功率、延遲與總成本,不能只挑最好看的數字。
如果 JEMM 能在你的真實工具與畫面上維持穩定校準,並以合理成本降低錯誤呼叫,它就是值得部署的判斷層。在此之前,它仍是一個需要嚴格驗證、不能越過安全閘門的開源候選方案。