JEV-as-a-Judge 是什麼?AI 評審省 277 倍,不確定時再交給 GPT-6
JEV 先做低成本判斷,低信心才交給 GPT-6。本文釐清 0.36% 費用、277 倍、99% accuracy 的實驗條件與不能泛化的範圍。
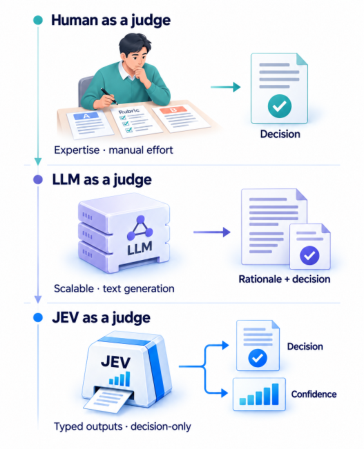
AI 產品每天都可能產生數千、數百萬個回答。團隊不只要讓模型回答,還要判斷答案是否正確、是否符合指示、兩個版本哪個比較好。常見方法是再叫一個大型語言模型當評審,這就是 LLM-as-a-Judge。
問題是,評審本身也會花錢、等待,甚至給出不穩定的分數。Carnegie Mellon University 研究團隊在 2026 年 9 月提出 JEV-as-a-Judge:先讓一個只做決策、不生成長篇理由的服務給出判決與標籤機率。有信心就接受,不確定才升級給更強的 LLM judge。
論文最吸睛的數字是:在普通偏好比較與有證據可核對的事實判斷上,JEV 與實驗中最強的 GPT-6 judge 差距在 3 個百分點內,估算費用只有其 0.36%,也就是約便宜 277 倍。
但這不代表 JEV 能全面取代大型模型。遇到需要逐步驗算、程式推理,或「錯答案寫得特別漂亮」的情況,差距會明顯拉大。真正值得寫的是這種分層評審架構:便宜模型處理有把握的案件,昂貴模型集中在疑難案件,而非只看一個便宜倍數。
LLM-as-a-Judge 為什麼會成為成本問題?
LLM-as-a-Judge 會閱讀題目、候選回答與評分規則,再輸出偏好、分數或是否通過。它能處理比 BLEU、字串比對更開放的任務,也能應用在聊天品質、RAG 事實性、程式答案和訓練資料篩選。
只是大型推理模型往往要產生許多 reasoning tokens,最後即使只回傳「A 比 B 好」,背後仍可能跑了一段長推理。當同一批回答要反覆回歸測試、A/B 比較、線上監控,評審成本會直接變成產品成本。
另外,能產生流暢理由不等於判決一定正確。LLM judge 可能偏好較長、較有自信或排版較好的回答,也可能受候選順序影響。這篇研究因此把所有 generative baselines 也限制成相同的輸出契約:只要離散判決與 label probabilities,不比較誰的解釋寫得漂亮。
JEV 和一般語言模型有什麼不同?
JEV 在論文中是一個 hosted decision service。它接收 structured state、問題與有限的答案選項,回傳 typed decision 和每個 label 的機率,不逐字生成一段評論。
例如,評審可問「回答 A 或 B 哪一個比較好」,JEV 直接回傳選擇與 A、B 的 probability distribution。最高 label probability 記為 q,研究團隊把 q 當作信心訊號。
這裡的「有信心」指輸出分布集中在某個 label,與模型口頭自稱「我很確定」不同。JEV 另有 native confidence,但它與最大 label probability 在三個主要 benchmark 的 Spearman correlation 高達 0.948 至 0.999,因此研究統一用 q 分析錯誤與升級規則。
必須注意,論文比較的是完整服務,不是公開模型架構。JEV 的實作是 proprietary,外界無法從這篇研究完整檢查參數量、訓練資料或訓練重疊。
研究怎麼比較 17 種 AI 評審?
研究涵蓋 17 個 judge configurations,包括 JEV、不同 GPT、Claude、Gemini、Groq hosted models,以及 local Qwen、PairRM、Skywork 等基準。主要任務有三種:
- RewardBench:一般聊天、安全、推理等偏好比較,研究取 400 pairs。
- JudgeBench:知識、推理、數學、程式等有客觀正解的比較,共 350 pairs。
- HaluEval:根據提供的 evidence 判斷回答是否支持事實,共 240 judgments。
研究保留 invalid outputs 並一律當錯誤,沒有把失敗請求偷偷刪掉。差異也用 source-question cluster bootstrap 計算區間,避免同一題的多個版本被當成完全獨立資料。
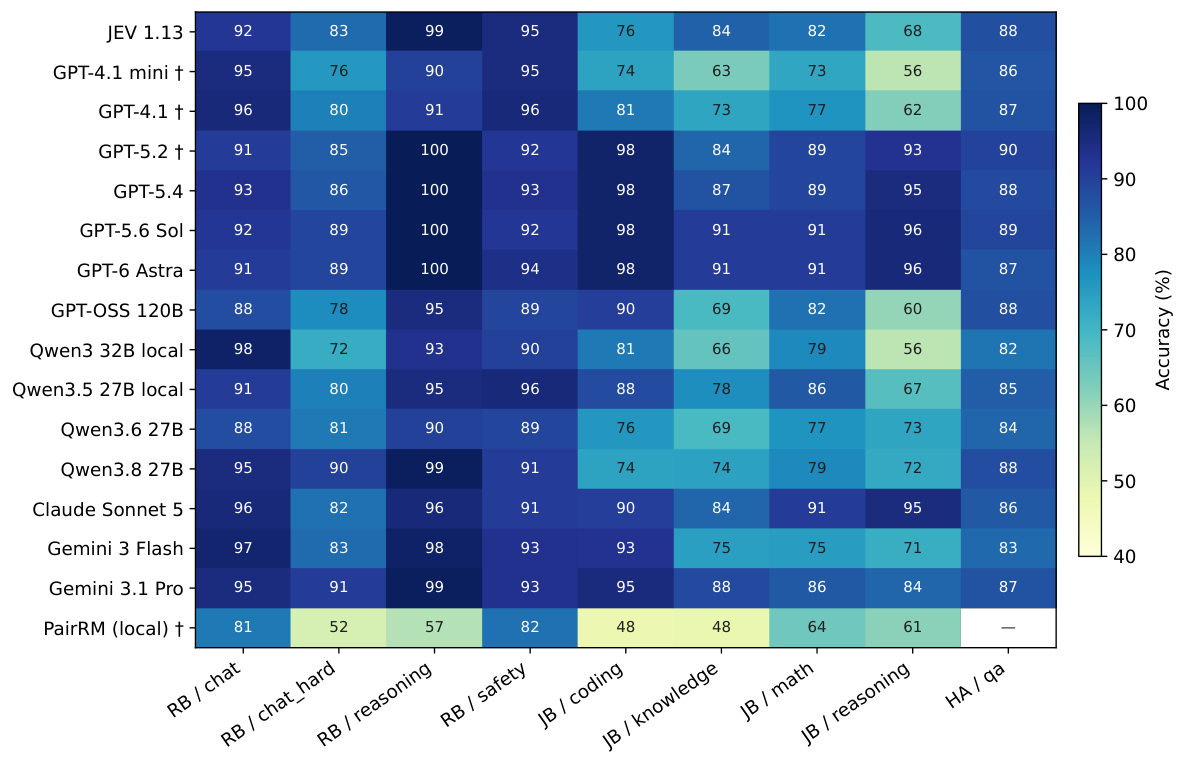
| 主要 benchmark | JEV | GPT-6 | 應如何解讀 |
|---|---|---|---|
| RewardBench | 92.2% | 93.5% | 差 1.3 點,普通偏好接近 |
| HaluEval | 87.5% | 86.7% | 原標籤下 JEV 略高,但有明顯 label noise |
| JudgeBench | 78.6% | 93.1% | 差 14.6 點,推理與程式是弱項 |
HaluEval 的原始分數尤其不能只看排名。研究者人工複核兩者共同「答錯」的 26 個案例,發現其中 24 個 benchmark labels 並不被 evidence 支持。修正這些 labels 後,JEV 為 95.8%,GPT-6 為 98.3%。較穩健的結論是:在 evidence-grounded factuality 上,JEV 仍落在 GPT-6 的 3 點以內,而不是 JEV 全面勝出。
277 倍便宜是怎麼算的?
研究另用固定的 120-decision panel 測量 latency 和費用。JEV median latency 是 0.152 秒,估算每 1,000 次判斷 0.044 美元。對照 GPT-6 low-effort configuration,JEV 費用約為 0.36%,因此得到約 277 倍便宜。
這些數字是根據實際回報 token usage 和 2026 年 9 月收集當時的定價估算,不是供應商 invoice。不同模型的大小與 reasoning effort 也沒有 compute-matched。
0.152 秒包含研究 client 所在地、網路、provider latency 和 retry,不是純模型 kernel speed。測試只涵蓋 120 個 decisions,不能推論所有地區與流量尖峰都一樣快。
因此,較精確的寫法是「在這個固定 panel 與當時價格下,每千次約 0.044 美元、median 0.152 秒」,而不是「任何公司都能固定省 277 倍」。
JEV 在哪裡表現好?
JEV 最適合答案集合有限、rubric 明確,而且有 reference 或 evidence 可檢查的工作。像是:
- 兩個客服回答哪個比較符合既定政策。
- RAG 回答是否被指定證據支持。
- 輸出是否符合格式、分類或 pass/fail 規則。
- 大量候選資料先做低成本 preference filtering。
RewardBench 的 92.2% 對 93.5%,以及人類複核後 HaluEval 的 95.8% 對 98.3%,顯示 decision-only judge 在這類任務可以成為便宜的第一道篩選。
它也在所有 1,312 個主要 items 上回傳 valid output。對大量線上監控而言,可用性和 unit cost 有時比每一題都請最強模型更重要。
哪些題目一定要升級?
JudgeBench 把界線畫得很清楚。JEV 整體 78.6%,GPT-6 為 93.1%。其中 reasoning 是 68.4% 對 95.9%,coding 是 76.2% 對 97.6%。
這些題目不只要看最後一句,還要檢查推導過程、程式行為或中間步驟。decision-only interface 可以省掉生成理由,但模型若缺乏足夠的內部推理能力,介面再乾淨也不會把錯誤變成正確。
RM-Bench 還測出 style bias。當 rejected answer 寫得更 elaborate,JEV 從同風格條件的 84.0% 降到 74.8%,少了 9.2 點。GPT-6 則從 93.3% 到 94.6%,沒有同方向下跌。換句話說,錯答案只要寫得更完整、更像專家,JEV 更容易受騙。
reference-free prose 也不在目前可信範圍。該任務中,JEV confidence 對錯誤的 AUROC 只有 0.518,接近隨機,調高 threshold 也救不了。這代表不能看到「JEV 能評分」就直接拿去判作文、品牌語氣或開放式創作。
Accept when confident, escalate when unsure 怎麼運作?
流程很簡單:先讓 JEV 判斷。如果最大 label probability q 高於 threshold,就接受 JEV。否則把同一題交給 GPT-6 或另一個強 judge。
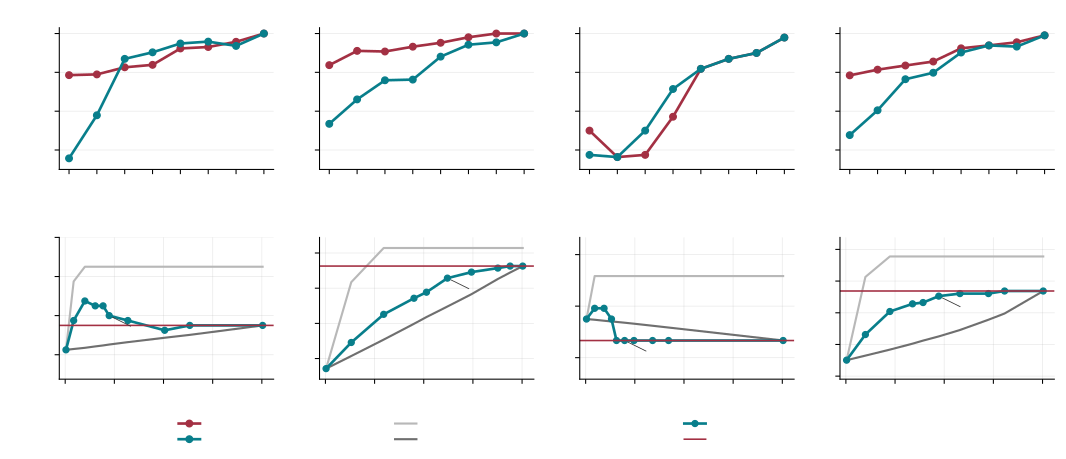
在 990 個 base-order judgments 中,q 小於 0.6 的 65 題,JEV 只答對 47.7%。q 等於 1 的 322 題,則答對 99.1%。GPT-6 在相同 bins 從 78.5% 到 99.1%,顯示大型 judge 的主要優勢集中在 JEV 自己沒把握的區域。
用 post-hoc threshold 0.9 模擬時,系統升級 34% items,整體 accuracy 91.3%,GPT-6 全包是 91.7%,也就是保留 99.6%。費用約為 GPT-6 全包的 47%。但這個 threshold 是看過同批資料後選的,不能當正式部署證據。
較嚴格的 frozen two-order policy 先在 selection set 決定規則,再到 510 個 extension preference pairs 測試。threshold 0.9 時,JEV 接受 53.7%,cascade 為 92.5%,GPT-6 為 93.1%。費用約為 fallback 的 56.8%。這才是論文摘要所說「保留約 99% accuracy、使用較低成本」的主要根據。
為什麼信心不能當保證書?
confidence 只在「模型知道自己不擅長」時有用。如果模型被漂亮錯誤答案騙到,還給出很高機率,升級規則就看不見危險。
RM-Bench 的 hard pairs 正是這種情況。在 q 介於 0.9 到 0.95 的案例裡,JEV 仍有三分之一判錯。即使 q 在 0.95 到 0.99,也有 15% 錯誤。threshold 0.9 cascade 只保留 GPT-6 accuracy 的 96.5%,要調到 0.95 並升級 58% 才能保留 98.7%。
threshold 也不會自動跨模型、跨任務通用。frozen policies 中,GPT-5.6 fallback 的 threshold 0.7 在 extension pairs 上損失 2.35 點,超過原先容忍範圍。論文因此建議每個 workload 都要用本地 selection set 選門檻,再以 held-out data 驗證。
企業導入時可以怎麼設計?
最穩健的做法是保留現有 judge,並建立三層防線:
- 先用 deterministic checks 處理 JSON schema、長度、必要欄位等可程式化規則。
- 再用 JEV 類 decision model 處理有限 labels、明確 rubric、大量重複判斷。
- 把低信心、推理密集、風格可疑或高風險案件交給強 LLM 或人工複核。
門檻要根據錯誤成本設定。行銷標籤判錯一次和醫療、金融、資安判錯一次不是同一風險。除了總 accuracy,還應記錄 escalation rate、每類錯誤、confidence calibration、invalid rate、實際費用與 end-to-end latency。
若候選順序可能影響偏好,研究建議 A/B 和 B/A 都評一次,再對齊機率取平均。這會多一次 JEV 費用,卻能降低位置偏誤,也與 frozen policy 的 two-order 設計一致。
這篇研究有哪些未解問題?
第一,JEV 是 proprietary service。研究無法提供 model internals,讀者也無法排除 benchmark training overlap。
第二,人工複核只涵蓋 183 個兩個 judge 意見不同的 items,由研究團隊一位作者完成。這能檢查 label noise,卻不是多評審、大規模 consensus study。
第三,cascade 是 offline simulation。真實系統先呼叫 JEV、再條件式呼叫 fallback 的 sequential latency、rate limits、failure handling 尚未實測。
第四,專業領域、長篇開放式寫作和真正對抗式輸入沒有充分驗證。JEV 可以回傳 valid verdict,不代表 decision 正確。decision 正確,也不代表 confidence 已校準。
JEV-as-a-Judge 常見問題
JEV 是一個會聊天的語言模型嗎?
依論文描述,不是。它是 hosted decision service,只回傳 typed verdict、label probabilities 與 confidence,不生成評論或改寫建議。
0.36% 費用代表固定便宜 277 倍嗎?
不是。這是相對研究中的 GPT-6 low-effort configuration,依 2026 年 9 月使用量與價格估算。模型定價、輸入長度、任務和部署條件改變,比例也會變。
99% accuracy 是 JEV 自己的準確率嗎?
不是。它指 frozen cascade 在 extension preference pairs 上,保留約 99% 的 GPT-6 fallback accuracy。實際分數是 92.5% 對 93.1%,費用約 56.8%。
JEV 可以直接拿來評作文嗎?
目前證據不支持。reference-free prose 上 confidence 幾乎無法辨識錯誤,論文也明確建議不要信任任何受測 judge 直接評沒有 reference 的自然文章。
最安全的導入方式是什麼?
先選有限 labels、可人工抽查、低風險的任務。以自己的 selection set 設 threshold,再在 held-out data 驗證。低信心或高風險案件交給強 LLM 或人工。
結語:真正的突破是把評審成本花在疑難案件
JEV-as-a-Judge 最有價值的觀念,是「每一題都用最貴的 judge 並不合理」,而非「小模型打敗大模型」。在普通偏好與 evidence-grounded factuality 上,JEV 能以每千次約 0.044 美元、median 0.152 秒提供可用的第一階段判斷。
當任務進入推理、程式、風格欺騙或開放式寫作,它的弱點也很清楚。這使 confidence cascade 成為更務實的設計:有把握就接受,不確定就升級。
對企業來說,部署前應用自己的資料驗證三件事:JEV 在哪裡答得對、它是否知道自己何時可能答錯,以及升級後究竟省下多少真實費用與時間,不能直接照抄 0.9 threshold。只有這三件事同時成立,277 倍便宜才會從研究 headline 變成可用的產品策略。