Luma 讓影片拍完還能換衣服、背景與燈光?Modify Video 原理、用法與限制
Luma 用 AI 修改已拍影片的服裝、背景和燈光。本文說明它不是傳統像素級修圖,以及何時仍應重拍。
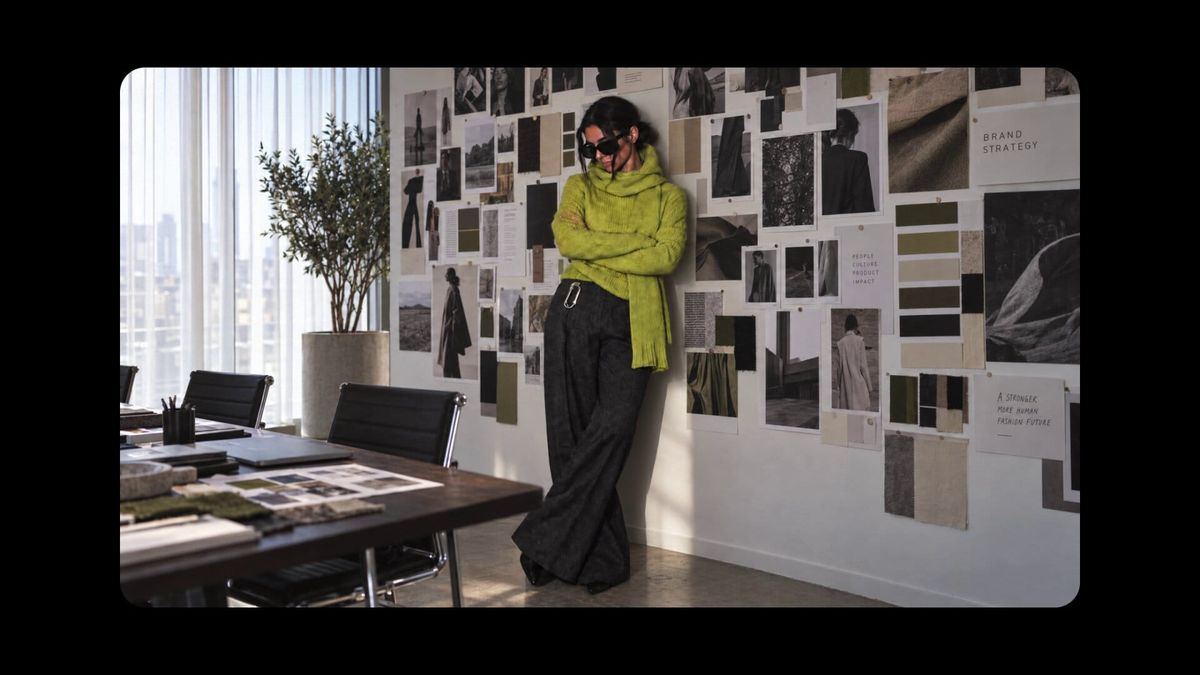
影片拍完後,客戶才發現外套顏色不對、背景不符新版活動,或主光的氣氛太冷。傳統做法可能是重回片場,或讓 VFX 團隊逐鏡處理抠像、tracking、rotoscoping、光影和合成。
2026 年 9 月 25 日,Luma 在官方 X 貼文公布一段約 20 秒的 AI 展示,主張拍攝後可對 wardrobe、background 和 lighting 進行更多修改,不必把整個團隊叫回片場。官方回覆還提供了 Luma 內的 virtual model try-on 工作流連結。
這不是傳統後製突然變成一鍵完美,也不代表所有鏡頭都能無痕替換。比較準確的理解是:Luma 將原始影片當作動作、構圖、身分與運鏡參考,再根據指令重新生成或變換畫面,目標是讓「指定的部分改變,其他部分盡量保留」。
官方 X 貼文確定了什麼?
官方文字很短,重點只有三種 post-shoot changes:服裝、背景和燈光。它的價值主張是降低重拍需求,不是宣布重拍已經消失。
影片上也標有 Made with AI,表示它是生成式處理的範例。但貼文沒有提供所有 prompt、重試次數、原始與成品的逐幀誤差,也沒有說明每個同類鏡頭的成功率。因此它能證明功能方向與範例效果,不能當作絕對品質保證。
Modify Video 和傳統生片有什麼不同?
文生影片從文字建立一個新鏡頭,模型要同時決定人物、構圖、動作、鏡頭與場景。Video-to-video Modify 則有原始影片當時間骨架,可以沿用演員動作、鏡頭移動與時間節奏。
但它通常不是在原始檔案上只改幾個像素。生成式修改會重合成區域甚至整幀,因此才會有人臉漂移、衣物紋理跳動、手指變形、logo 失真和陰影不連續的風險。
為什麼換衣服比單幀修圖難?
一件衣服在影片裡會隨身體旋轉、皺褶、受風、被手遮擋,還會接收場景中不同方向的光。如果只把單幀外套貼上去,下一幀的邊緣、紋理和陰影就可能換位。
Modify Video 的核心難題是 temporal consistency,也就是時間一致性。模型不只要讓每一幀看起來正確,還要讓相鄰幀的衣服版型、紋理、光影與遮擋關係連續。快速動作、motion blur、細密格紋、鏡面反光和物件交叉都會讓問題更難。
背景與燈光為什麼要一起思考?
如果將白天街道改為露營場夜景,主角還保留正午太陽的硬陰影,觀眾會立刻覺得人物像貼上去。背景替換會連動影響主體邊緣、反光、環境色、地面陰影與鏡面。
所以好的 prompt 不能只說「換背景」。它要同時定義什麼要變、什麼要鎖定,並要求新環境的光影和反射自然地影響主體。Luma 的官方 Layers 教學也建議,改變環境時要一併更新窗戶反射或關聯陰影。
Luma 現行產品說明了哪些能力?
Luma 目前的 Ray 產品頁將 Modify Video V2 定位為「變換既有素材」,並使用「替換牆、世界、服裝,保留燈光與表演」的描述。該頁也宣稱可處理最長 20 秒、1080p 輸出。
但產品頁的廣泛能力不能自動當作這則 X 展示的完整技術配置。X 回覆連到 virtual model try-on app,卻沒有在貼文本體列出底層模型版本、強度或重試參數。本文因此只將 Ray 頁面當作 Luma 當前整體能力說明,不反向推定 demo 的每個技術細節。
一個穩定的拍後修改流程怎麼做?
| 階段 | 要做的事 | 驗收重點 |
|---|---|---|
| 鎖定源片 | 保存原檔、剪輯區間與 hash | 後續能回到同一版原片 |
| 定義變數 | 一次先改服裝、背景或燈光之一 | 錯誤時能判斷是哪個變數 |
| 寫鎖定條件 | 列出臉、姿勢、鏡頭、動作、產品細節不能改 | 非目標區域漂移率 |
| 低成本試做 | 先用短片、低輸出或少數版本 | 身分、手、logo、布料邊緣 |
| 逐幀檢查 | 在動作大、遮擋與轉場處停格 | 閃爍、形變、陰影斷裂 |
| 音訊與觀感檢查 | 撥放完整成品 | 節奏、嘴型與音訊是否偏移 |
| 人工合成與回滾 | 只修失敗片段,保留原片備援 | 是否真的比重拍便宜、快且可接受 |
這種流程不應從完整廣告一次全改開始。最容易成功的起點是短鏡頭、單一主角、運鏡穩定、衣物邊緣清楚,而且修改項目單純。
Prompt 要怎麼寫?
實用結構可以分成四部分:目標修改、必須保留、物理整合,以及禁止變動。
例如:「將主角的黑色外套替換為附圖的深綠色風衣。保留人物的臉、髮型、身形、姿勢、手部、表情、鏡頭移動和背景。讓風衣皺褶、反光、陰影和遮擋符合原始動作。不要更改相機位置、臉部特徵或場景色調。」
如果要改背景,再將輪廓邊光、地面陰影、窗戶反射與環境色列入物理整合。一次改一件大事,通常比同時改衣服、場景、年齡、髮型和鏡頭更容易檢查。
什麼情況仍然應該重拍?
如果鏡頭是產品、法規或身分高敏感內容,不能容忍細小外觀改變,重拍或傳統合成往往更可控。例如珠寶鉲嵌、醫療器材操作、商標細節、精準手勢與不可改變的實際人物特徵。
原片如果有大量遮擋、快速旋轉、複雜手部交互、多人穿插、镜子和透明物,也容易讓生成式修改成本失控。如果反複生成和人工修補已超過重拍時間,「不回片場」就不再是優勢。
對廣告與電商團隊有什麼實際影響?
最明顯的用途是版本化。同一段模特兒動作可對應不同服裝配色、市場背景、季節燈光或活動主題。只要身分、產品細節和品牌標誌通過檢查,版本生產的邊際成本可能下降。
但團隊也要新增測試與記錄:哪支原片產生哪個版本、用了什麼參考圖與 prompt、誰核准身分與產品正確性、多少重試才通過。AI 降低拍攝成本,不應同時降低交付證據。
常見問題
Luma 這項功能是否等於虛擬試穿?
官方 X 回覆連向 virtual model try-on 工作流,但貼文的主張比試穿更廣,也包含背景和燈光的拍後修改。
修改後的人臉會與原片完全一樣嗎?
不能預設完全像素相同。生成式修改可能導致身分、皮膚紋理、髮絲、手和邊緣的微小變化,需要逐幀驗收。
修改燈光只是調色嗎?
不一定。如果指令改變光源方向與環境,系統還要重建陰影、高光、邊光和反射,比全片色調轉換複雜。
最長可以處理多少?
Luma 目前 Ray 產品頁宣稱 Modify Video V2 可達 20 秒、1080p。不同模型、plan 和工作流的上限可能不同,實作時應以當下介面為準。
使用 AI 修改真人服裝有什麼風險?
需要模特兒授權、品牌與服裝權利、不造成誤導的揭露,並避免將真人改成其未同意的敏感外觀或情境。
結語:重拍不會消失,更多修改可以先試算
Luma 這次展示反映一個很實際的製作變化:拍攝與後製之間的界線正在變模糊。服裝、背景與燈光過去會觸發重拍,現在可以先用 video-to-video 生成一個可驗收的版本。
這種方法的真正價值是新增一個可試算的選項。原本只有「接受瑕疵」或「整組重拍」的二選一,現在可以先做短鏡頭、單變數、可回滾的生成式修改。逐幀檢查、身分與商品正確性、授權與版本追蹤也必須成為正式流程。做到這些,AI 才能降低後製成本,避免將重拍風險藏到更後面。