NVIDIA 研究用「關鍵修正」挑模型:還不會完整解題,也能看見程式潛力
NVIDIA 與學術研究者提出關鍵步驟評量,用成功程式軌跡衡量基礎模型的訓練潛力。本文說明三種測法、十組模型的研究結果,以及相關性和實際能力保證的差別。

一個模型還不會完整操作程式工具,是否就表示它沒有成為程式代理的潛力?
這是 NVIDIA 與學術研究者的新論文想處理的問題。
研究於 10 月 7 日公開,之後在 X 引起開發者討論,關注它能否提早辨識值得訓練的模型。
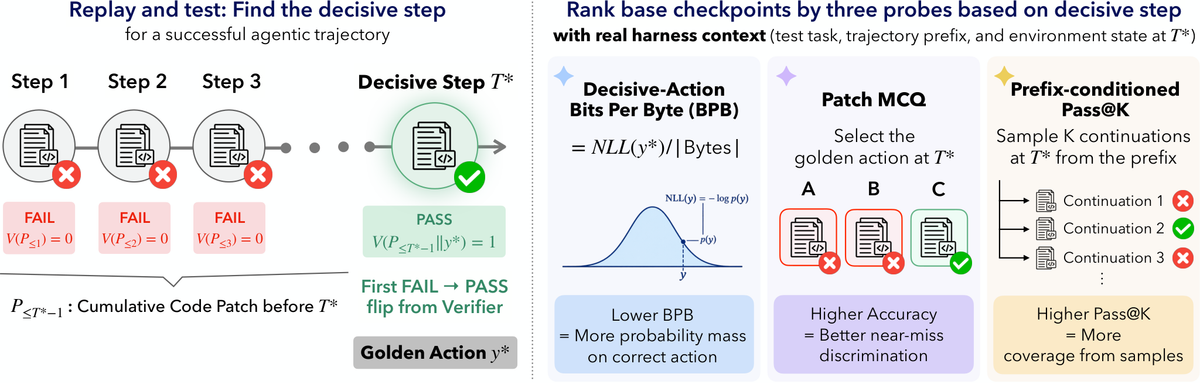
方法從成功解題的完整軌跡,找出第一次讓測試通過的關鍵修改,保留前面的程式狀態與工具脈絡。
再用這個位置評量基礎模型,觀察它與後續訓練成果的關係。
它提供的是挑選模型的研究訊號,仍不能當成未來能力的保證。
完整解題測試,可能看不出基礎模型的差別
基礎模型指的是完成預訓練,但尚未針對特定互動與工具流程完成後續訓練的模型。
如果直接要求它讀檔、改程式與執行測試,失敗可能出在工具格式,而不只是程式能力。
研究的完整流程試驗中,六個基礎模型有五個沒有解出題目,讓這種方式很難提供有用排名。
但只測一次產生的短程式,又可能離實際長任務太遠,無法反映持續處理程式庫的能力。
研究因此在兩者之間找一個位置:保留真實任務脈絡,降低從頭操作工具的門檻。
這讓評量更接近需要比較的潛力,而不是讓格式失敗掩蓋所有差異。
關鍵步驟,讓測試決定哪個修改真正有效
研究先取得已成功完成的代理工作軌跡,再依序重放每個修改並執行測試。
第一次使累積修改從失敗變成通過的步驟,就是它要評量的關鍵位置。
這不一定是人類參考答案,也不一定是最後一次修改,而是被同一套測試接受的有效動作。
接著把該步驟之前的背景交給基礎模型,避免讓它看到待評量的答案。
這個設計把「能否修好問題」連到可執行的判斷方式,比只請另一個模型評分更容易核對。
不過,測試本身仍有範圍。通過題目測試,不會自動證明程式沒有其他錯誤。
三種測法,分別看機率、選擇與產生能力
第一種方法觀察基礎模型對有效修改給予的機率,並依內容長度調整比較。
第二種方法讓模型在有效修改與未通過測試的替代方案中選擇,檢查它能否分辨。
第三種則讓模型從同一背景產生多個後續修改,再用測試確認有沒有成功的結果。
三種方法回答的問題不同,不能把其中一個分數當成全部能力。
研究在十組基礎與後續訓練模型中,發現這些排名與後續的 SWE-bench Verified 表現接近。
SWE-bench 是以程式庫問題評量解題能力的基準。這次結果支持方法的用途,樣本與測試條件仍有限。
想用來選模型,還需要自己的驗證
研究方法最直接的用途,是在投入後續訓練成本前,先篩選值得測試的基礎模型。
但相關性高,不等於每個新模型都會遵循同一關係,也不能預測某次訓練一定成功。
若團隊的目標任務和論文的程式題型不同,應先確認評量軌跡與測試能否代表自己的工作。
工具格式、程式語言與資料分佈改變,也可能影響結果,需要重新測量。
此外,正式工作還有維護性、權限與效能要求,不會只以某個測試是否通過決定可交付。
把研究訊號當成候選篩選,再保留完整的後續評量,比把排名直接當產品選型結論更合適。
常見問題
它是 NVIDIA 的新程式模型嗎?
不是,本文介紹的是評量研究,目的是比較基礎模型的後續訓練潛力。
五個模型零成功,表示它們都不能寫程式嗎?
不能這樣推論。研究指出完整工具流程會讓基礎模型難以呈現能力,這也是方法要改善的問題。
關鍵修改通過測試,就表示程式完全正確嗎?
只能確認在該測試條件下通過,其他功能與維護要求仍需要另外驗證。
結語
這篇研究把評量焦點放到真正改變結果的那一步。它讓模型選擇多了一個可核對的訊號,但訓練潛力、完整解題能力與正式交付品質,仍需要分開確認。
延伸閱讀:2026 GitHub 熱門 AI 工具推薦:10 個專案,從寫程式、自動化到影片製作怎麼選?
延伸閱讀:Atomic Machines 發表 Matter Compiler:AI 從寫程式,走向製造微型機器