onPanda 是什麼?只改第一個錯誤 Token,AI 資料標註時間少 52%
onPanda 讓標註員修正第一個錯誤 token,再由模型續寫。本文檢查 52% 時間縮短、on-policy fidelity、Panda-CVL 與技術限制。
訓練 AI 不只需要大量文字,也需要人類指出模型哪裡做錯。傳統做法通常是讓標註員把整段回答改寫完成,或從多個候選答案中排名。前者很花時間,後者只能在既有答案中挑選,難以精準指出第一個錯誤發生在哪裡。
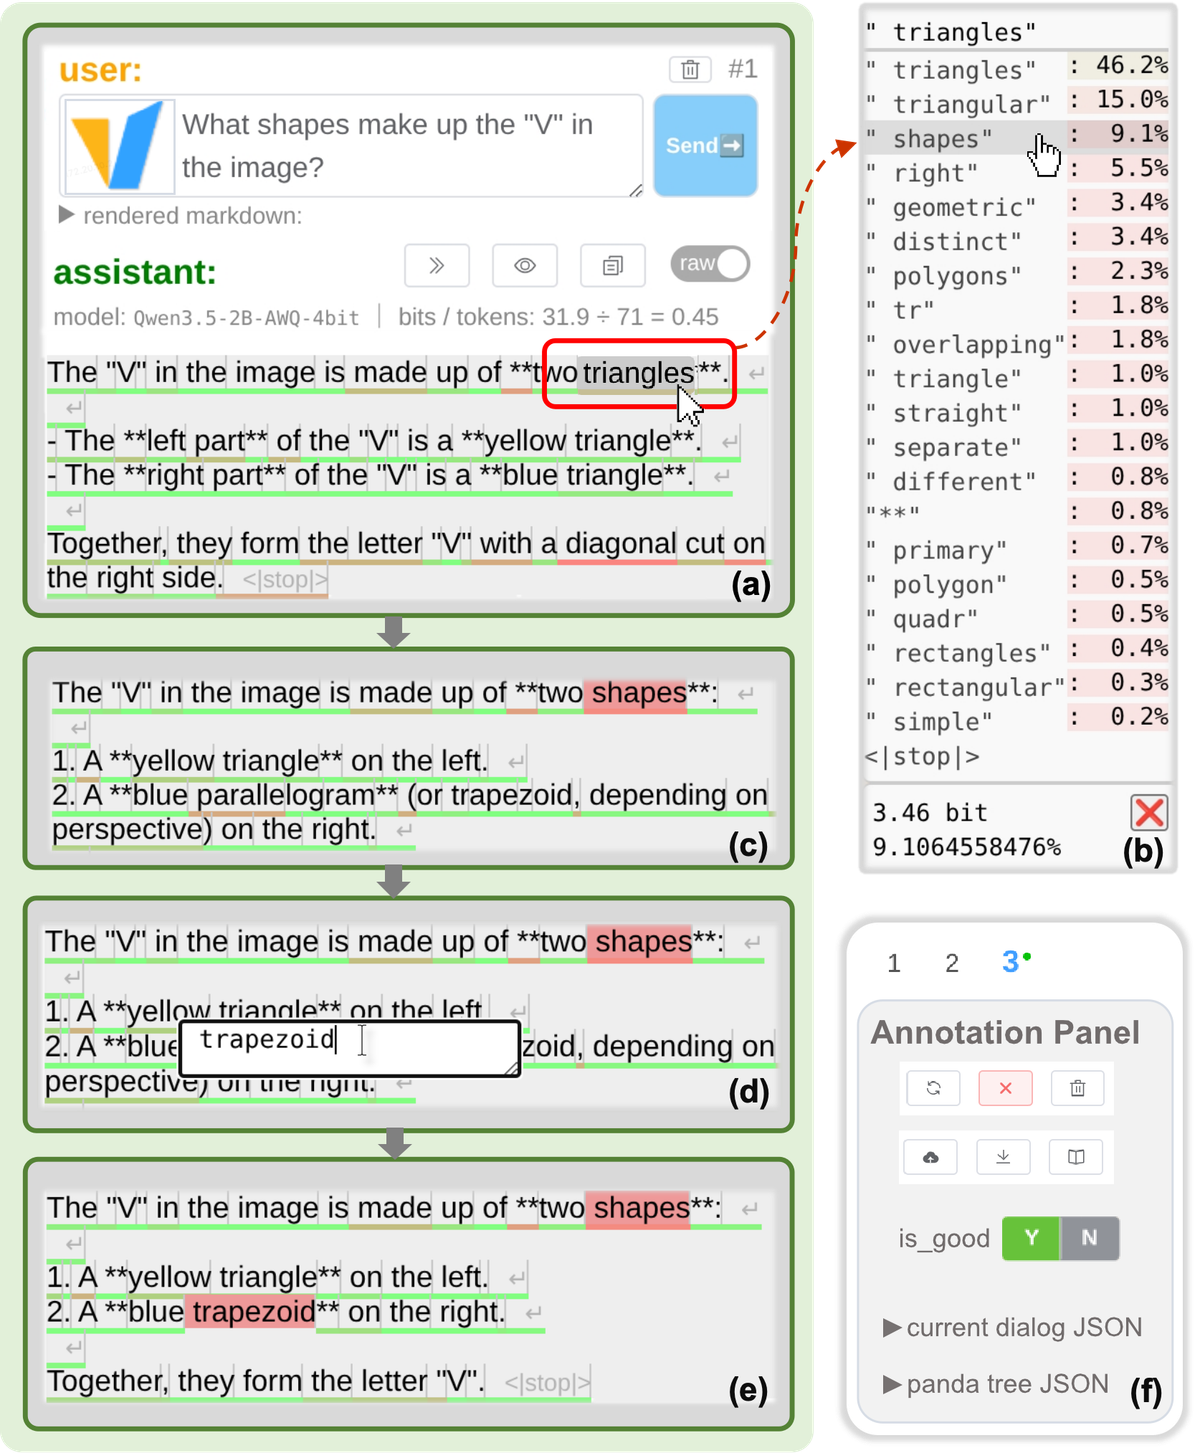
StepFun 等研究團隊在 2026 年 9 月公開 onPanda。它把修正單位縮小到 token:標註員讀到第一個不合適的位置,點選模型原本考慮過的替代 token,或手動輸入正確文字。系統刪除後續內容,再從修正後的 prefix 繼續生成。
論文的小型受控研究顯示,onPanda 每題標註中位時間為 330 秒,傳統 post-editing 工具 POTATO 是 681 秒,減少 51.5%,摘要四捨五入為 52%。但這不是「所有資料標註都快一倍」的保證。實驗只有 3 位標註員、21 個圖片描述 prompts,而且使用單一 rollout model。
Token 是什麼?為什麼只改第一個錯誤?
Token 是模型處理文字的基本片段,可能是一個字、半個詞、標點或一小段英文。模型每產生一個 token,背後都會對許多候選計算機率,再從中選出下一個片段。
一段回答前面出錯,後面往往會沿著錯誤前提繼續寫。例如把圖片中的「狗」看成「貓」,後面可能接著描述貓的花色與動作。若人類只在文章完成後 post-edit,就要逐句修掉連鎖錯誤。
onPanda 在第一個錯誤出現時改變方向。當「貓」被換成「狗」,模型從正確 prefix 重新續寫,後面的描述也可能自然恢復。這就是 locate-correct-continue:定位、修正、續寫。
onPanda 的操作流程
標註員先讀模型生成內容。滑鼠移到某個 token,可看到 top-k alternative tokens 與 probability。若候選中有正確答案,就直接點選。若都不合適,也能 free-form edit。官方 GitHub README 提供了完整操作 GIF,但這份 Ghost 草稿改用較小的官方論文靜態圖,以避免大型動態檔在 CMS 媒體處理階段逾時。
修正後,系統截斷該位置之後的 tokens,要求同一 rollout model 從新的 assistant-message prefix 繼續生成。標註員再往下閱讀,遇到下一個錯誤就重複一次,直到整段回答符合品質標準。
這套 UI 也能處理 reasoning、tool calls、圖片、音訊與影片輸入。它可以連接 MCP servers 與 Claude Code、Codex、OpenCode 等 harness,讓 corrected tool call 真正執行後,再把新 observation 交回模型繼續走 agent trajectory。
為什麼研究特別強調 on-policy?
On-policy data 可簡單理解為「很接近目前這個模型自己會產生的資料」。如果人類整段重寫,文字風格、句型和內容分布可能離模型原本的 sampling distribution 很遠。
對 SFT 而言,模型需要模仿 qualified response。對 preference learning 而言,系統需要知道哪個分支較好。onPanda 只在少數關鍵點介入,其餘 tokens 仍由 rollout model 產生,因此希望保留更多 on-policy fidelity。
每次 correction 也留下精確位置。錯誤 token 與替代 token 天然形成 positive-negative pair,修正前後的分支可形成 preference data,最後 qualified response 則可成為 SFT target。同一次標註不只得到一份完成答案,也得到細粒度的修正軌跡。
52% 是怎麼測出來的?
受控比較使用 3 位全職標註員與 21 個 image-description prompts,評估 onPanda、POTATO 和 Argilla。POTATO 代表 manual post-editing,Argilla 則讓標註員從四個 rollouts 中做排序與選擇。
| 工具 | 每題中位時間 | 每題平均時間 | Qualified SFT coverage |
|---|---|---|---|
| onPanda | 330 秒 | 515.6 秒 | 100%(持續修到合格) |
| POTATO | 681 秒 | 711.1 秒 | 100%(持續修到合格) |
| Argilla | 336 秒 | 684.5 秒 | 52%(11/21) |
onPanda 中位時間比 POTATO 少 51.5%,平均時間則少 27.5%。它與 Argilla 的中位時間接近,但 Argilla 的平均值高很多,反映較難 prompts 上閱讀四篇長回答造成 long tail。
品質方面,論文報告 onPanda 的 LLM-judged pairwise win rate 為 66.7%。另有匿名人工小型比較,onPanda 對 POTATO 的偏好率為 54.8%。前者仍依賴 LLM-as-a-Judge,不能當成大規模人類共識。
資料真的更接近模型分布嗎?
研究使用 perplexity,簡稱 PPL,觀察修正後文字對 rollout model 來說有多自然。Resampling baseline 是 1.171。onPanda 為 1.181,相對增加 0.86%,落在每題 resampling 約正負 2.8% 的波動內。
POTATO 的 PPL 為 1.596,相對增加 36.31%。這支持「整段人工改寫更容易離開模型分布」的說法,但 PPL 接近不等於內容正確,也不等於訓練後一定更有效。
在 production snapshot 中,qualified responses 的 97.0% tokens 由模型直接生成,2.1% 從 candidates 選出,只有 0.9% 由標註員手動輸入。這能證明 human intervention 稀疏,尚不能證明這些 correction signals 已改善下一代模型。
標註員的工作負擔有降低嗎?
3 位標註員填寫改編版 NASA-TLX,以 0 到 10 評估六種工作負荷,分數越低越輕。onPanda 是 3.1,Argilla 5.4,POTATO 6.8。
研究中的回饋指出,onPanda 會立即顯示進度,而且 probability shading 能協助先檢查低機率 token。相較之下,排名工具要求標註員同時記住數篇長回答,更消耗工作記憶。
這項結果仍受 UI 設計影響。研究比較的是完整工具工作流,不能把所有差異都歸因於 token-level correction 這個概念。
Agent trajectory 為什麼也能標?
一般文字修正只要重新生成 suffix。Agent 執行 tool call 時,修正會改變外部環境。onPanda 可把 harness 或 tools 透過 MCP 接入,讓修正後的工具呼叫實際執行,再記錄新的 observation 與後續 actions。
例如 agent 選錯檔案,標註員可以修正 tool call 裡的路徑。系統不沿用錯誤操作後的畫面,而是從修正分支重新執行,建立一條可追溯 trajectory tree。
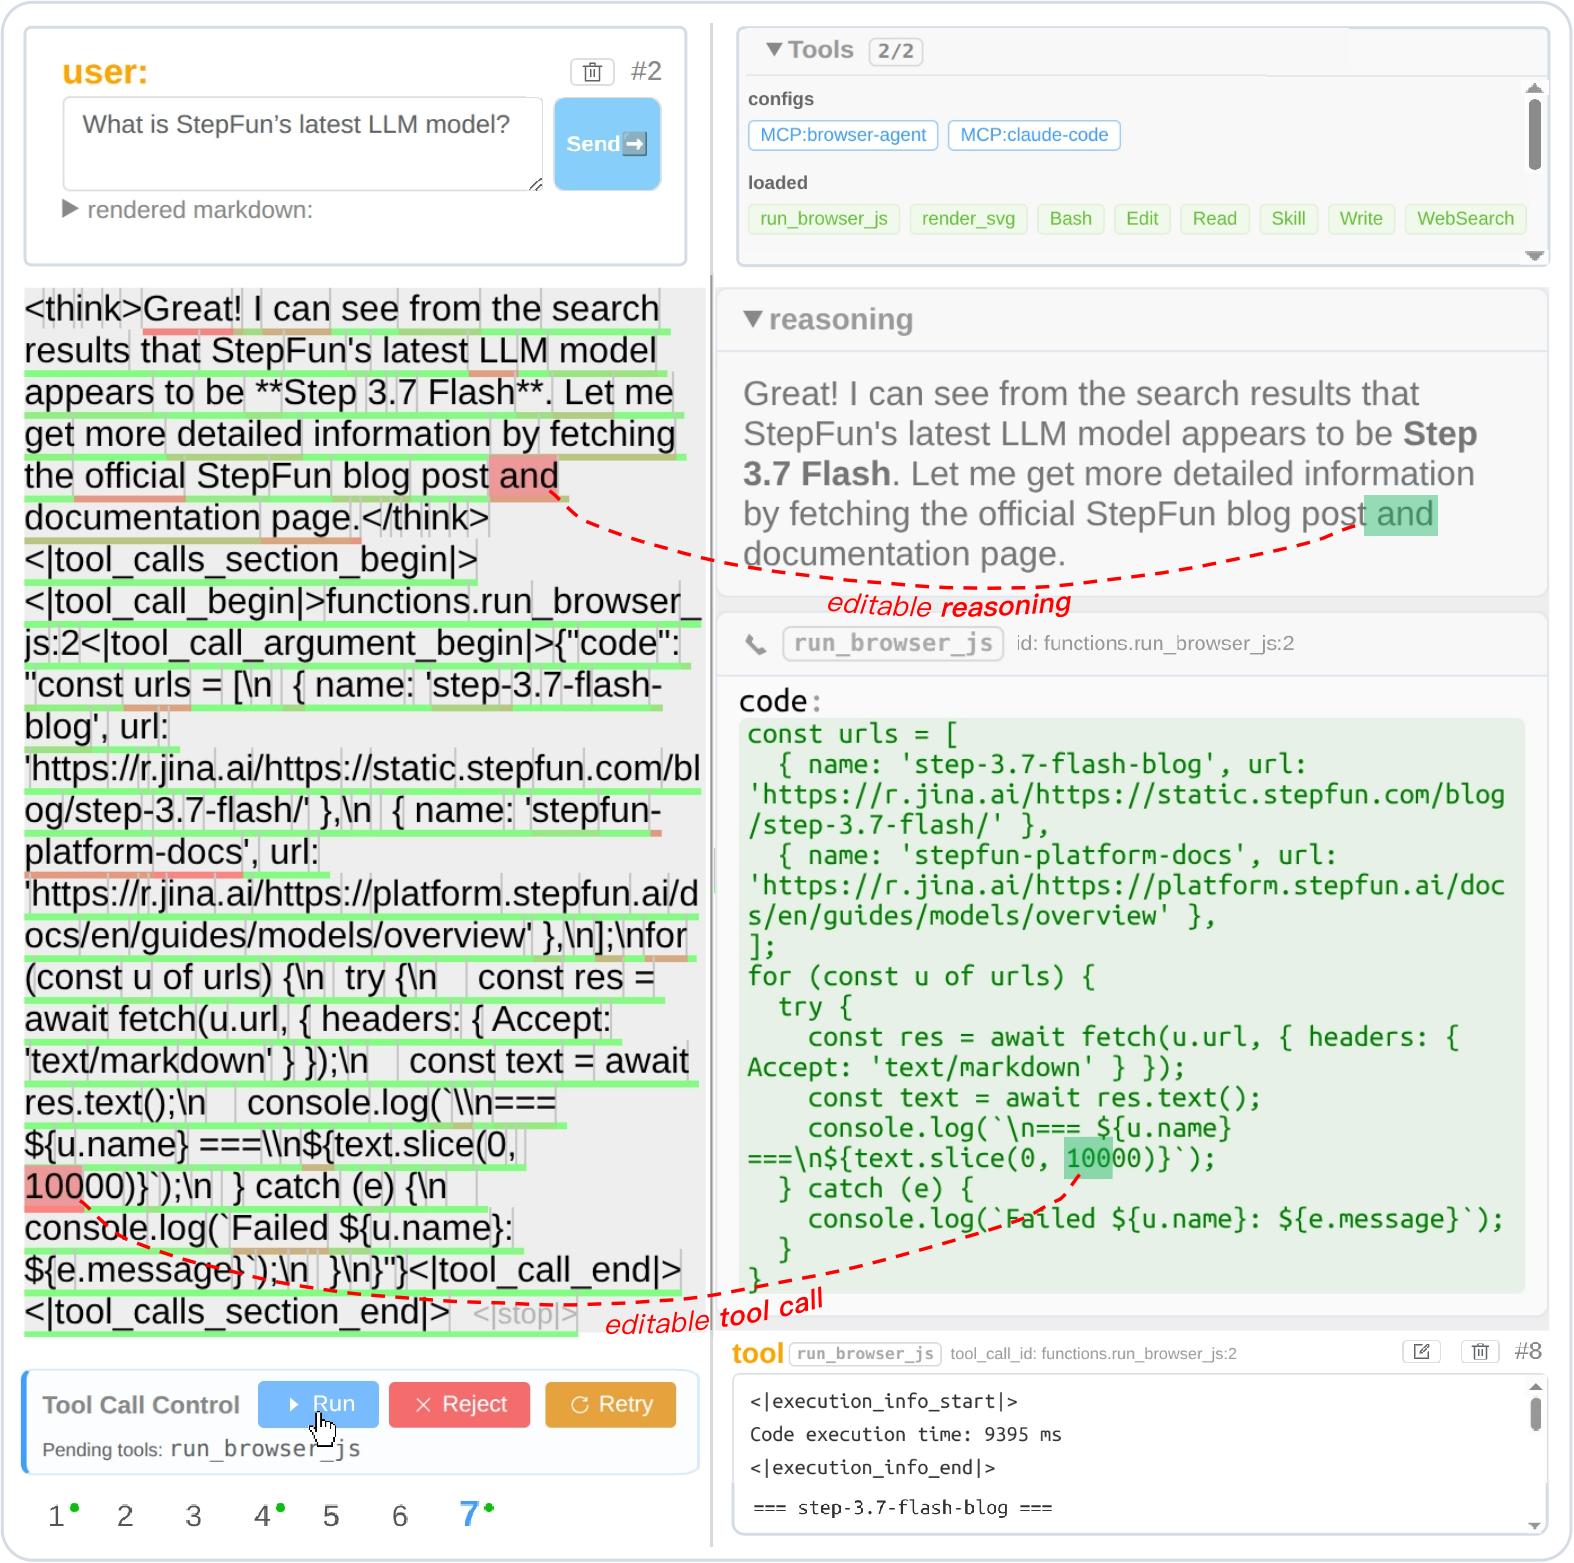
論文列出 production deployment 的 1,257 個 agentic sessions,但沒有 controlled agent study。這能證明系統具備使用與部署紀錄,不能證明 agent 任務標註也固定省 52%。
Panda-CVL 提供了什麼?
研究團隊另釋出 Panda-CVL,這是以中文為主的 vision-language token correction dataset,共 7,491 個 annotation sessions,包含 6,839 個 training sessions 與 652 個 test sessions。
Test conversations 展開後有 2,126 個 evaluation instances,其中 652 個是 final acceptable responses,1,474 個是仍需修正的 intermediate responses。模型要先判斷回答是否合格;若不合格,再找出第一個錯誤並替換。
目前 benchmark 很難。最佳 overall F1 只有 17.09%,GPT-6 的 Corr.-NG,也就是正確定位並修正不合格回答,為 15.83%。格式輸出正確不代表真的找對錯誤位置。
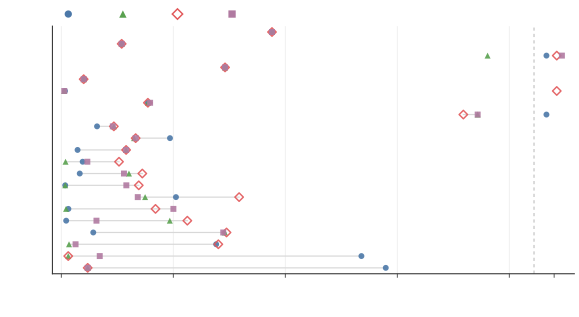
「第一個錯誤在哪裡」本身也帶有主觀性。Panda-MultiRef-21 讓 4 位標註員各自處理相同的 21 題,第一個修正位置完全一致的 pairwise agreement 是 30.95%,高於均勻隨機位置的 0.20%。容許前後 4 個 tokens 時,人類一致率升到 44.44%。這說明人類判斷有共同訊號,但單一 reference 仍不能代表唯一正解。
Panda-CVL 的論文聲明是 intended for research use only。即使 onPanda code 採 MIT License,也不能把程式授權直接延伸成資料集的商業使用權。
使用 onPanda 有哪些技術門檻?
核心互動需要模型服務的 API,也就是軟體彼此交換請求與結果的介面,提供兩種能力:從 assistant-message prefix 繼續生成,以及回傳 top-k token logprobs。若要重新計算自由編輯文字的機率,還需要 prompt_logprobs。
部分 proprietary model APIs 沒有同時提供這些能力,因此無法針對該模型收集真正 on-policy data。Open-weight models 可透過 vLLM、SGLang 等框架支援,llama.cpp 與 Ollama 能涵蓋核心互動。
不同模型的 reasoning 或 tool-call message template 也不同。接上新模型前,需要適配 response format。這是一筆一次性的 integration cost。
哪些情況不適合只靠 token correction?
onPanda 建立在 sparse-error premise:回答大致正確,只有少數位置需要人類修正。如果模型對任務理解很差,每幾個 token 就要改一次,效率與 on-policy 優勢都會快速消失,最後可能還是 free-form editing 比較實際。
On-policy 也有時效性。資料只相對 annotation-time rollout model 接近原分布。拿去訓練完全不同的模型,或模型訓練完成後的核心參數(模型權重)持續更新時,這項優勢會衰減。
最重要的是,論文沒有做 downstream training experiment。它驗證標註速度、輸出品質與 distributional properties,尚未證明 token-level supervision 會讓 fine-tuned model 在真實任務上更強。
onPanda 常見問題
onPanda 會自動修正所有錯誤嗎?
不會。核心流程仍由人類找出第一個不合適 token 並選擇替代。Panda-CVL benchmark 也顯示,現有模型自動完成定位與修正仍很困難。
少 52% 代表標註成本一定減半嗎?
不一定。52% 是 3 位標註員、21 個圖片描述 prompts、單一 rollout model 對 POTATO 中位時間的結果。其他任務、工具與錯誤密度要重新測量。
onPanda 可以產生哪些訓練資料?
最後合格回答可作 SFT data。修正前後分支可作 preference pairs,單一位置的錯誤與替代則形成 token-level correction supervision。
可以自己部署嗎?
可以。官方 GitHub 以 MIT License 開源,README 提供 Node.js 與 @on-panda/serve 的 self-hosting 方法。模型端仍需支援 prefix continuation 與 logprobs。
onPanda 和 Panda-CVL 的授權相同嗎?
不能這樣理解。onPanda code 是 MIT,論文對 Panda-CVL 的說明是 research use only。使用資料或媒體前應分別檢查其正式條款。
結語:把人類注意力放在模型第一次走錯的地方
onPanda 的想法很直覺:不要等模型寫完整篇才全面修稿,先在第一個錯誤點把方向拉回來。這能讓同一次操作同時產生 qualified response、preference pair 和位置精確的 correction signal。
小型研究的 330 秒對 681 秒、PPL 只增加 0.86%,說明這個互動方式值得擴大驗證。MIT 開源工具、線上 demo 與 Panda-CVL 也讓社群有實際材料可測。
但目前最合理的結論仍是「標註工作流更有效率」,還不是「訓練出的模型一定更強」。下一步要看更大規模、多任務、外部標註團隊的實驗,以及 token-level correction data 是否真的改善 SFT、preference optimization 與 Agent 行為。