Perplexity Portable Computer 登陸 Windows!RTX 顯卡本機跑 AI Agent:24GB 顯存門檻、零 Token 費用與雲端升級機制深度解析
Perplexity 宣布 Portable Computer 正式登陸 Windows,支援 24GB 顯存以上的 NVIDIA RTX 顯卡。本文深度解析運作架構、24GB 顯存硬門檻、零 Token 費用、按需雲端升級機制,以及與 Mac 版、開源方案的完整比較。
2026 年 9 月 14 日,Perplexity 官方在 X(前 Twitter)宣布,旗下的本地 AI Agent 平台 Portable Computer 正式登陸 Windows PC,並深度整合 NVIDIA GeForce RTX 與 NVIDIA RTX PRO GPU。
這項更新標誌著 AI Agent 從過去「雲端黑盒子」與「Linux/DGX 高階伺服器專屬實驗」,正式邁入佔據全球 PC 最大市佔率的 Windows 個人電腦生態。
「Portable Computer 現已可在搭載 NVIDIA RTX GPU 的 Windows PC 上運行。在您的個人電腦本機執行 Harness、Agents 與模型;直接處理本機檔案與已連結應用程式,無須將任務傳送至雲端。僅在需要時呼叫前沿雲端模型。」 —— Perplexity 官方公告
過去一年中,AI Agent(人工智慧代理)被視為大語言模型的最重要演進方向。但對許多專業工作者、企業法遵與工程師而言,雲端 Agent 存在兩大難以克服的硬傷:敏感資料上傳的隱私外洩風險,以及多步驟自動化任務高昂的 Token / 點數消耗。
Perplexity 在 8 月底針對 Linux 與 NVIDIA DGX Spark 推出 Portable Computer、9 月初在 Mac Apple Silicon 推出 Hybrid Compute 後,這次將完整技術棧帶到了 Windows RTX。本文將為你全面拆解 Portable Computer on Windows 的運作架構、硬體門檻、零 Token 經濟學、雲端升級機制、與各版本產品的差異,並提供客觀的實測評估與選購建議。
Perplexity 官方展示 Portable Computer 在 Windows PC 上搭配 NVIDIA RTX GPU 進行本機多步驟任務處理。 影片來源:Perplexity 官方 X。
一、Perplexity Portable Computer on Windows 是什麼?
首先必須釐清一個常見的誤解:Portable Computer 不是一台 Perplexity 品牌的實體硬體電腦,而是一套專為個人硬體打造的「本地優先(Local-First)AI Agent 完整執行環境軟體」。
一般的聊天機器人(如網頁版 ChatGPT 或 Perplexity 搜尋)只是一問一答的介面,背後的所有思考、推理、網路檢索與資料解析全都在遠端雲端機房完成。
而 AI Agent(智慧代理) 則是一種能自主拆解目標、連續呼叫外部工具、自行檢查錯誤並反覆迭代直至完成任務的系統。例如:「整理下載資料夾內所有 8 月份的發票 PDF,依據供應商分類命名,統計未稅金額填入 Excel,並將異常項目彙整成待辦事項」。
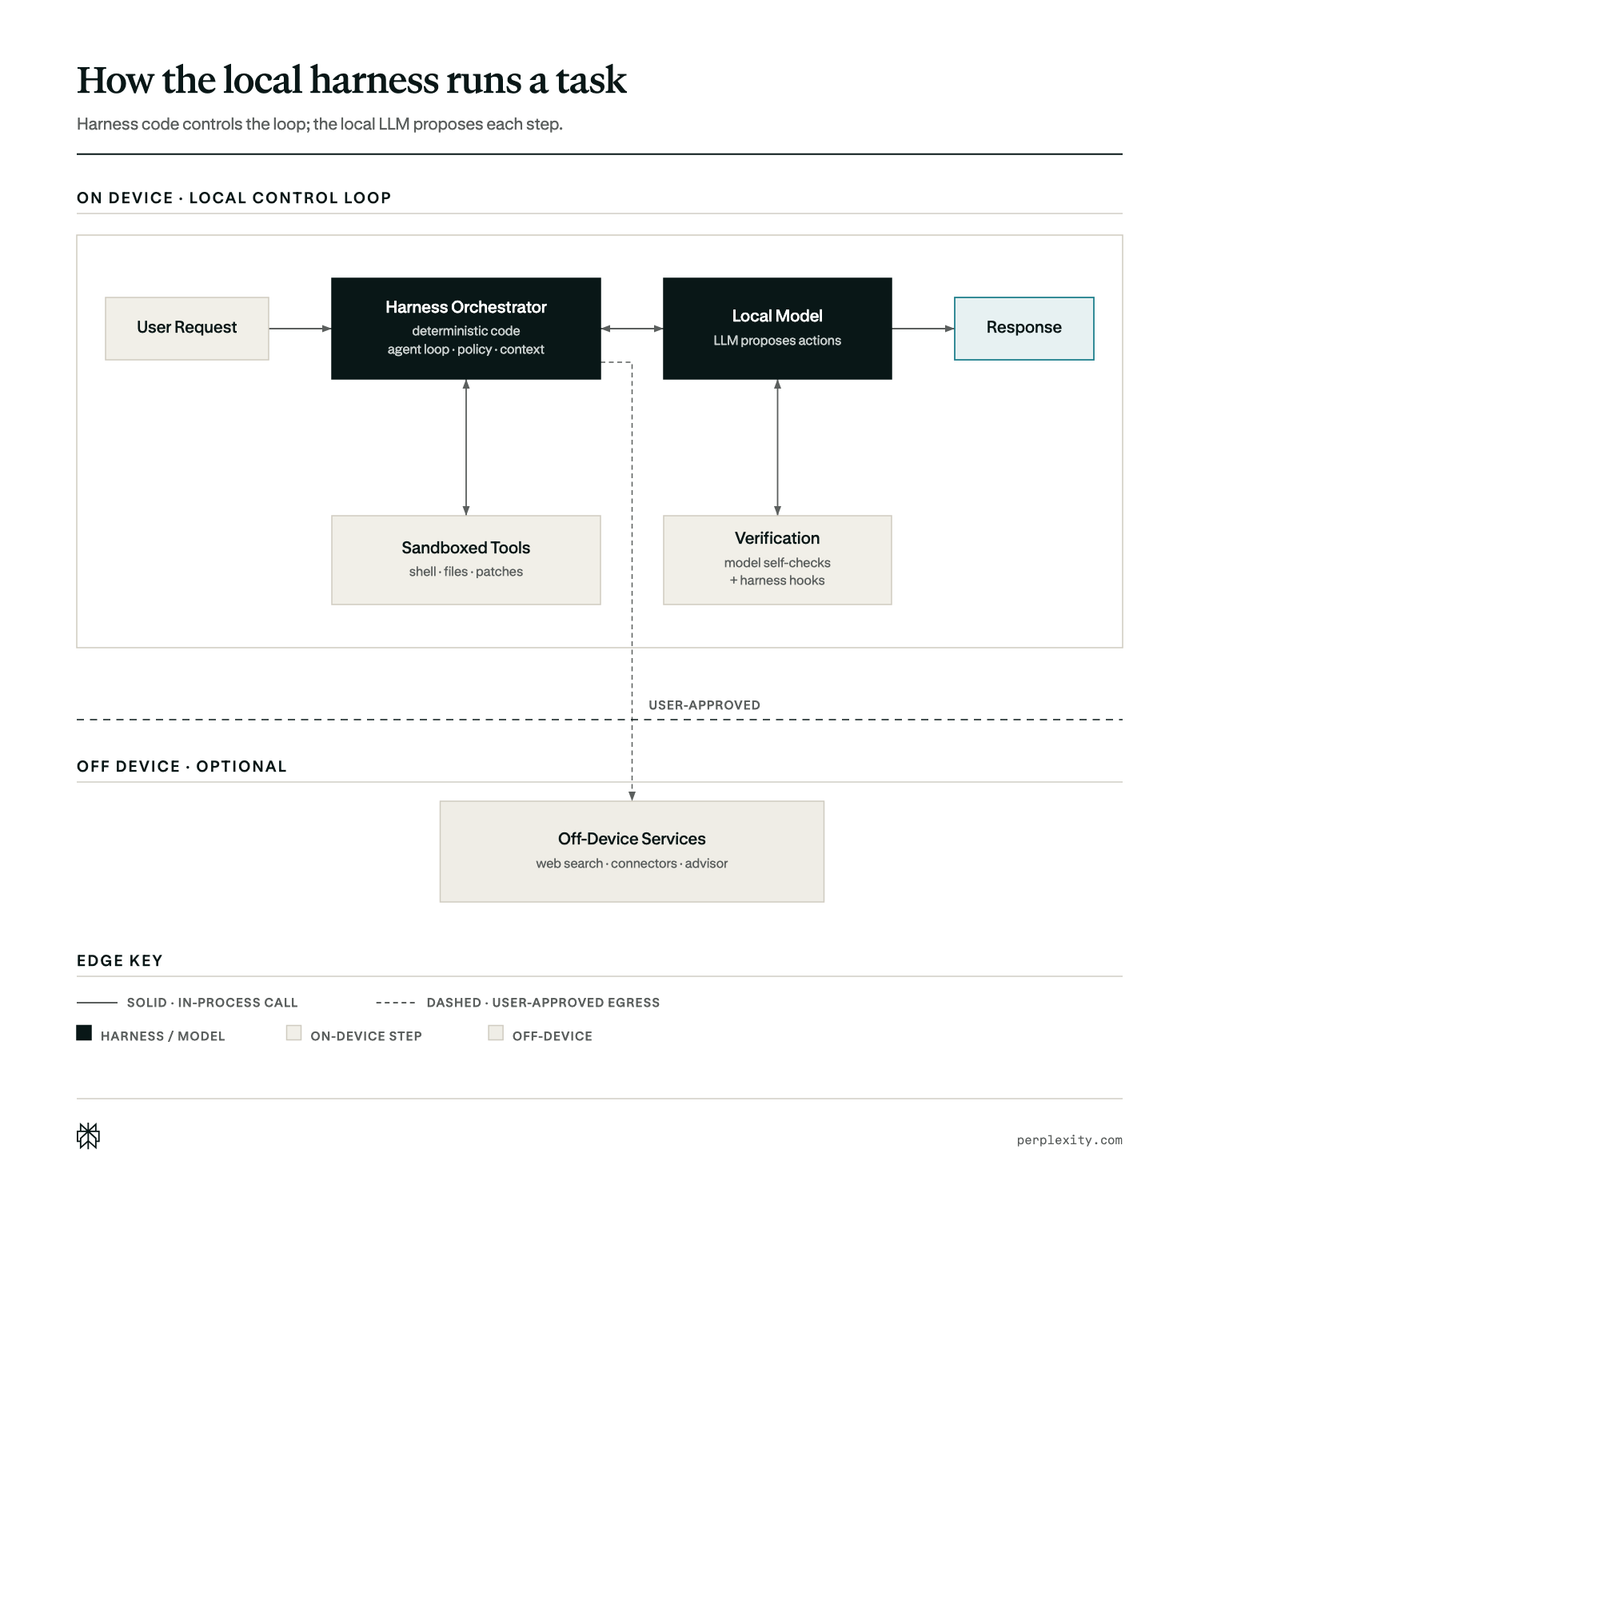
在 Windows 版 Portable Computer 中,Perplexity 把這套原本極其依賴雲端伺服器的複雜鏈路,全部打包搬進了使用者的 Windows 本機:
核心四大元件本機運行
- 本機基底模型(Local Foundation Models): 在你的 NVIDIA RTX GPU 顯存中直接加載並運行 270 億參數(27B)的專用模型。目前首發支援針對 Agent 任務後訓練優化的 PPLX 27B、開源廣受好評的 Qwen 3.8 27B,以及即將整合的 NVIDIA Nemotron 3.5 Lightning。
- Agent 執行框架(Agent Harness): 這是 Agent 的「大腦指揮部」。負責管理 System Prompt、任務分解樹、多步驟狀態機、上下文視窗動態修剪,以及結果的反射驗證(Reflection & Self-Correction)。
- 安全隔離沙盒(Secure Sandbox): 為了避免 Agent 在自動化操作時誤刪系統檔案或執行惡意代碼,Portable Computer 在 Windows 系統中建立了嚴格的隔離沙盒。Agent 只能在使用者明確授權的目錄與有限權限內讀寫檔案、執行 Python 數據分析或操作終端命令。
- 本機連接器與排程引擎(Connectors & Task Scheduler): 原生深度整合 Windows 使用者最常用的生產力工具,包括微軟 OneDrive、Outlook、Word、Excel,以及跨平台的 Google Drive、Gmail、Slack 與 GitHub。更重要的是,它內建了本機背景排程器(Task Scheduler),使用者可以設定定時任務(如每日清晨自動彙整代辦事項),電腦開機便能自主在背景運行。
二、零 Token 費用 vs. 本機運算經濟學:真的完全免費嗎?
Perplexity 在宣傳 Portable Computer 時,最吸引眼球的賣點莫過於「零 Token 費用(Zero Token Costs)」。但這究竟代表什麼?它真的等於完全零成本嗎?
1. 雲端 Agent 的「Token 燃燒焦慮」
使用過雲端 AI Agent 的人都知道,Agent 最耗費點數的地方在於「循環驗證」:
- 一個看似簡單的檔案清理任務,Agent 可能需要讀取 50 份文件。
- 每讀一份文件就塞入一次上下文,進行一次推理。
- 若發生語法錯誤或解析失敗,Agent 還會自我修正重試 3~5 次。
在雲端服務架構下,每一次循環都在計費。稍微複雜一點的長流程任務,動輒消耗數十萬甚至數百萬個 Token,雲端訂閱額度往往在幾次大型自動化任務後就被消耗殆盡。
2. 本機運算的「無限吃到飽」
當所有運算移至本地 NVIDIA RTX 顯示卡後:
- 模型推論 0 點數: 不管本地 27B 模型在後台思考了多少步、重試了幾次、讀取了幾萬字的文件,通通不計入 Perplexity 雲端使用點數。
- 長時間排程自由: 你可以放心讓 Windows 電腦在半夜連續運行 8 小時,批次清洗 1,000 份歷史數據,而不必擔心隔天早上收到天文數字般的雲端帳單。
3. 隱形成本試算:把雲端帳單轉移給硬體與電費
然而,天下沒有真正免費的算力。本地運算只是將「按使用量計費的運算費用(OpEx)」,轉化為「前期的硬體資本支出(CapEx)」與「後續維護電費」:
| 成本項目 | 雲端 Agent 模式 | Portable Computer 本機模式 |
|---|---|---|
| 計費方式 | 按次數、查詢次數或每百萬 Token 計費 | 本地推論零 Token 費用,無限次數運行 |
| 前置硬體門檻 | 無,一般文書筆電甚至手機瀏覽器即可 | 需高階 Windows 電腦與 24GB VRAM RTX 顯卡(硬體成本約 NT$ 50,000~120,000+) |
| 軟體訂閱要求 | 需 Perplexity Pro(每月 $20)或 Max/Enterprise | 仍需 Perplexity Pro / Max / Enterprise 訂閱才能啟用此軟體功能 |
| 能耗與電費 | 零(由雲端機房承擔) | RTX 3090/4090 滿載功耗約 350W~450W,長時間連續運算需考量散熱與電費 |
| 投資回收點(ROI) | 輕度與偶爾使用者最省錢 | 每天需執行大量自動化、數據清洗與私有文件分析的專業團隊,數個月即可攤平顯卡成本 |
本站觀點: 如果你只是偶爾需要 AI 幫忙寫寫 Email、查查旅遊攻略,雲端版絕對最划算。但如果你是自媒體、量化研究員、軟體工程師或中小企業,每天都有大量的日常數據整理、日誌分析與私有文件排程需求,Portable Computer 的經濟優勢將非常驚人。
三、隱私架構與「按需雲端升級」(Opt-in Cloud Escalation)
企業與專業人士過去不敢將整個工作流程託管給雲端 AI,最大的痛點就是「機密外洩」:
- 律師不敢把訴訟未公開案卷上傳。
- 投資人不敢把未公開財測與個人投資組合丟進對話框。
- 軟體工程師嚴禁將公司核心 Proprietary 代碼庫傳給第三方伺服器。
Portable Computer 採用的核心哲學並不是「徹底與世界斷絕聯繫」,而是**「本地優先、安全隔離、選擇性連外」**。
1. 敏感情境 100% 留在本機
當你指令 Agent:「檢查我 OneDrive 裡的合約草稿,找出所有違約條款與爭議罰則,列成表格存回本地 Word 文件。」 這整個過程,從載入檔案、文字剖析、條款審查到生成文件,全部都在你的 RTX 顯卡顯存與本機記憶體中完成,沒有任何一個字元會上傳到 Perplexity 伺服器。
2. 什麼是「按需雲端升級」(Opt-in Cloud Escalation)?
本地 27B 參數的模型雖然反應迅速、成本為零,但面對極高難度的跨領域推理(如複雜演算法除錯、深奧法律哲學論述),或是需要最新即時全網資訊時,27B 模型難免會遇到能力天花板。
此時,Portable Computer 不會偷偷把資料送出,而是主動向使用者發出確認:
「此步驟需要更進階的推理能力(或即時搜尋),是否允許調用雲端前沿模型(如 Claude 3.5 Sonnet / Opus 或 GPT-4o)協助?」
只有當使用者點擊「允許」後,該子任務才會向雲端求助。
3. 隱私閘門(Privacy Gate)與 PII 自動遮罩
即使使用者同意調用雲端,Perplexity 也導入了源自 Mac 版的 Privacy Gate 機制:
- 本機 PII 分類器: 內建約 6 億參數的開源專用模型
pplx-pii-masking。 - 自動敏感資訊脫敏: 在文字離開電腦前,自動辨識姓名、電子信箱、電話號碼、身分證字號、公司代號、加密金鑰等資訊,並將其替換為代稱(例如將「張小明,帳號 012-345-678」替換為
[PRIVATE_PERSON]、[PRIVATE_ACCOUNT])。 - 雲端僅提供邏輯思考: 雲端前沿模型只會看到抽象後的關係結構並給出解答。
- 本地動態還原: 解答傳回 Windows 本機後,再由本地系統將代稱還原為真實姓名與數據。
這套設計在「前沿智力」與「極致隱私」之間取得了一套令人信服的工程平衡點。
四、24GB 顯存的殘酷硬門檻:哪些電腦能跑?哪些被淘汰?
雖然 Portable Computer 登陸 Windows 是一大突破,但 Perplexity 設下了一個非常嚴格的硬體門檻:
硬體最低需求: 搭載至少 24GB VRAM(顯示記憶體) 的 NVIDIA GeForce RTX 或 NVIDIA RTX PRO 工作站顯示卡,作業系統需為 64 位元 Windows 11。
這道「24GB 顯存硬門檻」如同分水嶺,直接將消費市場中的硬體劃分為兩大陣營:
1. 取得入場門票的硬體設備
- 消費級桌上型顯示卡:
- NVIDIA GeForce RTX 3090 (24GB)
- NVIDIA GeForce RTX 3090 Ti (24GB)
- NVIDIA GeForce RTX 4090 (24GB)
- 次世代 GeForce RTX 5090 (32GB)
- 專業工作站 / 企業級顯卡:
- NVIDIA RTX A5000 (24GB)
- NVIDIA RTX A6000 / A6000 Ada (48GB)
- NVIDIA RTX 4500 Ada Generation (24GB)
- NVIDIA RTX 5000 Ada Generation (32GB)
- NVIDIA RTX 6000 Ada Generation (48GB)
2. 被擋在門外的硬體(無緣本機運行)
- 主流中高階遊戲顯卡:
- RTX 4080 / 4080 Super (16GB) ❌
- RTX 4070 Ti Super (16GB) ❌
- RTX 4070 / 4070 Ti (12GB) ❌
- RTX 4060 / 4060 Ti 系列 (8GB / 16GB) ❌(註:即使 16GB 版本的 4060 Ti 也未達 24GB 標線)
- 幾乎所有常規筆記型電腦:
- 即便是目前市面上最頂級的旗艦電競筆電,其行動版 RTX 4090 Laptop GPU 的顯存上限也只有 16GB。這意味著絕大多數 Windows 筆電使用者均無法在機身本機運行,除非透過 Thunderbolt / OCuLink 外接桌上型 24GB eGPU 顯卡盒。
- 非 NVIDIA 陣營硬體:
- AMD Radeon 顯卡(如 RX 7900 XTX 24GB):目前不支援。Perplexity 本機引擎深度綁定 NVIDIA TensorRT-LLM 與 CUDA 運算棧。
- Intel Arc 獨立顯卡:不支援。
為什麼非得 24GB 顯存不可?技術架構揭密
許多硬體玩家可能會問:「開源社群很多 4-bit 量化的 7B、14B 模型在 8GB 或 12GB 顯存就能跑,為什麼 Perplexity 堅持要 24GB?」
答案在於 「AI 聊天」與「AI Agent」對資源要求的本質差異:
- 模型權重基礎消耗: 一個具備紮實邏輯推理能力的 27B 參數模型,即便經過適度量化(如 4-bit / 8-bit 混合精度),模型權重本身就需要佔用約 14 GB ~ 16 GB 顯存。
- 超長上下文與 KV Cache: Agent 任務必須一次吞入龐大的文件、程式碼與工具回傳訊息(通常需要 32k 甚至更長的 Context Window)。長文本生成的 KV Cache 顯存開銷在滿載時高達 4 GB ~ 6 GB。
- 並發工具、沙盒與向量檢索: 為了在本地快速比對文件,系統需保留顯存給本地向量嵌入模型(Embedding)、沙盒緩存與 Harness 狀態維護。
- 避免顯存交換崩潰: 只要顯存不足,Windows 就會強制將資料溢出交換至系統主記憶體(System RAM via PCIe)。一旦發生交換,模型生成速度會從每秒 25-35 tokens 瞬間暴跌至每秒 1-2 tokens,整個 Agent 決策流程會陷入癱瘓與超時錯誤。
因此,Perplexity 寧可將 24GB 設為不可逾越的「硬門檻」,也不願讓使用者在顯存不足的環境下獲得糟糕的破碎體驗。
五、全方位橫向評比:Perplexity 五大版本與開源方案對照
隨著 Windows 版加入,Perplexity 的產品家族變得愈發龐大,使用者極易混淆。下表為你完整梳理不同產品形態的定位差異:
| 評比維度 | 雲端 Computer | 個人電腦版 (Personal Computer) | Mac 版 Hybrid Compute | Windows 版 Portable Computer | 開源自建 (Ollama + CrewAI) |
|---|---|---|---|---|---|
| 運作平台 | 任何裝置(Web / App) | Windows / macOS | macOS 15+ (Apple Silicon) | Windows 11 (64-bit) | Linux / Windows / Mac |
| 模型運行位置 | 100% Perplexity 雲端 | 雲端模型協調 | 雲端與 Mac 本地混合切換 | 100% 本地優先 (RTX 顯卡) | 100% 本地 (自選顯卡/CPU) |
| 硬體最低門檻 | 無任何要求 | 一般辦公電腦即可 | 統一記憶體 24GB 以上 (建議 32GB) | NVIDIA RTX 24GB VRAM 以上 | 視自選模型大小而定 (8GB~24GB) |
| 本地 Token 費用 | 依雲端點數扣款 | 依雲端點數扣款 | 本地部分 0 點數,雲端另計 | 本地完全 0 點數 / 無限次數 | 完全免費開源 |
| 隱私保護水準 | 資料傳至雲端伺服器 | 檔案透過雲端模型讀取分析 | 本機處理敏感檔案 + Privacy Gate | 檔案留在本機沙盒 + 選擇性雲端升級 | 100% 本機離線 |
| 背景自動化排程 | 依賴雲端伺服器排程 | 需保持連線與開機 | 支援背景排程 | 原生內建 Task Scheduler 本地排程 | 需自行撰寫 Cron / 腳本 |
| 部署上手難度 | ⭐(零門檻即開即用) | ⭐(安裝桌面 App 即用) | ⭐⭐(App 內一鍵下載本地模型) | ⭐⭐(App 內一鍵配置環境與驅動) | ⭐⭐⭐⭐⭐(需手動除錯 CUDA、環境與工具) |
| 適合族群 | 一般大眾、輕度查詢 | 想讓 AI 幫忙點擊操作電腦的人 | 使用 M 系列高階 Mac 的專業工作者 | 擁有 24GB RTX 顯卡的工程師與專業人士 | 追求極限客製化的開源極客 |
與開源自建(Ollama / vLLM)的關鍵差異
很多技術背景的讀者會問:「我自己用 Ollama 下載 Qwen 3.8 27B,再外掛 Open WebUI 或 LangChain 不也一樣嗎?」
關鍵差異在於**「模型推論」不等於「可交付成果的產品級 Agent」**:
- 開源自建: 你必須自己處理 CUDA 版本衝突、自己寫 Python 腳本串接各家 API、自己設計 Prompt Harness 避免模型陷入死循環、自己想辦法掛載安全沙盒防止腳本刪除硬碟、自己維護 Outlook / OneDrive 的 OAuth 授權。
- Portable Computer: Perplexity 將「模型微調、Harness 流程控制、錯誤自我修復、Windows 權限沙盒、原生辦公軟體連接器、定時排程引擎」全部封裝成開箱即用的圖形介面,替專業用戶省下數十小時的環境搭建與維護成本。
六、實測效能與任務邊界:27B 模型極限在哪?
在實際生產環境中,Windows 本機跑的 27B 模型到底能不能勝任日常工作?
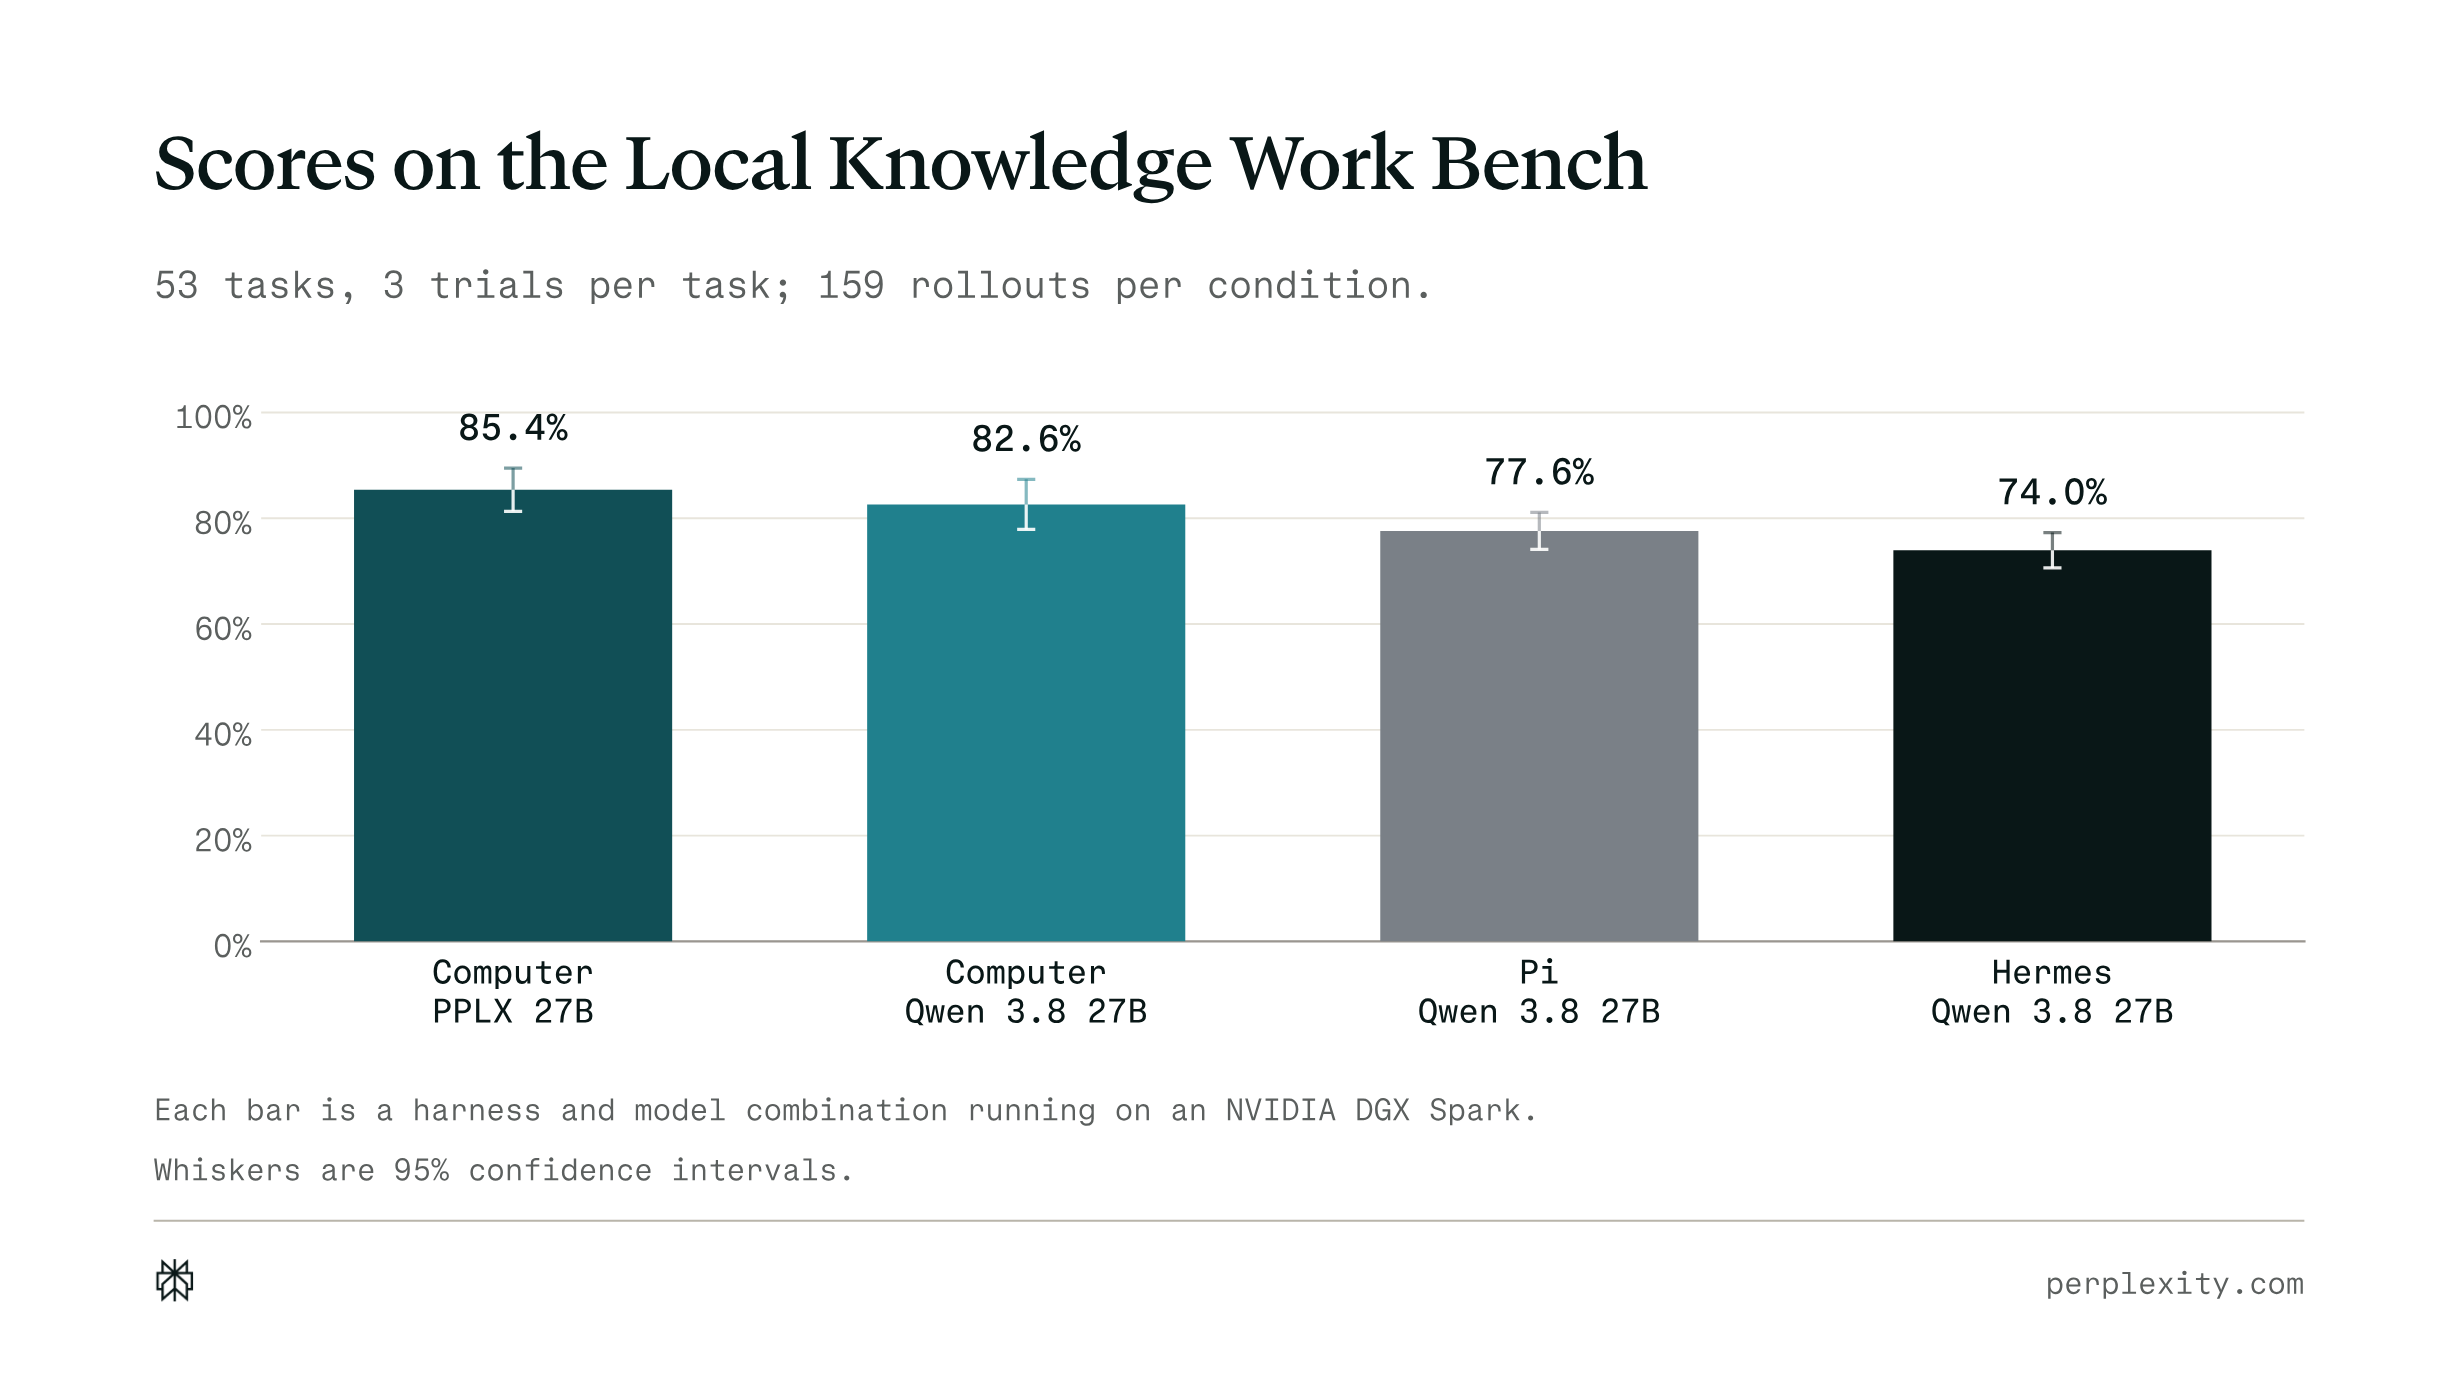
根據 Perplexity 官方針對 53 項日常專業知識工作(包含深度產業研究、財務損益表分析、法律合約審閱、工程規格撰寫與法遵審計)的內部基準評測:
【53項日常知識工作任務 成功率基準評測】
Perplexity PPLX 27B (本地專屬優化) : 85.4% ▇▇▇▇▇▇▇▇▇▇▇▇▇▇▇█
Qwen 3.8 27B (通用開源模型)          : 82.6% ▇▇▇▇▇▇▇▇▇▇▇▇▇█
Pi Harness                         : 77.6% ▇▇▇▇▇▇▇▇▇▇▇█
Hermes Agent                       : 74.0% ▇▇▇▇▇▇▇▇▇▇█
1. 本地模型表現卓越的領域(推薦放手給本地跑)
- 大批量本地文件清洗與摘要: 整理整年份的會議記錄、發票清單、客戶諮詢記錄。
- 固定範本的報表生成: 讀取 Excel 數字並轉換為標準格式的 Markdown 或 Word 報告。
- 例行性背景自動化: 定時監控指定資料夾,當有新圖檔或 CSV 匯入時自動進行標註與格式轉檔。
- 特定領域法規條款對照: 本地快速檢索數百頁 PDF 手冊並比對規格落差。
2. 本地模型的明顯短板(建議啟用雲端升級)
然而,在軟體工程與高難度程式開發測試中,差距便顯現出來:
- 純本地 27B 模型編程評測: 成功率僅約 59.6%。
- 調用 Claude Opus 5 雲端顧問協同: 成功率拉升至 73.0%。
- 純前沿雲端頂級模型(Claude Opus 5): 成功率為 82.4%。
這說明了一個客觀事實:270 億參數的模型雖然經過優化,但在面對超長鏈路架構設計、複雜系統除錯與抽象數學推理時,仍然無法取代數千億甚至兆級參數的前沿雲端模型。
因此,最聰明的用法不是堅持 100% 純本機閉門造車,而是**「日常雜務交給本地 RTX 跑免費,高難度核心邏輯按需授權給雲端大腦」**。
七、Windows 使用者快速上手與安全設定指南
如果你的 Windows 電腦已配備 RTX 3090、4090 或 RTX 專業卡,可以參考以下步驟快速啟用:
步驟 1:基礎環境與驅動檢查
- 確認作業系統已更新至 Windows 11 (64-bit)。
- 開啟 NVIDIA GeForce Experience 或至 NVIDIA 官網,將顯示卡驅動程式更新至最新版本的 Game Ready 或 Studio Driver。
- 開啟工作管理員,切換至「效能 -> GPU」,確認專用 GPU 記憶體(Dedicated GPU Memory)顯示為 24.0 GB 或以上。
步驟 2:下載安裝與權限綁定
- 下載最新版 Perplexity for Windows 桌面客戶端。
- 登入已開通的 Perplexity Pro、Max 或 Enterprise 訂閱帳號。
- 進入設定頁面,切換至「Compute Mode(運算模式)」,勾選開啟 Portable Computer (Local Engine)。
步驟 3:本機模型自動化配置
- 系統會自動檢測你的 RTX 顯卡架構,並開始下載針對 TensorRT 優化的本地模型權重(初次下載約需佔用 15GB~20GB 硬碟空間,建議安裝在高速 NVMe PCIe 4.0/5.0 SSD 上以確保最快載入速度)。
- 下載完成後點擊「Start Local Runtime」,狀態顯示為綠燈「Local Ready」即可。
步驟 4:關鍵安全實踐(重要!)
- 劃定專用工作資料夾: 切勿為了圖省事直接將整顆
C:\磁碟機或C:\Users\Username根目錄全部授權給 Agent。強烈建議在電腦中建立專門的資料夾(如D:\AI_Workspace),僅將需要處理的文件放入該目錄。 - 謹慎開啟 App 連接器權限: 串接 Outlook 或 OneDrive 時,確認組織內部是否有資料合規政策限制,建議先使用測試用子信箱或專案資料夾進行初期演練。
- 設定 Cloud Escalation 提醒層級: 在隱私設定中,確保將雲端升級選項設為「Always Ask for Confirmation(每次詢問)」,避免系統在未經你同意的情況下將任何去識別化資料發送至雲端。
八、本站客觀評價:誰該立刻使用?誰該繼續觀望?
綜合技術成熟度、硬體門檻與實用價值,編輯團隊對 Windows 版 Portable Computer 給出**「中性偏多、特定族群強烈推薦」**的評價:
🎯 強烈推薦立即採用的族群
- 已擁有 RTX 3090 / 4090 的電腦玩家與創作者: 你不需要額外花一毛硬體升級費用,就能立即將手上的遊戲旗艦卡轉化為 24 小時不間斷運作的私有 AI 秘書,省下大量雲端點數。
- 高機密行業專業人員(律師、會計師、金融分析師、醫療研究員): 工作經常需要審閱客戶私人隱私、病歷、報稅單據或未公開財報,以往受限於公司資安政策完全無法使用雲端 AI,現在終於能獲得現代化的本地 Agent 輔助。
- 自動化重度成癮者與一人公司(Solopreneur): 需要利用 Task Scheduler 建立大量夜間背景排程任務,每天處理海量網頁爬蟲資料清洗、文檔歸檔與格式整理的人。
🛑 建議繼續觀望或使用雲端版的族群
- 一般輕薄筆電與日常辦公族: 如果你的電腦是內建顯示晶片、或顯存只有 8GB/12GB/16GB,千萬不要盲目為了這個功能衝動花費數萬元組裝新桌機。繼續使用網頁版 Perplexity Pro 或桌面版 Personal Computer,性價比高得多。
- 主要需求為一般閒聊、單純搜尋與寫短文者: 雲端前沿模型(Claude 3.5、GPT-4o)在文字潤飾與通用問答上的表現依然優於本地 27B 模型,且雲端免去了高顯卡功耗與散熱噪音。
- 只使用 Mac 的 Apple 生態圈用戶: Mac 用戶請直接使用已在 9 月初發表的 Perplexity Hybrid Compute,只要你的 Apple Silicon Mac 配備 24GB/32GB 統一記憶體,就能享受類似的本機隱私保護,無須為了 NVIDIA 轉投 Windows。
九、常見問題 FAQ
Q1:Portable Computer 是一台實體的 AI 筆記型電腦或主機嗎?
不是。 Portable Computer 是一套軟體執行框架。它運行在使用者自備的 Windows 或 Linux 硬體上,之所以命名為「Portable(便攜/可移植)」,是指 Perplexity 的 Agent 技術能夠被「移植」到使用者自己的設備上本地運行。
Q2:既然是在我自己的電腦、吃我自家的電跑模型,為什麼還要付 Perplexity 訂閱費?
雖然推論算力來自你的顯示卡,但這套軟體依賴 Perplexity 長期投入研發的 Agent Harness 執行架構、持續維護的 Windows 應用程式連接器、專屬後訓練的模型權重微調,以及隨時待命的 Privacy Gate 雲端後援系統。因此 Perplexity 目前將其定位為 Pro、Max 與 Enterprise 企業級會員的加值功能。
Q3:我的電競筆電規格是頂規的「RTX 4090 筆電版」,可以使用嗎?
很遺憾,目前不行。 雖然名稱都叫 RTX 4090,但筆記型電腦版本的行動版 RTX 4090 Laptop GPU 物理顯存上限僅為 16GB,並未達到官方規定的 24GB VRAM 硬門檻。除非你透過外接顯卡塢(eGPU)連接桌上型 24GB 顯卡,否則目前無法在筆電本機運行。
Q4:在完全斷網(無網際網路連線)的情況下,它還能運作嗎?
可以執行純本地任務。 只要是處理本地磁碟內的檔案、使用本機模型推理與執行沙盒 Python 代碼,完全不需要網路。但如果你需要全網即時搜尋、使用 Google Drive/Slack 等雲端連接器,或觸發 Cloud Escalation 雲端升級,則必須保持網路連線。
Q5:雲端升級(Cloud Escalation)會不會不小心把我的公司機密外洩?
系統預設為「每次升級必須經過人工授權」。即便你授權同意,資料在傳送出去前還會經過本機的 PII 分類器進行自動遮罩(將敏感個資與帳號替換為代號),最大程度降低個資與企業商業機密外洩的風險。
Q6:它和直接在 Windows 上使用 Ollama 有什麼實質差別?
Ollama 是純粹的「模型加載器」,只負責讓模型能在本地輸出文字;而 Portable Computer 是一個完整的「Agent 自動化操作系統」,內建了規劃器、自我糾錯機制、Windows 安全沙盒、辦公軟體連接器與自動排程器。前者是零件,後者是組裝完成、隨開即用的成車。
十、結語:本地端算力覺醒,AI 代理走向「主權在己」的新常態
Perplexity Portable Computer 登陸 Windows,是個人運算發展史上的重要分水嶺。
過去三年,生成式 AI 的主戰場始終被巨型雲端數據中心壟斷,使用者只能扮演終端消費者的角色,忍受隨時可能被調整的服務條款、隱私外洩的擔憂,以及計量收費的 Token 壓力。
如今,隨著桌面 GPU 算力暴增與模型蒸餾技術成熟,Perplexity 證明了:只要有一張 24GB 顯存的消費級顯卡,使用者就能在自家桌機上擁有一個專屬、私密、無限次數運行且能自主排程的 AI 智慧代理。
儘管 24GB 的顯存門檻依然陡峭,但隨著硬體迭代與更多輕量高智商模型的問世,這種「本地保衛隱私與例行任務、雲端支援尖端推理」的混合運算架構,無疑正是每位知識工作者未來數位生產力的標準範式。