SubQ Snap 是什麼?384K 長上下文決策模型,價格、速度與限制一次看懂
SubQ Snap 主打 384K 長上下文、文字與圖片判斷,每百萬輸入 token 僅 0.05 美元。本文解析決策模型如何替 AI 代理分流、官方速度與基準的測試條件、圖片接口限制及資料保留政策,幫你評估是否值得試用。
AI 助手做一項工作,往往要先判斷資料送給誰、下一步用哪個工具,以及目前的結果是否足夠。這些小決定會反覆出現,也會累積等待時間與費用。
Subquadratic 在 2026 年 10 月 12 日推出 SubQ Snap,專門處理這類有明確選項的判斷。它目前開放公開預覽,定位是企業 AI 工作流程中的決策模型。
發布重點包括最高 384K 上下文,也就是一次可處理約 38.4 萬個 token。Token 是模型切分文字與計算容量的單位,不能直接當成相同數量的中文字。
另一個亮點是價格:每百萬輸入 token 收費 0.05 美元,輸出免費。官方也宣稱,處理十萬 token 並回傳決策可以在一秒內完成。
這些數字很吸引人,但要分清楚容量、單次模型速度,以及整個工作的完成時間。官方基準也有改寫題型與不同輸入方式,不能只拿總分判斷誰全面勝出。
價格、接口與優惠資訊核對至 2026 年 10 月 13 日。要理解它能省下哪些工作,先從模型回傳答案的方式看起。
SubQ Snap 如何工作?先給資料,也先定義答案
從寫一段回覆,變成替選項評分
一般大型語言模型擅長依照指令生成文章、程式或說明。SubQ Snap 的用途比較集中:讀取背景資料,根據問題,替事先定義的答案計算機率。
例如客服收到一段對話,你可以先設定「帳務」「技術支援」「其他」三個去向,再問這則訊息應交給哪一組。模型回傳的結果,能直接交由程式處理。
這裡的差別是,應用程式先決定哪些答案合法,再讓模型選擇。選項設計得好,後續流程便容易接手,也不用從一大段文字裡重新找出分類結果。
但答案範圍有限,也代表選項必須涵蓋實際情況。若所有去向都不適用,卻沒有「資訊不足」或「其他」,系統仍可能把案件塞進不合適的分類。
官方的 Decisions API 是供程式呼叫的決策接口,提供是否成立、多選一與等級評分三類判斷,並回傳機率資訊。
機率高,仍需要用自己的資料驗證。團隊應比較模型的分數與人工確認的結果,再決定哪些案件可自動處理,哪些要補資料或交給人看。
AI 代理反覆要做的四種決定
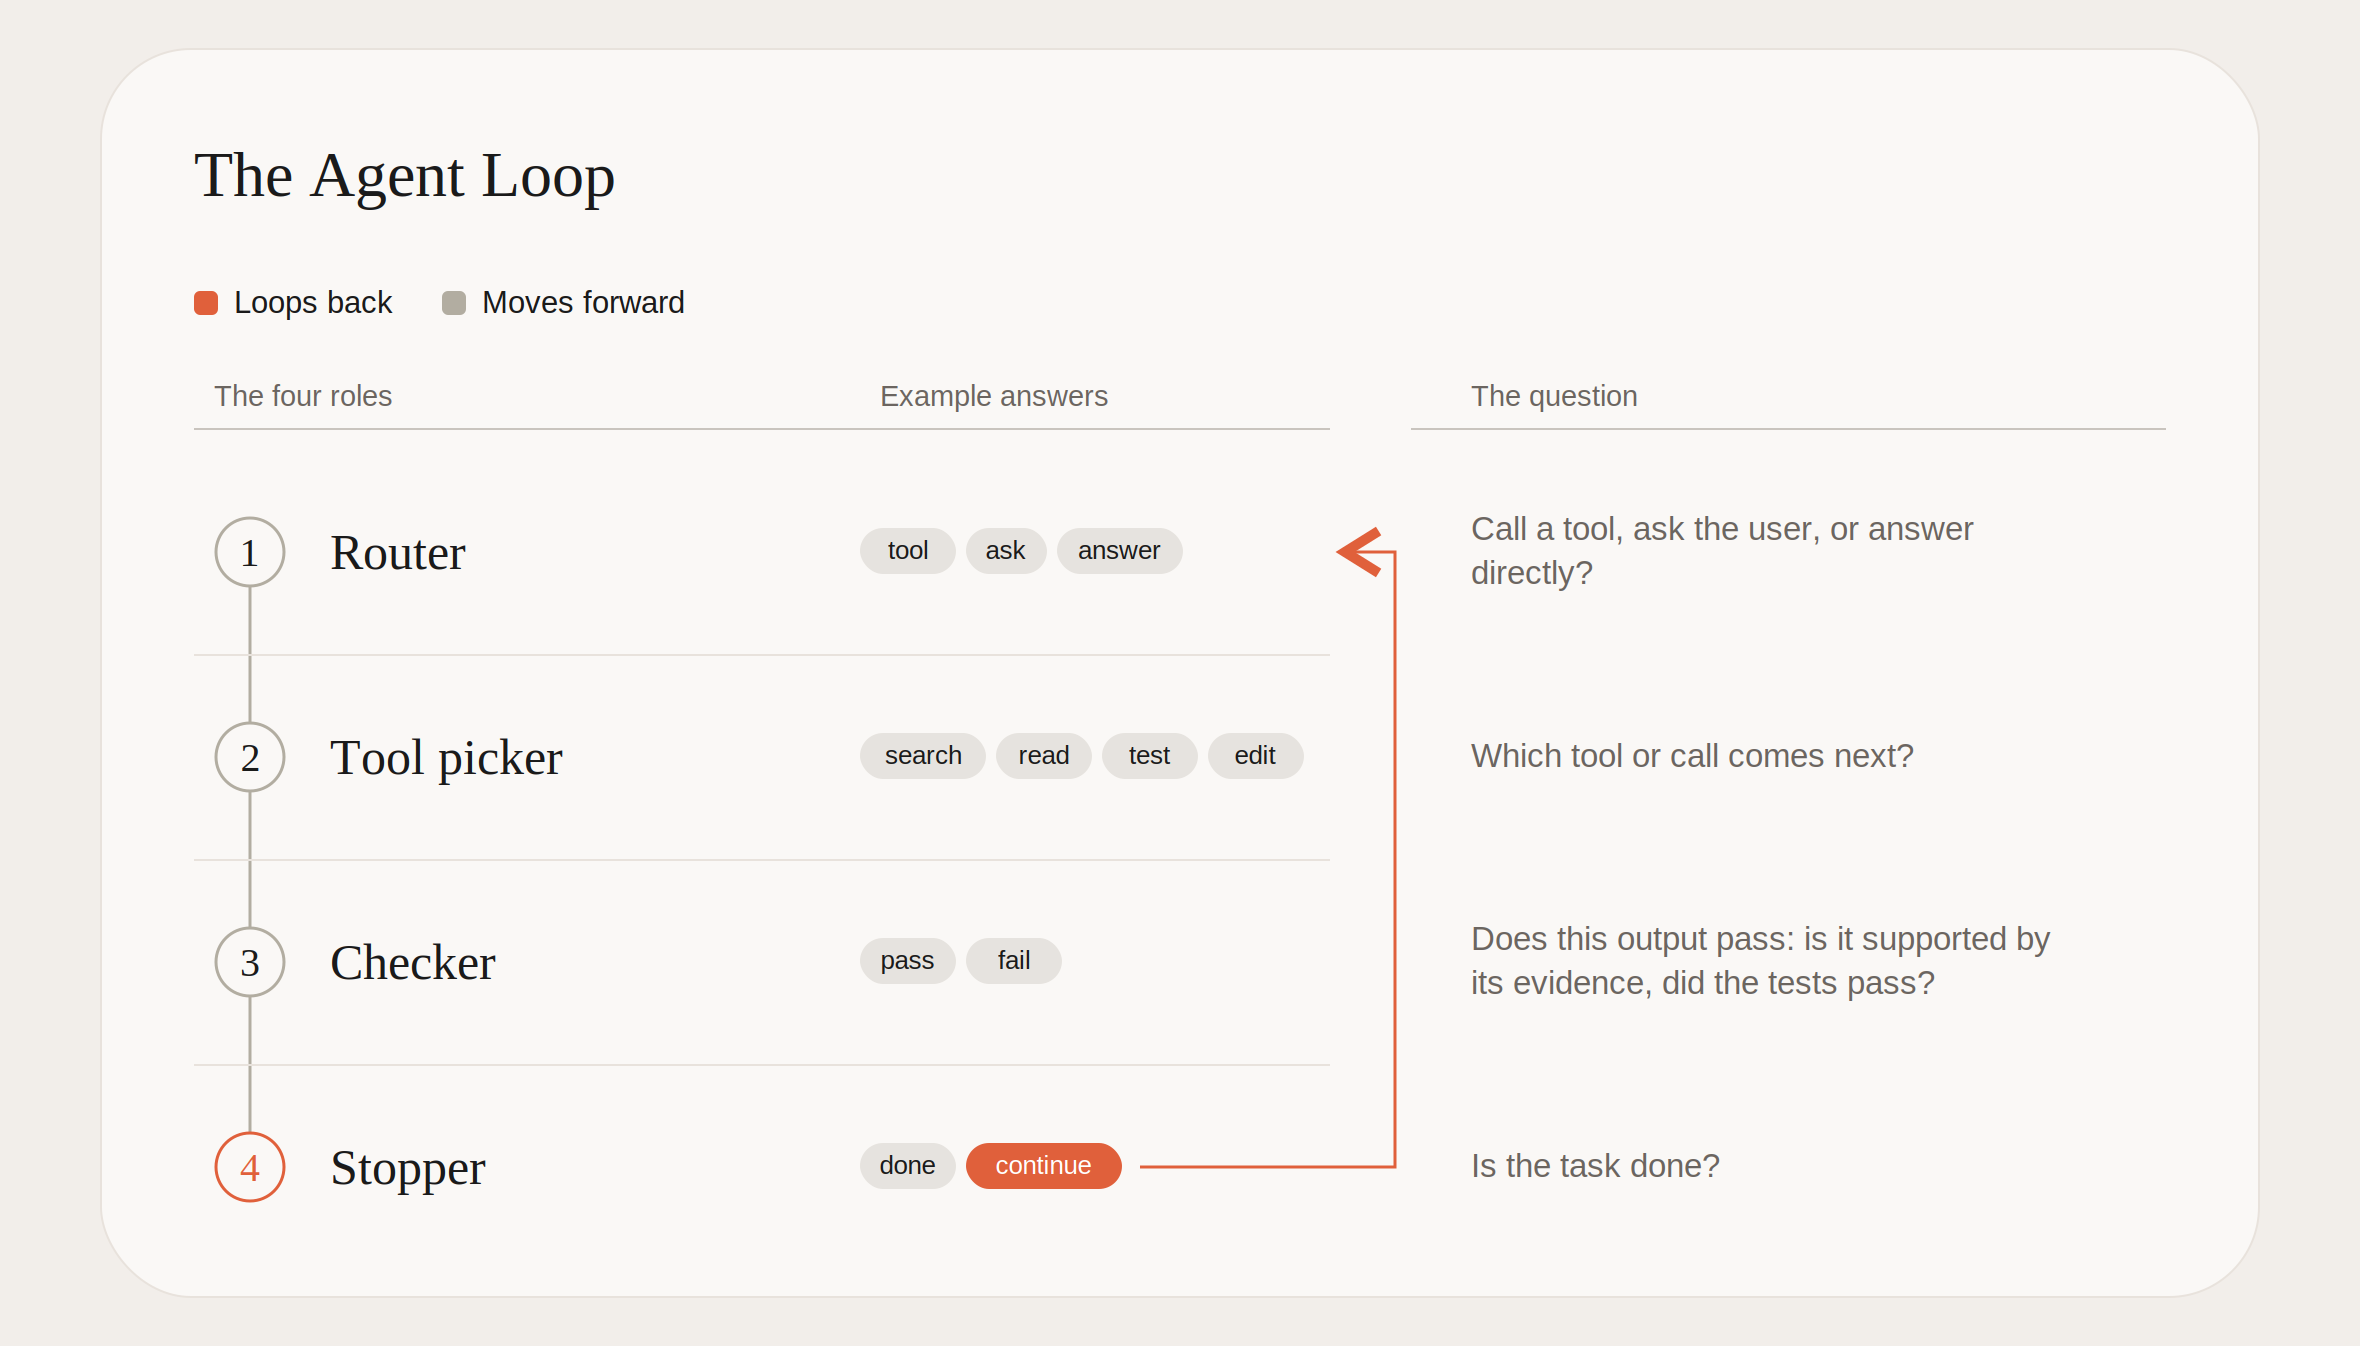
AI 代理是能串接工具、分步執行工作的系統。SubQ Snap 的官方設計,主要對準分流、工具選擇、結果檢查與停止判斷這四個位置。
| 決策位置 | 可以問什麼 | 應用程式接著做什麼 |
|---|---|---|
| 分流 | 直接回答、詢問使用者,還是呼叫工具? | 切換處理路徑 |
| 工具選擇 | 下一步搜尋、讀檔,還是跑測試? | 呼叫被選中的工具 |
| 檢查 | 目前輸出是否符合提供的證據與條件? | 接受結果或要求重做 |
| 停止 | 任務已完成,還是需要繼續? | 結束或再執行下一輪 |
這些是產品希望支援的角色,實際成效仍取決於你的問題、選項與背景資料。模型選出「跑測試」,測試本身仍由原有工具負責執行。
如果還不熟悉這種分工,可以先看決策層如何替 AI 代理分流與選工具。先找出一個反覆出現的判斷點,比直接換掉整套系統更容易量測效果。
384K 的意義:答案很短,判斷依據卻可能很長
三個選項,也可能要讀完整份背景
決策只回傳一個分類,不代表前面的資料一定很少。客服的問題可能牽涉早先對話,程式工具選擇可能取決於另一個檔案裡的設定。
如果先把內容摘要、截短或分塊,必須另外決定哪些資訊留下。這些方法能節省輸入,卻也可能漏掉會改變答案的條件。
SubQ Snap 支援把文字與圖片放進同一份背景,最高容量為 384K token。對需要跨多處資料判斷的工作,一次保留較完整的內容,是值得測試的能力。
「放得下」與「判得對」需要分開確認。長度只是入口限制,資料彼此矛盾、關鍵條件埋得很深,或問題定義模糊,都會影響最後結果。
SSA 改善讀取成本,總時間仍會隨長度增加
Subquadratic 將長輸入效率歸因於 SSA,也就是「次二次稀疏注意力」。注意力是模型連結不同資訊的方法,稀疏則表示挑選部分關係來計算。
官方說明,這種設計讓注意力計算成本隨輸入長度呈線性成長。讀入兩倍資料時,目標是避免注意力部分變成約四倍工作量,詳見SSA 技術說明。
這也解釋了創辦人所說的「每個 token 計算成本維持固定」。每個單位的成本穩定,總輸入增加時,總計算量與等待時間依然可能增加。
對使用者而言,應該問的是「在我的資料長度下,要等多久、答對多少、花多少錢」。架構名稱可以解釋設計方向,實際導入仍要看這三件事。
一秒內處理十萬 token,應該怎麼看?
官方發布速度是參考值,尚有預覽期波動
創辦人 Alexander Whedon 公開的發布期數字,包含 32K 約 250 毫秒、100K 約 660 毫秒,以及 384K 約 2.5 秒,並提醒平台調整期間會有延遲變動。
這組數字顯示,輸入拉長仍會增加等待時間。它支持「十萬 token 單次判斷很快」的宣傳,不能直接推成「任意長度都一秒完成」,詳見創辦人發布說明。
公開貼文沒有提供足以重現所有條件的完整速度測試設定。因此,上述數字適合作為試用時的比較起點,不適合當成每次呼叫都會達成的服務承諾。
而且一項工作通常還要讀檔、搜尋、等待工具,以及生成最後回覆。某個決策加速後,整體能省多少時間,取決於原本卡在哪一步。
用完整工作來量測,才知道是否值得換
以客服分流為例,可以分別記錄資料準備、模型回傳與案件入列所需時間。這樣才能辨識改善來自模型,還是其他流程剛好變快。
除了平均速度,也要看最慢的一批案件。若大多數很快,少數卻長時間等待,使用者仍會遇到不穩定的體驗,程式也需要超時處理。
測試時最好保留相同資料、選項與判斷規則,分別交給現有方法與新模型。若換模型時也改了題目,結果就很難說明是哪個改動帶來差異。
官方測試領先 Jev,哪些結果最有參考價值?
決策總分與原始答對率,要分開看
Subquadratic 公布,SubQ Snap 在 Decision Index v0.2.1 得到 61.7,Jev 為 57.9。這是公司公布的評測結果,本文沒有自行重跑整套基準。
官方說明,該指數將隨機猜測標成 0、完全正確標成 100,並整合多個領域的加權成績。因此 61.7 不能直接讀成所有問題答對 61.7%,詳見官方發布文章。
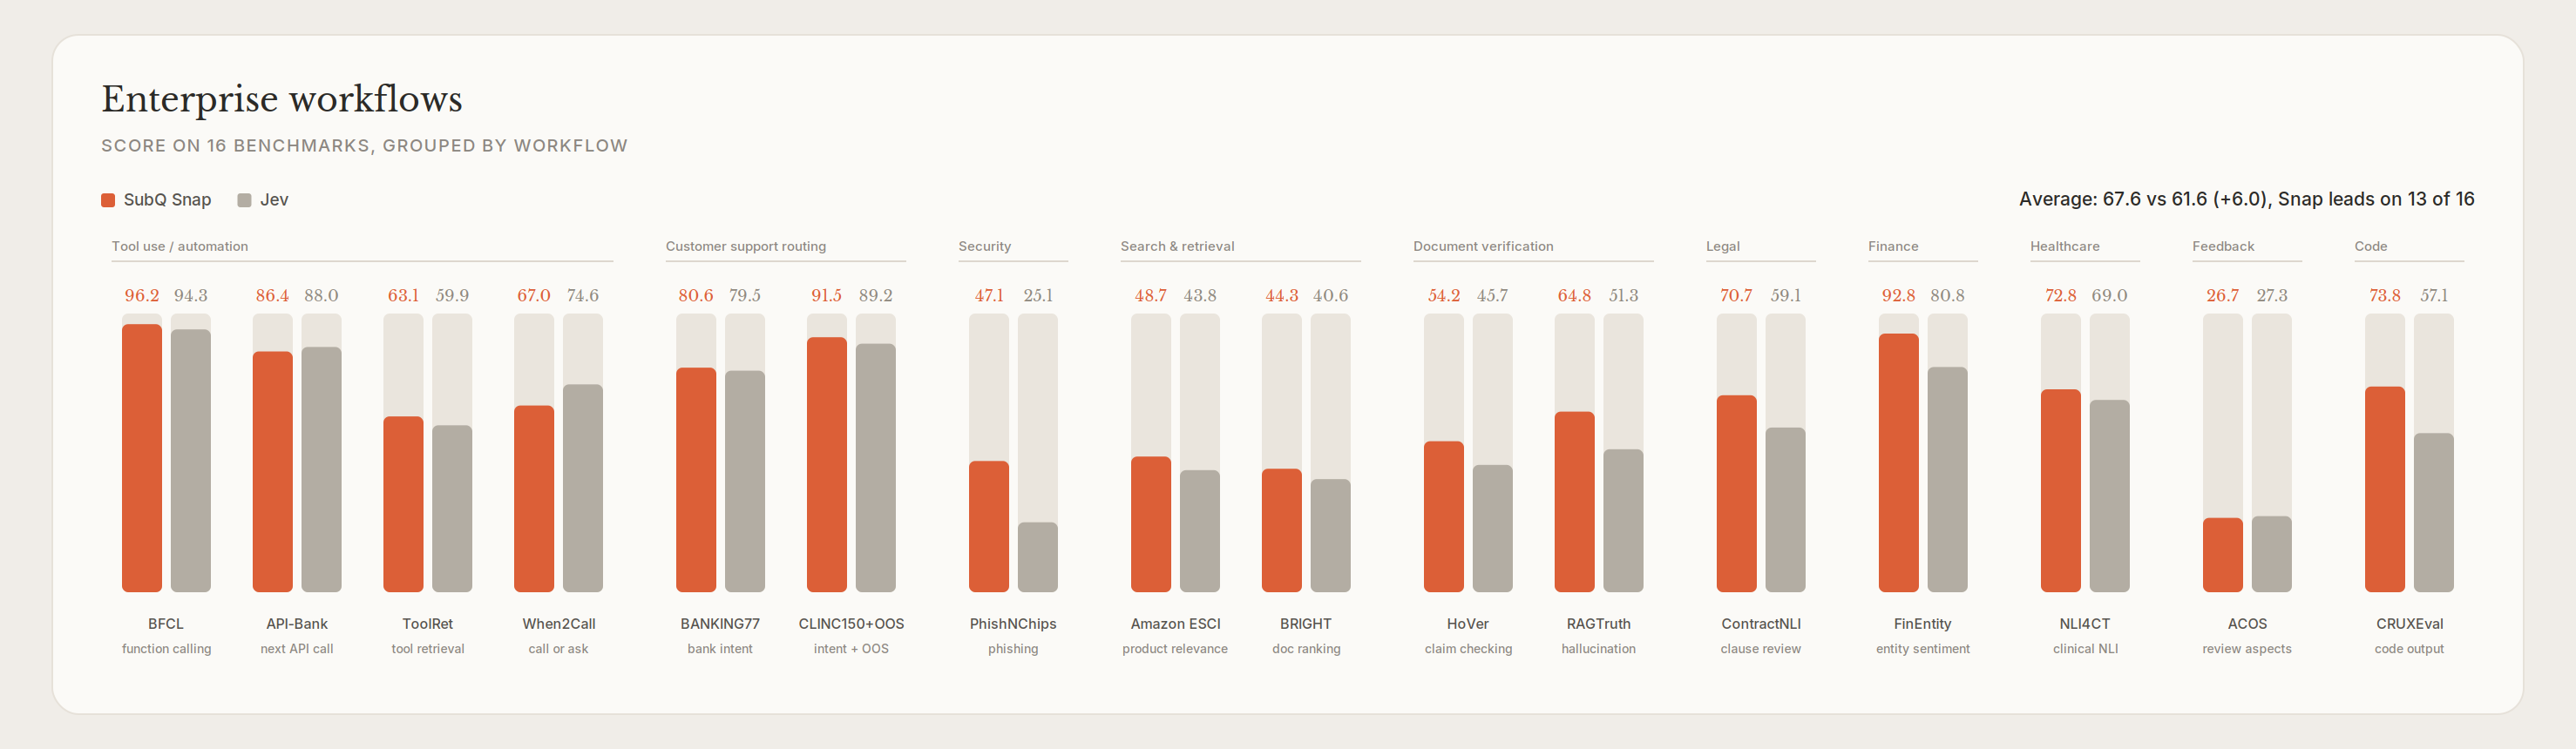
在公司另外挑出的 16 項企業相關測試中,Snap 領先 13 項。其中合約條件判斷得到 70.7,Jev 為 59.1,顯示某些文件決策值得深入評估。
但它在 API-Bank、When2Call 與 ACOS 落後。尤其 When2Call 測試要呼叫工具、詢問、回答或拒絕的時機,Snap 為 67.0,Jev 為 74.6。
這個落差值得重視,因為「下一步要做什麼」正是產品主打的用途。企業選模型時,應優先對照自己最常見的任務,再看總分是否有幫助。
長文件比較,包含一次讀入與分塊的差別
Decision LCR 是公司將長文件問答改成選擇題的測試。官方結果為 Snap 74.0、Jev 48.0,但 Snap 一次讀入資料,Jev 使用分塊處理。
這能呈現兩種資料處理方式的實用差異,卻不能視為兩個模型在完全相同輸入條件下的比較。模型能力與資料分塊方式,都可能影響結果。
原始 Artificial Analysis 長上下文推理測試評估的是書面回答。改成選擇題後,分數也不能直接拿去對照原始排行榜。
至於長內容找資訊的 Decision RULER,官方曾測到一百萬 token。那是研究評估的長度,目前 Snap 公開產品標示的上限仍是 384K。
這幾個界線放在一起看,比單一句「長上下文領先」更有用。要先確認它測了什麼,再判斷那件事是否接近你真正需要的工作。
價格很低,但圖片、存取與資料保留也要看
每百萬輸入 0.05 美元,如何估算一筆費用?
依照目前 官方模型與定價文件,SubQ Snap 每百萬輸入 token 為 0.05 美元,輸出不另外收費。
單純按這個費率計算,十萬輸入 token 約 0.005 美元,38.4 萬約 0.0192 美元。這是輸入費率換算,還沒有加入其他工具與服務的成本。
如果工作反覆送入同一份長背景,費用也要按實際每次呼叫計算。一次便宜,呼叫次數很多時,仍應記錄整個任務的累積用量。
官方首頁另列出前一萬名註冊者可獲一億免費輸入 token。是否仍有名額、帳戶實際拿到多少額度,要以註冊當下的帳戶資訊為準。
目前採先到先用的公開預覽,容量滿時可能進入候補。優惠與模型可用性應分別確認,有免費額度不代表任何時間都能立即使用。
支援圖片,但不能直接交給它一整段影片
目前 Decisions API 每次最多接受 4 張圖片,可搭配文字判斷。這與「多模態」的宣傳是一致的實作範圍,但還需要遵守檔案大小限制。
影片目前不支援直接輸入,官方建議抽取最多 4 個影格當圖片送入。因此,若用途是連續動作或長影片分析,就需要另做取樣與評估。
開發者應使用 subq-snap-preview 與 Decisions API,也就是供程式呼叫的決策接口。名稱相近的 subq-preview 是另一款長對話模型,存取階段與接口不同。
這個區分會影響接法與測試內容。若目標是文章生成,應評估生成模型。若目標是依照資料選分類,才適合先測 Snap 的決策接口。
企業文件送進去之前,先確認保留政策
官方文件目前列出的預設政策,是持續保留資料直到刪除。組織可聯繫 SubQ 改成保留指定天數,或申請零資料保留。
Decisions API 也受此政策管理。零資料保留啟用後,帳務與支援紀錄仍包含模型、token 數與時間等資訊,但不包含提示與完成內容,詳見資料保留文件。
準備導入時,可以先用公開資料或去除識別資訊的範例驗證。等帳戶政策、資料可傳送範圍與內部規定確認好,再決定哪些正式資料能交給它。
想試用,從一個可以驗收的判斷開始
先測客服分流,再決定是否加入更多角色
一個容易起步的例子,是把客服訊息分到既有部門。準備人工已確認去向的樣本,也納入模糊訊息、跨部門問題與資訊不足的案例。
接著寫清楚每個去向的條件,保留需要人工處理的選項。比較模型與原有方法的正確率、等待時間,以及每件實際花費,再決定是否採用。
測試樣本應包含會改變答案的細節,例如同樣寫「無法登入」,原因可能是忘記密碼、帳號未啟用,或服務本身發生故障。
如果只測文字明確、答案容易的案例,會高估正式上線的表現。刻意保留容易混淆的情況,才能知道哪些案件需要人接手。
最後再測系統如何處理超時、額度不足與服務暫時不可用。決策接口需要有退路,才能讓原本的客服流程繼續運作。
模型給建議,執行權限仍由流程決定
若把 Snap 用在工具選擇,程式也需要檢查被選中的動作是否允許執行。分類結果可以作為下一步依據,權限與完成條件則由原有系統管理。
同樣地,模型判斷「完成」後,仍應對照可觀察的結果。例如檔案是否產生、測試是否通過,或案件是否成功進入正確的處理佇列。
想進一步設計分數與人工接手條件,可以延伸閱讀Microsoft Decision-1 的結構化決策與信心分數實作。這些設計原則也適合拿來規劃自己的比較測試。
常見問題
SubQ Snap 可以取代聊天模型嗎?
它主要用於有明確選項與評分條件的判斷。需要寫文章、解釋原因或產生完整程式時,仍應評估適合生成內容的模型。
384K 是中文字數嗎?可以用到一百萬嗎?
384K 指 token 數,文字、圖片與問題會占用容量。官方研究有更長的評估,目前公開產品上限仍以 384K 為準。
輸出免費,代表使用完全免費嗎?
輸入依照 token 用量計費。符合發布優惠者可能取得免費額度,但名額、帳戶額度與後續收費,仍要在使用前確認。
官方領先 13 項,就值得全面換掉 Jev 嗎?
要看你的任務接近哪些測試。部分工具時機判斷仍是 Jev 領先,最好用相同資料比較,再決定哪個位置適合採用新模型。
結語:長背景、短答案,值得從小範圍實測
SubQ Snap 的方向很清楚:保留較長的判斷依據,用低輸入費率處理反覆出現的小決策。對客服分流、工具選擇與文件檢查,這提供了一個新的候選方案。
真正值得驗證的,是它能否在你的資料上同時達到正確、快速與便宜。先選一個範圍明確的判斷,量測完整流程,再決定是否擴大使用。
想持續掌握 AI 決策模型與實用工作流程,歡迎免費訂閱 AI 郵報。新的工具更新與應用解析,會直接送到你的信箱。