TTR-Compressor 少用 55.6% 視覺 Token:用每次輸入的回歸解,取代單純平均
TTR-Compressor 將序列摘要改為輸入相關的回歸解,在指定視覺實驗中用少55.6%的Token維持相近平均分。本文解釋RULER成績、閉式求解及實際速度與開放材料的限制。

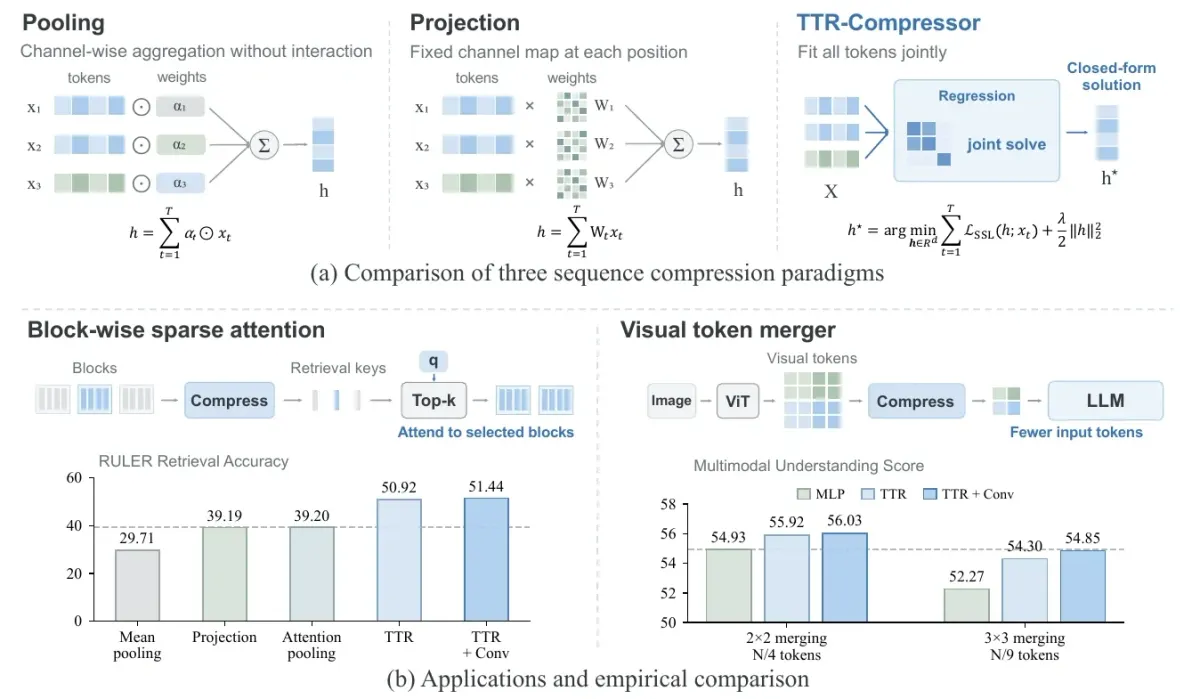
圖片在進入語言模型之前,通常會先變成一串視覺 Token。TTR-Compressor 想減少這些資訊的處理量,同時保留看懂圖片所需的線索。
直接把鄰近資訊平均雖然簡單,重複出現的內容卻可能蓋過少數重要細節。
研究者在 2026 年 10 月公開 TTR-Compressor,把序列壓縮改成每次依輸入求一次回歸解。
作者在指定視覺模型設定中,用少 55.6% 的視覺 Token 維持接近的平均分,也測試了語言模型的長序列檢索。
我認為這項方法值得做模型架構的團隊驗證,但省下的 Token 不能直接當成整個產品按相同比例提速,更不是所有現有模型都能直接加裝。
先看平均合併會丟掉哪一種資訊,才能理解為什麼要改成一起解讀整組輸入。
TTR-Compressor 為什麼不只把一組 Token 取平均?
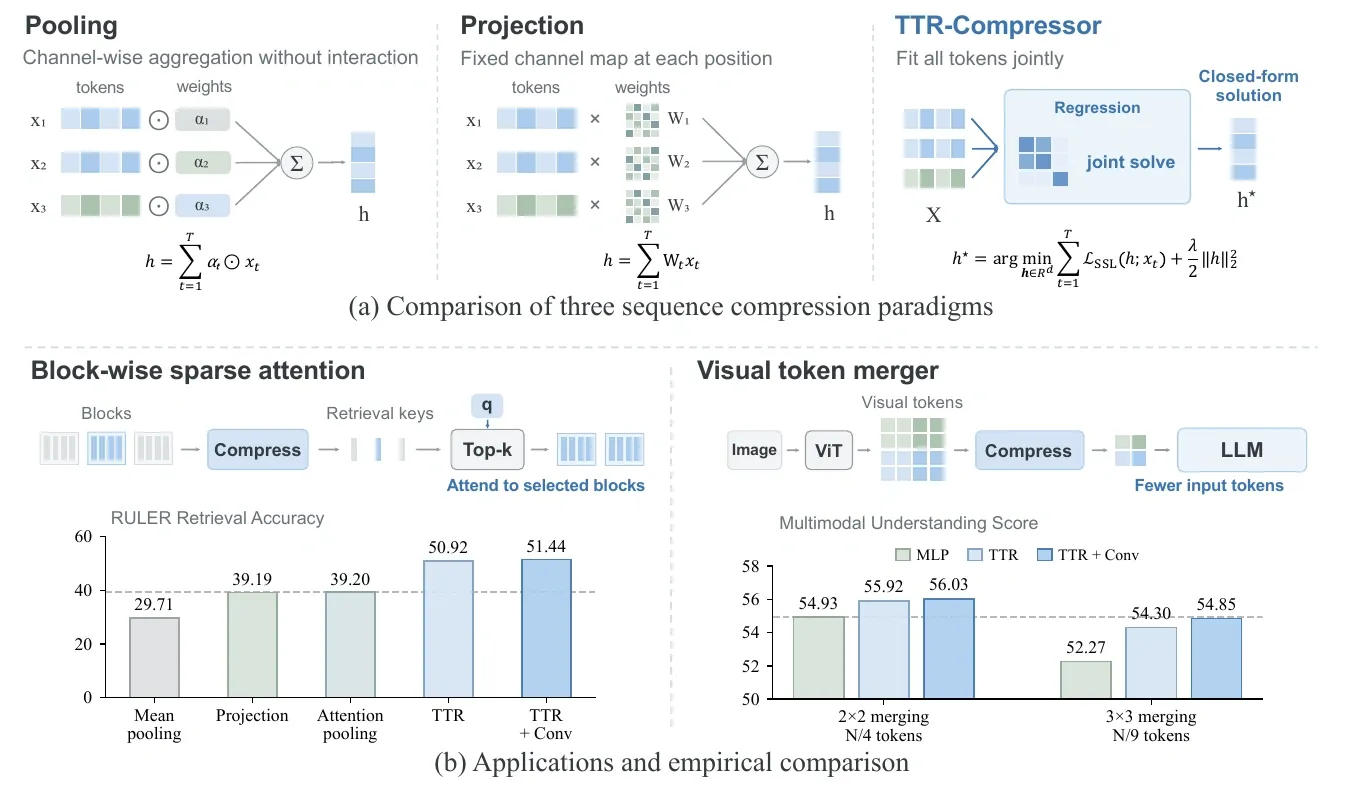
單純加總會讓重複內容累積影響,回歸方法則一起考慮整組資訊的關係,再形成摘要。Token 是模型處理資訊的單位,圖片也會被轉成這類數值表示,才能送到後續網路。
需要壓縮的原因很直接。高解析度圖片會產生較多視覺資訊,如果全部送進語言模型,後面的計算和記憶體需求也會增加,先合併部分資訊就能減少處理量。
但合併不是只改長度。圖片裡大面積重複背景,可能比小小的按鈕或數字占更多位置。若摘要主要反映出現次數較多的內容,真正要回答的細節就可能被弱化。
這是用來說明資訊取捨的情境,不是作者已證明每種小字問題都能解決。研究真正檢查的是,在固定模型和資料設定下,新的摘要方法是否改善後續任務。
官方用一個簡化例子解釋差異:三個相同表示加上一個不同方向的表示,單純累加時兩群影響為三比一。指定回歸條件下則成為三比二,不同資訊的相對份量提高。
這個比例來自示意設定,沒有代表所有圖片都會保留同樣份量。它說明的是,重複資訊可以出現邊際影響變小的效果,而不是看到三次就永遠比看到一次重要三倍。
因此,TTR-Compressor 嘗試讓同一組輸入彼此影響摘要權重,避免每個位置都只被獨立加進去。它改的是資料進入後續模型前的合併方式。
要讓摘要真正幫到後續任務,模型還需要先學會該解哪一個回歸問題。
訓練學目標、推論解係數,兩個階段怎麼分?
TTR 訓練時學習投影與正則條件,推論時依當前輸入直接求出係數。模型權重是訓練完成後的參數,推論時不反覆改動。回歸是找出一組係數,讓輸入和目標之間的對應誤差盡量小。
這裡的目標不是人工替每個 Token 打上重要或不重要的分數。研究讓後續任務的訓練訊號,經過求解過程回到壓縮器,學出什麼樣的回歸問題比較有用。
正則條件則限制解不要過度偏向某些方向,可以理解成替求解加上約束,減少只顧著配合當前資料而形成不穩定係數的情況。這些條件在訓練後固定。
真正變動的是每次輸入求出的結果。換一張圖片或另一段序列,資訊彼此的關係不同,係數也會跟著變,模型因此得到依輸入調整的摘要。
它和邊使用邊訓練模型不一樣。推論不需要反覆做梯度更新,而是用閉式求解完成當次計算。閉式表示能直接依數學系統求解,不必靠多輪試著調參。
作者也把求解改寫成較小的系統。當一組 Token 數遠少於特徵維度,改在 Token 數量對應的空間處理,可以減少直接求解大型矩陣的負擔。
研究列出的基礎壓縮器參數量是特徵維度的兩倍,指新增壓縮部分,不是整個語言或視覺模型只有這麼少參數。後面的編碼器與語言骨幹仍然存在。
求解時,研究把用來比較相似性的表示先做正規化,讓方向而非原本大小決定相似程度。目標端卻保留原始幅度。這種不對稱讓當次輸入仍會影響答案,避免目標只剩一個固定投影就能完全配合。
因此,回歸不是取平均後換個名稱。模型一方面學哪些特徵方向值得比較,另一方面依整組輸入的相互關係調整摘要,兩層安排一起決定結果,仍需要後續任務證據支持。
這種輸入相關的摘要先被用在稀疏注意力,檢查是否更容易找回重要內容。
RULER 檢索進步十二點,對長上下文代表什麼?
在指定模型與資料量下,更好的區塊摘要提升檢索分數,但不是任何長文件問答都同幅改善。稀疏注意力會先選擇要深入處理哪些資訊,摘要品質因此影響能否找到正確位置。
如果一個區塊的摘要漏掉關鍵特徵,後面即使有能力理解那段文字,也可能根本沒有選到它。這是壓縮器能影響整體結果的原因,並不只是減少計算量。
TTR 作者在 HiLS-Attention 框架裡更換壓縮器,使用三點四五億參數模型、約三百億訓練 Token,再比較四項 RULER 檢索任務,測試長度從四千到三萬二千。
在這組設定中,加上局部卷積的 TTR 版本平均正確率為 51.44%,注意力加權池化為 39.20%,差十二點二四個百分點。池化就是把多個表示合成較少摘要的操作。
局部卷積會把附近位置的資訊也帶進合併,因此這個最大差距包含該版本的安排,不能全部改寫成最基礎回歸求解單獨帶來的提升。
另一組十億參數、約一千億訓練 Token 的比較,也得到較高檢索分數,但數值屬於另一個規模。把兩組分數並列能看趨勢,不能相減當成只增加參數的受控實驗。
這些結果支持摘要方法會影響重要資訊能否被找回。它沒有測完實際產品裡所有長文件理解、引用正確性或多步任務,應依測試用途理解改善範圍。
同一種摘要還能放在圖片入口,這時要比較的是少留資訊後能否看懂。
少 55.6% 視覺 Token,模型和比較方式是什麼?
作者以同一組視覺編碼器與語言骨幹,比較四格合一和九格合一的結果,換算出 Token 數量差距。視覺編碼器負責先把圖片變成特徵,骨幹則是後面理解內容的主要模型。
TTR 這組研究使用 Qwen3-VL 的視覺編碼器,搭配 Qwen3-4B-Instruct 語言骨幹。它不是直接拿完整官方產品的預設配置,和另一個毫無調整的服務隨意比較。
標準 MLP 合併器把二乘二的位置合成一個,若原本有 N 個位置,後面剩 N 除以四。新方法的指定版本以三乘三合併,則剩 N 除以九。
因此,新版本相對留下九分之四的數量,減少約百分之五十五點六。這個比例來自合併格數,不是壓縮模型權重,也沒有表示輸出的回答文字減少一半。
結果品質需要另外檢查。若只是留下更少位置,任何方法都可能讓計算減少。研究重要的部分,是在較少表示下,後面模型還能否正確回答。
作者將帶局部卷積的 TTR 九格合併版本,和標準 MLP 四格合併對照,得到接近的十項評測平均。這支持指定架構下的取捨,沒有證明所有模型都能用同樣合併率。
圖片大小和原始 Token 數也會影響實際減量。比例能描述前後關係,但使用者若換了輸入解析度或影片長度,實際處理多少資訊仍會變動。
平均分相近仍可能掩蓋任務差異,因此省量之後還要看細節表現。
平均 54.85 與 54.93 接近,哪些結論還不能直接下?
兩個平均描述十項評測的整體表現,不保證文字辨識、圖表和空間推理每一項都沒有代價。平均接近,可能同時包含部分任務改善、部分任務變弱。
這組評測涵蓋視覺問答、知識、文件理解與空間題。它比只挑一個好看的展示更完整,但每種任務在產品裡的重要性不一樣,不能只因平均相差很小就視為完全無損。
例如文件產品最在意小字和表格,空間操作產品則可能更在意位置關係。兩者即使使用同一個平均分選模型,也可能需要不同的合併方式,因為錯誤代價不同。
這不是研究已證明某種特定小字一定會丟失,而是從平均量測的限制推導出的採用判斷。應回到對應題型檢查,而不是由整體分數替所有子任務作保證。
同樣地,這份結果沒有直接量測真實工作最終是否成功。看懂一張圖是流程的一部分,後面的推理、工具和狀態管理仍可能失敗,不能把這個平均換成產品完成率。
若要比較自己的模型,就應保留相同圖片、題目與評分方式。只用較容易的一批圖測新版本,再拿舊版本的公開平均對照,會看不出真正的品質取捨。
結果品質之外,回歸求解本身也有計算成本,需要和省掉的後段工作一起看。
每次求解會不會抵銷速度,現有時間數據怎麼讀?
TTR 方法用小型線性系統求解降低額外負擔,但公開時間表量的是指定訓練流程,沒有證明所有部署都同比加速。少傳一些 Token 和讓使用者更快收到答案,是兩個需要連起來量測的步驟。
壓縮器自己先做運算,後面的模型才得到較短輸入。如果求解成本過高,或硬體沒有有效執行這類計算,就可能吃掉部分後段節省,不能只計算少了多少位置。
官方列出,四格合併時標準 MLP 訓練約十八點四小時,基礎 TTR 約十八點五五小時。九格合併時,兩者又是另一組接近的時間,沒有出現與 Token 比例相同的訓練減幅。
九格合併時,表格列出的 MLP 與 TTR 訓練時間約為十七點二五和十七點零二小時,仍然很接近。比較的重點是新增求解沒有在這個設定造成巨大訓練負擔,不能把小幅差距當成任意硬體都成立的效能保證。
這些數據顯示作者有檢查實際成本,而不是只報理論複雜度。不過,訓練時間還包含其他模組,並不直接告訴你部署後每張圖或每個回答會快多少。
研究針對壓縮視窗遠小於特徵維度的情況,使用較小的求解系統。若把它改用在完全不同的分組大小,原本的效率前提也可能改變,不能忽略輸入形狀。
要重現這個取捨,最後還需要確認程式、模型與依賴實際提供到哪裡。
哪些材料已公開,適合如何開始驗證?
官方提供稀疏注意力與視覺合併的訓練和評測入口,研究者仍需準備相容骨幹、資料與執行環境。程式庫把兩條路徑分開,因為它們修改的位置和評測目的不同。
視覺範例要求準備初始模型與資料,依序完成兩階段訓練,再使用相應評測工具。這表示它是一項模型開發方法,不是使用者在任何聊天服務勾選一個選項就能啟用的功能。
程式也提供基礎版本、加局部卷積的版本與 MLP 對照。保留這些差異很重要,否則即使重現了較高分,也可能無法辨認改善究竟來自回歸還是其他組件。
我會先固定同一套評測與硬體,只更換合併器,確認省下的處理量沒有讓自己的核心題型失真。對需要長圖、多圖或較長序列的團隊,這樣的比較才足以決定是否值得整合。
延伸閱讀:Meta-Video 發現評測設定可差 19.5 個百分點:AI 看影片榜單該怎麼比?
延伸閱讀:MiniCPM-V 4.7 本機視覺 AI 解析:手機讀圖更快,3GB 記憶體與五倍加速怎麼看
TTR-Compressor 常見問題
TTR-Compressor 是權重量化工具嗎?
它調整序列與視覺資訊的合併方式,改變送入後續模型的表示,並非單純壓縮權重檔。
少 55.6% Token 就能讓產品快 55.6% 嗎?
比例來自指定視覺合併格數,求解與其他模組仍有成本,不能直接換算整段產品速度。
每次輸入求回歸解,會改掉模型權重嗎?
推論時學好的條件固定,只依當次輸入求係數,沒有反覆更新模型參數。