XGO-Duck:Arduino Uno Q 也能跑雙足機器人的動作策略
Luwu Dynamics 開源 XGO-Duck,以 Arduino Uno Q、15 顆伺服馬達與神經網路控制雙足動作。本文說明雙處理器架構與安全設計。
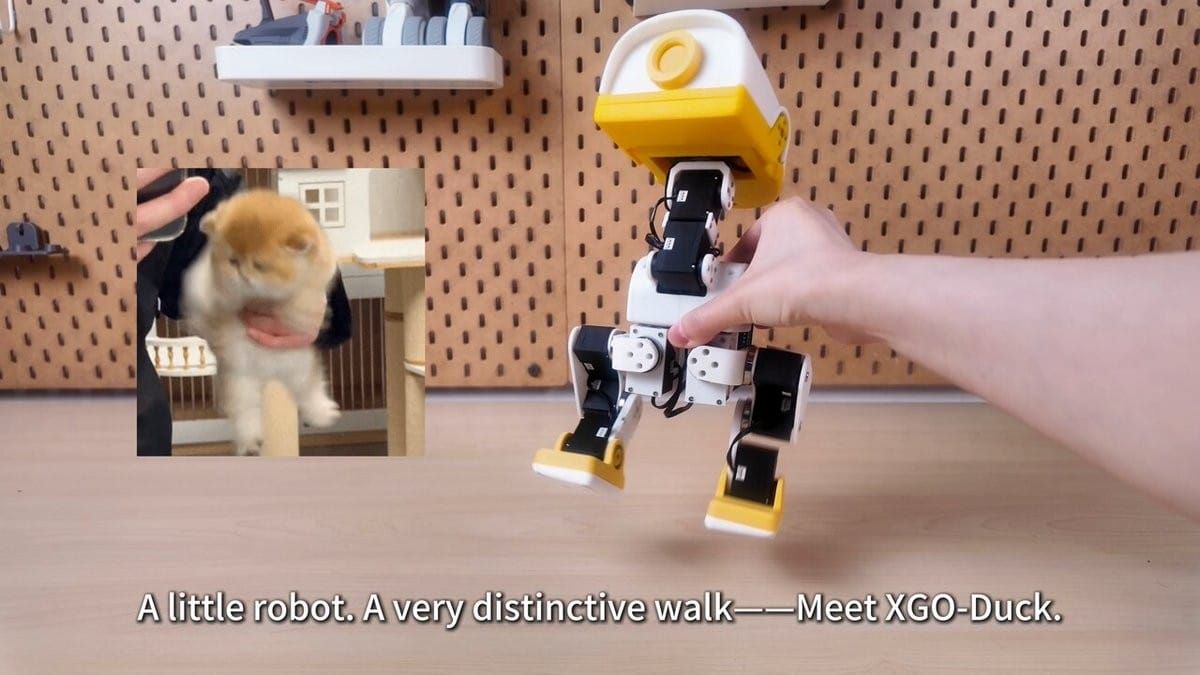
Luwu Dynamics 公開 XGO-Duck 的硬體、結構與執行程式。這是一隻以 Arduino Uno Q 為核心的雙足鴨型機器人,可執行行走、起身與拿取等神經網路動作策略。
專案改編自 Pollen Robotics 的 Microduck,沿用 15 顆伺服馬達、關節順序與每秒 50 次的神經控制節奏。XGO-Duck 改用自己的擴充板、Feetech 1910 伺服馬達與 QMI8658 動作感測器。
一塊 Arduino 板如何控制雙足機器人?
Arduino Uno Q 內有兩個運算部分。Qualcomm Linux 主機執行 ONNX Runtime 與神經網路策略,STM32 微控制器負責每秒 100 次的伺服馬達迴圈。ONNX 是讓訓練後模型在不同裝置執行的格式。
兩邊透過 Bridge 傳送狀態與命令。Linux 每秒產生 50 次動作,微控制器以更快頻率維持馬達控制。把高階策略與即時控制分開,可以避免 Linux 暫時卡頓時,馬達迴圈也跟著停止。
開源專案如何處理安全?
官方程式會拒絕非有限數值的目標,也會限制伺服馬達編碼器範圍。若主機回傳狀態超過 150 毫秒,系統會解除動作,降低舊命令持續執行的風險。
這些保護仍不能消除機械風險。組裝誤差、校正、電池與地面摩擦都會影響結果。初次測試應留出安全空間,並準備立即斷電。開源也不代表所有零件與套件都可在各地立即買到。
模擬訓練如何走到真實機器人?
雙足動作若直接在實體機器人上反覆嘗試,跌倒會損壞零件,訓練也很慢。Microduck 與 XGO-Duck 的路線是先在 MuJoCo 模擬環境建立機器人與地面,再用強化學習反覆練習行走、起身與拿取。
訓練完成後,策略輸出成 ONNX 模型,部署到 Uno Q 的 Linux 端。真實世界的馬達力量、摩擦與感測誤差不可能和模擬完全相同,所以訓練需要加入隨機變化,讓策略不要只記住單一理想環境。這個從模擬轉到實體的過程稱為 sim-to-real。
微控制器以 100Hz 維持馬達迴圈,Linux 端以 50Hz 執行策略。分層設計讓即時控制不必等待較複雜的神經運算。狀態過舊就解除動作,也是一種看門狗機制,避免舊命令在通訊中斷後持續驅動。
這個專案適合學什麼?
對學生與 Maker 而言,它把機構、電路、韌體、Linux、神經模型與網頁控制放在同一個專案中。可以先從模擬器觀察關節與策略,再逐步組裝硬體,理解每一層如何交換資料。
想修改動作時,不應只改馬達角度。需要確認關節順序、感測座標、控制頻率與模型輸入是否一致。校正檔也屬於每台機器人的本地資料,不能直接複製別人的數值。
開源材料降低研究門檻,但實體測試仍要準備斷電方式、固定區域與零件備品。最有價值的學習不是讓鴨子走一次,而是理解策略在何種條件下會失敗,以及控制系統如何安全停止。
開源硬體的可重現性要靠文件維持
材料表與 3D 列印檔只是起點。伺服馬達批次、列印公差、韌體版本與校正步驟都可能改變行走結果。專案若能持續記錄已驗證的零件與失敗案例,社群才容易重做。
XGO-Duck 將硬體與執行程式分成不同專案庫,方便各自更新,也要求使用者核對相容版本。重大更新最好以標籤或發布版本配對,避免最新硬體檔和舊韌體無法一起工作。
對教育使用而言,可讓學生先比較模擬與實體感測差異,再修改單一參數。這比直接下載新動作更能理解 sim-to-real 的核心問題。
XGO-Duck 的雙處理器架構為何重要?
Linux 主機擅長執行神經網路、網頁介面與高階邏輯,卻不是硬即時系統。背景程序或儲存操作可能造成延遲。STM32 微控制器能以固定頻率控制伺服馬達,不必等待 Linux 每次回應。
兩邊透過 Bridge 傳送狀態與命令,形成高階策略和低階控制的分工。策略決定下一個目標動作,微控制器負責穩定輸出、感測與安全限制。這種架構也常見於更大型機器人。
狀態快照與時間限制避免命令排隊。若系統把舊動作全部依序執行,網路或運算卡頓後,機器人可能突然補做過時命令。跳過晚到週期能讓控制保持接近目前狀態。
15 顆伺服馬達如何形成動作?
每顆伺服馬達控制一個關節,策略輸出目標角度。感測器提供機身方向與運動資訊,模型根據目前狀態持續修正。行走不是播放固定動畫,而是每秒多次根據回饋調整。
關節順序與座標方向必須和訓練環境一致。只要左右腳或角度正負號對錯,策略就會產生完全不同動作。韌體與 Linux 端都要使用同一份定義。
校正處理每台機器人的零點差異。官方把校正檔保留在本機,不提交到程式庫,因為別人的數值可能讓馬達到達危險角度。
sim-to-real 為何需要隨機化?
模擬器中的地面、摩擦與馬達通常比真實世界一致。訓練時加入重量、摩擦、延遲與感測雜訊變化,能讓策略學會在不同條件下維持平衡,而不是只適應一組完美參數。
隨機範圍太小,真機差異會超出模型經驗。範圍太大,模型又可能難以學會有效動作。開發者需要透過真機測試逐步調整,並保留安全支撐與低速模式。
起身與拿取也有不同風險。拿取涉及手臂與重心變化,物體重量超出訓練範圍時可能跌倒。展示成功不能取代負載與邊界測試。
教學與研究可以如何分階段進行?
第一階段只在模擬器觀察關節、感測與策略輸出。第二階段組裝硬體、校正並以固定姿勢測試通訊。第三階段在有支撐的空間執行短動作,再逐步增加自由度。
學生可以比較模擬狀態和真實感測,分析差異來自零點、摩擦還是延遲。也能修改網頁控制與日誌,而不必一開始重新訓練模型。
XGO-Duck 的價值在於把完整管線公開,讓學習者看見 AI 動作不是單一模型魔法。機構、韌體、資料、控制頻率與安全機制都要配合,機器人才會可靠地站起來。
把這則新聞轉成可驗證的小型專案
新聞中的效能、效率或安全主張,通常來自供應商選定的展示環境。真正採用前,可以先做一個範圍明確、結果可回復的小型專案,並保留目前流程作為比較基準。這樣能分清楚新產品本身的能力,以及團隊因為第一次使用而產生的學習成本。
XGO-Duck 的第一個實作不應直接追求完整行走。可先在模擬器確認關節定義,再在支架上測通訊、零點與單一動作,最後才到有緩衝的地面執行短週期策略。
試驗開始前要先寫下通過條件、停止條件與負責人。若過程涉及寫入正式資料、對外聯絡、付款或公開發布,就應把人工批准放在動作之前。測試結束後也要保存版本、設定與輸入範圍,否則下一次產品更新時無法重現結論。
哪些數字會改變採用決定?
每一步記錄控制週期延遲、逾時命令、感測漂移、關節溫度、跌倒次數,以及模擬和真機狀態的差距。影片成功一次不能代表策略已可靠。
平均值容易遮住少數嚴重失敗,因此還要看最差案例和失敗分布。若十次任務有九次很快,一次卻造成無法回復的錯誤,不能用平均速度掩蓋風險。供應商提供的基準可作為起點,採用決策仍應以自己的資料、權限和驗收方式為準。
若橋接層能跳過過期命令、微控制器可獨立維持安全限制,才適合增加速度與自由度。校正檔、負載範圍和緊急停止都應在公開教學中被明確處理。
最後把結論寫成有期限的判斷,例如「目前只用於內部草稿,三個月後重測」。AI 產品更新很快,今天的限制可能改善,今天的優勢也可能因價格、模型版本或條款改變而消失。可重跑的評估流程,比一次性的推薦更有長期價值。
Luwu Dynamics 官方影片展示 XGO-Duck 從列印零件、組裝到行走、起身與拿取。 影片來源:Luwu Dynamics 官方 X。
常見問題
XGO-Duck 的硬體也有開源嗎?
有。官方 GitHub 提供可列印結構、擴充板資料、材料表與組裝指南,執行程式則放在另一個專案庫。
動作是在真實機器人上學會的嗎?
專案沿用 Microduck 的模擬訓練與轉移方法,先在模擬環境訓練策略,再把模型部署到實體機器人。
結語
XGO-Duck 展示小型開發板也能把神經策略與即時馬達控制結合。它的教育價值不只在可愛外型,而是把模擬訓練、模型部署、感測回饋與硬體安全放進一個可拆解的開源專案。