PolicyLM-1.7B 開放權重:AI 每次讀平臺規則,內容審核不用等重新訓練
平臺規則改了,內容審核模型卻可能還沿用舊分類。Musubi 在 2026 年 10 月 6 日公佈 PolicyLM-1.7B,讓模型每次審核時讀取提供的政策,再判斷文字是否符合規則。對論壇、社群和客服產品而言,這個方向有機會縮短規則更新到執行之間的落差。

平臺規則改了,內容審核模型卻可能還沿用舊分類。Musubi 在 2026 年 10 月 6 日公佈 PolicyLM-1.7B,讓模型每次審核時讀取提供的政策,再判斷文字是否符合規則。對論壇、社群和客服產品而言,這個方向有機會縮短規則更新到執行之間的落差。
本文會進一步說明自訂政策分類,並分析實際使用條件與評估方法。
每次讀政策,先減少規則更新的摩擦
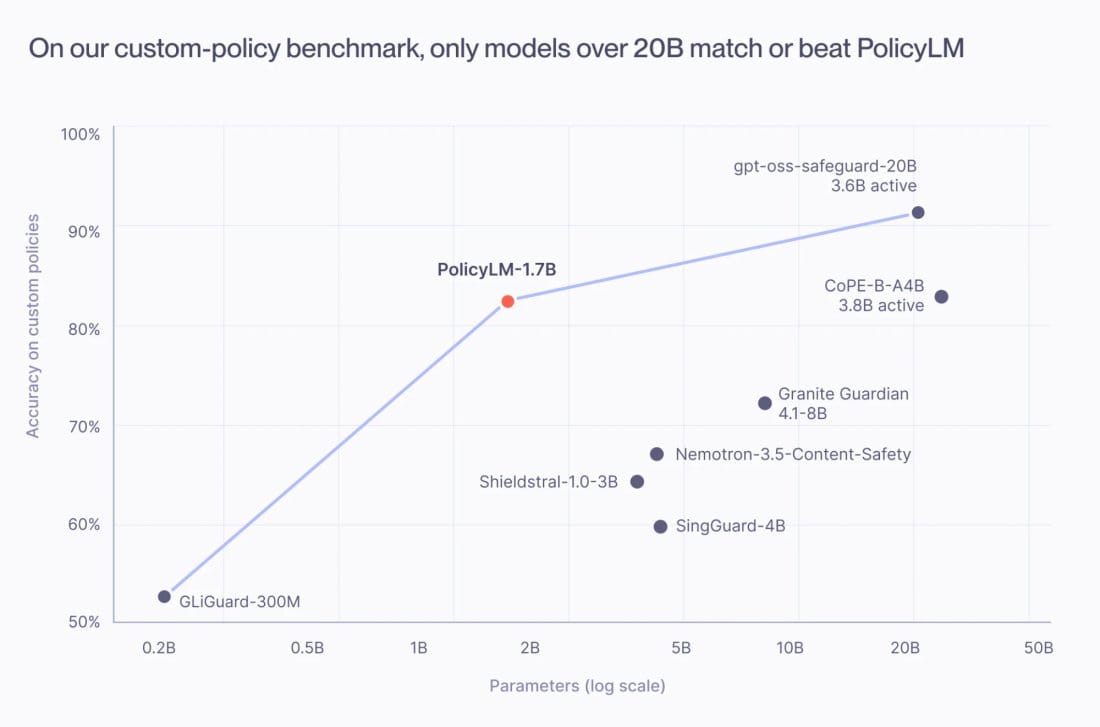
依 官方介紹,PolicyLM-1.7B 是可下載部署的開放權重模型,採 Apache 2.0 授權。模型權重就是訓練完成的核心參數。1.7B 表示約十七億個參數,規模比許多大型聊天模型更小。
它把政策文字和待審內容一起作為輸入,輸出分類判斷。這讓平臺有機會調整政策描述,而不必每次都重新訓練模型。官方模型卡另提供自訂分類模式,每次可設定最多十六個政策類別。規則可以更新,但仍需檢查長度與判斷品質。
語言與長度,是落地之前要看清楚的限制
官方評估涵蓋 19 種語言,英語表現較強,泰米爾語等語言仍有明顯差異。政策文字的測試主要使用英語,這不等於繁體中文政策已獲得同樣程度的驗證。
模型核心的政策與訊息共用 2,048 個 token,也就是模型切分文字所用的單位。官方輔助程式可分段處理較長訊息,但每段仍有窗口限制,也不會自動理解完整對話歷史。
速度數字,需要和審核錯誤一起看
官方測試在 24GB 的 NVIDIA L4 裝置上,六類審核的中位數延遲約 35 毫秒,並報告低於 100 毫秒的條件性結果。這是指定硬體與任務的測試,部署成本和實際速度仍要用自己的資料確認。
模型沒有提供完整文字推理說明。平臺需要儲存政策版本、輸入與分類結果,才方便追查爭議。不同門檻也會改變誤擋和漏放的比例,不能只追求一個漂亮的準確率。
自訂政策分類,讓規則可以與每次訊息一起判斷
官方模型卡提供 explicit 模式,可以把自訂類別寫成簡短規則,在推論時直接使用,不必為了每次政策調整重新訓練。推論是模型處理輸入併產生結果的過程。每項類別可以包含違規條件、非違規條件與例外,讓模型不僅知道要攔什麼,也知道哪些內容應該保留。
這項能力特別適合規則經常更新的社區。假設平臺新增一種交易資訊要求,可以先將規則整理成明確類別,再用代表性訊息測試,而不是立即建立一輪完整訓練。這裡的重點是政策成為輸入的一部分,不是任何寫法都能被正確理解。規則複雜、互相矛盾或過度冗長,仍會影響結果。
官方說明每次政策最多支援十六個類別,也提供內建的通用分類模式。自訂與內建模式用途不同,企業應先確認需要哪些規則,再選擇合適方式。類別數上限與文字空間都需要保留,不能把整本社區規範貼進去,就假設模型會完整理解。
規則與例外需要同時清楚,避免誤擋正常內容
內容審查最困難的情況,常是同樣詞語出現在不同用途。討論保護密碼,與要求分享密碼,可能包含類似文字,意圖卻不同。政策可以把禁止條件與允許情況分開,讓模型有更具體依據。這是官方模型卡示範的規則寫法方向,實際效果仍要以自己的資料檢查。
引用違規內容進行舉報,也可能與真正發佈違規內容不同。如果平臺希望保留舉報,就需要在規則中說明例外,並準備相應測試。只列一組敏感詞,容易把正常討論一起擋下。政策導向模型有機會減少這種僵化判斷,但不應因此取消對複雜語境的人工處理。
規則變更之後,也要重跑舊樣本。新增一句例外可能改善某些誤擋,也可能影響其他類別。官方提醒,一起輸入的類別會互相影響,因此企業不能只測試修改的那一個例子。保存政策版本與代表性樣本,才能知道更新帶來了什麼變化。
核心窗口與長訊息處理,屬於不同層級的限制
模型核心的政策與訊息共用兩千零四十八 token,token 是模型切分文字的單位。官方輔助程式則會將較長訊息切成窗口處理,並設有獨立的字元長度限制。換言之,核心窗口不等於輔助程式完全不能接收較長文字,但分段也不代表模型一次理解了整篇文章。
分段審查可能失去跨段關係。例如前段提出一種說法,後段才說明引用或反駁,單看局部窗口可能產生不同判斷。平臺如果需要完整對話或長文語境,應確認目前處理方式能否滿足,而不是把分段能力當成無限上下文。官方也說明模型主要處理單則文字,不負責圖片與完整對話歷史。
政策本身越長,留給訊息的空間也會變少。企業應把規則整理成簡短、明確的類別,並使用官方檢查方式確認長度。長文輸入與複雜政策都需要邊界,只有知道實際截取與分段方式,才方便追查為什麼某一段被標記。
零到一的分數,要搭配自己的門檻與樣本
PolicyLM 為各類別輸出零到一的分數,平臺再依門檻決定是否標記。分數不是完整的文字推理,也不能自動解釋給使用者為什麼遭到處理。若需要申訴、停權或移除的說明,仍要結合政策依據與人工判斷,不能只公佈一個模型分數。
門檻高低會影響誤擋與漏放。假設一萬則訊息裏,真正違規只有少數,即使整體準確率很高,仍可能產生比真正違規更多的錯誤標記。這個假設說明基礎比例的重要性:平臺應分別查看正常內容被誤擋的數量,與違規內容未被識別的數量,而不只看一個平均成績。
官方提供不同預設與自訂門檻,企業可以用已標註樣本決定適合範圍。重要的是先定義處理動作。低信心標記可以送人工檢查,高信心也不一定直接刪除,具體安排取決於平臺規則與後果。模型判斷與平臺執行應分開,才容易修正錯誤。
十九種語言的評估,不能代替本地用語驗證
官方評估涵蓋十九種語言,但政策文本測試以英語為主,並說明部分語言表現較弱。繁體中文社區可能包含地方用語、反諷、中英混合與引用,這些都需要自己的樣本。多語言支援提供試驗起點,不是對每種語言與政策寫法的同等保證。
平臺可以先整理容易引發爭議的真實案例,去除個人資訊後建立人工判斷,再比較模型。除了明顯違規,也應包含正常討論、新聞引用與舉報。只有測試困難案例,纔看得出模型是否減少現有問題。隨機抽取大量簡單內容,可能讓總體成績好看,卻無法說明爭議場景。
語言測試還要固定政策版本。若同一批樣本不斷換規則與門檻,就難以知道改善來自哪裏。先確認規則能被清楚表達,再驗證目標語言,能夠讓問題比較容易定位。部署之後也應持續觀察新用語與使用情境,避免模型只適合初期資料。
三十五毫秒是指定條件,裝置差異也會影響結果
官方在二十四 GB 的 NVIDIA L4 上報告短訊息、最多六類的中位數約三十五毫秒,H100 條件下約二十二毫秒。速度與訊息長度、類別數及裝置有關,不能當成所有部署的固定延遲。CPU 與 Apple 裝置可以運行,也不代表具有相同效能。
模型卡還指出,不同數值精度與裝置可能讓分數出現差異。數值精度是計算時保存小數的方式,較低精度可以減少資源,但結果不一定完全相同。若平臺已經設定門檻,遷移裝置或更新版本之後,應重新檢查邊界樣本,避免同一訊息突然得到不同動作。
實際系統還需要排隊、資料傳輸與記錄,完整延遲會比模型推論多。平臺應測量從收到訊息到決定呈現或轉交的時間。若速度已經足夠,後續優化更應關注錯誤與人工負擔,不能為了縮短幾毫秒忽略重要判斷。
開放權重有助於本機部署,仍有明確適用邊界
PolicyLM 使用 Apache 2.0 授權,並提供可下載權重與輔助程式。這讓團隊可以評估本機使用與離線處理,減少對遠端呼叫的依賴。授權說明的是使用條件,實際資料治理、模型維護與平臺處理責任仍由部署者安排,不能因為模型開放就省略這些工作。
官方模型卡明確列出不適合把它當成唯一兒童安全、自傷保護或對抗性安全邊界,也不定位為審查助理回答的通用系統。這些限制應被當成產品範圍。平臺有相關高影響需求時,需要專門工具與合適的人工作業,不能把快速分類模型當成全部保護。
開放實現的優勢,是可以檢查版本、測試與處理過程。企業應固定使用版本並保存驗證結果,出現異常時纔有辦法重現。下載一個模型只是開始,持續評估與處理錯誤,才決定它是否適合正式服務。
審核紀錄應保存政策,不只保存模型名稱
同一則內容,在不同政策下可能得到不同結果,因此紀錄需要包含當時的規則版本、門檻與輸入。模型版本只是其中一項。若只留下「被 AI 標記」,平臺就難以判斷爭議來自政策、資料還是模型。
人工更正也應回到測試資料。某個案例經確認屬於正常內容,可以成為之後規則更新的回歸樣本。這樣能避免同樣問題反覆出現,也讓平臺知道修正是否影響其他分類。可追溯的紀錄,是把快速模型轉成穩定審核流程的重要條件。
先觀察標記建議,再決定哪些動作能夠自動化
導入可以先採用平行觀察,讓模型產生標記建議,實際內容仍依既有流程處理。團隊比較誤擋、漏放與政策差異,再調整規則與門檻。這樣能取得真實資料,同時避免一開始就讓模型決定所有使用者結果。
申訴與更正也應成為流程的一部分。使用者提出上下文時,平臺需要能查看原始內容、政策版本與當時結果,再作判斷。模型沒有文字推理,紀錄更重要。處理結果若只剩一個標籤,就難以解釋,也難以改善。
PolicyLM 的價值在於把規則更新與快速分類連接起來。適合先試的,是單則文字、政策清楚且有標註樣本的場景。若測試能減少誤擋與人工重複工作,再逐步擴大。若需要複雜語境或高影響判斷,就應保留其他工具與人工作業。
類別、自訂規則與長訊息處理可查閱 Musubi 官方模型卡。
常見問題
可以直接用在繁體中文社群嗎?
可以設計測試,但要先用代表性繁體中文內容評估,包括引用、反諷、地方用語和上下文。公開的跨語言結果不能代替自己的驗證。
這能完全取代人工審核嗎?
它適合協助大量內容分類。爭議案例、申訴和需要上下文的情境,仍應保留人工處理流程。
先測試真正困難的內容
PolicyLM 的價值在於把政策變成每次判斷都能讀取的輸入。要知道是否適合你的平臺,最好拿容易引發誤擋的真實樣本測試,並明確設定人工接手門檻。