Qwen Intelligence 是什麼?從 Mobile Planner、Qwen-UI-Agent 到手機 Agent 的完整解析
Qwen Intelligence 所代表的手機 Agent 方向,正在從聊天回答走向規劃、跨 App 操作與真機驗證。本文整理 Qwen-UI-Agent、MobileWorld、MobilePA-Bench 與像素空間擴散研究,說明 benchmark 分數與量產手機體驗之間的差距。
「Bringing personal intelligence within everyone's reach. Personal intelligence is not just another chatbot in a widget; it is the organic fusion of a deliberative planning brain, versatile device-operating hands, and near-instant creative capability.
With Qwen Intelligence, we provide the open foundation for smartphones to evolve from passive command receivers into proactive, autonomous personal agents.」
—— 阿里巴巴通義實驗室(Tongyi Lab / Qwen Team),官方產品定位語句
很多人談到 AI 手機,想到的仍是摘要、修圖或語音問答。但真正難的問題是:手機能不能理解一個有條件、有順序、需要權限確認的任務,並在不同 App 之間把它完成?
例如:「幫我比對明天下午三點前去北京出差的高鐵與機票,挑選一千元以內最快抵達的班次,付款前讓我確認,並幫我預約好降落後的機場接送」。這不只是生成一句回答,而是要處理資料搜尋、條件篩選、跨 App 操作與付款前確認。
**個人智能(Personal Intelligence)**的重點,不只是聊天,而是讓系統能理解目標、規劃步驟、操作工具,並在高風險動作前把決定權交還給使用者。
本文把 **Qwen Intelligence(千問智能)**當成這條產品方向的總稱,並以目前可查證的 Qwen-UI-Agent、MobileWorld、MobilePA-Bench 與相關研究為主。這樣寫的好處是,讀者可以分清楚「官方已展示的模型與基準」和「未來可能整合到手機產品的想像」。
從公開資料來看,這個方向可以拆成三個能力面向,而不是一個已經在所有手機上完成整合的單一 App:
- 🧠 Mobile Planner Agent(任務規劃的大腦):處理目標拆解、工具順序、記憶與錯誤回饋。MobilePA-Bench 官方頁面目前列出 1,705 個評測任務、212 個工具與 13 類領域,測量 Tool Use、Memory、Skills 與 Sub-agent Collaboration。
- 🦾 Mobile-Use Agent(操作介面的雙手):Qwen-UI-Agent 採用 GUI 操作與結構化工具並行的路線。官方報告列出 MobileWorld 82.1%、MobileWorld-Real 92.2% 與 AndroidDaily 97.5%。這些是特定基準的結果,不是所有 App 都能達到的保證。
- 🎨 Mobile Creative Agent(研究中的創作方向):像素空間擴散研究提出 Latent-to-Pixel 路線,報告的是研究條件下 3.18 倍至 4.75 倍的端到端推論加速,不能直接等同於每支手機都能在 3 秒內出圖。
- 📊 評測與安全層:MobileWorld、MobilePA-Bench 與 MobileWorld-Real 各自量測不同問題。至於高風險操作,仍需要權限、確認、日誌與安全測試,不能只用一個 benchmark 分數代替。
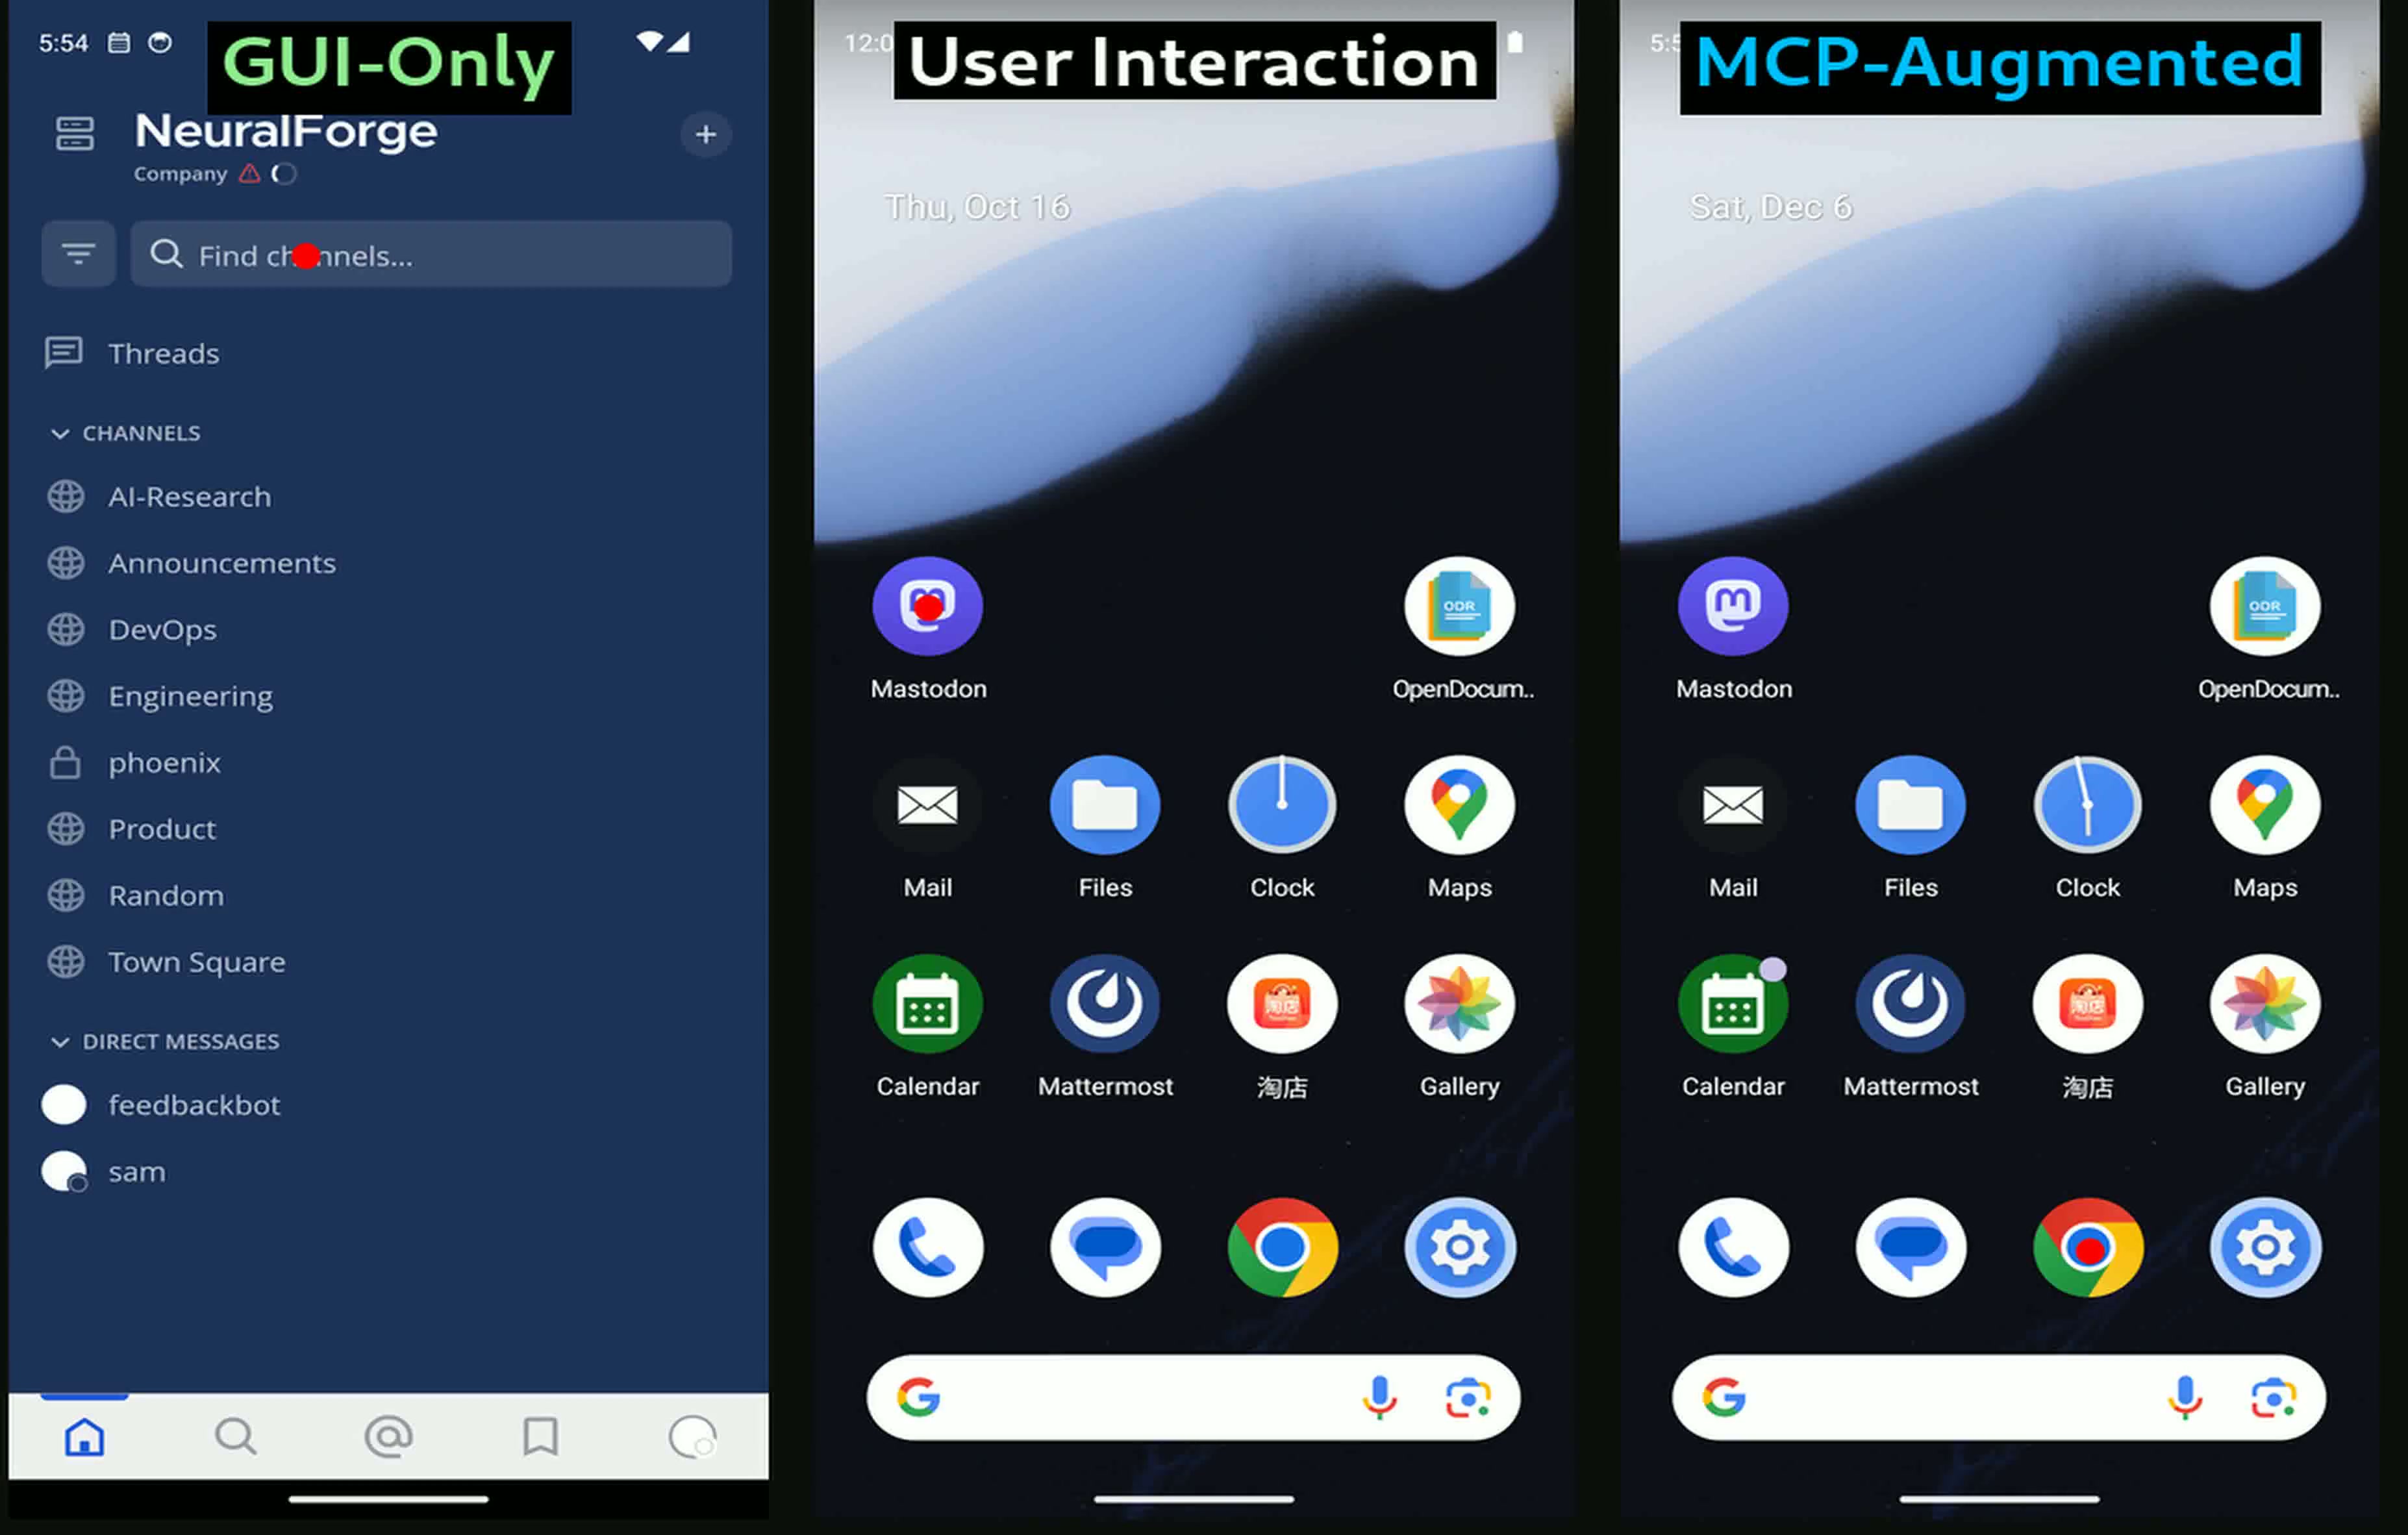
▲ MobileWorld 官方專案展示的移動 Agent 生態與任務方向。(來源:Tongyi MAI 官方專案)
至於 Qwen Intelligence 是否會以何種形式進入特定品牌手機,仍要看手機廠商的正式公告。本文不把尚未能由上述公開技術報告獨立確認的硬體合作、上市日期或系統整合,當成已完成的量產資訊。
接下來會依序回答三個問題:Planner 為什麼需要有狀態的評測?GUI Agent 如何在 API(讓軟體以結構化方式互相呼叫的介面)與畫面操作之間取捨?研究中的生圖加速,距離一般手機體驗還有多遠?
一、系統全景圖:手機 Agent 如何分工?
要理解 Qwen Intelligence 的革命性,必須先看清其整體的系統架構分工。
在過去,AI 系統往往試圖用「單一超大模型包山包海」:同一個模型既要讀懂使用者的模糊指令,又要去辨識螢幕上的像素按鈕座標,還要負責繪製精緻海報。這種架構在雲端伺服器上或許勉強可行,但一移入算力受限、電池供電、延遲極度敏感的手機終端時,便會瞬間遭遇崩潰——反應遲鈍、記憶混亂、耗電如流水。
公開資料呈現的是一種**「各司其職、分層閉環」**的 Agent 架構:規劃、操作與創作可以分開優化,再由執行層負責回傳狀態。
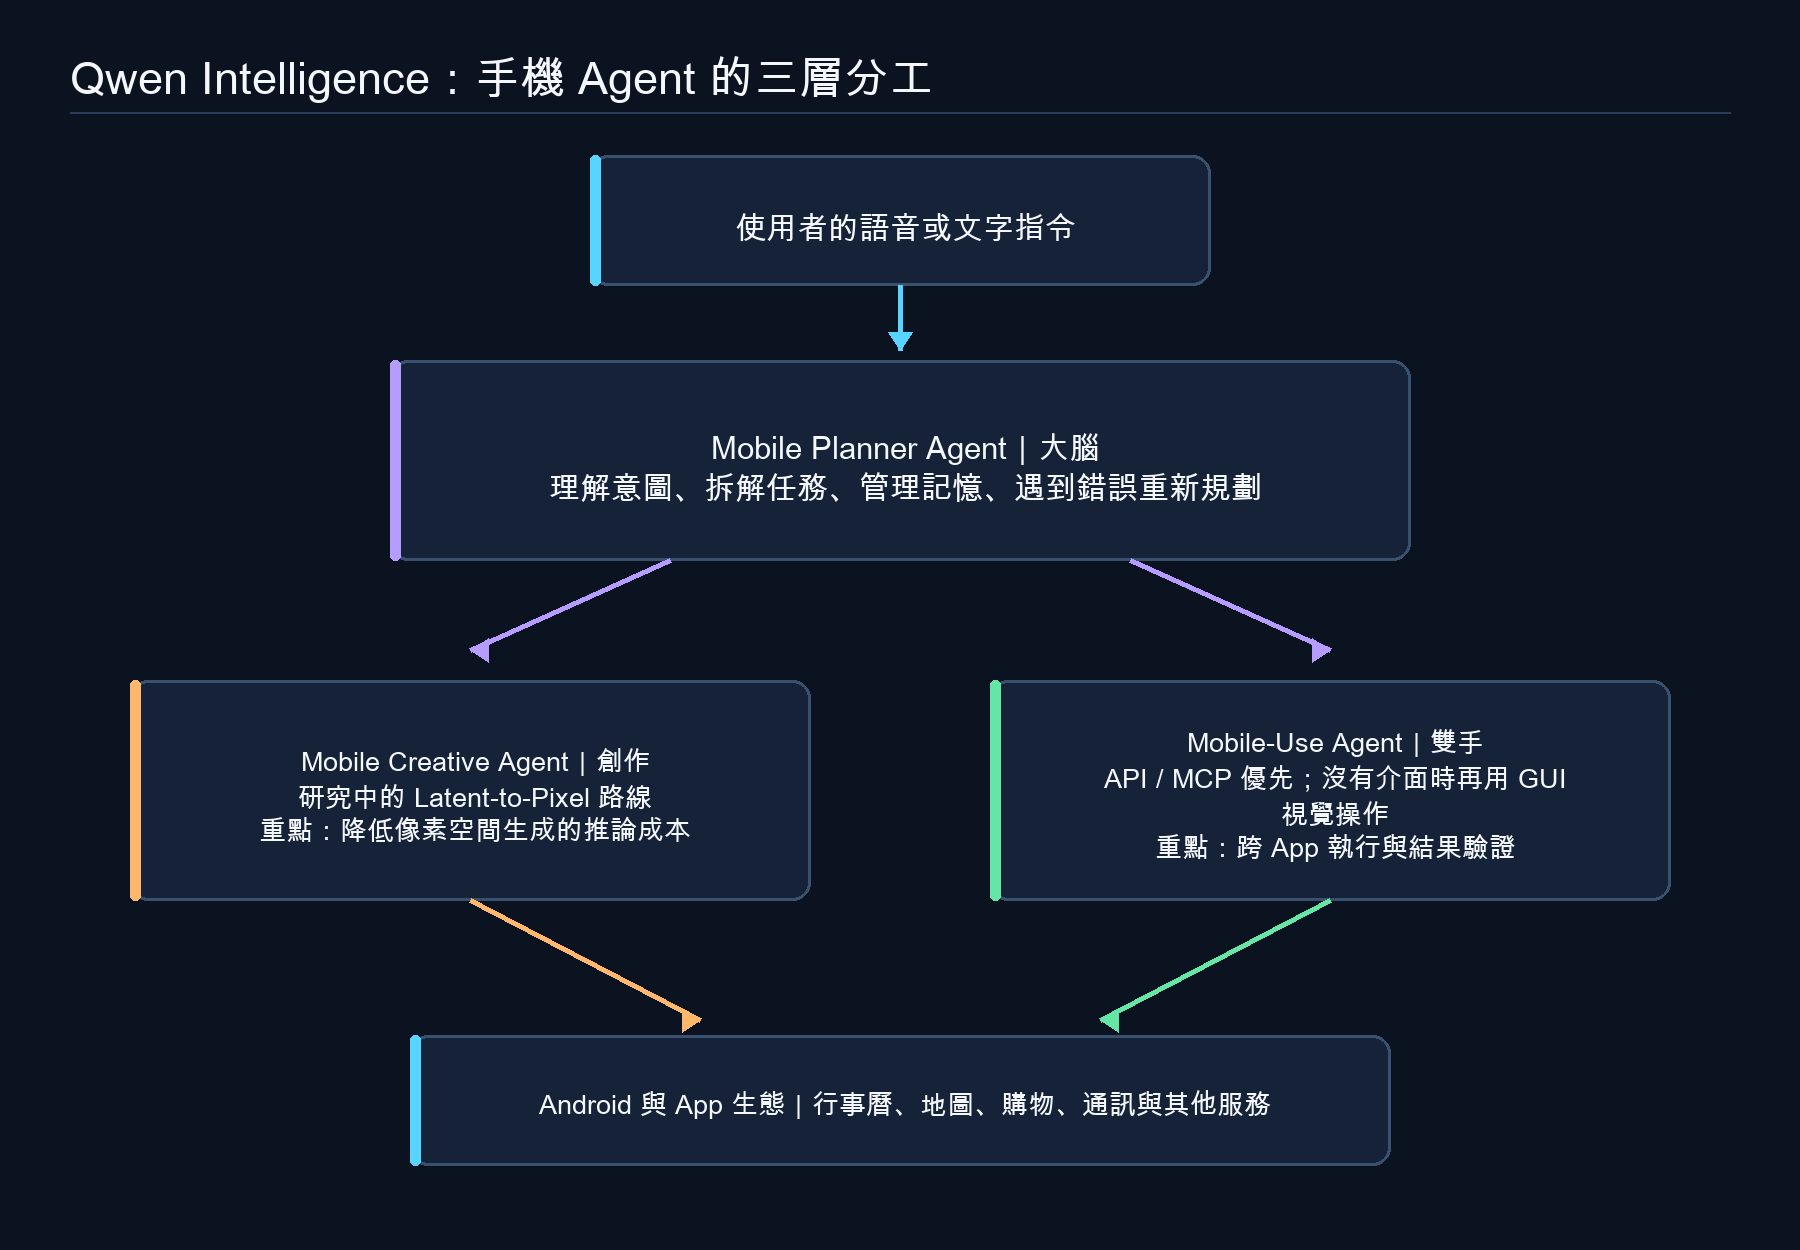
這套架構的核心精髓在於:
- 大腦不碰碎屑像素:Planner Agent 站在上帝視角,專注於邏輯推理、多步拆解與記憶回溯,不浪費算力去算螢幕按鈕座標。
- 雙手具備雙軌切換:Mobile-Use Agent 優先走輕量、精準、毫秒級的 API/MCP 管道。只有在遇到封閉 App 時,才調用視覺神經網路去點擊螢幕。
- 創作模組研究加速:像素空間研究提供降低推論成本的方向,但實際速度仍取決於模型、晶片與部署方式。
- 安全不能被省略:支付、刪除與個資操作需要權限分級、使用者確認與日誌,不能只靠模型自稱安全。
二、大腦剖析:Mobile Planner Agent 如何處理長程任務?
在移動終端上,真正困難的是**「理解一連串充滿相依性、帶有時間先後順序與權限約束的現實任務」**,而不只是點擊某個按鈕。
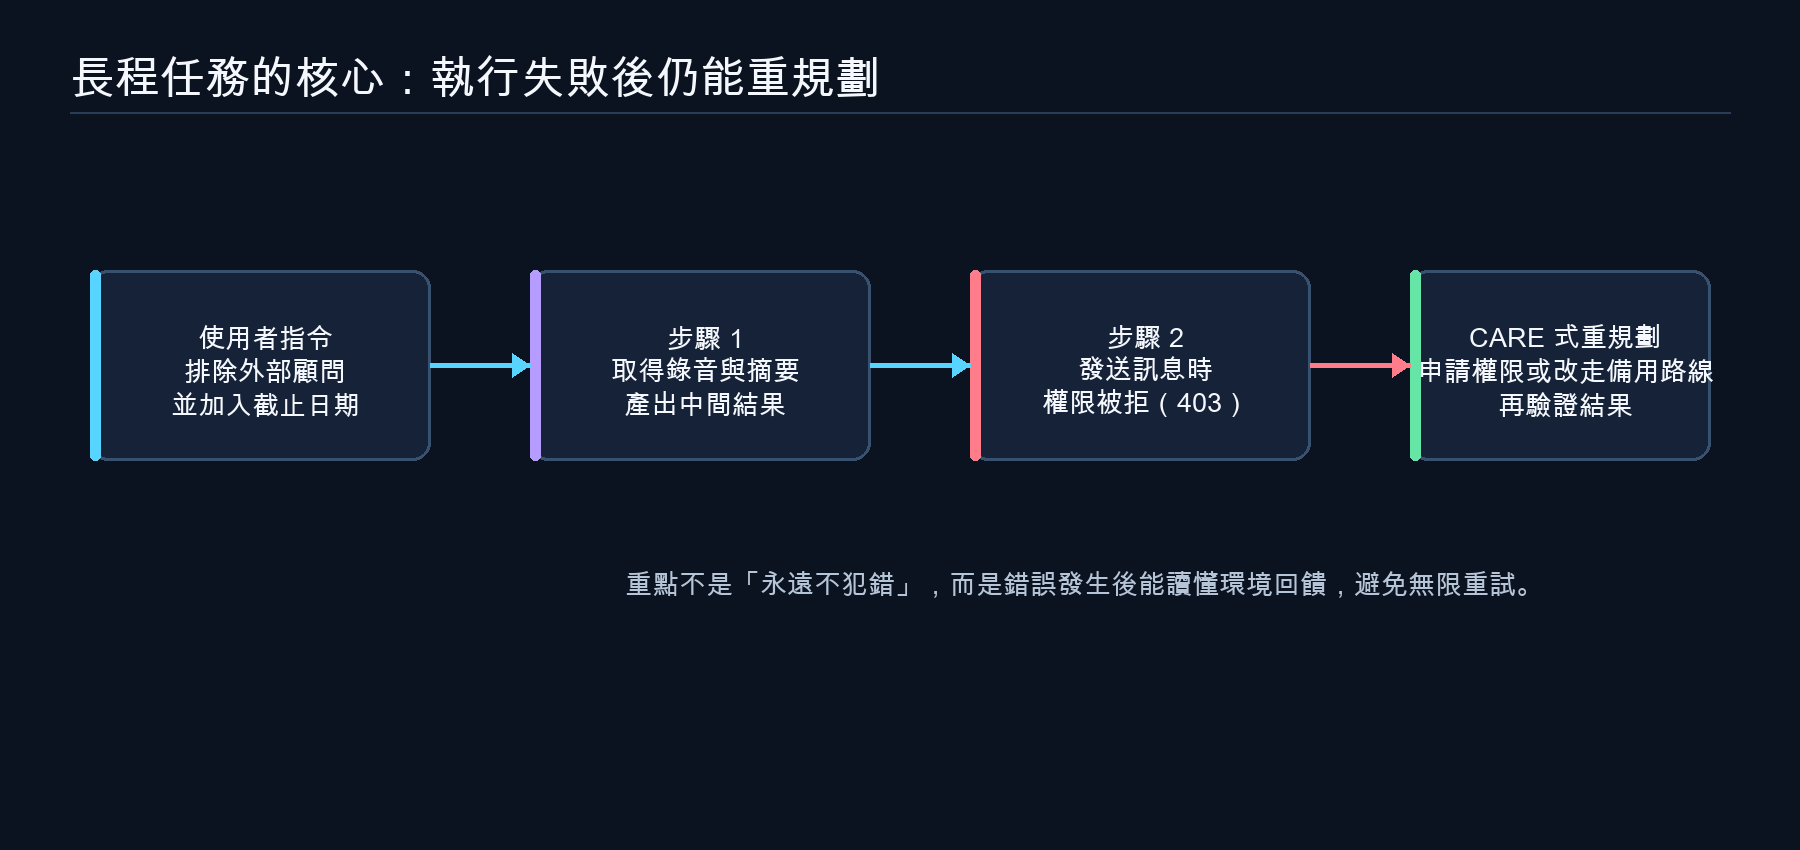
舉例來說,當使用者說:「把今天會議錄音的摘要發給專案群組,但排除外部顧問,並且把會議中提到的截止日期加入我的行事曆」—— 這項任務牽涉到:
- 取得錄音檔案並呼叫轉文字與摘要工具。
- 讀取通訊軟體群組成員名單,識別並過濾外部人員。
- 解析摘要中的具體日期時間,並與現有行程比對是否有衝突。
- 依序寫入行事曆並發送訊息。
只要中間任一步驟的參數錯誤、權限被拒或工具報錯,整個流程就會瞬間癱瘓。
1. 痛點診斷:為什麼手機 Agent 需要「有狀態」?
MobilePA-Bench 論文指出,手機任務不只是離線比對一次 API 呼叫。工具有先後依賴、權限會限制動作、每一步都可能改變 App 狀態,模型還要根據執行回饋調整下一步。這也是為什麼單看聊天能力,不能直接推論 Agent 能可靠完成手機工作。
- 無狀態幻覺(Stateless Amnesia):傳統 LLM 在多輪對話中容易忘記前面的約束條件(例如忘了「排除外部顧問」)。
- 忽視依賴前置條件(Prerequisite Blindness):在還沒取得會議文字前,就急著呼叫發送訊息 API。
- 報錯即當機(Brittle Error Recovery):一旦某個工具回傳
403 Permission Denied或網路超時,模型不知所措,陷入無限重複調用的死循環。
2. MobilePA-Bench 真正測量什麼?
MobilePA-Bench 的價值,不在於替所有手機 Agent 排一個永遠不變的名次,而在於把「工具能不能正確執行」拆成可觀察的能力。官方頁面列出的四個面向,剛好對應長程任務最容易出錯的地方:
① Tool Use:工具真的被正確執行
評測同時檢查模型是否選對工具、參數是否落地、前置條件是否滿足,以及環境最後是否進入正確狀態。
② Memory:能不能用到持久脈絡
如果使用者先前交代過偏好或限制,Agent 必須在後續任務中正確取用。這比單純把歷史對話塞回上下文更接近實際產品需求。
③ Skills 與 Sub-agent Collaboration:能不能把複雜工作拆開
複合技能與子代理協作,讓系統不必每次從零開始規劃。但它們也增加了權限、交接與錯誤回溯的複雜度,因此需要把執行證據一起納入評測。
3. MobilePA-Bench 的規模,為什麼比單一分數更重要?
官方頁面目前列出 1,705 個評測任務、212 個工具、13 類功能領域。它不只看模型在固定 demo 裡能不能點對,也觀察模型在持續變動的狀態、工具依賴與權限限制下,能不能把任務完成。
| 官方量測面向 | 它在回答什麼問題? | 對產品代表什麼? |
|---|---|---|
| Tool Use | 工具與參數是否正確,最後狀態是否完成? | 能不能真的做事,而不是只會說明步驟。 |
| Memory | 能否使用使用者偏好與歷史脈絡? | 能不能少問幾次,又不誤用舊資訊。 |
| Skills | 能否調用可重用的複合程序? | 能否把常見工作包成穩定流程。 |
| Sub-agent Collaboration | 能否拆工、交接並保留上下文? | 多代理協作是否增加可控性,而不是增加黑盒錯誤。 |
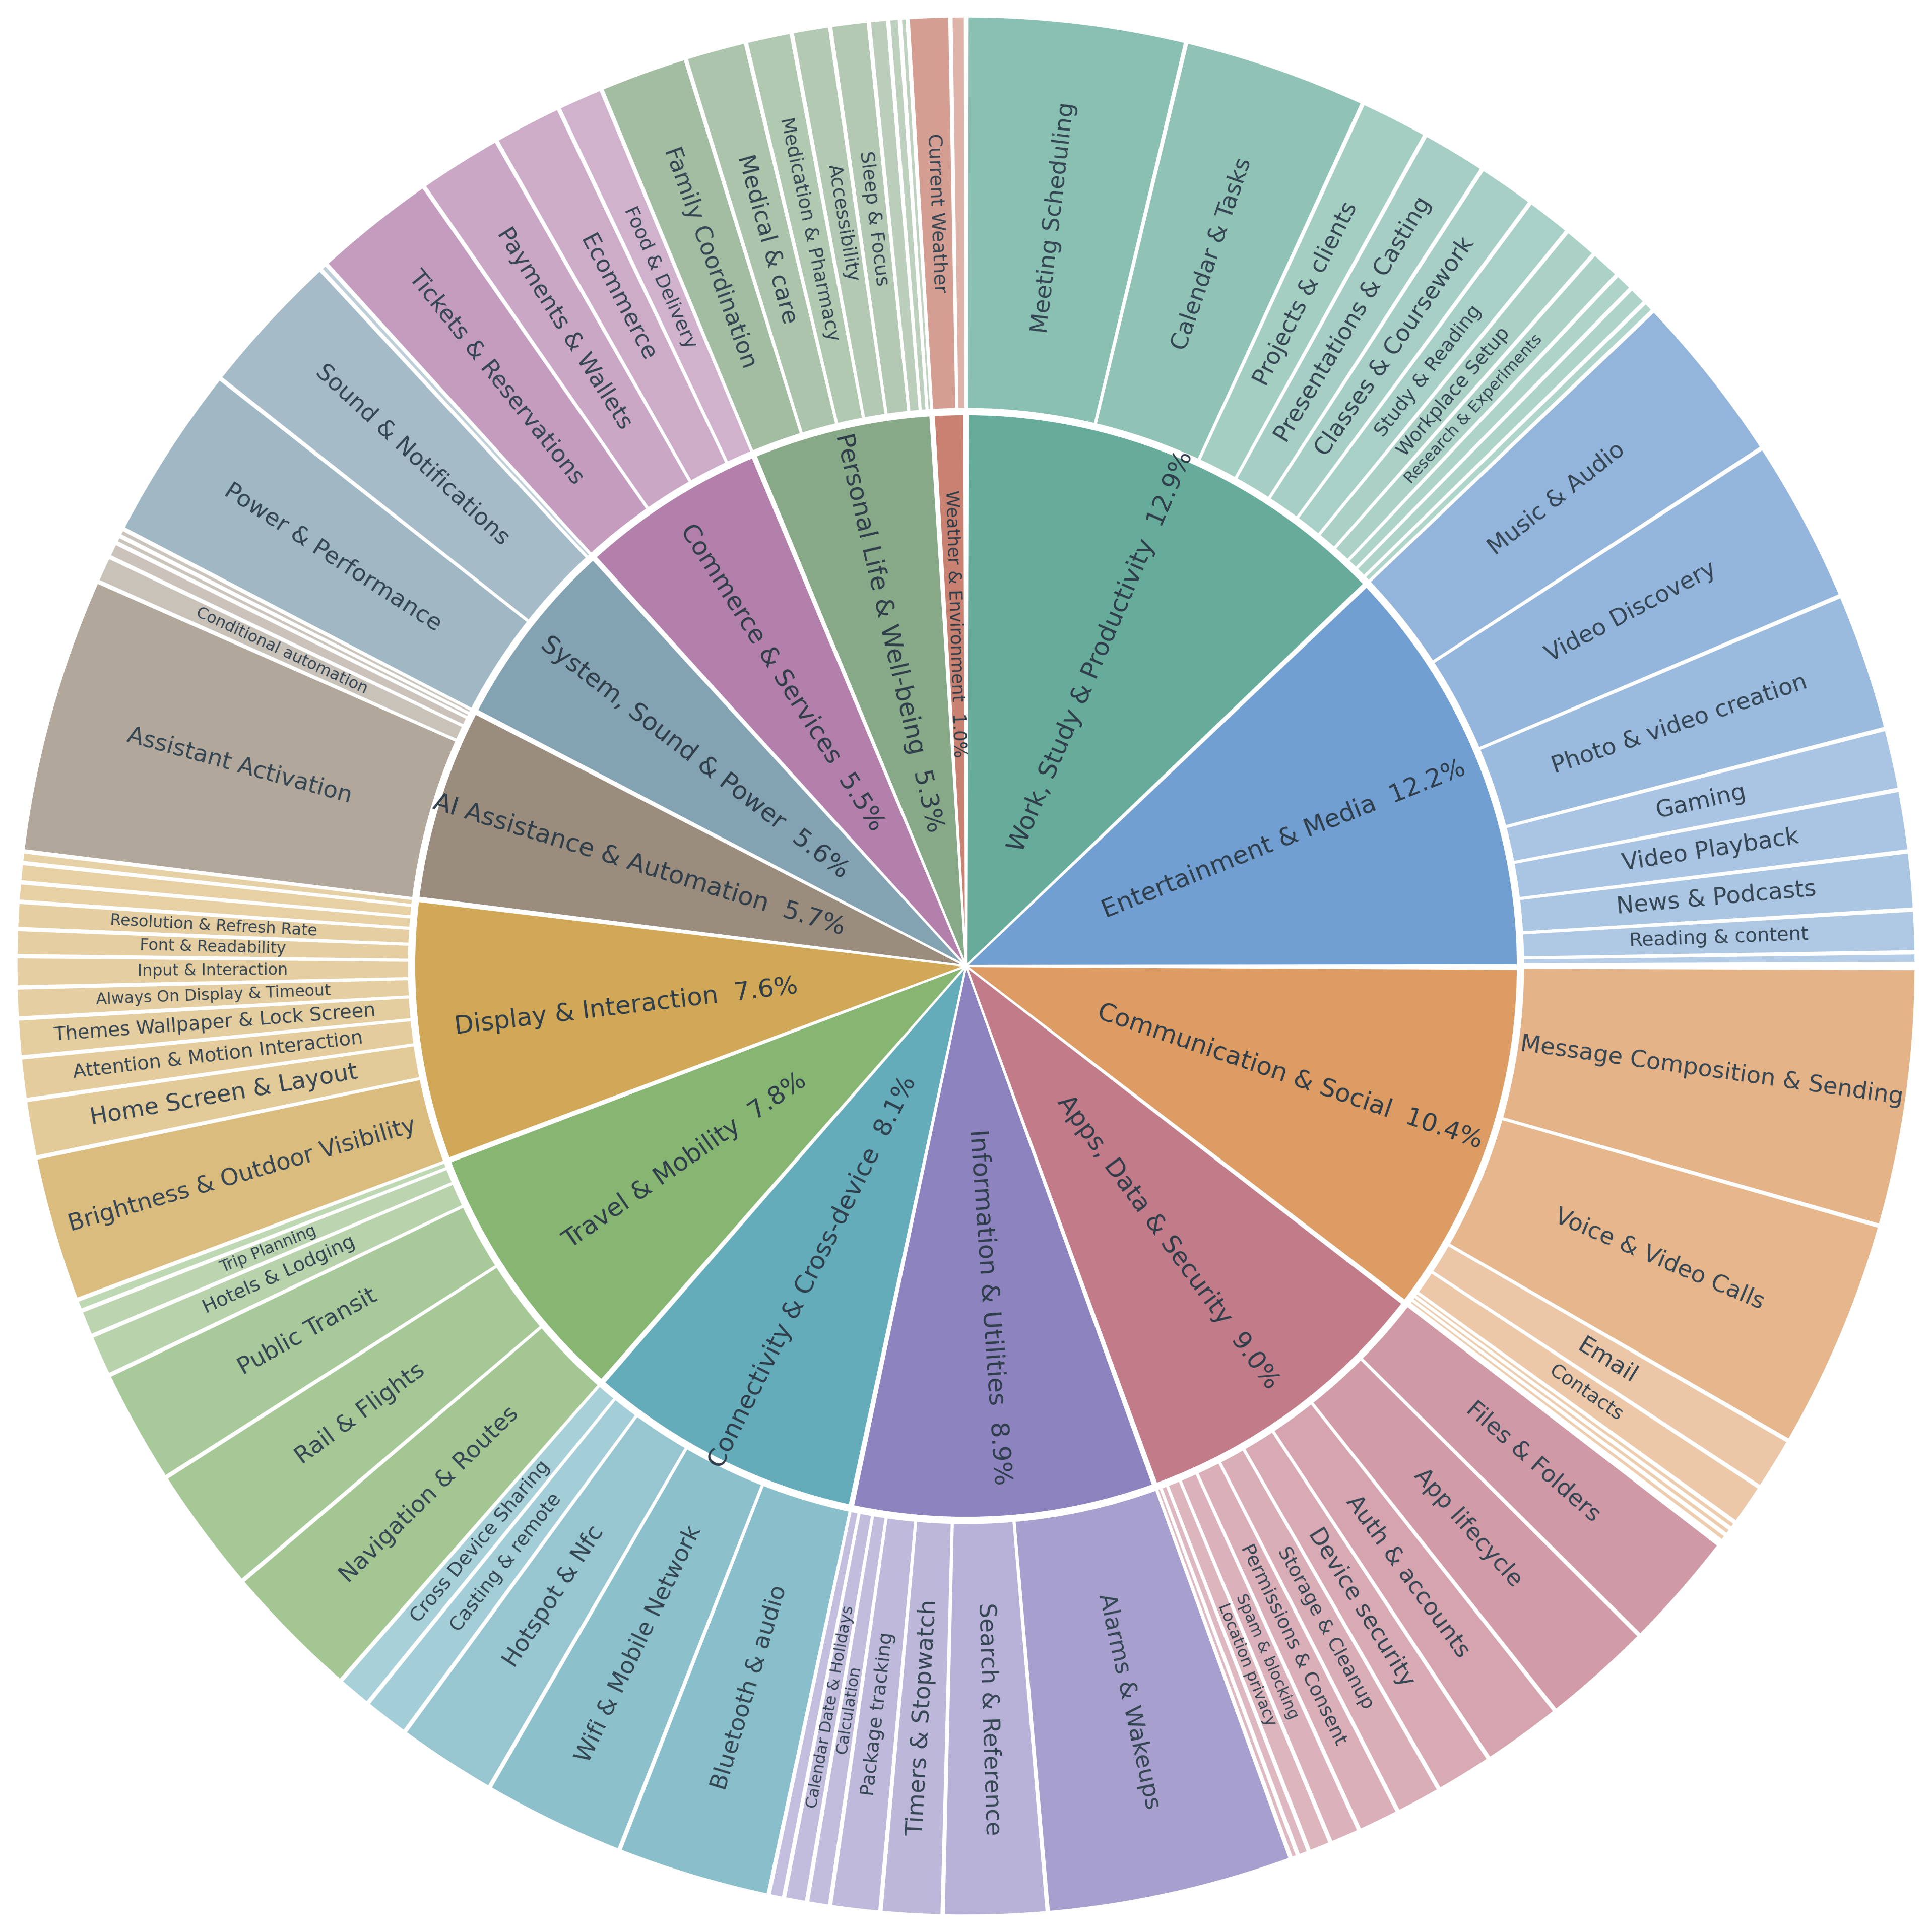
讀者要記得: benchmark 分數只能說明特定任務、工具與評測設定下的表現。要把它變成可用的手機產品,還要另外驗證延遲、耗電、權限、隱私、失敗回復與使用者確認流程。
三、雙手揭密:Mobile-Use Agent 的「API-First with GUI Fallback」革命
如果說 Mobile Planner Agent 是調兵遣將的大腦,那麼 Mobile-Use Agent(Qwen-UI-Agent) 就是穿針引線的雙手。
在端側 AI 的演進歷史上,工程界始終存在兩派路線的激烈鬥爭:
- 純 API 派:主張所有操作必須透過廠商開放的 SDK 或 API 執行。優點是速度極快(毫秒級)、穩定性高。缺點是現實世界中 90% 的 App 根本沒有公開 API,更不願開放底層資料庫,導致實用性極低。
- 純 GUI 視覺派(如傳統 Computer Use / OSWorld 代理):主張模型只看螢幕截圖,像人一樣用滑鼠點擊或觸控。優點是泛用性強。但缺點是慢、卡、耗電、易受動效干擾。螢幕上只要彈出一個廣告或 App 改版,純視覺點擊的成功率就會斷崖式暴跌。
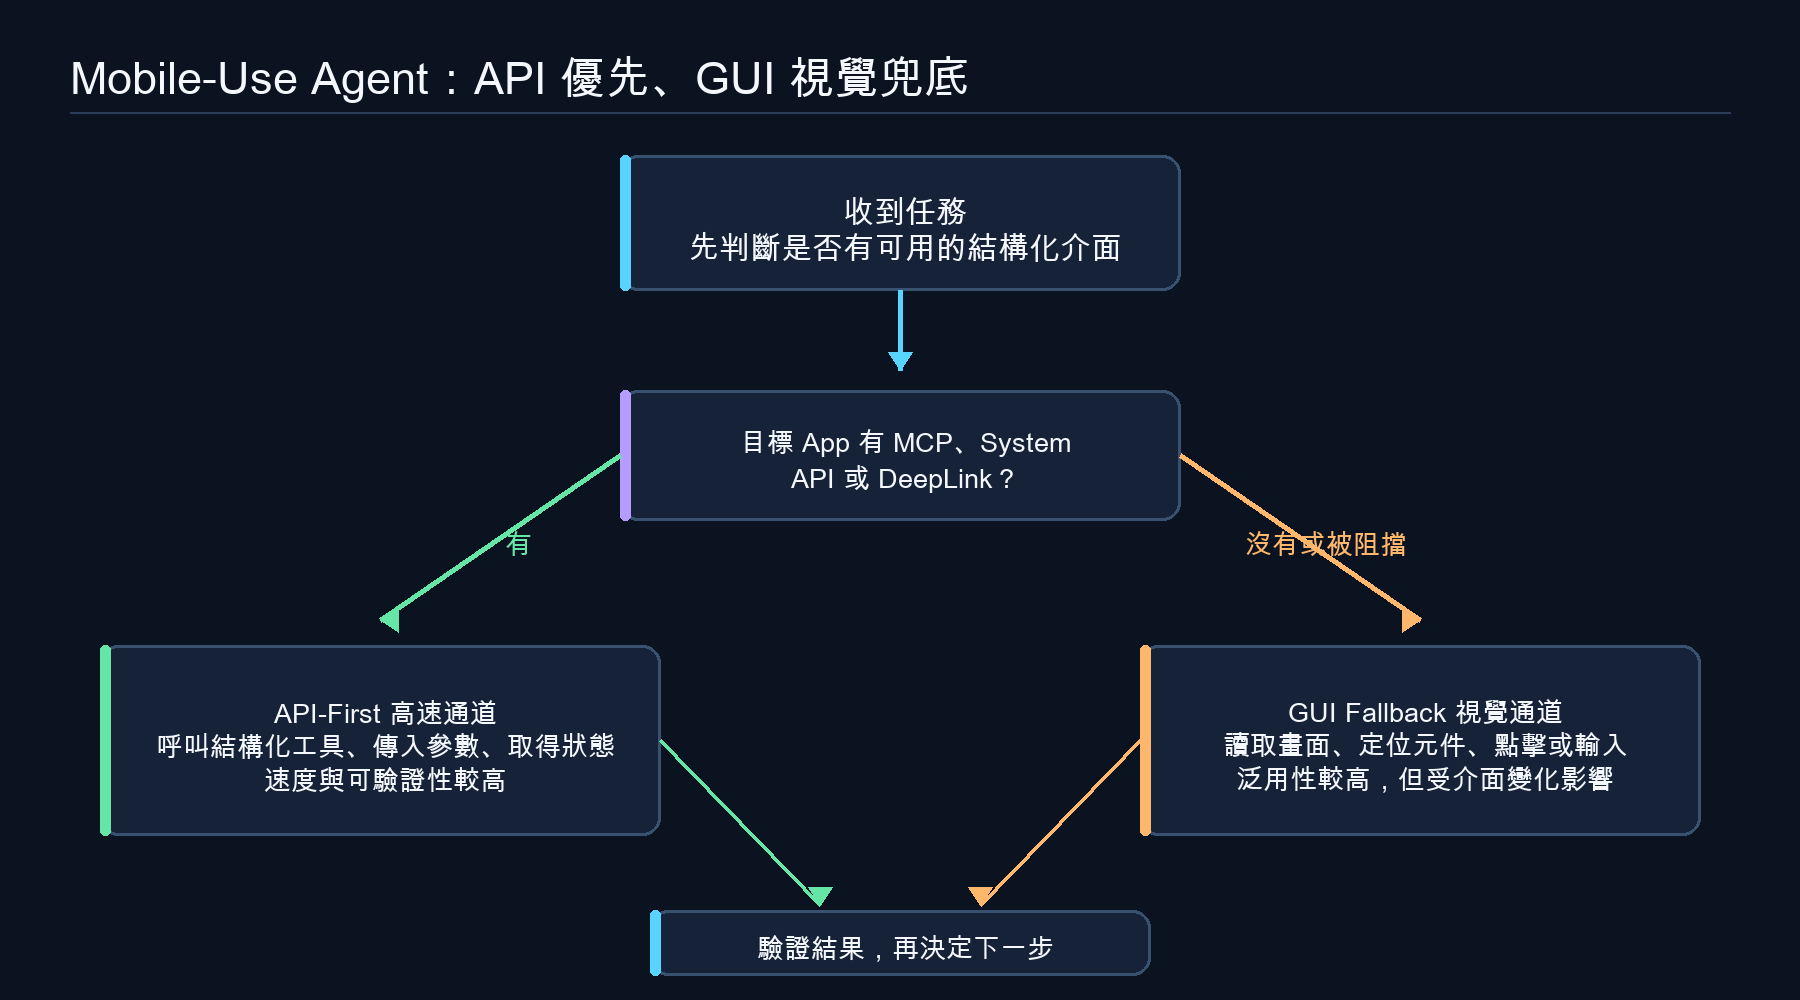
1. 殺手鐧哲學:API-First with GUI Fallback
Qwen-UI-Agent(基於阿里 Tongyi-MAI 團隊最新技術報告 arXiv:2607.28227)給出了當前產業界最優雅的解答:API 優先,GUI 視覺兜底!
什麼叫「API-First」?
當系統需要設定鬧鐘、查詢日曆,或呼叫支援 MCP(Model Context Protocol,讓模型以標準格式使用外部工具的協定) 的服務時,API 路線可以直接交換結構化資料,通常比讀取截圖再點擊更容易驗證。但「有 API」不代表結果必然正確,權限與回傳狀態仍要檢查。
什麼叫「GUI Fallback」?
當使用者要求 Agent 操作沒有對外 API 的第三方 App,例如地方停車繳費或專屬訂餐軟體,GUI Fallback 才會派上用場:
- Mobile-Use Agent 立刻啟動多模態視覺編碼器。
- 螢幕畫面被分割為高維幾何特徵,模型結合自然語言目標與 UI 視覺特徵進行 ScreenSpot Grounding(元素定位)。
- 自動發送 Android 觸控事件(Tap、Scroll、Drag、Input),並在每一步後讀取畫面確認狀態。
2. 從模擬器走向真機,難點在哪裡?
許多 GUI Agent 在模擬器中表現不錯,但真機還要面對: 因為真實手機上有:網路延遲波動、App 開屏跳轉廣告、動態權限彈窗、鍵盤彈起遮擋、滑動慣性殘影。
Qwen-UI-Agent 官方資料描述了超過 100 台真實 Android 手機、150+ 款 App 的真機訓練與評測環境,也展示超過 100 步的長程工作流。這證明測試範圍比單一模擬器更接近現實,但不等於每個 App、每種網路與每個帳號狀態都能得到相同結果。
▲ Qwen-UI-Agent 官方高畫質真機實測:展示自主跨 App 搜尋、預算比價、規格篩選與確認授權工作流。(來源:Qwen-UI-Agent 官方展示)
3. 三個基準分數,應該怎麼讀?
Qwen-UI-Agent 官方頁面列出以下結果。它們是不同測試集的成功率,不能合併成單一的「手機可靠度」:
- MobileWorld(跨 App 長程綜合基準):82.1%
(對比:Claude Opus 4.7 僅為 56.4%,GPT-5.6 Sol 僅為 70.1%,Kimi-K3 為 74.4%)。 - MobileWorld-Real(100+ 真實物理手機實測):92.2%
徹底打破「學術模型無法在真機上落地」的魔咒。 - AndroidDaily(日常高頻應用基準):97.5%
這代表該測試設定下的任務成功率很高,但仍需注意任務範圍、帳號狀態與評測方法。

四、像素空間生圖研究:為什麼 Latent-to-Pixel 值得注意?
在手機端生成高解析度圖片,通常要在畫質、速度、記憶體與耗電之間取捨:
- 開啟生圖 App,手機瞬間發燙。
- 螢幕上的進度條緩慢爬行,往往需要等待 10 秒、15 秒甚至 30 秒。
- 巨大的計算量把手機電池直接榨乾。
所以研究者一直在找更有效率的推論路線,但研究結果不應直接包裝成所有手機都能達成的固定秒數。
1. 科研突破:揭密像素空間擴散模型(arXiv:2608.16887)
這篇研究探討如何降低像素空間模型的訓練與推論成本: 《An Empirical Study of Training Pixel-Space Text-to-Image Diffusion Models》(像素空間文字生圖擴散模型經驗研究,arXiv:2608.16887)。
問題可以簡化成一句話:模型應該先在壓縮的潛空間(Latent Space)學習,再轉到像素空間(Pixel Space),還是從頭到尾都在像素空間訓練?
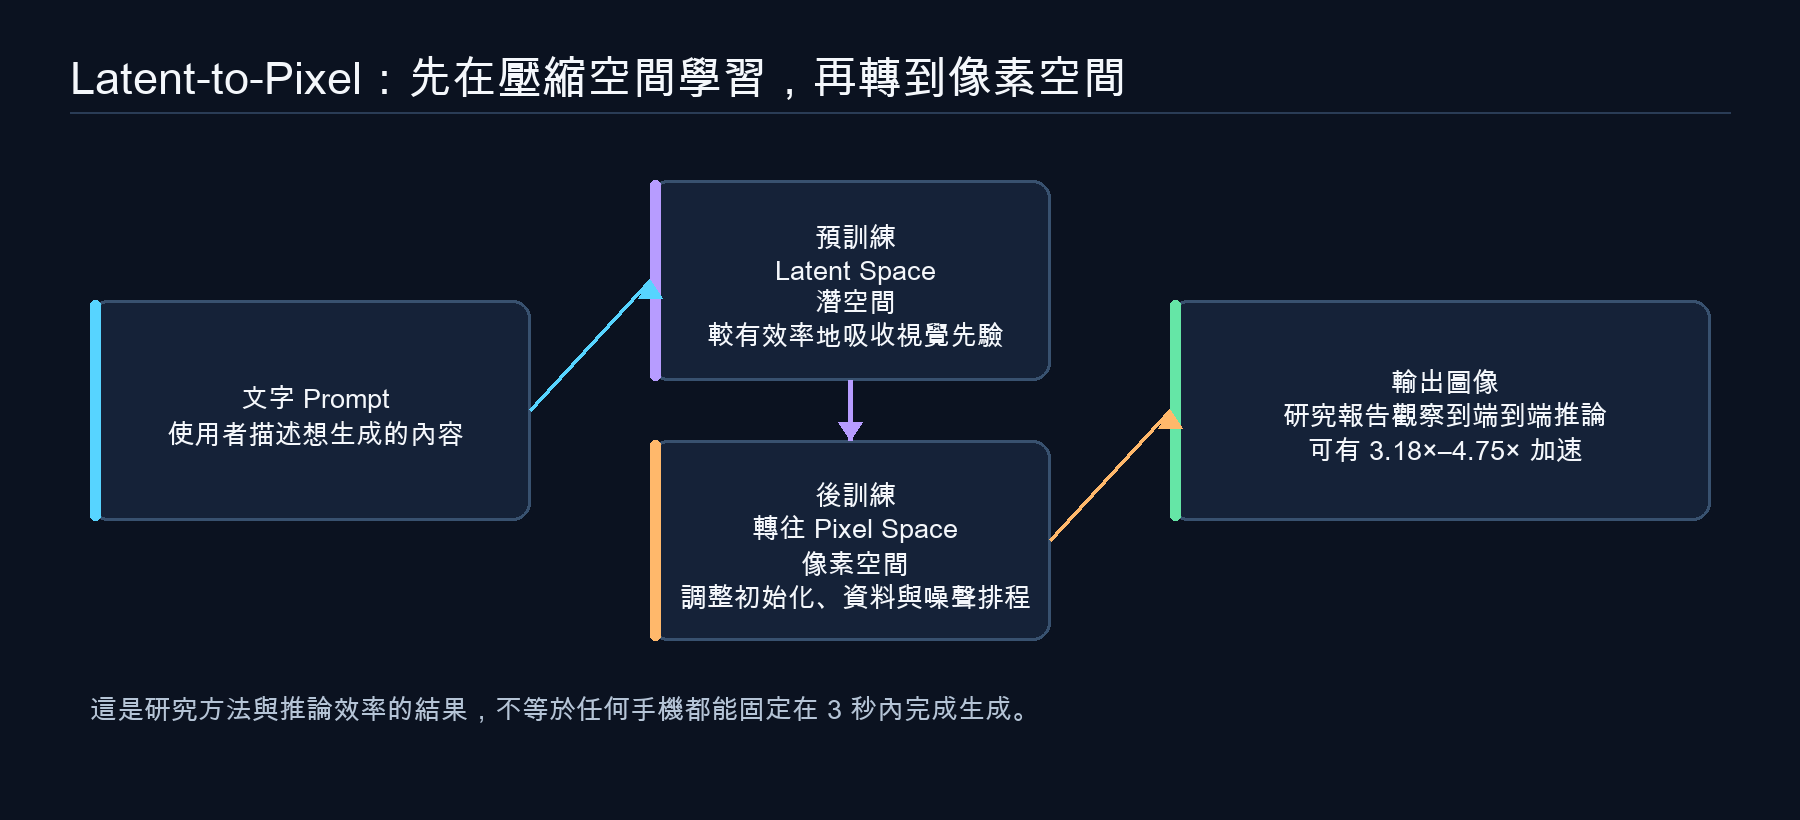
研究團隊發現:
- 如果一開始就直接在像素空間從頭預訓練(Pre-training),模型的收斂速度極其緩慢,且需要海量的算力。
- 但如果一直留在潛空間,模型在手機終端推論時,就必須承擔巨大的 VAE(變分自編碼器)特徵解碼與高頻噪聲計算開銷。
2. Latent-to-Pixel 轉移架構:3.18x ~ 4.75x 推論加速
基於這一洞察,阿里團隊提出了一套精妙的**「Latent-to-Pixel」過渡工程配方**:
- 先在潛空間吸取先驗:在預訓練初期,利用潛空間的高效壓縮特性,讓模型快速掌握世界視覺規律、構圖語法與實體特徵。
- 後訓練平滑過渡至像素空間:在 Post-training 階段,重新設計權重初始化(Weight Initialization)、調整數據混合配比(Data Composition)、重構預測目標(Prediction Target)與噪聲排程(Noise Schedule),將潛空間獲得的深層表徵無縫「移植」至像素空間。
- 優化解碼管線:在推論階段徹底拋棄繁重的去噪迭代循環。
3. 這項研究對手機產品有什麼意義?
論文報告的重點是:像素空間模型若採用合適的轉移與後訓練設計,端到端推論可取得 3.18 倍至 4.75 倍的加速。對手機產品來說,這可能降低等待時間或硬體負擔。但實際速度仍取決於模型大小、解析度、晶片、記憶體、是否走雲端,以及產品採用的整套推論流程。
因此,「研究上有 3.18 倍至 4.75 倍加速」和「任何手機都能 3 秒出圖」是兩個不同命題,文章不把它們混為一談。
五、手機 Agent 的評測:規劃、跨 App、真機與安全要分開看
一個產業要真正成熟,關鍵在於是否有一套公平、嚴密、可復現的度量衡體系,而不只是某家公司宣稱自己有多強。評測的價值,是把能力與限制攤在讀者面前。
過去在手機 Agent 領域,各家評測標準混亂不堪:有的拿玩具般的網頁點擊充數,有的在單機模擬器裡作弊,還有的刻意避開真實使用者的權限隱私問題。
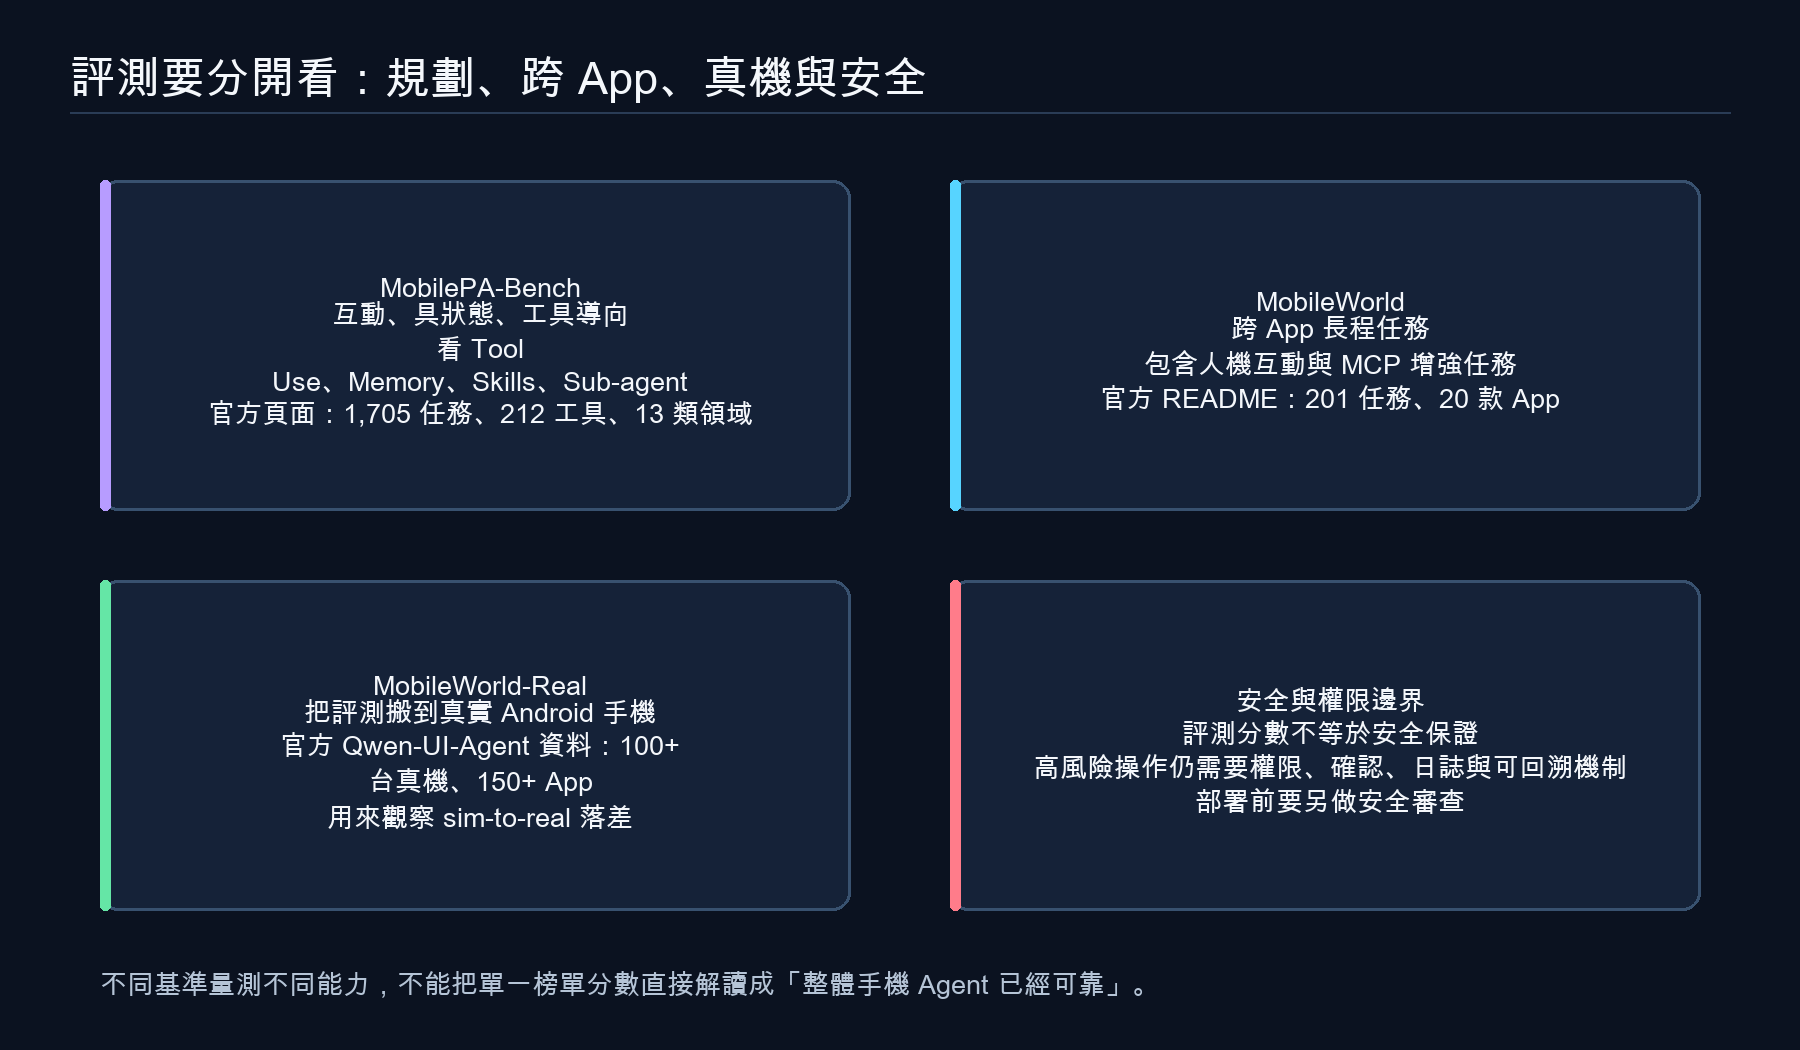
目前公開資料可以確認幾個互補的評測方向:MobilePA-Bench 看有狀態的工具規劃,MobileWorld 看跨 App 長程任務,MobileWorld-Real 把測試放到真實手機。安全與權限則應視為另一條部署前的驗證線,而不是用單一分數取代。
1. MobilePA-Bench:有狀態工具規劃的試金石
- 官方入口:
https://tongyi-mai.github.io/MobilePA-Bench/ - 特色:專注於考察 Agent 作為「大腦」的規劃能力。官方頁面列出 1,705 個評測任務、212 款工具、13 類功能領域,並以互動環境回傳狀態與證據。
- 評估維度:
- Tool Use:參數正確性、先決條件判斷。
- Memory:跨輪次歷史記憶維持、隱式意圖挖掘。
- Skills:複合技能封裝調用。
- Sub-agent Collaboration:多智能體分工協同。
2. MobileWorld:真實複雜長程跨 App 考場
- 官方入口:
https://github.com/Tongyi-MAI/MobileWorld - 特色:收錄 201 個精心挑選的高難度任務,涵蓋 20 款日常主流 App。徹底淘汰了「單步點擊」的初級測試,全面引入長程推理(Long-horizon)、跨 App 連續跳轉、以及全新的 Agent-User Interaction(動態人機對話詢問) 與 MCP-Augmented Tasks(MCP 增強工具調用)。
- 具備完整的 Arena 雙模型對抗競技場,開發者可並排回放兩款 Agent 在相同任務下的執行軌跡、思考日誌與螢幕截圖。

3. MobileWorld-Real:把評測搬到真機
- 特色:由超過 100 台真實物理 Android 手機組成的實體測試集群。
- 它用來觀察 Agent 在網路波動、系統彈窗與硬體差異下的表現,但通過真機 benchmark 仍不等於完成商業量產驗證。
4. 安全與權限:不能用一個分數代替
- 面對提示詞注入、偽造介面、未授權支付或個資外傳,產品需要權限分級、使用者確認、操作日誌與可回溯的失敗處理。本文把這些視為部署要求,不把它們寫成已由單一公開 benchmark 證明的保證。

六、巨頭交鋒:四大主流個人智能方案橫向評測
若要比較不同公司的 Agent,應先承認它們的測試環境、權限模型與產品階段不一定相同。下面的表格只提供架構方向,不把各家數字當成同一場考試的直接排名。我們將 Qwen Intelligence 的公開方向,與蘋果的 Apple Intelligence、Google 的 Android Agent,以及 Anthropic 的 Computer Use 放在同一張圖上理解:
| 評比維度 | 公開 Qwen Agent 方向 | Apple Intelligence | Google Android Agent | Anthropic Computer Use |
|---|---|---|---|---|
| 核心架構 | Planner、GUI 操作與研究中的創作路線 | Siri 語意增強 + 端雲混合私有雲 | Gemini Live + 端側 Nano | 單一模型視覺操作 (Claude) |
| 動作空間策略 | API-First with GUI Fallback (兼顧極速與泛用性) |
純 App Intents / API 綁定 (無 GUI 視覺兜底) |
逐步轉向視覺 + API (探索階段) |
純 GUI 視覺模擬 (依賴截圖與游標) |
| 跨 App 長程執行 | Qwen-UI-Agent 官方資料含 100+ 步工作流。MobileWorld 82.1% | 依功能與開發者支援度而異 | 依功能與支援範圍而異 | 主要針對桌面 PC |
| 端到端閉環成功率 | MobileWorld-Real 92.2%(特定評測設定) | 依功能與裝置而異 | 依功能與裝置而異 | 依部署方式而異 |
| 創作生圖速度 | 研究中的 Latent-to-Pixel 路線。論文報告 3.18×–4.75× 加速 | 依功能與裝置而異 | 依功能與裝置而異 | 無原生端側即時生圖 |
| 安全隱私機制 | 需要權限分級、使用者確認與日誌。不能以 benchmark 代替 | Private Cloud Compute 等官方架構 | Android 原生安全與權限機制 | 依部署方式而異 |
| 開源度與生態 | 公開技術報告與評測專案。實際裝置整合仍看廠商 | 封閉生態 | Android 生態與官方支援範圍 | 依產品與 API 授權而異 |
戰略總結:
- Apple Intelligence 的優勢在於封閉生態的軟硬整合與私有雲安全,但實際能力仍取決於功能開放範圍與 App Intents 支援度。
- Anthropic Computer Use 主要展示桌面視覺操作能力,手機端的延遲、能耗與權限模型仍需另外評估。
- 公開 Qwen Agent 方向 同時探索規劃、工具與 GUI 操作,但能否進入更多 Android 裝置,仍取決於廠商整合、權限設計與商業部署。
七、從 benchmark 到手機產品,還差哪三關?
官方 Qwen-UI-Agent 已展示真機移動任務,阿里雲的 Agentic Mobile 文件也描述了在雲端 Android 容器中以 Qwen 驅動跨 App 任務的產品路線。這些資料說明「手機 Agent」不只存在於論文,但距離每一支消費型手機都能穩定使用,還有三道關卡:
- 權限與確認:查詢天氣和付款不能使用同一套放行規則。Agent 要讓使用者知道目前做了什麼,也要在支付、刪除、修改密碼等動作前停下來。
- 延遲與成本:GUI 讀圖、工具呼叫、雲端推論與網路傳輸各自增加延遲。benchmark 的成功率高,不代表日常使用一定夠快或夠省電。
- App 整合與失敗回復:API 能讓操作更穩定,但需要 App 或平台提供介面。沒有介面時靠 GUI 兜底,則必須處理改版、彈窗、登入狀態與錯誤回滾。
這三關也解釋了為什麼「模型跑分很高」和「手機用起來可靠」必須分開報告。真正的產品競爭,不只是誰能點到按鈕,而是誰能在權限、延遲、成本和失敗時仍然讓使用者掌握決定權。
八、常見問題 FAQ:Qwen Intelligence 與手機 Agent
Q1:Qwen Intelligence 與我現在手機裡裝的「通義千問 App」有什麼差別?
通義千問 App 主要是對話與內容生成入口。手機 Agent 則要再加上工具、權限、狀態管理與執行回饋,才有機會跨 App 完成任務。Qwen Intelligence 這個名稱對應的具體產品形態與裝置整合,仍應以官方產品公告為準,不能只靠概念圖推定。
Q2:為什麼「API 優先、GUI 視覺兜底」這麼重要?全用視覺點擊不好嗎?
純視覺點擊存在嚴重的工程瓶頸:
- 耗電與發燙:視覺模型每看一張截圖就要跑一次龐大的神經網路,連續點擊 10 步,手機 NPU/GPU 就會持續滿載,電池迅速見底。
- 易受干擾:App 只要跳出一個雙十一促銷彈窗,或者網路卡頓加載慢了半秒,純視覺模型就容易點錯或迷航。 「API 優先」通常較容易驗證與控管。「GUI 兜底」則擴大可操作的 App 範圍,但更容易受到介面改版、彈窗與登入狀態影響。兩者是工程取捨,不是任何情境都保證成功的唯一解法。
Q3:Mobile-Use Agent 可以在我手機上點擊操作,會不會偷偷幫我轉帳或洩漏個人隱私?
不能只因為模型有安全宣稱,就直接假設「絕對不會」。可靠的產品應該把操作分級,並把高風險動作交給使用者確認:
- 安全操作(Low-risk):如查詢天氣、設定鬧鐘、開啟導航,Agent 可自主執行。
- 高危操作(High-risk):涉及資金支付、銀行轉帳、修改密碼、刪除檔案或上傳個資時,應要求使用者明確確認,並留下可追溯的操作紀錄。
Q4:Mobile Creative Agent 號稱 3 秒出圖,是純手機本地跑的、還是走雲端算力?
arXiv:2608.16887 談的是像素空間擴散模型的訓練與推論效率,論文的 3.18 倍至 4.75 倍是研究條件下的加速結果。它不能直接回答某個商用 App 是純端側、端雲協同,或固定幾秒完成。這些要看實際產品架構與裝置規格。
Q5:其他品牌的手機能用上嗎?
要看品牌是否整合對應的 Agent、權限層與工具介面。公開 benchmark 或開源程式碼可以降低開發門檻,但不等於任何品牌都能直接把完整能力搬進手機。具體支援型號與上市時間,仍要等待廠商公告。
九、結語:手機 Agent 的關鍵,不只是會操作
Qwen Intelligence 所代表的方向值得注意,但目前較可靠的結論是:手機 Agent 的工程問題正在被拆開測量。MobilePA-Bench 看規劃與工具,MobileWorld 看跨 App 長程任務,Qwen-UI-Agent 則把 GUI 能力帶到真機與更多工作流。
這些成果說明,未來的手機助理可能不只回答問題,也能在取得權限與使用者確認後代為執行。但要從 benchmark 走到日常產品,還必須持續解決延遲、耗電、App 相容性、隱私、錯誤回復與高風險操作控管。
一般使用者更該觀察的是 Agent 能不能清楚告訴你它要做什麼、在關鍵步驟停下來詢問,並在失敗後留下可理解的原因,而不只是宣傳中的「幾秒完成」。這才是個人智能從 demo 走向可靠工具的分水嶺。
相關文獻與官方資源彙整
- Qwen Intelligence 官方門戶:https://qwenintelligence.com
- Mobile-Use Agent(Qwen-UI-Agent)技術報告:https://tongyi-mai.github.io/Qwen-UI-Agent/
- MobilePA-Bench 評測基準與論文:https://tongyi-mai.github.io/MobilePA-Bench/(arXiv:2608.23035)
- Mobile Creative Agent 核心論文:《An Empirical Study of Training Pixel-Space Text-to-Image Diffusion Models》(arXiv:2608.16887)
- MobileWorld 官方儲存庫與 Arena 競技場:https://github.com/Tongyi-MAI/MobileWorld 與 Leaderboard