Atria Dawn Preview 是什麼?744B 開放權重 AI Agent,功能、評測、限制與使用方式
Atria Dawn Preview 以 744B MoE GLM-5.2 為基礎,強調把研究、工具操作、失敗修正與外部驗證串成完整工作流程。
Atria Dawn Preview 不是另一個只把問題回答得更漂亮的聊天模型。它鎖定的是更麻煩的工作:查資料、寫程式、操作工具、跑實驗、看到失敗後修正,最後交出能被檢查的成果。
這款模型由上海人工智慧實驗室開發,建立在 744B 參數的 GLM-5.2 基礎上。模型權重與程式碼採 MIT 授權,提供 256K 上下文,並可透過官方 API 或自行部署使用。
我的結論是:比 744B 更值得注意的,是 Atria 把「證據與外部驗證」放進 Agent 的訓練主線。這個方向很實用,但目前仍屬預覽版。官方評測尚待更多獨立重現,本機部署也明顯不適合一般個人電腦。
Atria Dawn Preview 重點規格
| 項目 | 官方資訊 | 對使用者的意義 |
|---|---|---|
| 開發者 | 上海人工智慧實驗室 | 屬於 InternLM 官方帳號發布的研究模型 |
| 基礎模型 | 744B 參數 MoE GLM-5.2 | 總參數規模大,但 MoE 每次只啟用部分專家,不等於每次運算全部 744B |
| 上下文 | 256K tokens | 一次可放入較長的文件、歷史訊息與工具結果 |
| 輸入 | 純文字 | 不能直接把圖片或 PDF 原檔交給模型理解 |
| 版本 | BF16/FP8 | FP8 較省儲存與顯示記憶體,仍是大型資料中心等級模型 |
| 取得方式 | 官方 API、Hugging Face、ModelScope | 可以線上呼叫,也可以自行部署 |
| 授權 | MIT | 程式碼與模型權重開放使用,但官方網站圖片與展示影片仍要另外確認媒體使用權 |
Atria Dawn Preview 是什麼?它要解決的不是一次問答
AI Agent 可以理解成「能依目標採取多個步驟,並呼叫外部工具的 AI」。一般聊天機器人常在產生文字後停止。Agent 還要把答案送進程式、瀏覽器、終端機或其他工作環境,根據實際結果決定下一步。
Atria Dawn Preview 再往前加了一個條件:最後交出的結果要能驗證。官方將目標分成四類:蒐集與整理證據的 Discovery、建立程式與互動內容的 Creation、製作報告與簡報的 Delivery,以及在授權環境中找漏洞、修復並重新測試的 Cybersecurity。
這四個分類本身不新鮮。真正的差異在於,Atria 團隊不希望模型只說「我完成了」,而要讓外部環境回答它是否真的完成。例如程式測試有沒有通過、檔案是否真的產生、實驗指標是否改善、引用能不能支持結論,或漏洞修補後是否無法再次利用。
Verifiable Experience Pipeline:把失敗與驗證也變成訓練經驗
Atria 技術報告把這套做法稱為「可驗證經驗管線」(Verifiable Experience Pipeline)。白話來說,訓練資料不只保留問題與答案,而是連同模型採取的步驟、使用的工具、產生的檔案,以及外部檢查結果一起保存。
一個長任務中,模型可能先選錯工具,也可能遇到測試失敗。管線會保留它如何讀取錯誤訊息、修改做法與再次驗證的過程,再移除不完整、互相矛盾或重複的紀錄。官方希望模型學到的重點不在固定工作流程,而在面對環境回饋時如何繼續推進。
這也解釋了模型、Agent 執行框架與工作環境的分工。模型負責理解、推理與選擇工具。執行框架管理目標、狀態、權限與長時間任務,工作環境則提供真實資料、檔案與測試結果。少了後兩者,再大的模型也不能靠一段提示詞自動變成可靠 Agent。
官方展示了哪些案例?
官方網站目前展示研究、程式、3D CAD、互動網站、辦公文件與資安任務。這些案例無法證明 Atria 能處理所有同類工作,主要價值是讓讀者看到它如何把多個步驟串成可檢查的產物。
最完整的案例之一是全球氣象預測。技術報告表示,Atria 在不能使用網路搜尋的受限環境中處理超過 100GB 的氣象資料,建立超過 4 億參數的 ViT 網路,訓練 45,000 步,處理 69 個氣象變數。官方稱系統能在一分鐘內產生未來一週的全球預報,部分指標優於 FourCastNet。
但這裡要把「展示」與「通用能力」分開。影片能證明團隊產生了可操作介面,不能單獨證明所有預報精度,也不能推論每個使用者下同一句指令都會得到相同成果。技術報告也主動將這些案例稱為選定展示,不是平均成功率。
官方展示 Atria 建立全球氣象預測系統與互動介面。影片能證明案例產物存在,不代表本文獨立重現其預報精度。 影片來源:Atria Dawn Preview 官方網站。
另一個 MiniOS 案例從空白工作區建立具備命令列、磁碟存取、持久化檔案系統與直譯器的小型作業系統,約 20 分鐘完成。CAD 案例則生成四缸引擎、人形機器人、關節模組與火箭。這些畫面能證明幾何與元件結構已產生,卻不等於已完成工程或製造驗證。
Atria Dawn Preview 評測成績怎麼看?
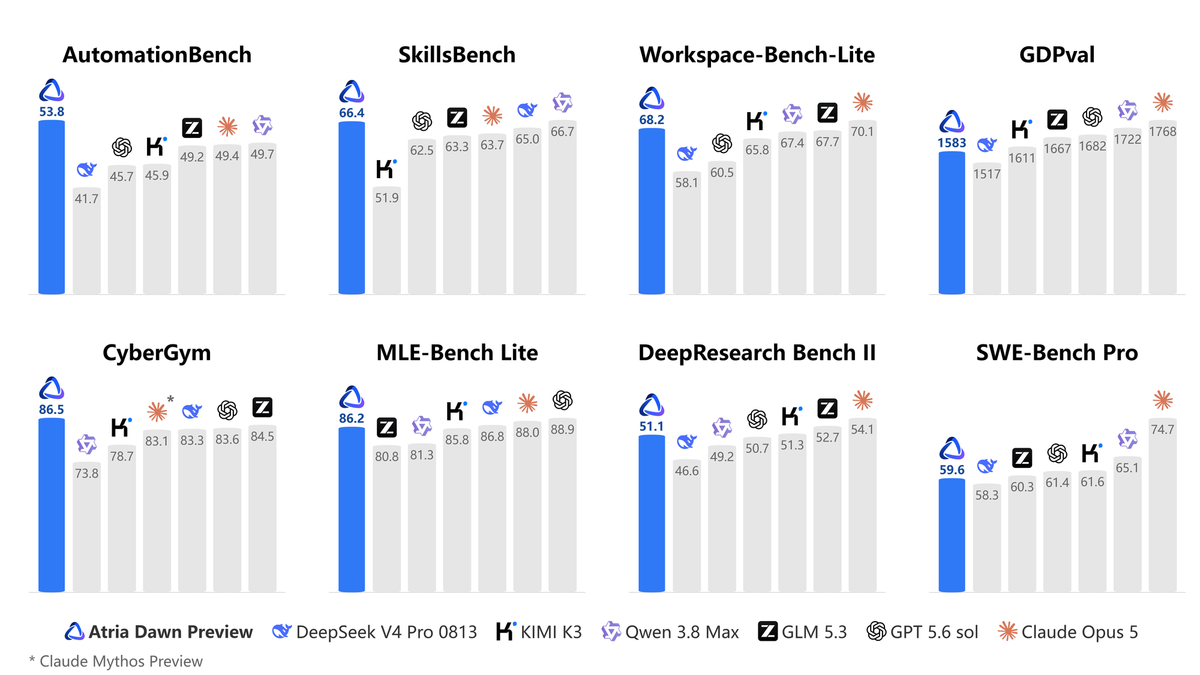
官方技術報告列出 16 項評測。Atria 在其中 5 項取得表內最高分,包括 AutomationBench 53.8、BFCL v4 77.0、DeepSearchQA 96.0、BrowseComp 92.5 與 CyberGym 86.5。它在 SkillsBench 得到 66.4,僅低於表內最高的 66.7。Workspace-Bench-Lite 為 68.2,低於最高的 70.1。
這組成績支持一個較保守的結論:Atria 在工具呼叫、搜尋與資安任務上具有競爭力,但不能直接寫成「全面超越所有頂尖模型」。在 SWE-bench Pro、Terminal-Bench 2.1、GDPval 與 JobBench 等項目,表內仍有其他模型領先。
評測方法也不是完全相同的單一賽道。技術報告說明,部分工作空間評測讓 GPT 模型使用 Codex,其他模型使用 Claude Code。多個項目還依賴不同的模型裁判、時間限制與工具配置。這些資訊讓結果更容易查核,同時也提醒讀者:表格是團隊公布的成績,不是已由中立機構完成的統一測試。
因此,我會把這份評測當成值得進一步測試的證據,而不是採購或部署的最終答案。真正要導入時,仍應用自己的資料、工具、錯誤情境與驗收標準跑一輪小型評估。
769 件任務揭露更重要的事:AI 做得更多,人類仍在做決定
Atria 論文不只談模型分數,也分析開發 Atria 本身時的人機協作。團隊整理 56 名參與者的 769 件任務與 Agent 紀錄。在 739 件能明確判斷是否使用 AI 的任務中,713 件使用了 AI,占 96.5%。
其中 455 件已完成的 AI 輔助任務有可用回答,參與者認為 151 件若沒有 AI 就無法在相同範圍、品質與資源條件下完成,占 33.2%。這不是受控實驗,而是參與者對自身工作的估計,不能解讀成 AI 客觀提升三成生產力。不過它顯示,AI 除了節省時間,也讓團隊開始嘗試原本不會做的工作。
Agent 的自主性也有明確邊界。在方法與參數的決策中,「AI 提案、人類選擇」是最常見模式,占 55.4%。人類最後拍板的比例仍有 85.5%,目標與範圍由人類最後決定的比例更達 93.4%。遇到重大困難時,588 件有紀錄的任務中有 76.0% 靠人類介入才繼續前進,最常見的幫助是補充背景或改變方法,而不是人類直接接手。
這些數字反而削弱了「AI 已經能自行研發下一代 AI」的誇張說法。目前更接近的狀態是:Agent 負責提出方案與大量執行,人類把有限時間放在目標、判斷、驗收與風險責任。Atria 的論文標題用了「Agentic Superintelligence」,正文卻承認持續的遞迴自我改進仍有明顯技術與治理缺口。
Atria Dawn Preview 怎麼使用?
一般使用者最實際的入口是官方 API。文件提供 Chat Completions、Anthropic Messages 與 OpenAI Responses 三種相容介面,模型 ID 固定為 Atria-Dawn-Preview。使用前要先在控制台建立 API Key,再把金鑰保存在伺服器環境變數或密碼管理器。
開發者也可以從 Hugging Face 或 ModelScope 下載 BF16 與 FP8 權重,並透過 SGLang 0.5.13.post1 以上或 vLLM 0.23.0 以上部署。官方也提供 Codex、Claude Code、WorkBuddy、Qoder、OpenClaw 與 Hermes 的接入範例。
不過「可自行部署」不等於「可以在筆電上順跑」。截至 2026 年 9 月 15 日,Hugging Face 檔案清單中,完整版本約 1.51TB,FP8 版本約 756GB。實際推論還需要額外顯示記憶體與運行空間,因此主要面向多 GPU 伺服器或資料中心環境。
另一個容易踩到的限制是純文字輸入。官方文件明確說明 Atria Dawn Preview 不能直接接收圖片、截圖或 PDF。若用支援圖片的 Agent 工具接入,需要先關閉影像輸入,或在外部完成 OCR 與文字擷取後再傳給模型。
Atria Dawn Preview 適合誰?
Atria 現階段最適合三類人。第一類是研究 AI Agent 訓練與評測的團隊,因為權重、技術報告與評測協定都已公開。第二類是有長流程開發或研究任務的工程團隊,可以透過 API 做小規模對照測試。第三類是有多 GPU 基礎設施,且重視資料留在自有環境的組織。
如果只需要日常聊天、摘要或偶爾寫程式,這個模型不一定比成熟的雲端產品方便。若工作包含大量圖片與 PDF,純文字限制也會增加前處理成本。企業要把它接到程式碼、機密文件或資安工具前,還要另外設計權限、紀錄、人工覆核與失敗回復,不能只看模型分數。
我的判斷維持中性偏多:技術方向值得關注,現在適合做受控評估,不適合直接把關鍵流程全部交給它。若後續有獨立評測重現官方成績,加上清楚的服務價格與穩定性資料,這個判斷會更偏正面。若第三方無法重現長流程成果,Atria 的價值就會更接近研究展示。
常見問題
Atria Dawn Preview 是開源模型嗎?
官方把程式碼與模型權重以 MIT 授權釋出,一般可稱為開放權重模型。權重可從 Hugging Face 與 ModelScope 下載,但訓練資料與完整訓練管線是否全部公開,仍要以 repository 實際提供內容判斷,不能只因權重可下載就視為完全可重製。
744B 代表每次都會使用 7440 億個參數嗎?
不一定。Atria 建立在 MoE(Mixture of Experts,混合專家)模型上。這種架構擁有大量專家參數,但每個 token 通常只路由到其中一部分,因此總參數量與每次推論實際啟用的參數量不同。
Atria Dawn Preview 可以看圖片或 PDF 嗎?
目前不行。官方文件把它標示為純文字模型。圖片與 PDF 需要先用其他工具轉成文字,再把文字交給 Atria 處理。
可以在一般電腦本機執行嗎?
對大多數人來說不實際。即使使用 FP8 版本,權重檔仍約 756GB,還需要額外運行資源。一般使用者較適合先透過官方 API 測試。
Atria Dawn Preview 已經能自己改進下一代 AI 嗎?
官方研究認為 Agent 已能參與 AI 研發,但仍需要人類決定研究方向、選擇方法與處理關鍵失敗。論文把持續遞迴自我改進列為尚未解決的挑戰,而不是已完成能力。
結語:真正的新意是把「完成」改成「可驗證完成」
Atria Dawn Preview 把 AI Agent 的競賽焦點,從回答品質推向完整工作結果。模型必須接觸工具與真實環境,失敗時要修改做法,最後還要留下可由測試、檔案、指標或來源檢查的證據。
這個方向比單看 744B 更有意義,也比一句「AI 會自我修正」更具體。不過 Preview 的名稱仍然重要:官方案例與 16 項評測提供了有用起點,卻還不能取代獨立重現與自己的任務驗收。
如果你想評估 Atria,最合理的第一步是挑 5 到 10 件真正會遇到的長流程任務,透過 API 比較完成率、人工介入次數、成本與結果可驗證性,還不用先準備一台能放下 756GB 權重的伺服器。Atria 最終有沒有價值,應該由這些外部結果決定。