AVG 即時強化學習是什麼?機器人從互動中學動作,為什麼不一定要存滿經驗?
Gautham Vasan 的博士研究探討機器人即時強化學習,AVG 每次互動更新一次,不儲存經驗重播資料。本文解析串流學習、遠端與本機分工,以及真實機器人數小時學習的實驗界線。

機器人通常先訓練,再部署。環境改變後,如果原本策略不適合,可能還要由工程師重新收資料、訓練與更新。Gautham Vasan 的博士研究探討另一種方向:讓機器人在執行中持續從互動學習,並把算力、時間與回饋設計放進同一個問題。
這份研究近期由強化學習學者在 X 分享,吸引超過兩萬次瀏覽。論文包含三項互補工作,其中 AVG 是一種計算較輕的串流強化學習方法,每次互動更新一次,不儲存歷史互動供重複取用。它提供的是指定實驗中的學習方法,不是已完成的通用家用機器人。
對關心實體 AI 的讀者,這個方向值得理解,因為「能在模擬學會」與「能在有限資源的真實裝置上學會」是不同門檻。本文會拆解即時學習、經驗重播與目標回饋,再整理官方模擬與實體結果,說明數小時學習究竟代表什麼。
強化學習是什麼?從動作與結果調整策略
強化學習讓系統透過互動取得回饋,逐步調整行為。它觀察環境、選擇動作、看到結果,再根據獎勵決定是否改善。策略可以理解為在某種狀態下選擇動作的方法,不一定是人逐條寫好的規則。
以機械手臂接近目標為例,系統可能從畫面取得目前狀態,選擇移動方向,再看是否完成。這是本文的理解示例。回饋如何定義、哪些動作允許、觀察包含什麼,都會影響學到的行為。
傳統流程常在部署前完成大量訓練,實際使用時策略保持固定。這便於測試與控制,但環境一變,可能需要新的工程工作。即時強化學習則研究如何在持續執行中更新,讓學習與環境的真即時間一起推進。
這裡的即時不是「任何任務都立刻學會」。它描述學習必須跟上真實互動的時間條件,不能無限暫停環境等待計算。機器人有電力、感測、動作與資源限制,演算法需要在這些條件下工作。
真實機器人學習,三個門檻要一起處理
依照作者博士論文,即時學習需要面對有限計算與記憶體、可接受的學習時間,以及能由機器人自身感測取得的回饋。任何一項不適合,都可能讓方法難以走出實驗。
算力限制意味著機器人可能沒有大型訓練伺服器。學習程式要和感測、控制共享資源,不能因為更新模型就錯過動作時機。記憶體也有限,大量儲存影像與互動資料,可能使邊緣裝置負擔增加。
時間則關係到實際價值。一個任務若要幾個月互動才能學會,可能無法用於日常研究或應用。論文討論在數小時內得到可用策略的指定實驗,仍需看任務難度、環境與重複結果,不能把小時數當成通用承諾。
回饋設計也很重要。真實裝置不一定能讀取模擬器提供的完美狀態,可能只能靠相機與感測資料確認目標。若每次回饋都需要外部人員標記,持續學習就會受到很大限制。方法需要讓反饋既可取得,也與真正成果相關。
| 門檻 | 實際問題 | 研究對應方向 |
|---|---|---|
| 計算與記憶體 | 小裝置如何承擔學習 | 遠端分工與輕量更新 |
| 學習時間 | 多少互動後能有用 | 以真即時間評估 |
| 回饋取得 | 如何知道動作有效 | 簡單目標與感測條件 |
| 完整控制 | 更新是否跟上動作 | 觀察、執行與學習協同 |
ReLoD:讓遠端工作站補足本機算力
論文第一項工作是 ReLoD,遠端與本機分散式框架。它把動作計算與學習更新安排在機器人和遠端工作站之間,讓有限資源的裝置取得額外計算。這個方向依賴連線與系統安排,並不是全部學習都在小晶片獨立完成。
研究在視覺任務中觀察有限本機計算對批次學習的影響,再通過遠端資源恢復表現。它說明算力配置本身會影響學習,而不是模型演算法名字相同就一定有相同結果。
遠端分工也有成本。網路延遲、連線中斷與資料傳輸,都可能影響控制。實際系統要決定哪些工作必須在本機及時完成,哪些可以交給遠端。不能只看遠端機器更強,就忽略完整時間與可靠性。
這項工作與後面的 AVG 是互補貢獻,而不是同一個功能的兩種名字。ReLoD 研究如何使用額外資源,AVG 則研究更輕量的更新方式。文章把它們分開,才能避免把所有結果說成一個演算法在所有硬體上的成績。
最短時間目標:每一步減一,為什麼有用?
論文第二項工作研究最短時間的任務描述:每個時間步得到負一,達到目標時結束。這樣可以鼓勵系統儘快完成,而不是由人設計許多距離、角度與進度獎勵。負一隻是回饋規則的一部分,不是對機器人的情緒懲罰。
複雜獎勵可能幫助引導,也可能讓系統學會追求代理指標。例如只獎勵接近目標,卻沒有完整定義結束條件,策略可能反覆靠近而沒有真正完成。簡單的時間規則試圖把目標與效率連起來,仍需要可靠的目標判定。
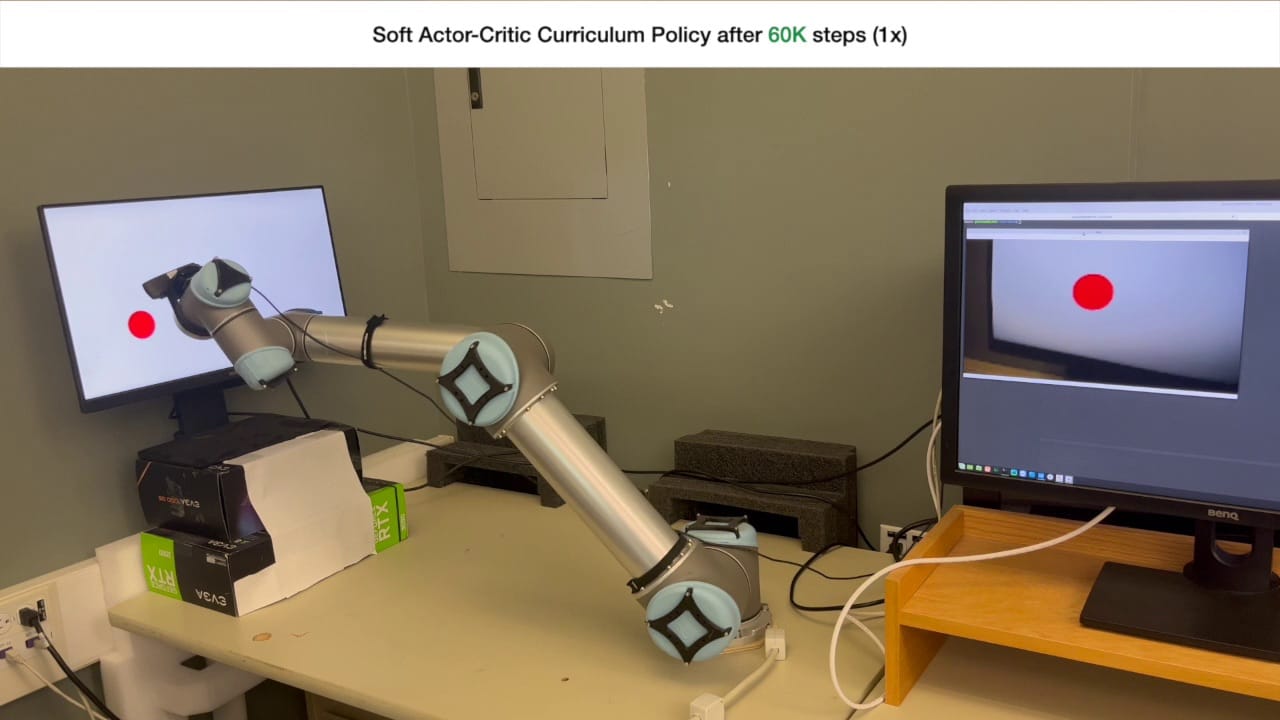
研究比較同樣互動預算下的最終策略,並在四種實體機器人上,從原始畫面學習到達目標。作者報告數小時內學會指定策略,且不需要額外外部儀器提供回饋。這個結果以特定任務與感測配置為準,不等於所有工作都能省掉校準與裝置。
對讀者,最值得理解的是獎勵與驗收關係。學習會追逐你定義的目標,因此完成條件必須對應真實任務。簡單規則有潛力,仍不能脫離實際感測與操作範圍。
AVG:每次互動學一次,不存經驗重播
AVG 是 Action Value Gradient,動作價值梯度方法。它屬於串流強化學習方向,每次取得一筆互動資料,就進行一次引數更新,並不儲存這些資料供後續重播。互動資料包含觀察、動作、獎勵與下一次觀察。
經驗重播是把過去的互動存起來,之後重複抽取來學習。這能提高某些方法的資料使用效率,也需要儲存與處理。AVG 不使用這種歷史重播,讓資源安排更直接,但不代表系統完全沒有狀態或不用模型引數。
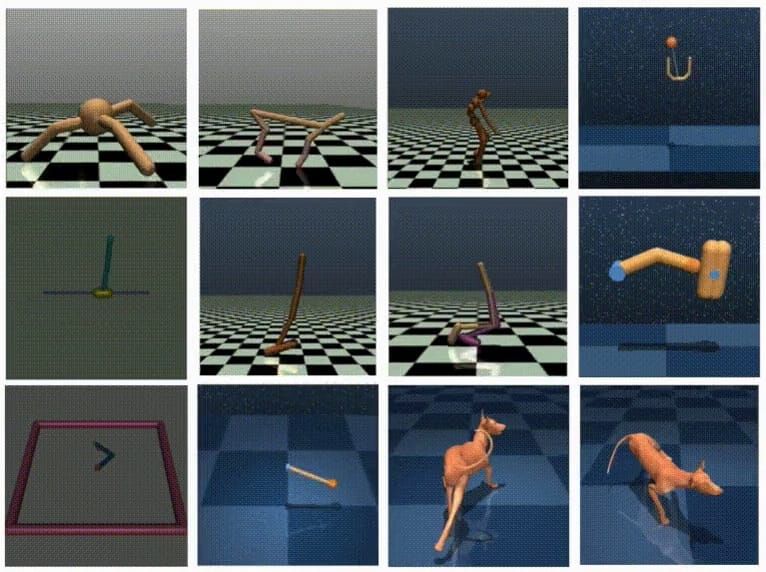
論文在模擬任務中比較現有串流方法,報告 AVG 的表現,並在部分設定達到接近批次方法的最終成果。實體任務則展示在邊緣裝置數小時內學到指定策略。模擬比較與實體學習是不同證據,不能把模擬畫面標成真實機器人現場。
本文引用的 AVG 官方影片展示模擬控制任務,另以作者網站的實體機械手臂畫面與論文介紹物理實驗。這樣能讓讀者區分視覺素材,也知道哪些結果來自哪一種環境。
| 方法概念 | 是否儲存歷史互動供重播 | 主要取捨 |
|---|---|---|
| 經驗重播批次方法 | 通常會 | 資料複用與儲存處理 |
| 串流更新 | 依方法而定 | 跟隨當前互動學習 |
| AVG 的研究設定 | 不儲存供重播 | 輕量更新與指定任務表現 |
| 固定部署策略 | 使用時不再學習 | 控制穩定與適應能力 |
邊工作邊學,不等於沒有任何限制地嘗試
機器人動作會影響真實環境,學習需要明確的可用範圍。目標、速度、位置與任務結束條件,應由完整系統控制。一個學習演算法能更新策略,不表示可以自行擴大操作權限或隨意探索所有動作。
這與模擬不同。模擬中失敗可以重新開始,真實裝置可能需要人工恢復,也可能損壞材料。評估時應把恢復時間與介入次數記錄下來,避免只計算成功策略,而漏掉取得策略的完整成本。
長期適應也需要額外證據。數小時學習一個目標,不等於證明多年持續執行後仍穩定。環境變化、遺忘與感測漂移,都可能影響後續表現。論文提出通往持續學習的方向,不能把方向寫成已經解決全部問題。
更新與驗收也要連起來。策略改變後,應能檢查是否仍符合任務範圍與最低完成條件。若只追求當前獎勵,可能犧牲其他要求。實際應用需要完整標準,而不是把演算法更新當成自動可靠的過程。
為什麼「不存經驗」仍值得研究?
儲存與讀取大量影像,會影響邊緣裝置的資源。若學習方法能用較少記憶體持續更新,就可能更適合某些小型平臺。這個優勢需要和學習速度與最終表現一起看,不能只因為節省資料儲存就判定更好。
不重播也可能減少對歷史資料庫的管理,流程較直接。另一方面,過去經驗不能再反覆使用,方法需要在當前互動中有效學習。不同任務對樣本效率與記憶體有不同要求,因此兩種路線可能各有適合場景。
對研究者,AVG 提供了一個可比較的設計:每次互動的計算、資源與回饋都更明確。能否推廣到更多機器人與更復雜任務,需要後續測試。方法名稱不決定通用性,實驗證據才決定可用範圍。
怎麼評估一個即時學習系統?
先儲存任務定義與初始條件。目標位置、感測輸入、動作限制與環境都應清楚,才能比較不同執行。若每次任務不同,小時數與最終分數就很難解釋。
再記錄真即時間與互動次數。兩者都重要:快速計算不一定減少需要的經驗,少量經驗也可能需要很長處理。把每步更新、動作與恢復放在一起,才能看完整效率。
接著記錄成功與失敗過程。多少次執行學會、哪些條件失敗、有沒有人工重置,都影響可靠性。只展示一條成功曲線,可能掩蓋不同開始條件的差異。
最後比較固定策略與繼續學習。更新是否真的幫助適應變化?會不會在原本任務退步?這樣的對照更接近持續學習需要回答的問題,也能避免把單次訓練成功誤當成長期能力。
常見問題:AVG 讓機器人完全不用人教嗎?
不存經驗,代表不用訓練資料嗎?
它仍使用當下互動產生的資料,只是不儲存供重複重播。觀察、動作與獎勵都是學習依據。資料使用方式改變,不等於沒有資料或沒有訓練過程。
數小時學會,能直接推廣到做家務嗎?
不能直接推論。論文討論指定到達目標與控制任務,家務包含更多物體、步驟與異常。後續能力需要新的實驗與完整驗收,不能只套用一個學習時間。
即時學習會永久越來越聰明嗎?
研究提供持續適應方向,長期穩定與泛化仍需要驗證。更新可能改善當前任務,也可能受到錯誤回饋或環境變化影響。應儲存基準與比較,不能把持續更新當成必然進步。
結語:讓機器人學得動,也要讓學習可量測
這份研究把算力、時間與目標設計連起來,說明實體學習不只需要好演算法,還需要合適的完整系統。ReLoD、最短時間任務與 AVG 提供互補方向,讓有限資源上的學習更具體。
對科技讀者,最值得記住的是證據範圍:模擬、實體、資源與持續適應要分開看。當任務條件與完整成本清楚,數小時學習才從吸引目光的數字,變成可以繼續研究與比較的成果。