beignet 是什麼?傅立葉特徵金字塔如何讓物理神經網路解方程更準,論文數字怎麼讀
beignet 是 Caltech 與 Google DeepMind 研究者提出的神經場架構,用多解析度傅立葉特徵金字塔解偏微分方程。本文依 arXiv 論文整理誤差表、速度測試、Burgers 奇點實驗、開源程式碼與限制。

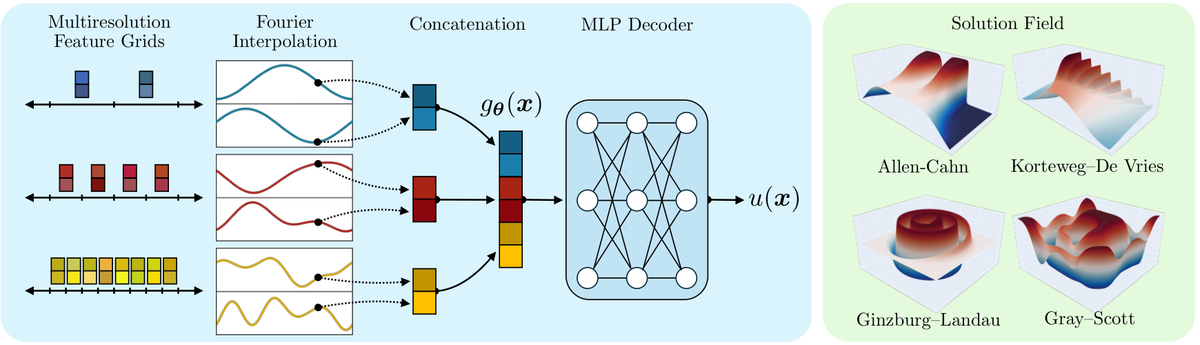
偏微分方程描述熱怎麼傳、水怎麼流、波怎麼走,想用神經網路解它,一個常見做法叫物理資訊神經網路,簡稱 PINN。問題是它常常只能做到「大致正確」,要把誤差壓到小數點後五、六位,就會卡住。
beignet 是針對這個卡點提出的新架構。論文有六位作者,Brandon Zhao、Yixuan Wang 與 Katherine L. Bouman 隸屬 Caltech。
另外三位是 Jonathan T. Barron、Dor Verbin 與 Pratul P. Srinivasan,他們隸屬 Google DeepMind。
台灣時間 10 月 21 日清晨 6 點多,X 帳號 Brandon Zhao 發文,說它能讓解方程「更快收斂、更高精度」,還能用在尋找奇點。這個帳號的簡介寫著 PhD @caltech,與論文第一作者同名同校,我據此判斷是作者本人發文。
論文其實更早,arXiv 編號 2605.24278 的第一版在 2026 年 5 月 22 日上傳,10 月 6 日更新到第二版。所以這次熱傳是舊論文加新版本,不是一項剛出現的成果。
讀者最該問的是,貼文那三個說法有多少能在論文裡找到對應。我把論文的表格逐一對過,結論是精度的證據最完整,論文的速度只量了單步時間,奇點部分則是一個一維模型問題,離真正的流體奇點還很遠。
貼文附的影片另有一段計時,但那是另一個實驗,後面會單獨說明。
這個結論對你很重要,因為如果你把它當成通用的 AI 影像或生成技術,會找錯方向。它是科學計算的工具,適合做 PDE 求解的研究者與工程師,不適合想找現成應用的一般使用者。
要看懂這些數字,先要知道 PINN 的瓶頸在哪裡,以及這個新架構動了哪個零件。
beignet 是什麼?PINN 的瓶頸與傅立葉特徵金字塔的做法
PINN 的做法是用一個神經網路表示答案,輸入座標,輸出該點的解。訓練時不給標準答案,而是把網路的輸出代回方程式,看左右兩邊還差多少,這個差距叫殘差,訓練目標就是把殘差壓小。
這種用神經網路表示隨座標變化的函數,稱為神經場。這個新架構的全名是 Bandlimited Embedding with Interpolated Grid Network,意思是「帶限的插值格點嵌入網路」。
卡點出在頻譜偏差。神經網路用梯度下降訓練時,會先學會緩慢起伏的低頻成分,很久之後才學會劇烈變化的高頻成分,而方程的解常常正好有尖銳的介面。
過去的解法是在輸入端加隨機傅立葉特徵,也就是把座標先丟進一組隨機頻率的正弦波。論文指出,這類高斯隨機特徵不是嚴格帶限,頻寬調高時會讓最佳化變脆弱。頻寬調低,劇烈變化的細節又很難學到。
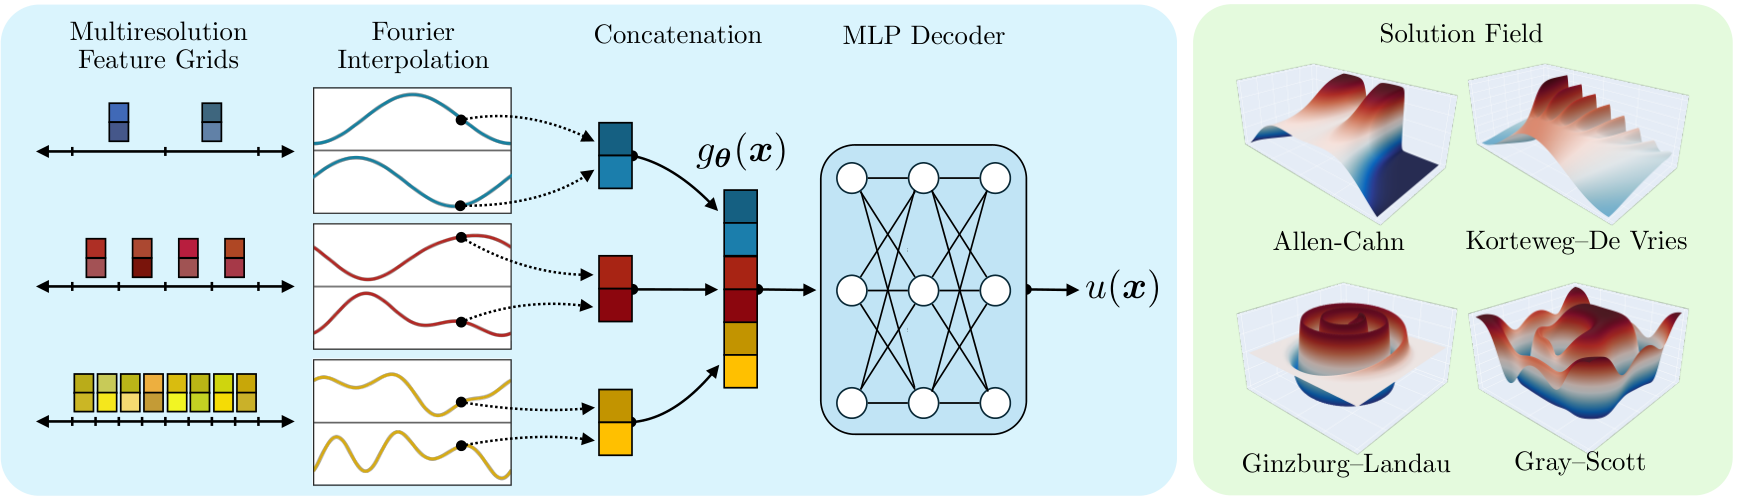
beignet 把隨機頻率換成一個可訓練的金字塔。金字塔有好幾層,每層是一張週期性的特徵格點,解析度從粗到細,通常每往下一層就加倍。
查詢某個座標時,每一層都用傅立葉內插取出一個特徵,再把各層特徵接在一起,交給一個小型 MLP 解碼出答案。你可以把它想成地圖的不同縮放級別,粗層管大趨勢,細層管細節。
這種設計有個好處,最細那一層的解析度直接決定能表示的最高頻率,所以工程師可以主動控制頻寬,不必靠亂數碰運氣。
但頻寬控制只是其一,更大的差別來自導數怎麼算。
為什麼用 FFT 算導數?速度與記憶體差距的來源
解方程需要大量導數,因為殘差裡含有對座標的一階、二階甚至三階微分。傳統 PINN 靠自動微分逐點計算,網路愈大、導數階數愈高,成本就愈高。
新架構把特徵格點的導數交給快速傅立葉轉換(FFT)處理。傅立葉空間裡微分只是乘上波數,所以整張格點的導數可以一次算完,再用鏈鎖律接上 MLP 的導數。
這條路徑要求取樣點排成規則格子,這也是它的限制,後面會再談。好處是計算可以整批重用,不必每個點各算一次。
論文的附錄 E 在單張 NVIDIA A100 80GB 上量了 Allen–Cahn 問題的訓練步時間。它排除了記錄、存檔與取樣時間,在相同的殘差點數下比較。
在 65,536 個殘差點時,FFT 路徑每 100 步花 6.8 秒,PirateNet 基準要 50.4 秒,論文給的倍數是 7.4 倍。在 8,192 個殘差點時,兩者是 1.88 秒與 12.75 秒,約 6.8 倍。
記憶體差距更直接。論文說這個 65,536 點的訓練可以放進一張 A100 80GB,而 PirateNet 在 8,192 點、加上梯度範數重加權的設定下,需要兩張 GPU。
這裡要看清楚比較口徑。這是單步時間,不是達到同樣誤差所需的總時間,附錄 E 也寫明目的是把單步吞吐量與收斂行為分開看,所以貼文所說的「更快收斂」,在我讀到的正文與附錄裡,沒有用牆鐘時間的收斂曲線直接證明。
精度則另有一組同點數的對照。附錄 E 的表 9 顯示,在 8,192 個殘差點時,PirateNet 的相對誤差是 1.38×10⁻⁵,beignet 是 1.91×10⁻⁶,依表相除約低 7.2 倍。這說明精度優勢不只是因為用了更多取樣點。
另一個設計叫隨機格點平移。固定格子的取樣點,容易讓網路學到「只在格點上正確」的高頻答案,所以訓練時每次把格子隨機平移一小段。
消融實驗顯示它的重要性。Allen–Cahn 問題拿掉平移後,訓練殘差更小,相對誤差卻高達 0.95,開啟平移則是 1.52×10⁻⁶。這個例子說明,殘差小不等於答案準。
介紹完機制,接下來看論文在哪些題目上拿到什麼成績。
beignet 的誤差表:四個基準問題與三個模型的比較
論文用 JAX-PI 基準套件的四個時間相依 PDE 做主要比較,對手是 JAX-PI 與 PirateNet 兩個 PINN 架構。以下我把論文表 1 的相對 L2 誤差與參數量放在一起,並加上我依表格相除的倍數。
| 問題 | JAX-PI | PirateNet | beignet | beignet 相對 PirateNet |
|---|---|---|---|---|
| Allen–Cahn | 6.98e-5 | 1.21e-5 | 1.88e-6 | 約 6.4 倍準 |
| KdV | 4.06e-4 | 2.59e-4 | 3.71e-5 | 約 7.0 倍準 |
| Ginzburg–Landau | 2.10e-2 | 1.15e-2 | 1.08e-3 | 約 10.6 倍準 |
| Gray–Scott | 72.8 | 3.10e-3 | 1.84e-4 | 約 16.8 倍準 |
表中數字是主要場的相對 L2 誤差,意思是預測解與參考解的差距占參考解大小的比例,1e-3 約等於 0.1% 的偏差。每格是三個隨機種子的平均,基準的結果是作者用 JAX-PI 程式碼在同一個評估流程下重現的。
倍數是我自己算的,論文正文只說誤差「明顯較低」,並指出 Ginzburg–Landau 低約一個數量級,Gray–Scott 在兩個場上都低一個數量級以上。
參數量也值得看。Allen–Cahn 與 KdV 兩題,新架構約用 41 萬個參數,PirateNet 約 192 萬個。
Ginzburg–Landau 與 Gray–Scott 每個時間視窗的參數,新架構是 85.6 萬個,PirateNet 是 191.7 萬個,不到一半。
這張表有兩處要保留。JAX-PI 在 Gray–Scott 的主要場誤差是 72.8,標準差高達 69.8,等於預測值偏離參考解數十倍。我的解讀是,這個基準在重現設定下幾乎失敗,反映的可能是設定問題,不是這類架構的極限。
另一處是種子數太少,三個種子的結果波動很大。新架構在 Gray–Scott 的誤差是 1.84×10⁻⁴,標準差是 1.52×10⁻⁴,兩者幾乎同一量級,差距雖然大,統計信心仍有限。
論文另外在兩個不規則幾何的非週期問題上測試,它的誤差比最好的基準低 2.4 倍與 5.7 倍。這部分的做法是把區域嵌進更大的週期方塊,再靠懲罰項處理邊界。
誤差表回答了「準不準」,貼文提到的奇點則是另一個實驗。
延伸閱讀:Walrus 用 12 段果蠅胚胎影片學組織流動:物理 AI 能跨到生命科學嗎?
「找奇點」是什麼意思?Burgers 方程自相似爆破實驗的真實範圍
奇點指的是某個物理量在有限時間內變成無限大。流體力學裡最有名的問題,是三維納維–斯托克斯方程的解會不會爆掉,這是千禧年大獎難題之一,也是論文引言的背景。
論文並沒有處理那個問題。它選的是一維無黏性 Burgers 方程,一個形式簡單、卻保留爆破關鍵特徵的模型。
直接模擬爆破很難,因為接近爆破時數值會愈來愈病態。常見做法是換成自相似變數,把「找爆破過程」改寫成「找一個固定形狀的剖面」,這個剖面稱為 U。
算出夠精確的剖面後,可以交給後續的穩定性分析或電腦輔助證明。所以精度是這類工作的門檻,殘差要壓到接近機器精度才有用。
論文表 2 比較三種做法,條件是固定相似指數 0.5、使用 64 位元浮點,兩個 Adam 列訓練 20K 步,座標 MLP 是寬 20、深 4 的小網路。
| 方法 | 優化器 | 記憶體 | 方程均方殘差 | 最大殘差的以 10 為底對數 |
|---|---|---|---|---|
| 座標 MLP | Adam | 與參數量成正比 | 6.21e-7 | −2.41 |
| 座標 MLP | BFGS | 與參數量平方成正比 | 7.15e-20 | −9.10 |
| beignet 金字塔(12 層、每層 4 通道) | Adam | 與參數量成正比 | 6.29e-19 | −8.46 |
Adam 是只用一階資訊的常用優化器,BFGS 是要保存密集矩陣的二階方法,記憶體需求隨參數量平方成長,所以放大模型時很吃資源。
表中最重要的一列,是金字塔架構只靠 Adam,就把均方殘差從 6.2×10⁻⁷ 壓到 6.3×10⁻¹⁹,差了十二個數量級。
但請注意,BFGS 的數字依然更低,均方殘差小約 9 倍,最大殘差的對數也低 0.64。所以較準確的說法是,它讓便宜的一階方法逼近昂貴二階方法的水準,並沒有超越。
這張表還有兩個口徑差異。附錄 J 寫明三列都是單一隨機種子,兩個 Adam 列用 JAX 訓練,BFGS 列用 PyTorch 訓練 2 萬次迭代,並把存檔結果用同一套診斷指標重新評估。所以它不是完全同一程式下的對照,也沒有誤差範圍。
這項結果只能代表一維低維問題。論文自己的措辭是「有希望」用於高維的自相似剖面計算,沒有宣稱已經解出任何三維流體奇點。
貼文裡那段影像擬合動畫,和論文的海星實驗不是同一組數字
貼文附的 5 秒影片,示範新架構擬合一張影像。我抽樣檢視過影片畫面,內容是一張撒滿糖粉的點心配咖啡的照片,同時跑一般 MLP、隨機傅立葉特徵(RFF)和 beignet 三組模型,下方是損失曲線,橫軸是牆鐘訓練時間。
最後一格標示訓練時間 0.149 秒,並註明播放速度慢了 30 倍。三組的峰值訊噪比(PSNR,數字愈高代表愈接近原圖)分別是 14.8、23.8 與 43.9 分貝。貼文說的「超快」,指的應該就是這張計時圖。
這組畫面與數字,我在論文裡找不到對應。附錄 C 的影像擬合用的是 256×256 的海星照片,訓練 2,000 步 Adam,目的是把表示法本身和 PDE 的殘差機制分開檢驗,而且只給步數與 PSNR,沒有任何秒數。
附錄 C 的結果是,一般 MLP 的 PSNR 為 19.61 分貝,高斯隨機特徵為 36.73 分貝,beignet 為 58.39 分貝。
三者的參數量分別是 13.3 萬、26.4 萬與 18.0 萬,而原始影像有 196,608 個數值,所以論文稱這是接近完美的重建,且參數比影像本身還少。
附錄 C 的口徑有一點不對等。一般 MLP 與隨機特徵的解碼器較大,寬 256、深 4,金字塔模型的解碼器較小,寬 64、深 3。論文的說法是,即使解碼器比較小,beignet 仍近乎完美重建,這反映特徵表示的作用。
所以影片裡的 0.149 秒,要當成作者在貼文裡展示的計時。顯卡型號、影像解析度、模型大小與訓練步數,貼文都沒有交代,我也無法換算成倍數。這段影片適合看畫面差異,不適合拿來和論文的單步時間表放在一起比。
另外要分清楚用途。影像擬合是用來檢驗表示法,並不代表它要拿來做影像壓縮或生成,論文的訴求仍是 PDE 求解。
數字與影片都看完了,下一步是判斷自己的研究適不適合動手試。
適合誰、不適合誰:研究者與工程師要先檢查的事
適合的人是做科學機器學習、數值分析或流體模擬,並且已經在用 JAX 與 PINN 的研究者。
作者釋出的程式碼從 JAX-PI 修改而來。論文說基準實驗是把 JAX-PI 的隨機傅立葉特徵換成金字塔,保留 ModifiedMLP 主幹,訓練策略也大致沿用。
程式碼放在 GitHub 的 beignet-paper/beignet-release,採 Apache 2.0 授權,語言是 JAX。
倉庫附有四個基準問題、Burgers 爆破實驗與視覺化筆記本的範例,README 寫明環境是 Python 3.11.14 與 CUDA 12。
授權要分開看。程式碼是 Apache 2.0,論文本身在 arXiv 頁面標示 CC BY 4.0,轉載圖表要標示出處。本文封面是論文圖 1,來源為 Zhao et al., arXiv:2605.24278,圖片屬論文作者。
安裝前建議先讀 requirements 與設定檔,在獨立環境執行,不要直接把來源不明的命令貼進終端機。這份程式碼是研究用的參考實作,我沒有執行過,所以不保證在你的硬體上能重現論文數字。
不適合的人也很明確。想要現成產品、圖形介面或能直接接影像模型的使用者,這個專案都沒有提供,它只是一份論文附帶的實驗程式。
使用前還要確認問題本身適不適合。FFT 路徑天然適合週期性邊界與規則格點,不規則區域要靠嵌入加懲罰的做法處理,精度是否維持要自己驗證。
論文也提醒,不同方程需要的頻寬不同。KdV 這種含三階導數的問題,金字塔愈深反而愈難訓練,最佳設定是 4 層、每層 64 個特徵,而 Allen–Cahn 則是 9 層、每層 14 個特徵。
所以導入時至少要跑一組參數匹配的層數掃描,不能直接照抄論文設定。
延伸閱讀:AI 數學證明為何還需要人理解?從陶哲軒部落格討論,建立可靠解題教學流程
beignet 的限制與風險:論文還沒回答的問題
第一個限制是審查狀態。這是 arXiv 預印本,論文的 AI 使用聲明提到 ICLR 2027 的規範,我推測作者依該會議的規範撰寫,但我沒有看到錄取或審查結果的公開資訊。
第二個限制是證據範圍。主要比較只有四個週期性 PDE、兩個不規則幾何的 Poisson 類問題,以及一個一維 Burgers 剖面。換成其他方程或更高維度,結果未必相同。
第三個限制是基準由作者自己重現。JAX-PI 與 PirateNet 的數字是作者在同一流程下跑出來的,沒有第三方獨立重現,所以倍數應視為作者條件下的結果。
第四個限制是統計力。主要表格只用三個隨機種子,個別題目的變異很大,Gray–Scott 就是例子。
第五個限制是超參數的敏感度。論文承認金字塔頻寬必須依方程調整,這代表「更準」的前提,是你願意花時間做掃描。
最後是論文本身的揭露。作者聲明使用生成式 AI 協助實作、執行實驗與起草文字,也表示已人工驗證所有程式與結果,並大幅修改 AI 起草的文字。這是一項透明的揭露,不代表結果有問題,但讀者可以據此知道研究流程。
另一個風險是誤讀。把「接近機器精度」理解成「解出了流體奇點」或「取代數值模擬」,都超出論文的主張。
beignet 常見問題
beignet 是縮寫嗎?
是。全名 Bandlimited Embedding with Interpolated Grid Network,直譯是帶限插值格點嵌入網路,重點在用可控頻寬的特徵格點取代隨機傅立葉特徵。
beignet 和影像生成模型有關嗎?
沒有直接關係。影像擬合只是論文附錄與貼文影片用來展示特徵表示法的實驗,主要用途仍是解偏微分方程。
一般人需要 GPU 才能跑嗎?
論文的速度測試用 NVIDIA A100 80GB,程式碼倉庫的環境以 CUDA 12 驗證。小問題或許能在較小的 GPU 上執行,但官方沒有提供對應的需求表。
論文提到的奇點,是現實中的流體奇點嗎?
不是。實驗用的是一維 Burgers 方程的自相似剖面,作為通往流體奇點研究的墊腳石。論文沒有宣稱解決納維–斯托克斯問題。
先在小問題上驗證,再談把 beignet 放進研究流程
這個架構最有說服力的部分,是在四個標準 PDE 基準上,誤差比 PirateNet 低約 6 到 17 倍,參數量卻少了一半以上。這是一個值得追蹤的架構改進。
但它目前仍是預印本,論文的速度證據只有單步時間,奇點實驗也只在一維問題上完成。所以最穩妥的使用方式,是在自己熟悉的小型 PDE 上,用同樣的評估流程對照現有 PINN,再決定要不要擴大。
如果你想持續追蹤科學機器學習與開源研究程式碼的實用解讀,可以免費訂閱 AI 郵報。
資料來源
- arXiv 論文頁,Fourier Feature Pyramids for Physics-Informed Neural Networks:https://arxiv.org/abs/2605.24278
- arXiv 論文全文 HTML 版(v2,2026 年 10 月 6 日):https://arxiv.org/html/2605.24278v2
- beignet 作者釋出的程式碼倉庫(Apache 2.0):https://github.com/beignet-paper/beignet-release
- beignet 程式碼倉庫 README(安裝環境與實驗說明):https://github.com/beignet-paper/beignet-release/blob/main/README.md
- X 熱度線索,第一作者 Brandon Zhao 貼文:https://x.com/joiedeposter/status/2112679237526426064