Devin Fusion 得 68 分:Coding Agent Index 的成本與差距怎麼看
Devin Fusion 用 Claude Opus 5.5 當主導、GPT-6 Luna 當副手,在 Artificial Analysis Coding Agent Index 得 68 分,比 Claude Code 搭 Opus 5.5 高 2 分、每題便宜 31%。本文拆解指數與成本算法。

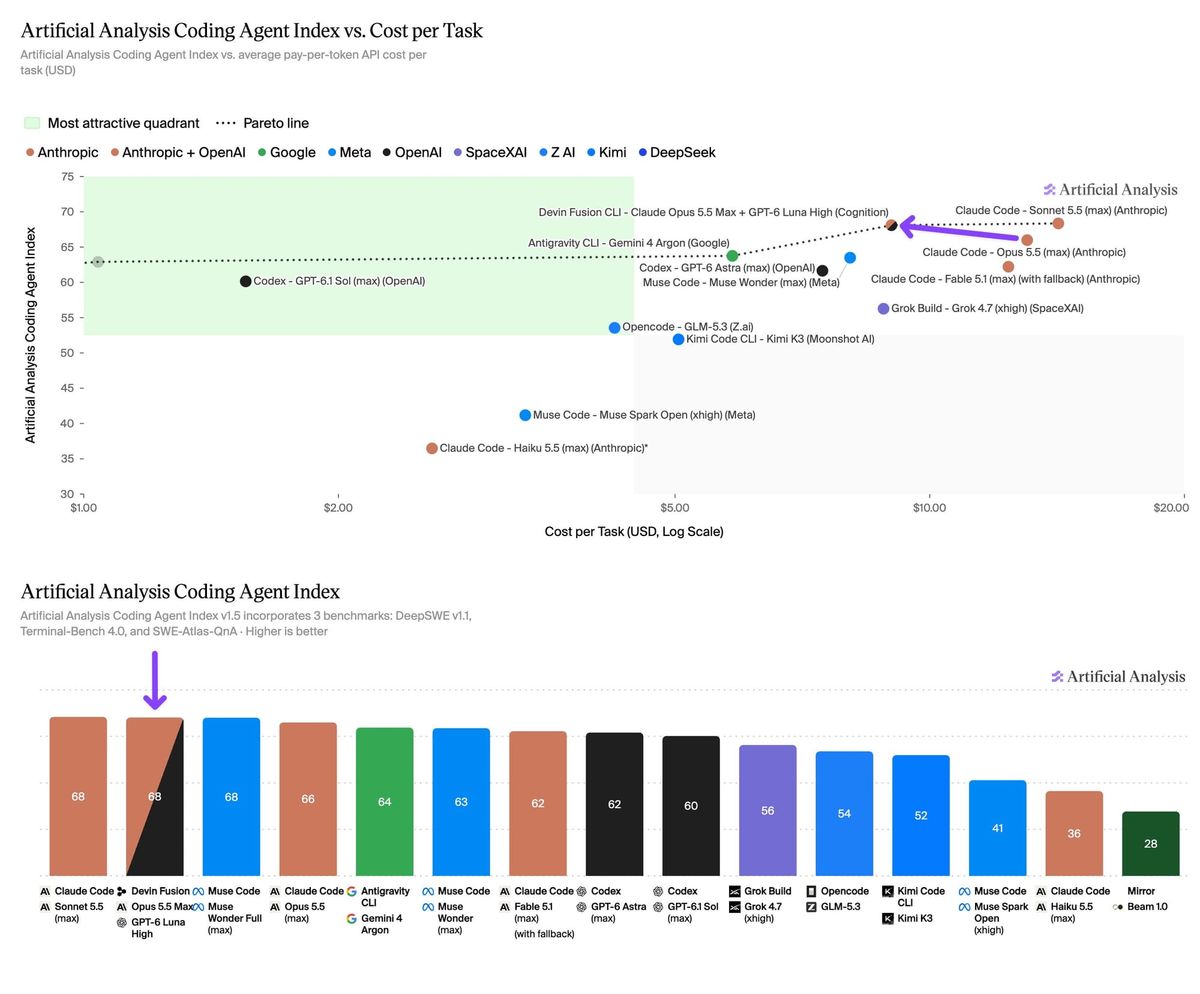
2026 年 10 月 21 日下午(台灣時間),Artificial Analysis(下稱 AA)在 X 公布,Devin Fusion 以 Claude Opus 5.5 搭配 GPT-6 Luna,在 Coding Agent Index 得 68 分。
這個分數比 Claude Code 搭 Opus 5.5 高 2 分,每題成本低 31%。
Devin Fusion 是 Cognition 旗下 Devin 的工作模式,讓昂貴的前沿模型當「主導」,負責規劃與審查,再讓便宜的模型當「副手」,負責動手寫程式與跑測試。分數更高、成本更低,讀起來像是又省又準。
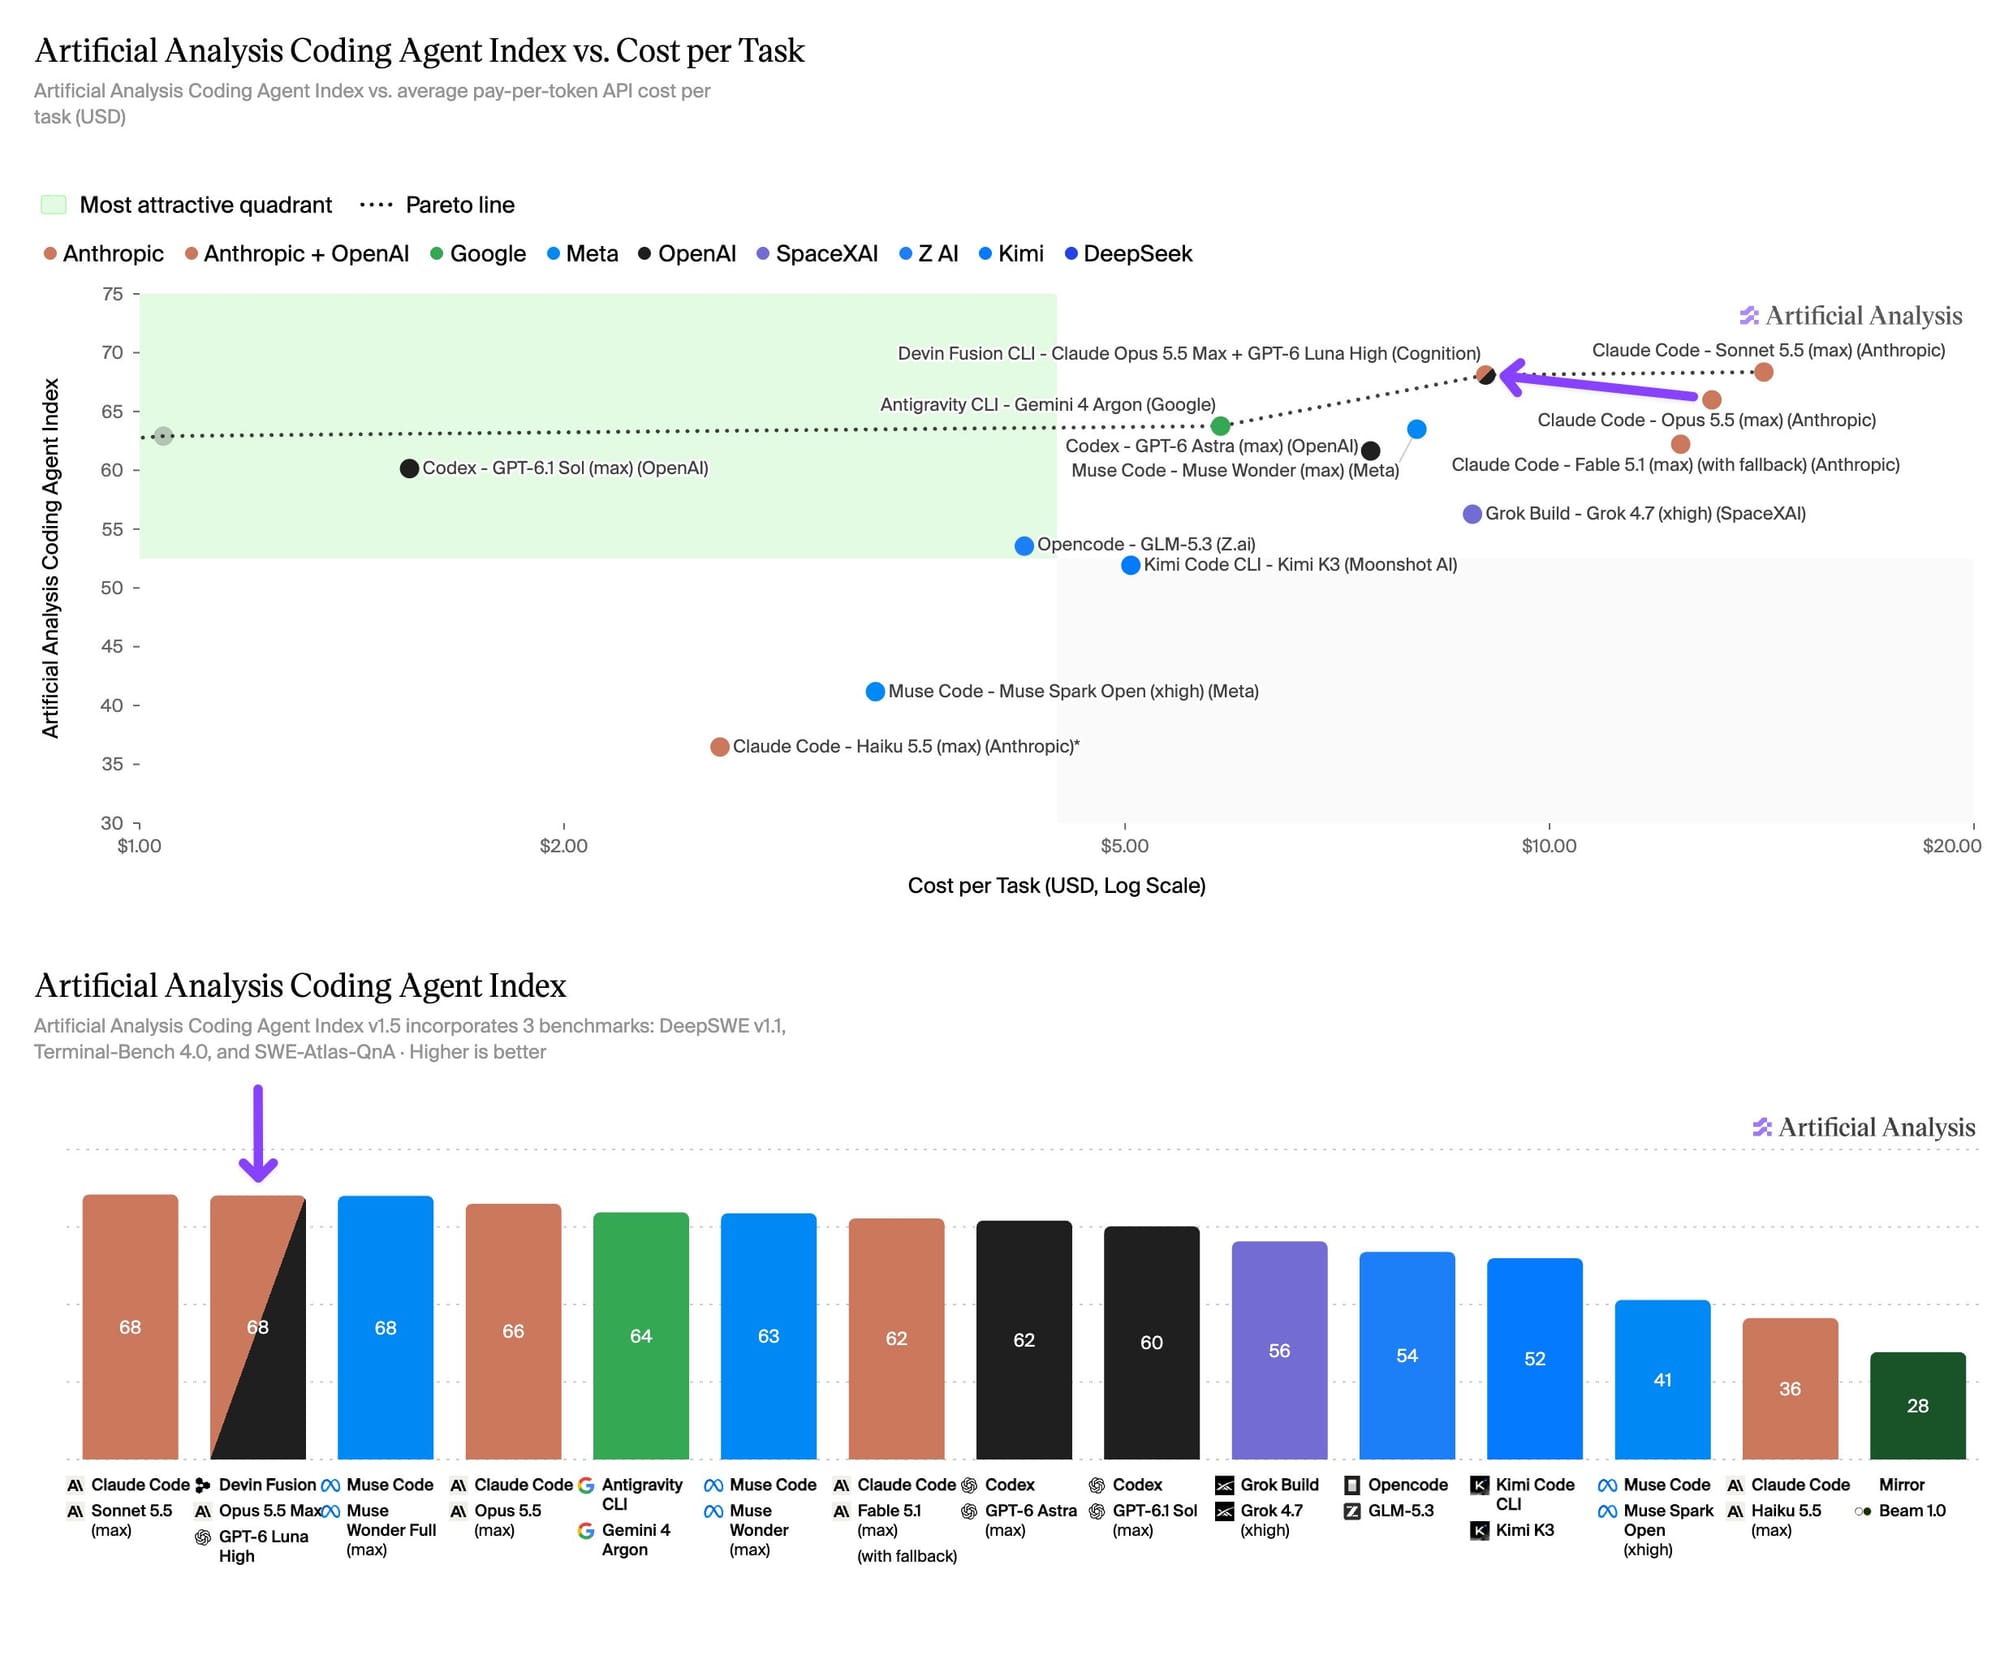
但回到 AA 的榜單,68 分並不是第一名。Claude Code 搭 Sonnet 5.5 得 68.4,Muse Code 搭 Muse Wonder Full 得 68.0。
三者貼在一起,AA 在貼文裡也用「closely matched」形容。
所以要讀的是三件事:2 分的差距算不算大、31% 的成本怎麼算出來,以及這組數字是誰測的。AA 的指數由三個基準組成,共 303 題,每題跑三次,題數不多,所以差距要打折。
我的判斷是,Devin Fusion 對按 API 用量付費、每月在前沿模型上花不少錢的團隊值得試。但現有證據只能說它用較低成本拿到相近分數,不能說它比 Claude Code 更準。
要看懂這個差別,得先理解 Fusion 為什麼要把一個任務拆給兩個模型。
Devin Fusion 是什麼?主導模型負責規劃、副手模型負責動手
Devin Fusion 讓兩個模型在同一個工作階段裡同時運作,一個是前沿主導模型,一個是成本較低的副手模型。
依 Cognition 部落格,主導模型負責計畫、釐清模糊需求與審查成果,副手負責探索程式碼、修改、跑測試並回報。使用者面對的仍是單一個 Devin,配對在背後進行。
部落格解釋,Fusion 刻意避開「依任務難度切換模型」的路由做法。原因有兩個:光看一句「修這個錯誤」無法判斷難度,而且中途換模型會讓提示快取失效。
提示快取是把已處理過的前文保存起來,下次重複使用時按較低價格計費。Fusion 的做法是讓兩個代理各自保有持續的上下文與工具,彼此只交換任務簡報、結果與回饋,所以各自的快取都能延續。
這裡的 harness 指的是替模型配上工具、記憶與執行迴圈的外殼。同一個模型放進不同外殼,成績與成本都可能不同,所以 AA 的榜單列的是「代理加模型」的組合,而不是單一模型。
Fusion 目前是付費功能。官方文件寫明,Devin CLI 3000.10.20 以上與 Devin Desktop 3.10.0 以上可用,免費與試用方案不含,使用舊版或點數制方案的客戶也不能用。
計費方面,主導與副手各按自己的費率計算。CLI 內的 /session-stats 指令可以看各模型的用量、成本與預估的 Fusion 節省金額。
配對建議則有兩個版本。Devin 文件寫「先從 Fable 5.1 搭 SWE-2 開始」,部落格則寫建議 Opus 5.5 搭 GPT-6 Luna,並註明圖表在 10 月 19 日更新過。
兩處都是官方說法,使用前要看你的方案實際列出哪些選項。
知道它怎麼運作之後,下一個問題是 AA 的 68 分到底在量什麼。
Artificial Analysis Coding Agent Index 是什麼?三個基準、三次取平均
Coding Agent Index 是 AA 用來比較「程式代理」的綜合分數,目前是 1.5 版,由三個公開基準等權平均而成。
三個基準各測不同的能力。DeepSWE v1.1 有 113 題軟體工程任務,由 Datacurve 製作。
Terminal-Bench 4.0 有 66 題終端機操作任務,由 Laude Institute 製作。SWE-Atlas-QnA 有 124 題程式庫技術問答,由 Scale AI 製作。
每題跑三次,先算該題三次的平均通過率,再把所有題目平均,所以每題權重相同。結果都是通過或失敗的二元判定,即使程式跑完,只要沒通過驗證就是零分。
AA 也寫明成本是依 API 每個詞元計價換算的費用,並含快取折扣,不等於訂閱價格。Fusion 的數字已合併主導與副手兩個模型的費用。
時間是整個代理流程的牆上時鐘時間,包含推理、工具呼叫與等待。
AA 的說明還提醒,指數相近的兩個代理,強項可能不同,所以要連同各基準的分項一起看。這句話正好適用於這次的比較。
指數的另一個限制是樣本。三個基準加起來只有 303 題,而 AA 頁面沒有顯示信賴區間。
我用二項分布粗估,單一代理的指數標準誤約為 2.8 個百分點。每題跑三次、同一批題目配對比較,實際誤差都會小一些,但 2 分的差距仍不足以斷定誰比較好。這是我的估算,並非 AA 公布的數字。
Devin Fusion 對 Claude Code:差 2 分、省 31% 成本怎麼讀
貼文的重點數字是 68.1 對 66.0,成本 9.01 美元對 13.04 美元,平均時間 55 分鐘對 65 分鐘。
以下我把 AA 榜單頁面在 10 月 21 日晚間查詢的前四名放進同一張表,因為榜單會更新,所以個別數字與貼文略有出入。
| 代理與模型組合 | 指數 | 每題成本 | 平均時間 | DeepSWE | Terminal-Bench | SWE-Atlas-QnA |
|---|---|---|---|---|---|---|
| Claude Code 搭 Sonnet 5.5(max) | 68.4 | 14.19 美元 | 87 分鐘 | 72.0 | 66.2 | 66.9 |
| Devin Fusion 搭 Opus 5.5(max)加 GPT-6 Luna(high) | 68.2 | 9.02 美元 | 55 分鐘 | 72.6 | 62.6 | 69.4 |
| Muse Code 搭 Muse Wonder Full(max) | 68.0 | 頁面未顯示 | 29 分鐘 | 77.0 | 59.1 | 68.0 |
| Claude Code 搭 Opus 5.5(max) | 66.0 | 13.04 美元 | 65 分鐘 | 68.4 | 63.1 | 66.4 |
表中 max 與 high 是推理強度的設定。貼文寫的 Fusion 分數是 68.1,10 月 21 日晚間的頁面是 68.2,Terminal-Bench 與 SWE-Atlas-QnA 的個別數字也各差零點幾分,這是榜單更新造成的,結論不變。
表格裡 Fusion 對 Claude Code 搭 Opus 5.5,在 DeepSWE 高 4.2 分,在 SWE-Atlas-QnA 高 3.0 分,但 Terminal-Bench 低 0.5 分。
貼文寫的差距更大一點,是 62.1 對 63.1。
所以 Fusion 的優勢集中在修改程式碼與回答程式庫問題,終端機操作任務沒有優勢。如果你的工作偏向指令列自動化,這項差異值得留意。
再看成本。以 13.04 美元降到 9.01 美元計算,降幅約 30.9%,與貼文的 31% 一致。時間也從 65 分鐘降到 55 分鐘。
不過把榜首的 Claude Code 搭 Sonnet 5.5 放進來,圖像就不同了。它的指數比 Fusion 高 0.2 到 0.3 分,每題成本卻是 Fusion 的 1.6 倍,時間也多了約 32 分鐘。
這表示 Fusion 在這幾組中的優勢是效率,而不是準確度。
Muse Code 的組合最快,只要 29 分鐘,但 AA 頁面沒有顯示它的每題成本,所以無法比較金額。分數與成本的差距看完了,接下來要問 Fusion 的成本為什麼會比較低。
延伸閱讀:Reason Agent 1.1 比較 Codex:同一模型,為何寫程式的成本仍會不同?
Devin Fusion 為什麼比較省?副手價格、快取命中率與 Cognition 自己的表格
省錢的主因是副手模型便宜很多。依官方定價,Claude Opus 5.5 每百萬詞元輸入 4 美元、輸出 20 美元,GPT-6 Luna 是輸入 0.10 美元、輸出 0.50 美元,兩者每個詞元的價差是 40 倍。
所以只要大部分詞元由副手處理,整體成本就會明顯下降。至於實際有多少詞元由副手處理,我在部落格與 AA 頁面都沒有看到拆分數字。AA 頁面的資料顯示,Fusion 平均每題用了約 1,290 萬詞元,Claude Code 搭 Opus 5.5 則是約 1,550 萬,Fusion 用得比較少。
但 Fusion 的快取命中率較低,AA 頁面顯示約 87%,Claude Code 搭 Opus 5.5 約 95%。快取命中率是輸入詞元中取自快取的比例。
Cognition 部落格說兩個代理各自保有上下文,就是為了讓快取延續。AA 的數字顯示命中率仍較低,兩邊都沒有解釋原因,我也無法從公開資料判斷。
Cognition 自己的表格提供了另一個角度。部落格列出 Fable 5.1 與 GPT-6 Astra 各搭 SWE-2 副手的結果,成本降幅從 11% 到 46%,但分數並非每項都守住。
例如 Astra 搭 SWE-2 在 Terminal-Bench 從 55.6 降到 50.0,在 Vals Code Migration 從 67.7 降到 61.3。Fable 搭 SWE-2 在 DeepSWE 從 64.3 降到 63.1。
也有升的項目,例如 Fable 搭 SWE-2 在 Vals Code Migration 從 54.6 升到 57.3。
部落格開頭的「最多提升 39% 效率」,對應的是 Astra 搭 SWE-2 的例子,成本指數從 100 降到 61。依 AA 榜單,這個配對的指數是 58.9,而 Codex 搭 Astra 是 61.6,也就是低 2.7 分。
所以較精確的描述是,Fusion 的賣點是以更低成本換到相近的成績,Opus 5.5 加 Luna 是目前成績最好的案例,並不代表每種配對都如此。
Cognition 還提出一個反直覺的說法,更貴的模型有時能讓整體更便宜。部落格舉例,主導從 Opus 4.8 換成 Fable 5,每個詞元的名目價格貴一倍,同樣副手下的平均成本卻低 9%,原因是 Fable 更早分派工作,簡報也寫得更清楚。
副手也有類似的例子。以 Astra 為主導時,換用每百萬詞元 0.75 美元的 SWE-2,取代 0.20 美元的 GPT-5.6 Luna,名目價格高 275%。
FrontierCode 的成本卻從 2.39 美元降到 2.34 美元,分數由 62.0 升到 63.4。這些都是 Cognition 自己的測試,我查詢時沒有看到第三方複現。
還有一個測試者的問題。這次的 68 分由 AA 執行並公布,榜單頁面也寫明結果由 AA 獨立測量。但 Cognition 部落格寫明,Fable 5.1 與 Astra 的評測是與 AA 和 Vals AI 合作進行的。
Opus 5.5 加 Luna 這次是否也屬合作,貼文與部落格都沒有交代。另外,Cognition 的圖表註記顯示,10 月 19 日就已放進這筆 68.1,比 AA 的 X 貼文早兩天。所以我不會把它當成與廠商完全無關的結果。知道省在哪裡、誰測的之後,還要把 Fusion 放回整張成本曲線上看。
延伸閱讀:Devin Dreaming 是什麼?Cognition 用 Agent Memory Repo 整理跨任務記憶
Devin Fusion 在成本曲線上的位置:更便宜的組合能拿到多少分
只比 Fusion 與 Claude Code,會漏掉榜單上更便宜的選擇。AA 的另一張圖把指數放在縱軸、每題成本放在橫軸,越靠左上角越划算。
以下我從榜單頁面挑出幾組成本明顯較低的組合,與 Fusion 並列,數字是 10 月 21 日晚間查詢的結果。
| 代理與模型組合 | 指數 | 每題成本 | 平均時間 |
|---|---|---|---|
| Codex 搭 GPT-6.1 Sol(xhigh) | 62.9 | 1.04 美元 | 16 分鐘 |
| Claude Code 搭 Sonnet 5.5(xhigh) | 62.9 | 3.33 美元 | 27 分鐘 |
| Antigravity CLI 搭 Gemini 4 Argon(high) | 63.8 | 5.84 美元 | 35 分鐘 |
| Devin Fusion 搭 Opus 5.5(max)加 GPT-6 Luna(high) | 68.2 | 9.02 美元 | 55 分鐘 |
表格顯示,Codex 搭 GPT-6.1 Sol 的指數是 62.9,每題只要 1.04 美元,約是 Fusion 的九分之一。依表格相除,Fusion 比它多 5.3 分,每題多花約 8 美元,平均多等約 39 分鐘。
這個算法是我自己換算的,只拿平均值相除,沒有考慮各任務的差異。但它說明了一件事:Fusion 與 Claude Code 搭 Opus 比較,確實省了不少。若拿去和更便宜的組合相比,多出來的 5 分是用數倍的錢與時間換來的。
所以選擇的關鍵在你的任務需要多高的通過率。如果多數工作是中等難度、可以接受偶爾重做,較便宜的組合已經能拿到六成多的通過率。如果每次失敗都要花工程師數小時收拾,多付的成本才有意義。
還要補一句,指數 68 並不是「能解決 68% 的真實工作」。它只代表在這 303 題基準上的平均通過率,其中還有一類是程式庫問答,不需要修改程式碼。你的專案和這些題目差得越多,分數的參考價值就越低。所以是否導入,要回到你自己的任務類型與預算。
適合誰、不適合誰:導入 Devin Fusion 前的檢查
Devin Fusion 適合按用量付費、已經在前沿模型上花大量預算的團隊,以及任務能拆成「規劃」與「實作」兩段的程式修改工作。
它不適合免費或試用方案的使用者,因為官方明說不含。以訂閱額度為主的個人使用者也要小心,因為 AA 的成本是 API 計價,而 Fusion 在自助方案下是依各模型費率扣你的額度,省多少要看額度怎麼算。
如果你的主要工作是終端機自動化,Terminal-Bench 的結果顯示 Fusion 沒有優勢,也不必急著換。
導入前的做法很單純。挑 10 個你自己的真實任務,各跑一次 Fusion 與你現在用的單一模型,記錄每個任務的總費用、花費時間與結果品質。
Cognition 文件也建議比較「同類任務的總成本與結果品質」,而不是只看詞元單價。這和部落格主張的「看每題價格,不看每個詞元價格」一致。
記錄時多加一欄「被接受的變更數」會更有用,因為便宜但需要反覆修改的結果,每個真正能合併的變更成本反而可能更高。
安裝時有一個安全提醒。部落格示範的安裝指令,是把網路上的腳本直接交給 bash 執行。比較穩妥的做法是先把腳本下載下來、讀過內容再執行,不要直接照貼。
Devin Fusion 常見問題
Devin Fusion 真的比 Claude Code 更準嗎?
在 AA 的指數上,Fusion 搭 Opus 5.5 與 Luna 得 68 分,Claude Code 搭 Opus 5.5 得 66 分。但差距小到難以排除題目抽樣的影響,Terminal-Bench 還略低。
較有把握的結論是成本與時間較低。
31% 的成本是怎麼算的?
是 AA 公布的每題平均 API 費用,Fusion 約 9.01 美元,Claude Code 搭 Opus 5.5 為 13.04 美元,降幅約 31%。這不是訂閱價格,實際帳單依你的方案而定。
Devin Fusion 要選哪個主導與副手?
Devin 文件建議 Fable 5.1 搭 SWE-2,部落格則建議 Opus 5.5 搭 GPT-6 Luna。目前 AA 公布成績最好的是後者,但你的方案能選哪些模型要以模型選單為準。
訂閱制使用者能省到錢嗎?
官方說明自助方案是依各模型的詞元費率扣你的額度,所以仍可能省,但 AA 的 31% 是 API 費用,不能直接套用。
這是獨立的第三方測試嗎?
測試由 AA 執行,榜單頁面寫的是獨立測量。但 Cognition 說明部分評測是與 AA 合作進行,並在 10 月 19 日就把這筆數字放進自己的圖表,所以不宜視為與廠商完全無關。AA 的方法論與題目來源公開,你也可以對照其他代理的成績。
先用自己的任務比較每題總成本,再決定要不要換
這次的新聞重點是,Devin Fusion 用 Opus 5.5 加 GPT-6 Luna,相對於 Claude Code 搭 Opus 5.5,把每題成本壓低約三成,分數則略高。對重度使用 API 的團隊,這是值得測試的省錢路線。
但 2 分的差距在 303 題的基準上難以斷定,Terminal-Bench 又略低,而且測試與廠商合作的程度並不明確。所以我會把它當作成本選項,而不是準確度升級。
想持續追蹤程式代理與基準榜單的更新,可免費訂閱 AI 郵報,並以 AA 與官方文件核對後續數字。
資料來源
- Artificial Analysis Coding Agent 榜單頁面:https://artificialanalysis.ai/agents/coding
- Artificial Analysis X 貼文(熱度線索與官方公布):https://x.com/ArtificialAnlys/status/2112773422698606736
- Cognition 部落格,Introducing Fusion in Devin Desktop & CLI:https://cognition.com/blog/fusion-in-devin-cli
- Devin CLI 的 Fusion 文件:https://docs.devin.ai/cli/fusion
- Devin Desktop 的 Fusion 文件:https://docs.devin.ai/desktop/fusion
- Anthropic 模型定價頁:https://platform.claude.com/docs/en/about-claude/pricing
- OpenAI API 定價頁:https://developers.openai.com/api/docs/pricing