Dream-1 是什麼?機器人世界動作模型 API 每小時 3 美元,零樣本成績怎麼讀
Dream-1 是 Dream Labs 在 2026 年 10 月 19 日離開隱身模式時推出的機器人世界動作模型,以 API 每小時 3 美元提供。本文整理零樣本成績、Robocurve 評測條件、價格與導入前的限制。

把一台沒見過的雙臂機器人接上網路,傳幾張相機畫面和一句指令,它就開始動手做事,每小時只花 3 美元。Dream Labs 在 2026 年 10 月 19 日離開隱身模式時,用 Dream-1 展示的就是這個畫面。
Dream-1 是一個世界動作模型。這種模型一邊預測接下來的畫面會怎麼變,一邊預測該做什麼動作,所以它看到新機器人的手臂,就能把它當成畫面裡另一種會移動的形狀,再算出動作。
Dream Labs 的官方 X 帳號在 10 月 19 日 17:13 UTC 發文,換算成台灣時間是 10 月 20 日凌晨 1:13。
我查詢時有 1,520 個讚、約 20.5 萬次瀏覽,共同創辦人 Joel Jang 另有一串長貼文,也有 573 個讚。
貼文說它能控制沒見過的雙臂機器人、做沒看過的任務。官方研究頁把這句話拆成幾組數字,但每組數字的基準都不同,有的相對訓練用機器人,有的是人工評分,有的來自第三方評測。
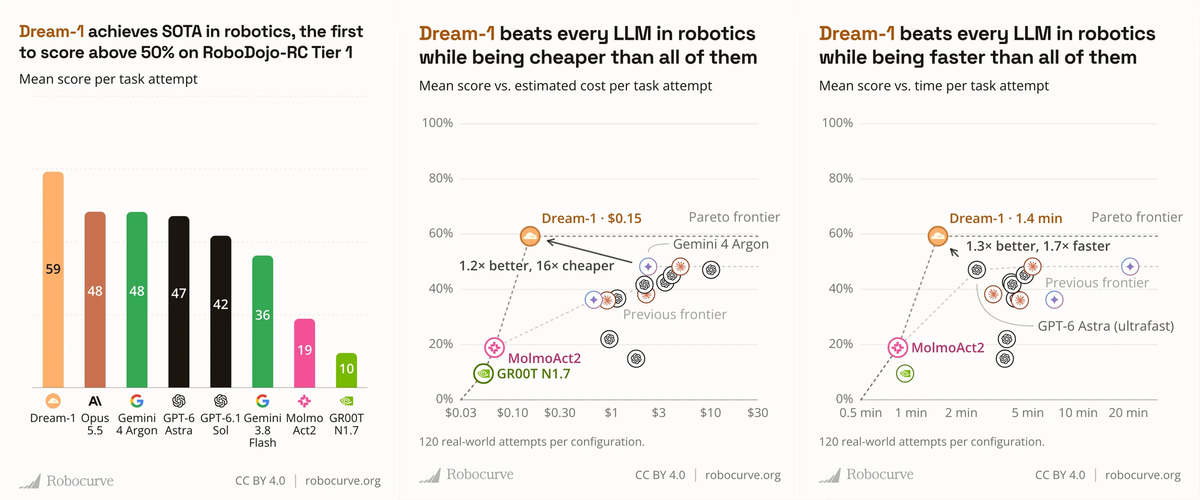
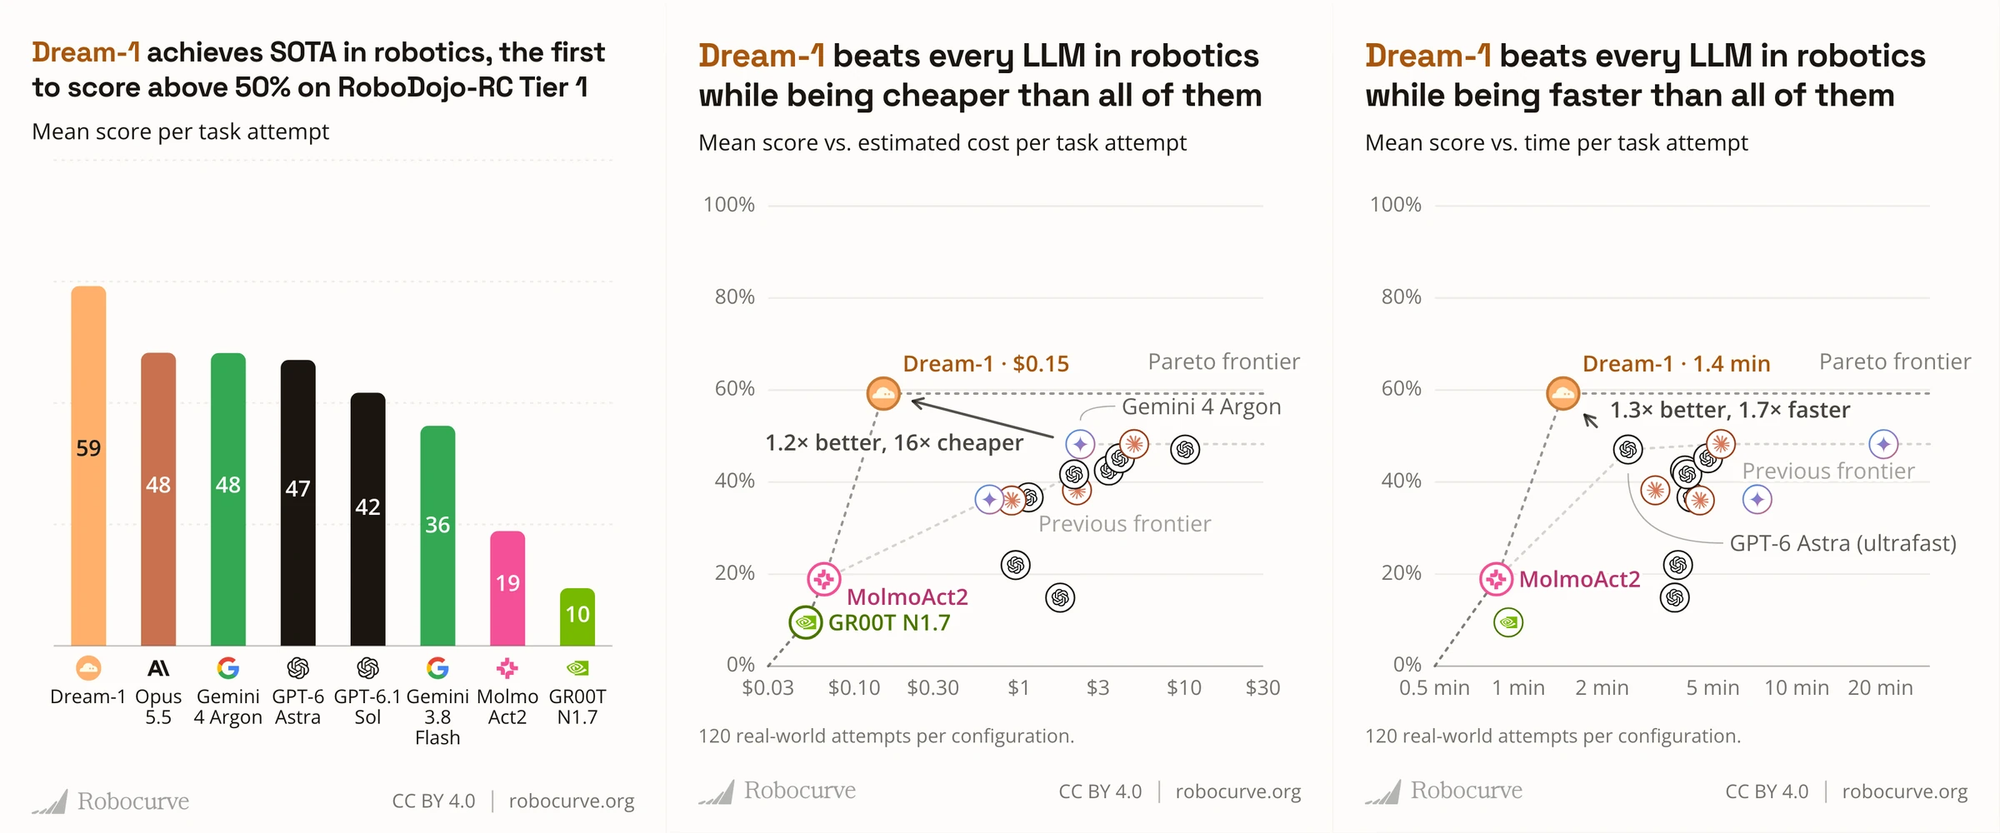
其中最容易誤讀的是 Robocurve 的比較。它在那份評測拿到 59.3%,高過 Gemini 4 Argon 的 48.2%,但依評測規格,用的是它當初訓練的那款機器人,並不是它沒見過的機器人。
我的判斷是,手上已有雙臂機器人、想用現成模型快速驗證任務的研究團隊與新創,現在可以付費試一輪。需要穩定完成任務、處理安全風險或使用靈巧手的場景,目前離可用還有一段距離。
要讀懂這些數字,得先弄清楚它怎麼接上機器人,又是怎麼收費。
Dream-1 是什麼?世界動作模型怎麼用 API 控制機器人
Dream-1 是 Dream Labs 的第一個公開 API 模型,官方說它可以控制沒見過的雙臂、平行夾爪機器人,不需要微調,也不需要該機器人的示範資料。這家公司位於舊金山,同時宣布取得 9,000 萬美元種子輪資金。
團隊的前作是 2026 年 2 月的 DreamZero,由 NVIDIA 研究團隊發表,提出世界動作模型這個詞。
DreamZero 專案頁寫明,只用 30 分鐘、55 條軌跡的 YAM 機器人資料後訓練,就能在這台新機器人上零樣本泛化到沒看過的任務。
零樣本是指模型沒有針對這個機器人或這個任務再訓練,直接使用。官方研究頁說,Dream Labs 的創辦團隊是在這個結果之後決定創業。
使用方式很直接。客戶端把三個相機畫面、機器人目前狀態與任務文字傳給 API,模型回傳機器人要執行的動作,官方稱每次呼叫回傳 1.6 秒的動作。
三個相機是頭部視角加上左右手腕各一個。動作的表達方式是末端執行器位姿,也就是兩個夾爪應該在哪裡、要張開或閉合,再由每個機器人自己的逆向運動學求解器,把位姿換成關節指令。
這個設計是零樣本能成立的關鍵。因為只要是兩隻手臂加平行夾爪,就共用同一種動作語言。官方也承認代價,模型只決定夾爪最終在哪裡,不管手臂怎麼繞過障礙,所以成績會受求解器品質影響。
價格也寫在研究頁上。Dream-1 每小時 3 美元,較輕量的 Dream-1-flash 每小時 2 美元。官方換算一小時共 2,250 次呼叫,所以每次約 0.0013 美元,flash 約 0.0009 美元。
官方還推出微調服務,叫做 Fine-tuning-as-a-Service。使用者在自己的機器人上蒐集資料,交給服務微調,取得專屬模型。
官方另外提供網頁遊樂場,沒有機器人的人可以輪流對實驗室裡的真實機器人下指令,也能操作模擬環境。
研究頁沒有列出模型的參數量與訓練資料量,我讀完全頁,沒有看到這兩項。所以外界目前只能從行為與評測去判斷它的能力,無法從規模去估計。
先弄清楚它怎麼運作,才好讀「沒見過」到底代表什麼成績。
零樣本控制新機器人,成績落在哪裡?
官方研究頁對零樣本的第一組數字,來自 27 款模擬機器人。每款機器人做 300 次嘗試,其中 150 次測 50 項任務的語言指令遵循,另外 150 次測 150 項沒見過的任務。
分數是相對 YAM 的比例,YAM 是它實際訓練的雙臂機器人,記為 100。數字愈高,代表換到新機器人後保留的能力愈多。
這些都是模擬環境的成績,真實機器人官方只放了影片,沒有給分數。下表從 27 款裡挑 10 款,沒列出的款式也都落在 36.6 到 91.2 之間。
| 機器人 | 相對 YAM 的零樣本分數 |
|---|---|
| PiPER 雙臂 | 91.2 |
| Trossen Workbench | 82.8 |
| ARX X5 | 77.4 |
| PR2 | 73.8 |
| UR5e 雙臂 | 69.8 |
| ALOHA | 63.1 |
| Franka FR3 雙臂 | 58.3 |
| SO-101 | 54.2 |
| Mantis | 45.8 |
| Bracket Bot | 36.6 |
我從官方圖表資料把 27 款機器人依序排開,中位數是 62.4,落在 LBR iiwa 14 的位置。也就是說,換一台沒見過的機器人,典型情況是保留約六成的能力,而且最高與最低相差 2.5 倍。
所以「零樣本控制沒見過的機器人」成立,但「和訓練用機器人一樣好」並不成立。夾爪形狀、手臂自由度與逆向運動學求解器的差異,都會讓成績往下掉。
沒見過的機器人,官方還拍了真實影片。研究頁放了 21 段真實雙臂機器人的片段,包含 18 年前發表的 PR2,以 4 倍速播放。
合作夥伴的 12 個測試場地,影片則以 8 倍速播放,所以看影片時要記得它們都被加速了。
第二組數字是沒見過的任務。官方在 YAM 機器人上,按任務類型統計進度分數與成功率,兩者差距很大。YAM 正是訓練用的機器人,所以這組衡量的是新任務,不是新機器人。
| 任務類型 | 進度分數 | 成功率 |
|---|---|---|
| 撿起與放置 | 69% | 40% |
| 插入與嵌合 | 58% | 24% |
| 倒出與舀取 | 55% | 10% |
| 布料與軟物 | 52% | 19% |
| 重新擺向 | 50% | 14% |
| 推動與滑動 | 50% | 19% |
| 使用工具 | 44% | 6% |
| 開關 | 42% | 16% |
進度分數衡量任務做到哪個階段,成功率則要求完整做完。從表中看,最簡單的撿起與放置完整成功率是 40%,使用工具只有 6%。官方圖表附的標準誤差約 3 到 6 個百分點。
頁面另有一組 YAM 換上 UMI 夾爪的結果,成功率在 6% 到 38% 之間,使用工具同樣只有 6%。
這代表它常常「做了一半」。對研究探索這已經很有價值,但要拿去做重複性的工作,需要靠微調把成功率拉高。
微調的成效,官方也列了數字。12 款合作夥伴的機器人在模擬中的語言遵循分數(同樣相對 YAM),微調後有 10 款提高,例如 AI Worker 從 44 升到 84,Mantis 從 28 升到 57。
但 Bracket Bot 從 32 降到 31,Unitree R1 從 42 降到 31,所以微調不保證每一台都變好。
所需資料量也有數字。官方示範的兩台合作夥伴機器人,各只用 5 分鐘資料就看得到差異,離訓練分佈特別遠的機器人要更多,配靈巧手的 Dexmate 用了 77 分鐘,換了特殊末端工具的 YAM 用了 98 分鐘。
官方首頁則寫,幾百筆示範就能調到你的機器人,所以實際需要的資料量要以自己的機器人為準。
延伸閱讀:Pi API 開放 Beta:上傳機器人資料就能微調,雲端控制還要解決什麼?
自家的數字講完,才輪到第三方怎麼量。
它贏過 Gemini 4 Argon 嗎?Robocurve 評測的條件
官方研究頁引用第三方機構 Robocurve 的評測。Robocurve 是公益公司,宣稱獨立評估前沿 AI 控制機器人的能力,並在 2026 年 9 月公布 1,000 萬美元種子輪。
Dream Labs 說這份報告在發表前完成,日期是 10 月 18 日,採用 CC BY 4.0 授權,Dream 頁面上的圖表也標示同樣的授權與 robocurve.org 出處。本文只引用數字並註明來源。
我在 Robocurve 網站查到的表格,用的是 RoboDojo-RC Tier 1 這組基準,每種設定做 120 次真實嘗試。語言模型有 40 次呼叫上限,視覺語言動作模型有 3,600 個控制步驟上限。
| 設定 | 平均分數 | 每次嘗試估計費用 | 每次嘗試分鐘數 |
|---|---|---|---|
| Dream-1 | 59.3% | 0.15 美元 | 1.4 |
| Gemini 4 Argon(高,優先) | 48.2% | 2.34 美元 | 20.5 |
| GPT-6 Astra(高,快速) | 42.5% | 3.48 美元 | 4.0 |
| GPT-6.1 Sol(高,快速) | 41.7% | 2.15 美元 | 4.0 |
| Opus 5.5(高,快速) | 38.2% | 2.23 美元 | 3.1 |
| MolmoAct2 | 18.9% | 0.07 美元 | 0.8 |
| GR00T N1.7 | 9.5% | 0.05 美元 | 0.9 |
Dream-1 的分數最高,費用大約是 Gemini 4 Argon 的十六分之一,這是我用 2.34 除以 0.15 的結果,與官方的「16 倍」吻合。比它便宜的只有兩個開放模型,但分數落後 40 個百分點以上。
要注意費用的算法並不一致。兩個開放模型是用 RunPod 租 RTX 5090 的每小時 1.19 美元估算,Dream-1 是 Dream Labs 託管推論的每小時 3 美元,語言模型則依詞元用量計價。
官方文字還寫它比最快的語言模型快 1.7 倍。這個倍數出自圖片裡對上 ultrafast 設定的 GPT-6 Astra,我在 Robocurve 的表格找不到這個設定。
表格列出的最快語言模型是 Opus 5.5 的 3.1 分鐘,換算約 2.2 倍,所以我只引用表格原數字。
另外,Dream 頁面的長條圖與網站表格不完全一致。圖上 Opus 5.5 與 Gemini 4 Argon 都是 48,GPT-6 Astra 是 47,表格裡 Opus 5.5 是 36.0% 到 38.2%,GPT-6 Astra 是 36.7% 與 42.5%。
我無法確認是設定不同還是資料更新,但兩種版本裡它都排第一。
這份評測的條件要先讀清楚。Robocurve 的規格頁寫明,RoboDojo-RC Tier 1 使用 I2RT 的 YAM 雙臂,這正是它訓練用的那一款,所以依規格推得,這是在熟悉機器人上的成績,不是零樣本跨機器人。
另外,Robocurve 的另一份報告說明,六項任務是從 18 項 RoboDojo 真實任務中,挑出 GPT-6 Astra 表現最好、也最簡單的六項。
題目是依其中一個受測對手的成績挑的,我的解讀是這會讓基準偏向語言模型做得到的事。官方也說這是改編版,與原基準不能直接比較。
同一份報告列出的限制還有,評分由知道模型身分的人工操作員打分,可能有無意識偏誤,物件也由人手動擺回。Dream 這次的報告是否採同樣做法,我沒有看到說明。
Robocurve 也出現在 Dream Labs 列出的 12 個測試場地之中。這不代表評測不獨立,但讀者可以知道兩者在發表前就有接觸。
延伸閱讀:Runway Praxis-1 把影片學習帶進機器人:看懂動作,距離可靠執行還有幾步
成績與條件對照完,接著是導入前要先做的檢查。
導入 Dream-1 前要檢查什麼?硬體、延遲與安全
導入的第一個條件,是你的機器人最好是雙臂加平行夾爪。官方明說目前的版本是針對這類機器人的操作模型,移動操作與靈巧手是日後的方向。不過官方也展示過配靈巧手的機器人,用 77 分鐘資料微調後完成任務。
第二個條件是逆向運動學求解器。官方有寫專門的指南,因為零樣本成績有一部分取決於它。若你的機器人沒有穩定的求解器,成績可能落在表格底端。
第三是延遲與網路。每次呼叫回傳 1.6 秒的動作,所以模型不需要每個控制週期都連線,但雲端往返的不穩定仍會讓動作停頓。官方沒有在研究頁列出實際的往返延遲。
安全方面,官方在頁面上寫得很明白。它是研究 Beta,會犯錯,未經安全關鍵用途的驗證,要在受控環境測試,機器人靠近人時要格外小心,也提供通報不安全行為的信箱。
Robocurve 另有 RoboHarm 基準,測試機器人模型會不會拒絕有害指令。我查到的首頁排行沒有列出 Dream-1,所以它對危險指令的反應,我沒有公開資料可以引用。
適合誰、不適合誰
適合已經擁有雙臂平行夾爪機器人,想快速試探「這個任務能不能用現成模型做」的研究團隊、創客與新創。每小時 3 美元的門檻很低,官方示範的微調從 5 分鐘資料起跳,驗證成本相對可控。
也適合想比較不同機器人模型的人。官方的零樣本數字附有逐款機器人的結果,可以拿來和 DreamZero、其他視覺語言動作模型對照。
不適合要在工廠或家庭穩定重複作業的人。官方自己的數字顯示,沒見過的任務成功率在各類型之間只有 6% 到 40%,即使微調,也只有部分機器人明顯改善。
不適合用於醫療、與人近距離接觸或任何安全關鍵的場合。官方已經寫明未經驗證,這類應用需要自己的安全設計與驗證,不能只靠模型。
延伸閱讀:Microduck 是什麼?Hugging Face 推出 $399 強化學習機器人,功能、開源範圍與限制一次看
導入的限制與風險
首先要提醒的是,影片都是加速播放的。官方標示真實機器人影片是 4 倍速,合作夥伴場地是 8 倍速,模擬是 3 倍速,實際動作比看起來慢很多。
雲端託管也帶來資料問題。機器人的相機畫面會上傳到 Dream Labs,若畫面裡有人臉、文件或工作場所,需要先確認隱私與合約條款,研究頁沒有談資料保存與使用,要另外查服務條款。
供應商風險同樣存在。這是一家剛離開隱身模式的新公司,API 價格、模型版本與服務條款都可能改變,若你的產品依賴它,需要規劃退出方案。
最後,9,000 萬美元的種子輪是公司自己公布的數字,我讀過的官方頁面沒有列出投資人名單。
Dream-1 常見問題
Dream-1 真的不用訓練就能控制任何機器人嗎?
不是任何機器人。官方說的是雙臂、平行夾爪的機器人,零樣本分數相對訓練用的 YAM 約 37 到 91,中位數約 62。需要更好成績時,官方建議用微調服務。
使用要花多少錢?
官方研究頁寫 Dream-1 每小時 3 美元,Dream-1-flash 每小時 2 美元,每小時 2,250 次呼叫。微調服務與遊樂場的價格,我在研究頁沒有看到,需要到官方平台確認。
Robocurve 的評測可靠嗎?
Robocurve 說自己是獨立第三方,公開了任務與評分規則,網站上也有各設定的完整紀錄頁。但評分者知道模型身分,基準經過改編,機器人又是它訓練用的 YAM,所以只能當作有參考價值的第三方資料。
沒有機器人也能試嗎?
可以。官方提供機器人遊樂場,讓使用者輸入指令操作一台真實機器人。官方說明如此,我沒有自己操作過。
先弄清楚評測條件,再決定要不要試 Dream-1
Dream-1 把世界動作模型包成按小時計費的 API,並公開了逐款機器人的零樣本成績與微調所需的資料量,讀者因此有機會自己核對。對想快速驗證雙臂任務的團隊,它值得試。
但「沒見過的機器人」大約只保留六成能力,「沒看過的任務」多數只做到一半,第三方評測依規格又是在訓練用的機器人上完成。導入前最好先用自己的機器人與任務,量一次進度分數與完整成功率。
想持續追蹤機器人模型與世界動作模型的新發展,可以免費訂閱 AI 郵報,也可以回到官方研究頁核對價格與數字是否更新。