Pangram 4.1 更新了什麼?AI 偵測加入不確定範圍,老師與編輯該怎麼讀分數
Pangram 4.1 在 10 月 19 日更新 AI 文字偵測,加入機率輸出與「AI 範圍」提示。本文依官方模型卡整理誤判率、漏判率、50 字下限與中文支援,並說明老師、編輯與求職者看偵測分數時的限制。

台灣時間 10 月 20 日清晨 2 點 27 分,Pangram 的 Max Spero 在 X 上宣布 Pangram 4.1 上線。
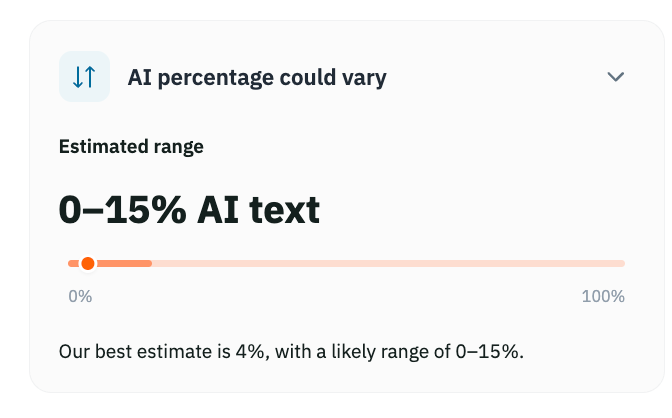
他說團隊把信心程度校準得更好,對不太確定的文件,會用提示顯示一個「AI 範圍」。這則貼文到 10 月 21 日上午有 942 個讚、約 4.5 萬次瀏覽,並附了一張提示框的截圖。
AI 偵測工具一向有個尷尬處境。使用者想要的是一個明確的答案,也就是這篇文章是不是 AI 寫的,但這類工具本質上只能做統計預測,給出一個數字並不等於給出證據。
這次更新就是在處理這個落差。依官方模型卡與貼文,Pangram 4.1 多輸出一組各類別的機率,儀表板對把握較低的文字也改成呈現不確定性,而不是只給單一百分比。
這件事對老師、編輯與審稿人很實用,因為最大的風險是把一個預測值當成定罪依據。我的判斷是,加入範圍提示是好的方向,但它沒有把誤判風險變成零,也沒有交代繁體中文文章的表現。
這個工具適合拿來當初篩與討論的起點,不適合單獨作為處分學生或否決稿件的理由。要明白範圍提示在說什麼,得先弄清楚這次官方實際改了哪些東西。
Pangram 4.1 是什麼?10 月 19 日模型卡寫了哪些變化
Pangram 4.1 是 Pangram Labs 在 10 月 19 日發布的 AI 文字偵測模型,接替 7 月 29 日推出的 Pangram 4。
官方模型卡說,它在整體準確度與「不確定情況下的表現」都有改進,技術基礎仍沿用 EditLens 技術報告。
依官方模型卡,Pangram 把文章切成以句子為單位的片段,替每一段標上三種標籤之一:人類撰寫、AI 輔助、AI 生成。因此它不是只回答「是或不是」,還想分辨 AI 參與的程度。
4.1 的輸入與訓練都沒有改,新增的輸出是 class_probabilities,也就是每個片段屬於三種標籤的機率,各自一個數值。
模型解析度也稍微提高,所以讀者偶爾會在偵測結果中看到較短的片段。這只是判斷切得更細,模型卡沒有說這會讓文章更容易被判成 AI。
穩定性是另一項改進。官方用 29,103 組成對的小幅修改來測試,發現原本不該翻轉的判定結果,在 Pangram 4 有 1.08% 會改變,在 4.1 降到 0.15%。這個數字是 Pangram 自己的內部評測。
還有一項從 Pangram 4 延續下來的功能,是標示文字是否經過「人性化」工具改寫。這類工具專門把 AI 文字改得更像人寫,官方的做法是輸出一個人性化分數,預設門檻在發布時是 0.91。
Pangram 在分析之前,也會先移除刻意混入的特殊字元,並把混用字母的偽裝寫法還原。這些是 4 代就有的設計,4.1 的模型卡寫明推論流程沒有更動。
最後一項是介面。模型卡寫道,儀表板改成對 150 字以下的文字呈現較低的確定性,這可能就是 Max Spero 貼文裡那個提示的來源,但兩者的說法並不完全一致。
說完改了什麼,接著看那個提示框究竟在說什麼。
Pangram 4.1 的「AI 範圍」提示怎麼讀?0–15% 與最佳估計 4%
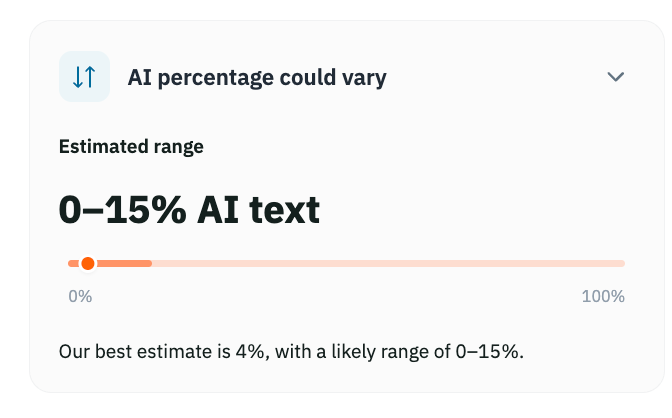
貼文附的截圖標題是「AI percentage could vary」,也就是 AI 比例可能會變動。
框內寫著估計範圍是 0 到 15% 的 AI 文字,下面一行寫著 Our best estimate is 4%, with a likely range of 0–15%,意思是最佳估計是 4%,可能範圍為 0 到 15%。
這張圖傳達的重點是,同一篇文章不再只被貼上一個固定數字。依 Max Spero 的說法,這個提示用在比較不確定的文件,我推測把握較高的文件仍只顯示單一比例。有了範圍,使用者就知道 4% 也可能是 0% 或 15%。
要避免讀錯,得先分清這裡的百分比是什麼。
依模型卡對文件層級欄位的定義,fraction_ai 這類數值是「以字元數加權的比例」,也就是文章中被判成 AI 的部分占多少。截圖裡的 AI percentage 應該就是這類比例,但官方沒有逐欄對照,我的解讀是它不是「這篇文章由 AI 寫成的機率」。
這兩種意思差很多。一篇文章顯示 4%,代表模型認為約有 4% 的字元像 AI 輸出,而不是有 4% 的可能整篇由 AI 完成。
另外,文件層級的 Human、Mixed、AI 三種結論,是依比例門檻決定的。依 Pangram 4 模型卡,至少 90% 字元被判成人寫才算 Human,至少 80% 字元被判成 AI 才算 AI,其餘都是 Mixed,而 4.1 的文件層級輸出沒有更動。
依這條規則推算,如果截圖的 4% 涵蓋所有 AI 參與的部分,那它仍屬於 Human。不過官方沒有說明這個百分比含不含「AI 輔助」,而且 15% 的上限已經超過 10% 的門檻,所以範圍提示的作用,是讓你知道這個結論可能偏高或偏低。
官方資料裡還有一個值得留意的細節。Max Spero 的貼文說,範圍提示用於「比較不確定的文件」,模型卡則寫成「對 150 字以下的文字呈現較低確定性」。
兩種說法不完全相同,所以我無法確認觸發範圍提示的完整條件,只知道短文會顯示得更保守。
另外,Pangram 4 的模型卡原本就說明,confidence 欄位的高、中、低是根據模型後驗分布的集中程度,不是校準過的機率。
Max Spero 的貼文說 4.1 把信心程度校準得更好,但 4.1 模型卡裡沒有出現任何校準評測,所以這句話目前只能當成官方宣稱。
延伸閱讀:美國 STEM 博士論文摘要 29% 被判定含 AI 寫作:用 AI 的人較少走學術,代表訓練變差嗎?
提示框讓使用者看到了不確定性,但不確定性有多大,要看官方列出的誤判與漏判數字。
Pangram 4.1 的誤判率與漏判率:比 4.0 好在哪、差在哪
整體來看,4.1 的人寫文章誤判率比 4 低,英文 AI 文章的漏判率則略升。誤判是把人寫的文章判成 AI,漏判是把 AI 寫的文章判成人寫。Pangram 在準確度文章中說,他們刻意把工具調成寧可漏判也不要誤判,因為誤判可能造成真實的傷害。
4.1 的模型卡把兩種錯誤都列出來,我把它和 Pangram 4 並排放在一起。
| 評測項目 | 樣本 | Pangram 4.1 | Pangram 4 |
|---|---|---|---|
| 人寫英文網頁(FineWeb,排除非自然文字) | 781,981 篇 | 誤判 70 篇,0.0090% | 0.0164%(128 篇) |
| 人寫文章,104 種語言(FineWeb2) | 1,000,000 篇 | 誤判 33 篇,0.0033% | 0.0042%(42 篇) |
| AI 英文文章,26 個生成模型 | 520,000 篇 | 漏判 1,899 篇,0.3652% | 0.3396% |
| AI 多語文章,18 種語言 | 190,149 篇 | 漏判 3,793 篇,1.99% | 1.24%(Pangram 4 模型卡) |
表格的第一個結論是,4.1 在人寫文章上的誤判率更低,英文網頁從 0.0164% 降到 0.0090%,約減少四成多。我依官方表格相除,英文誤判的件數從 128 降到 70,減幅約 45%。
第二個結論是漏判率反而略升。英文 AI 文章的漏判率從 0.3396% 升到 0.3652%,這和官方「寧可漏判也不要誤判」的取向相容,但官方沒有說明漏判率上升是不是刻意的取捨。
分模型來看,結果有升有降。
Claude 系列的漏判率從 0.195% 降到 0.181%,GPT 系列從 0.316% 微升到 0.323%,Gemini 系列則從 0.498% 升到 0.598%,Grok 4.3 從 0.605% 升到 0.720%。
所以 4.1 不是全面進步。對某些模型寫的文章,它比較容易看出來,對另一些則稍微退步,使用者不宜只看總平均。
多語言的漏判率退步得更明顯。同樣是 190,149 篇的多語言 AI 文章,Pangram 4 模型卡列的漏判率是 1.24%,4.1 是 1.99%,我依兩張模型卡相除,約是 1.6 倍。
Pangram 4 的模型卡把件數寫成 23,578 篇,與 1.24% 對不上,所以我只引用比例。
還有一個容易被忽略的比較口徑問題。
10 月 16 日 Pangram 的準確度文章說,Pangram 4 在 2,046,273 篇人寫文件上的誤判率是 0.0041%,但在 4.1 模型卡的英文網頁評測,同一個 Pangram 4 是 0.0164%。
這兩個數字相差四倍,我的判斷是差在評測資料:準確度文章說人寫資料來自授權與自有文本,4.1 模型卡的英文評測則用 FineWeb 網頁文字,官方沒有逐項解釋這個差距。所以不同資料集的誤判率不能直接比較,官方數字也不是你手上那批文章的保證值。
第三方評測方面,模型卡列了三項:非英語母語者的 91 篇人寫文章誤判為 0,Jabarian 與 Imas 的 15,936 篇測試誤判與漏判都是 0,另一項只有 39 篇 AI 文章,漏判也是 0。
其中第一項與第三項的樣本分別只有 91 篇與 39 篇,所以參考價值有限。
還有一層資料落差要留意。FineWeb 是大型網頁文字資料集,模型卡也說英文評測排除了垃圾訊息、廣告與機器產生的列表,所以它代表的是一般網頁上的人類寫作。
學生作業、求職信、公司公告與社群貼文,寫法與長度都不一樣,因此這些誤判率能說明模型在網頁文字上的表現,卻不能直接當成你所在場景的錯誤率。
偵測分數能當證據嗎?教育與編輯現場的風險
答案是不能單獨當證據,原因要分成幾層看。第一層是文章長度。Pangram 的設計是處理至少 50 字、以完整句子寫成的散文,字數越少越不穩定。
依 10 月 16 日的準確度文章,Pangram 4 在 50 到 99 字的文章上,誤判率約 0.02%、漏判率約 1.29%,250 到 499 字則是 0.004% 與 0.21%。
所以越短的文字,數字越不可靠,這是官方自己列出的限制。
第二層是混合寫作。官方資料顯示,被 AI 大幅修改的文章,約 41% 被判成人類、55% 被判成混合、3.6% 被判成 AI,Pangram 的說法是遇到混合文字時,它「偏向判成人類」。
這代表被 AI 大幅改寫過的作業,約四成會被判成人類,單看「是不是 AI」的標籤,很容易低估 AI 的參與。反過來,只用 AI 做文字潤飾的文章,99.45% 仍被判成人類,官方認為輕度校稿應該維持人類標籤,這是刻意的設計。
所以偵測結果無法回答「他有沒有用 AI」,只能回答「文字看起來像誰寫的」。
第三層是不適用的文體。官方列出的範圍外項目包括程式碼與標記語言、機器翻譯、目錄與參考文獻、制式或自動產生的文字、操作說明與食譜、以數學符號為主的內容。詩的誤判率在各領域中最高,達 0.078%。
第四層是語言。Pangram 的支援語言清單有 24 種,包含中文,4.1 在 FineWeb2 中文子集(2022 年前的文章)的誤判率是 0。
但我查了 4.1 與 4 的模型卡和準確度文章,官方沒有區分繁體或簡體,也沒有列出中文子集的樣本數。
AI 文章被漏判的比例也要看,Pangram 4 的模型卡列出中文漏判率為 0.7133%,樣本是用英文文章合成的多語言 AI 文章,4.1 的模型卡沒有再列各語言的漏判率。所以台灣的老師或編輯不宜直接套用英文的準確度。
官方在模型卡的倫理段落也直說,這個模型的錯誤率不是零,錯誤可能造成名譽損害與情緒創傷,並承諾持續與使用者及學界溝通如何解讀結果。
綜合這些限制,我的看法是,偵測分數適合拿來決定「要不要多看一眼」,不適合拿來決定「要不要處分」。下一步是怎麼把它放進實際流程。
誰適合用 Pangram 4.1?導入前的檢查
適合使用的情境,是出版編輯、內容平台、招募人員與老師想先篩出需要人工複核的稿件。這時工具負責縮小範圍,最後的判斷仍由人來做。
不適合的情境有兩類。一是單獨用分數處分學生或拒絕求職者,二是用來檢查程式碼、翻譯稿、詩或食譜這類官方列為範圍外的內容。另外,若稿件普遍不到 150 字,即使有範圍提示,結果也不宜當作主要依據。
價格方面,我在 10 月 21 日查看 Pangram 定價頁,個人方案標示每月 20 美元,附 7 天試用,可掃描每月最多 30 萬字。
專業方案每月 65 美元,團隊方案每月 40 美元含兩個席位。免費方案的額度,定價頁只提到存在,我沒有查到細節。
導入前,我建議先做幾件小事。先挑一批已知作者的舊稿件,含你們自己寫的中文稿與確定使用過 AI 的稿件,跑一遍看結果是否合理。再訂一條規則,被標示為可疑的稿件要經過第二位人員複核,並給作者說明與申訴的機會。
如果你是開發者,模型卡把 class_probabilities 列為 4.1 新增的片段層級輸出,但我在 API 文件的回應欄位中沒有看到這一項,能不能拿到要先向官方確認。若拿得到,門檻要用你自己的資料驗證,不能直接照抄官方的判定規則。
使用 API 的人還要注意一件事。Pangram 的 API 文件範例仍只列出 default 與 pangram-4 兩個模型選項,並說 default 會跟著 Pangram 目前的預設模型走。
我在這頁沒有找到 4.1 如何選用的說明,也看不出現在的預設是哪一版,所以串接前要自己確認回傳的模型版本。
Pangram 4.1 常見問題
Pangram 4.1 判定 AI 寫的文章,可以當作作弊證據嗎?
不建議,官方模型卡自己承認錯誤率不是零,而且工具只能預測文字看起來像誰寫的。
Pangram 4.1 能判斷繁體中文嗎?
官方支援語言清單有中文,但我查到的官方頁面沒有區分繁體與簡體,也沒有中文樣本數,Pangram 4 模型卡列的中文漏判率是 0.7133%,建議自行用台灣稿件測試。
為什麼同一個 Pangram 4 有兩種誤判率?
因為評測資料不同,0.0041% 來自 Pangram 準確度文章的人寫文件集,0.0164% 來自 4.1 模型卡的英文網頁集。
0–15% 是指這篇文章有 15% 機率是 AI 寫的嗎?
依模型卡的欄位定義,我的解讀是它指的是 AI 文字所占的比例範圍,不是整篇的機率。
結語:偵測工具是篩子,不是法官
Pangram 4.1 做對了一件事,就是承認自己有不確定的時候,而且把這件事放進介面。誤判率與穩定性的數字也比 4 更好,但英文漏判率略升,多語言漏判率升得更多,對不同模型的表現也有升有降。
如果你是老師、編輯或招募人員,可以把它當成第一道篩子,再用人工複核補上判斷。如果你是被偵測的人,應該知道這些數字不等於定罪,遇到爭議時可以要求對方說明依據。
想了解另一條判斷 AI 文字來源的路線,也就是從模型端加水印,可以接著讀站內這篇整理,再回到 Pangram 官方頁面追蹤後續模型卡更新。
延伸閱讀:OpenAI textGrain 文字水印上線:ChatGPT、Codex 適用範圍與偵測限制