EurekaBench 是什麼?AI 預測接近人類,科學洞見仍有落差
EurekaBench 用 26 項跨領域任務與 306 個洞見問題測試 AI 科學研究。本文拆解預測準確度、科學限制與機制理解,說明模型擬合資料與發現規律之間的差別。

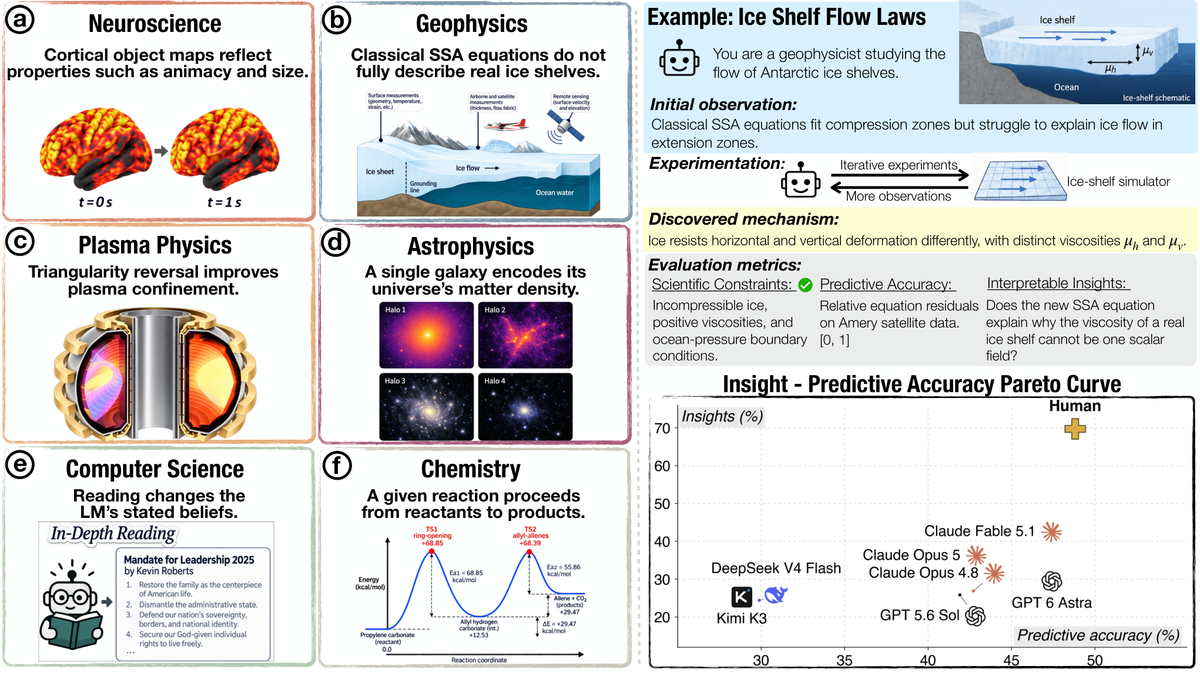
EurekaBench 是測試 AI 能否透過實驗發現科學機制的評測。研究者給代理一個需要解釋的現象,讓它操作實驗環境、提出模型,再檢查成果能否支持有意義的科學洞見。
2026 年 9 月底公布的研究,在 X 上重新引起 AI 科學家的討論。它提醒了一個容易被分數掩蓋的差異:模型能把預測做準,仍可能說不清楚現象為什麼發生。對期待 AI 協助研究的人,這個差異會影響怎麼交付任務、怎麼驗收。
EurekaBench 如何測試科學發現
依原始論文,評測包含 26 項長程任務,涵蓋神經科學、化學、天體物理、地球物理、電漿物理與電腦科學,合計 306 個科學洞見問題。
長程任務是需要多次操作與檢查的工作,代理不能只回答一道選擇題。它必須從初始觀察出發,在實驗環境中比較假設,交付能解釋現象的機制。
研究分開評估三件事:提出的機制是否符合已知科學限制、能否預測測試資料,以及能否帶出可延伸的洞見。這種拆分讓「答案很準」不會自動等於「解釋很好」。
預測與理解,為什麼會出現不同分數
論文報告 GPT-6 Astra 的預測準確度為 47.4%,人類參考為 48.8%。但在科學洞見分數上,兩者分別為 29.4% 與 69.7%。這些數字屬於該評測的任務、預算與評分方式,不能直接當成模型全面研究能力的排名。
想像模型預測一杯熱水何時變涼。它可能找到一條很貼近觀測值的曲線,但如果不知道杯子材質、環境溫度與熱交換的關係,換一個杯子就可能失準。這是用來理解評測的例子,並非論文的一項實測結果。
EurekaBench 關注的機制,就是能把變化背後的關係說清楚。科學洞見則進一步問,這個機制是否讓研究者理解更多現象,或知道下一次實驗應該測什麼。
AI 科學家容易卡在哪裡
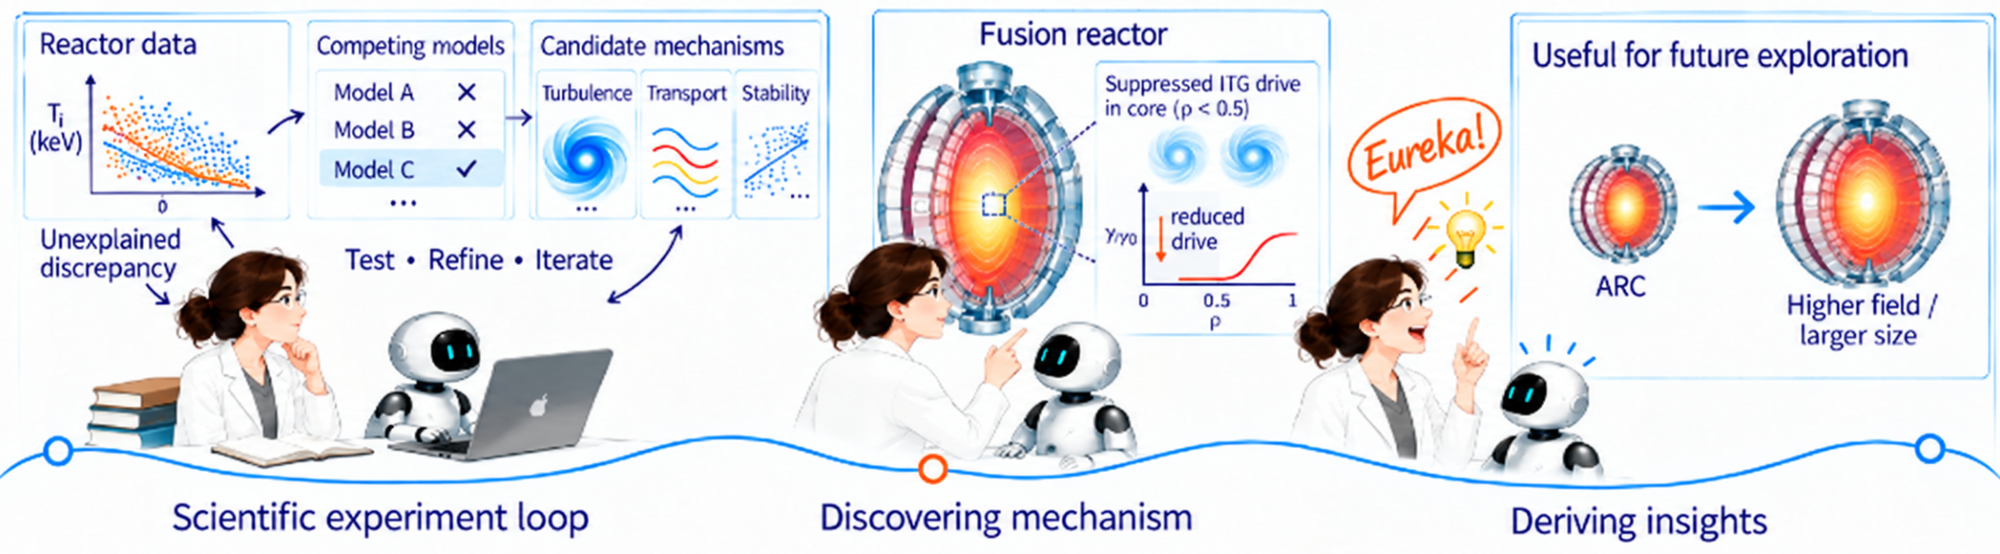
研究分析指出,代理常把任務當成提高預測分數的最佳化問題,對不確定性缺乏足夠的深入探索。最佳化是反覆調整方法,使某個指標變好的過程,但指標變好不一定能排除其他解釋。
例如兩個不同機制都能解釋現有資料,研究者需要設計能區分兩者的實驗。如果代理只繼續調參數,它可能得到更漂亮的曲線,卻沒有回答兩個假設哪個比較可信。
這也說明為什麼工具使用與研究品質應分開驗收。代理確實跑了程式、生成圖表,不代表已完成推導與對照實驗。
團隊應該怎麼交付研究任務
比較可用的任務要求,是讓代理同時交出假設、實驗紀錄、替代解釋與仍未解決的問題。每個結論都應能連回實際觀測,而資料不足的部分可以留在研究成果中的限制說明。
| 驗收問題 | 要檢查的證據 |
|---|---|
| 預測是否準確 | 分開保留的測試資料與結果 |
| 機制是否合理 | 已知限制與可解釋的變數關係 |
| 是否排除其他解釋 | 對照實驗與假設比較 |
| 是否有新洞見 | 由機制推出的新問題或預測 |
我的判斷是,EurekaBench 比單一正確率更接近研究工作的需求。它也有邊界:26 項任務無法代表所有科學,洞見評分需要專家設計與評審。它提供了更好的檢查方向,仍需和實際研究成果一起看。
常見問題
EurekaBench 證明 AI 不懂科學嗎?
研究顯示受測代理在科學洞見上有明顯不足。這是特定評測下的結果,不能推導成所有 AI 在所有領域都沒有價值。
分數接近人類,為什麼仍有落差?
預測準確度與科學洞見是分開的指標。能預測資料,和能提出有用機制,需要不同證據。
研究者還能把哪些工作交給 AI?
可以讓它整理假設、撰寫實驗程式與比較結果,再由研究者檢查對照條件與結論。用途應配合可驗證的工作內容。
結語:讓研究成果回答「為什麼」
AI 科學工具值得繼續發展,但驗收應包含可解釋的機制與有用的下一步。EurekaBench 將這些能力拆開測試,讓團隊能更清楚看見代理已完成的工作,以及仍需要研究者判斷的部分。