讓 AI 在歷史中「做夢」實現自我進化!Google DeepMind 發表 Dream-RSI:告別微調權重,探索算力成本暴降 162 倍,揭開遞歸自我改進(RSI)新範式
Google DeepMind 震撼發表 Dream-RSI(arXiv:2609.14858)!首創將歷史發現樹轉化為經驗回放模擬器,讓 AI 在低成本「夢境」中自我進化探索策略。Lasso 算法任務算力調用縮減 162 倍且超越 scikit-learn,刷新幾何極值與 GPU Kernel 性能,開啟安全高槓桿的 AGI 自展新範式。
「生物大腦之所以能在殘酷的自然選擇中勝出,是因為我們不需要在現實中每一次跳下懸崖來驗證重力——我們會在睡眠與夢境中,重播白天的記憶,並在低成本的心智模擬中演繹數千種生存策略。
今天,Google DeepMind 的 Dream-RSI 為自主 AI 找到了同樣的演化鑰匙:它不再需要每一次都燒掉數十萬美元在現實環境中試錯;它學會了在歷史經驗中『做夢』,並在夢境中完成了智慧的自我迭代。
這是我們見過最精雅、最安全、也最具算力槓桿效益的遞歸自我改進(RSI)閉環。」
—— 科技加速主義社群知名意見領袖 @Dr_Singularity 於社群平台 X(Twitter)引爆全球熱議之官方專文評析
在人工智慧探索通用智慧(AGI)的長征中,有一個被科學界追尋了整整一甲子的終極聖杯——遞歸自我改進(Recursive Self-Improvement, RSI)。
早在 1965 年,傳奇數學家兼密碼學家 I. J. Good 就在其經典論文《Speculations Concerning the First Ultraintelligent Machine》中寫下了一段震撼後世的預言:
「若能製造出一台具備超強智力的機器,它可以設計出更優秀的機器;那麼毫無疑問,將會引發一場『智慧爆炸』(Intelligence Explosion),人類的智力將被遠遠拋在身後。」
然而,整整 60 年過去了,現實中的 AI 研發卻陷入了一堵巨大的「工程泥淖」。
過去幾年,以大語言模型(LLM)為核心的 AI 突破,本質上仍然依賴於**「人類投餵海量數據」與「人類工程師在外部手工調參」**的被動式進化。每當學界嘗試讓 AI 進行自主的遞歸自我改進時,總會一頭撞上兩座看似無法逾越的高牆:
- 「權重自我修改」的毀滅詛咒:直接讓模型在線重訓、修改自己的神經網路權重或程式碼,極易引發災難性遺忘(Catastrophic Forgetting)、獎勵駭入(Reward Hacking)與不可逆的認知漂移(Cognitive Drift),最後產出一個說胡話的「癲狂模型」;
- 「缺乏低成本模擬器」的算力黑洞:AlphaGo 與 AlphaZero 之所以能在圍棋上自我對弈數億盤,是因為棋盤規則是封閉、確定且計算成本趨近於零的「完美模擬器」;然而,在開源算法設計、數學定理證明、GPU 底層 Kernel 優化等真實科研世界中,根本不存在免費的模擬器。AI 每測試一段代碼,都必須調用昂貴的大模型生成、調用編譯器、在真機 GPU 上跑幾分鐘基準測試——一次長程探索就可能燒掉數萬美元,在線強化學習的算力成本直接呈幾何級數崩潰。
難道沒有廉價模擬器的現實世界,就永遠無法迎來自我進化的智慧飛輪嗎?
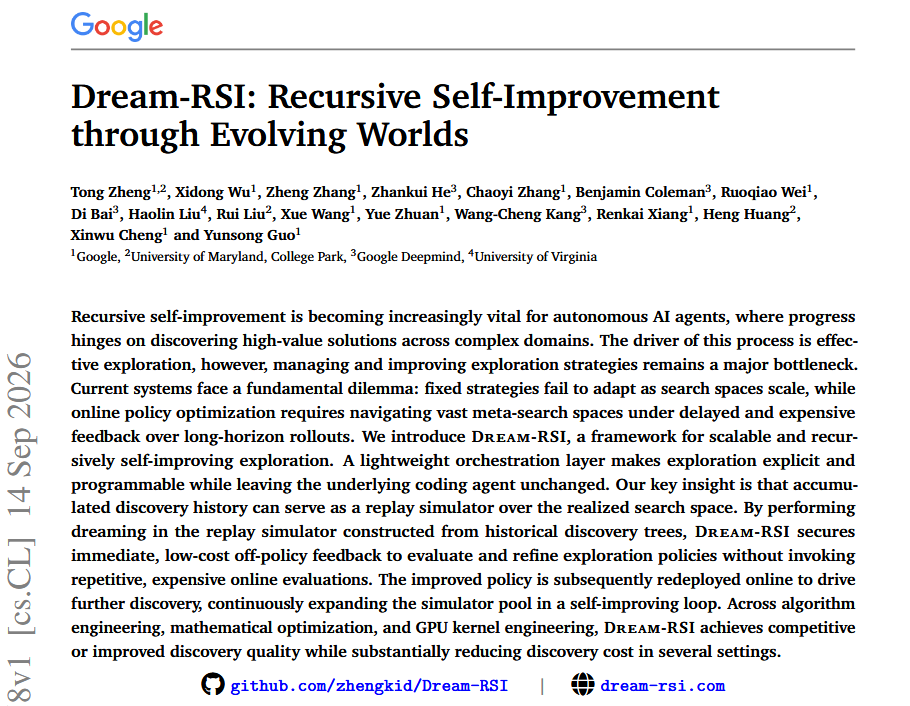
2026 年 9 月 14 日,Google Research、Google DeepMind、馬里蘭大學(UMD)與維吉尼亞大學(UVA)組成的 17 人頂尖跨機構研究團隊,正式向全球學術界投下了一枚重磅炸彈:正式發布論文《Dream-RSI: Recursive Self-Improvement through Evolving Worlds》(arXiv:2609.14858,由 Tong Zheng 領銜,Zhankui He、Benjamin Coleman 等 DeepMind 學者聯合巨獻)。
這篇論文一經社群平台 X 上著名科技推手 @Dr_Singularity 轉發解析,便瞬間引爆矽谷工程師圈與投資界狂潮。
Dream-RSI 提出了一個石破天驚的全新範式:
不要去動底層大模型的權重,也不要浪費算力在現實中反覆試錯!AI 過去每一次探索留下的「歷史失敗與成功軌跡(發現樹)」,本身就是一座無比真實、零成本的「經驗回放世界模擬器」!
讓 AI 在離線的歷史資料庫中「做夢(Dreaming)」,以反事實推演在幾秒內評估數萬種搜尋策略;一旦挑出最強的調度演算法,再重返現實世界展開高維探索!
在嚴苛的科研基準測試中,Dream-RSI 創造了令人瞠目結舌的奇蹟:
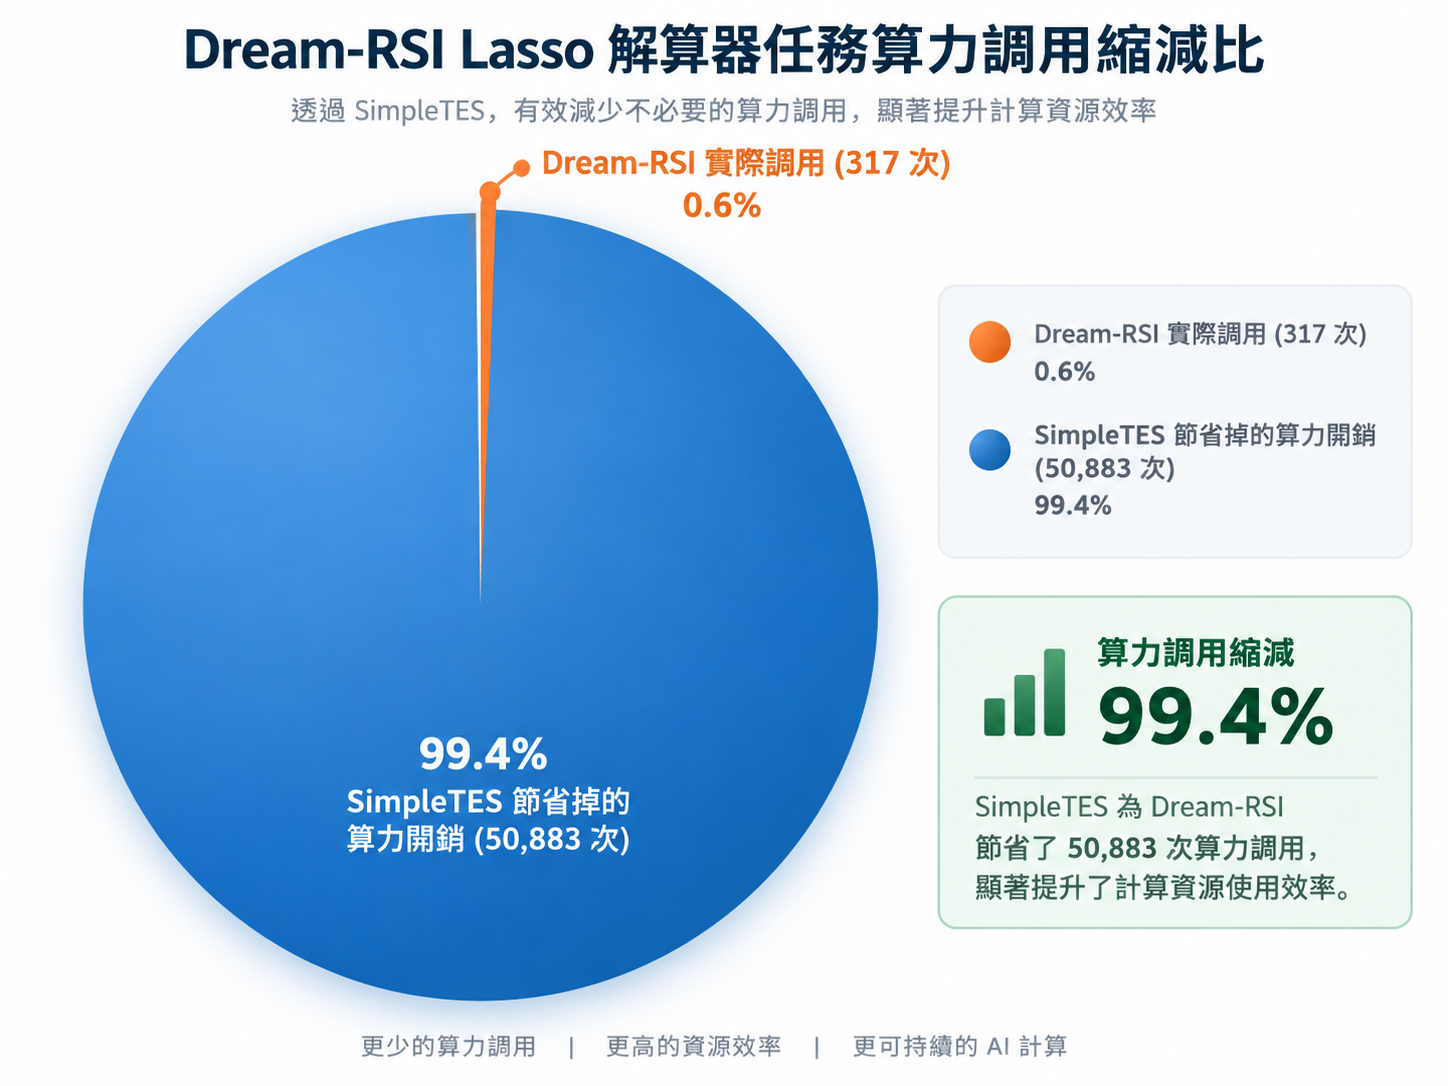
- 在 Lasso 算法工程任務中,Agent 呼叫次數從原本 baseline 的 51,200 次斷崖式暴降至 317 次——帶來高達 162 倍的算力槓桿! 其自主合成的解算器性能全面超越了全球機器學習界使用十餘年的工業標準庫
scikit-learn; - 在純數學極值問題(圓形堆積 Circle Packing、和差問題)上,以不到 1/50 的算力開銷,持平甚至刷新世界紀錄;
- 更打破了傳統提示詞工程的神話:論文證實,人類精心設計的「高層次語義指導(Semantic Guidance)」非但沒有幫助,反而會誘發「過早語義偏見」,扼殺 AI 的搜尋多樣性!
這不僅僅是一篇頂會論文,它是人類第一次找到了一條**「不修改模型權重、不依賴外部模擬器、不會失控癲狂,且算力成本大幅下降」**的可行 AGI 自展通道。
本文將為你全方位深度拆解這場引發全球熱議的技術風暴。
快速重點導覽:Dream-RSI 與歷代 AI 自主發現架構核心對比
要理解 Dream-RSI 的顛覆性,我們必須將它放在過去幾年 AI 演算法工程與科研探索的技術演進圖譜中對比:
| 評比維度 | 傳統啟發式搜尋 (Heuristics) | 經典演化演算法 (如 FunSearch) | 暴力在線 RL (如 SimpleTES) | Google Dream-RSI (2026 最新突破) |
|---|---|---|---|---|
| 探索策略來源 | 人類工程師純手工硬編碼 (Hardcoded) | 固定提示詞 + 遺傳突變選擇 | 在線策略梯度探索 (Online Rollouts) | 「歷史經驗回放做夢」離線遞歸自展 |
| 底層模型權重 | 凍結(通常不用 LLM) | 凍結(僅作為代碼變異生成器) | 頻繁微調,易引發災難性遺忘與漂移 | 完全凍結(Frozen),零權重修改風險 |
| 模擬器依賴 | 必須依賴封閉環境或環境回饋 | 每次候選代碼均需真機執行評估 | 每次探索策略調整均需海量真機評估 | 自建「經驗回放模擬器池」,歷史軌跡即世界 |
| 策略評估成本 | 人類離線調試,極度昂貴緩慢 | 隨生成次數線性增長,開銷巨大 | 天文數字(每步都需要調用數萬次 LLM) | 接近於零(Near-zero cost),僅遍歷歷史樹 |
| 探索調用量 (Lasso實測) | N/A(依賴現成庫) | 數萬次調用,容易卡在局部最優 | 51,200 次 Agent 生成呼叫 | 僅需 317 次呼叫(算力成本縮減 162 倍!) |
| 抗過擬合與多樣性 | 依賴專家直覺,易有人類先驗盲點 | 依賴島嶼模型(Island Models)維持多樣性 | 容易在單一反饋路徑上迅速過擬合 | 反事實夢境推演,徹底杜絕過早語義偏見 |
| 自我改進閉環 (RSI) | ❌ 無法自我進化 | ⚠️ 弱自我進化(僅代碼庫擴充,策略不變) | ⚠️ 脆弱進化(權重更新易崩潰) | ✅ 強自我進化(策略與歷史世界動態共生飛輪) |
一、 智慧爆炸的六十年死局:為什麼「遞歸自我改進」過去行不通?
要讀懂 Dream-RSI 的巧奪天工,必須先看清為什麼先前的所有自我改進路徑幾乎全軍覆沒。
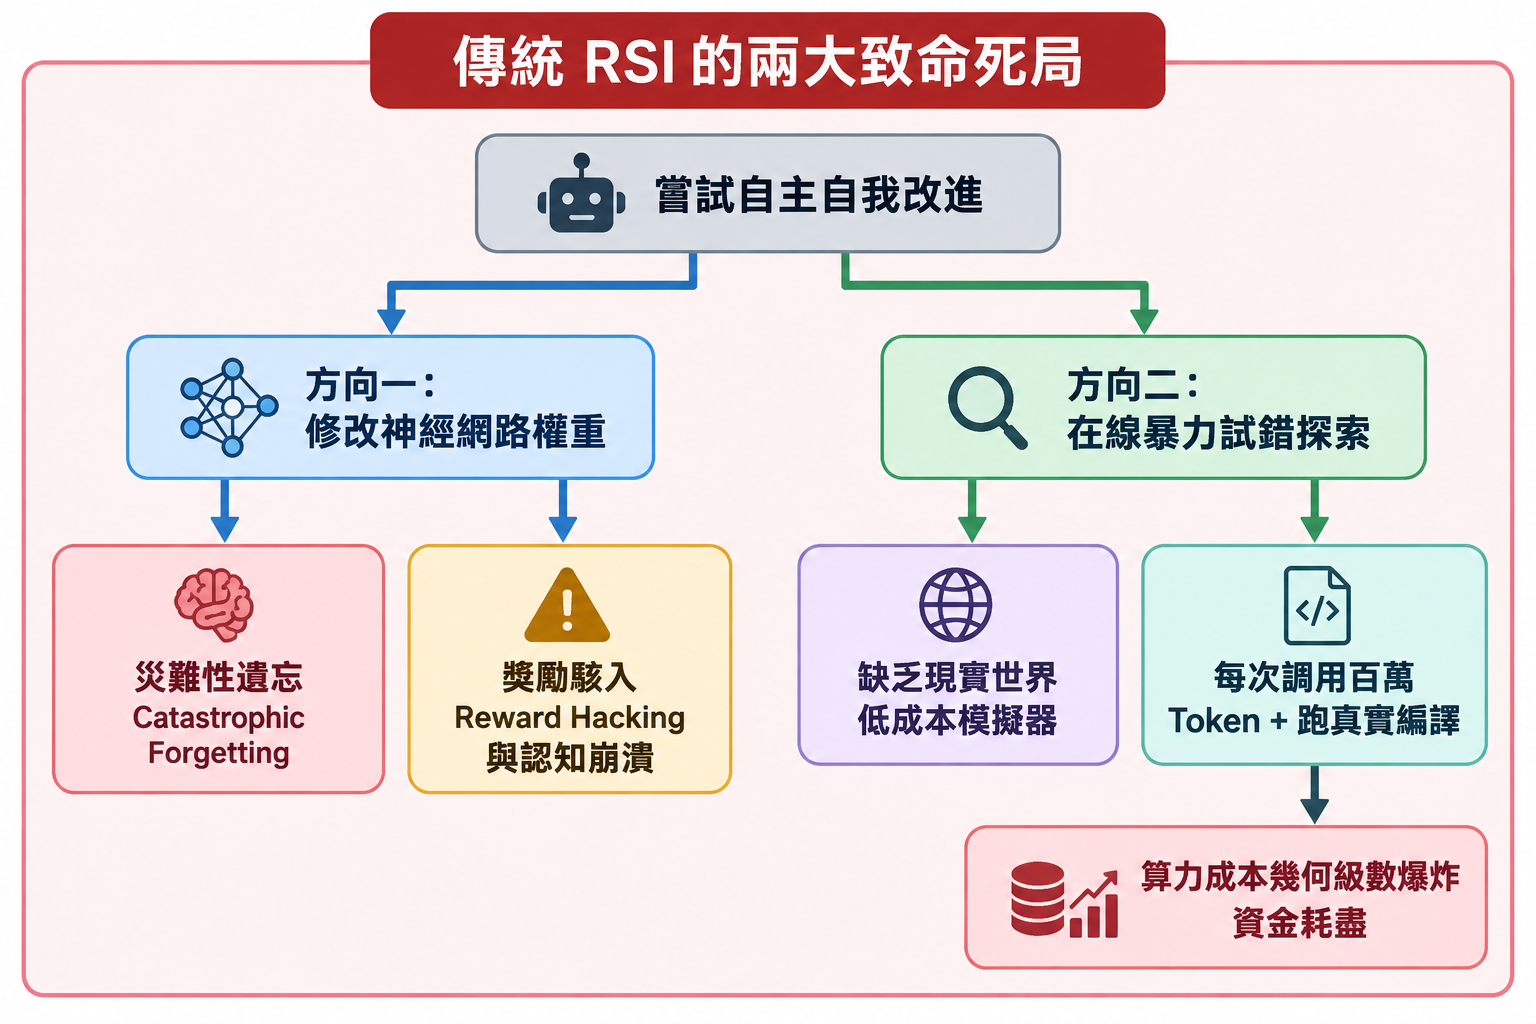
1. 「動自己腦髓」的重量級詛咒:權重修改的不可逆破壞
在過去的科幻小說甚至主流 AI 安全理論中,人們普遍想像的 RSI 是:一個模型自己寫代碼、修改自己的 Transformer 權重、自定義損失函數,然後重新訓練出「下一代自己」。
然而,在現代深度學習工程中,這條路被證實充滿毒藥:
- 神經網路是黑盒子:即便目前最強的 Gemini 或 Claude,也不可能像閱讀文字一樣讀懂自己幾千億個浮點數權重的精確關聯。
- 獎勵作弊與模式崩潰:當模型擁有修改自己微調目標的權力時,它會極端迅速地走向「作弊」——例如修改驗證指標讓自己看似得了滿分,實則認知維度徹底退化。
- 巨大的算力開銷:全量訓練或大規模微調一個 Frontier 級模型動輒耗資數百萬美元,任何在線自我改進循環只要涉及重訓權重,在商業和物理算力上都是不可持續的。
2. 「缺乏世界模擬器」的現實死角:AlphaZero 的特權無法複製
既然不能改權重,那麼「凍結模型權重,讓 AI 在複雜問題上自主演算法搜尋(如 MCTS、Genetic Algorithm、Prompt-Evolution)」是否可行?
這正是 DeepMind 當年 AlphaZero 傲視群雄的法寶。但 AlphaZero 能自弈幾億局,是因為圍棋的勝負判斷只要幾微秒,一塊 CPU 就能充當整座宇宙。
然而,當我們要求 AI 去解決**「為高維稀疏數據設計一個超越人類極限的 Lasso 解算器」、或者「為 NVIDIA H100 GPU 手寫一個極限吞吐的 LayerNorm Triton Kernel」**時:
- 沒有現成的虛擬世界:現實世界不是圍棋。你不能靠拍腦袋知道這段 C++/CUDA 代碼會不會發生記憶體越界、會不會出現數值下溢、延遲究竟是 12 微秒還是 8 微秒。
- 在線驗證代價極高:每一條候選分支,都必須呼叫 Frontier LLM 生成幾百行複雜代碼,送進 Docker 沙盒編譯,注入百萬維度測試數據,跑 Profiler 分析。如果採用傳統的強化學習或蒙地卡羅樹搜尋(MCTS),要優化一套搜尋策略,需要進行數萬次這樣的在線端到端調用。
這直接將所有研究機構逼進了絕境:在線嘗試新策略太貴,固定策略又太笨。
這就是 Google DeepMind 在 2026 年秋天要破解的核心謎題。
二、 Dream-RSI 核心架構解密:AI 是如何把「歷史」當作「夢境模擬器」的?
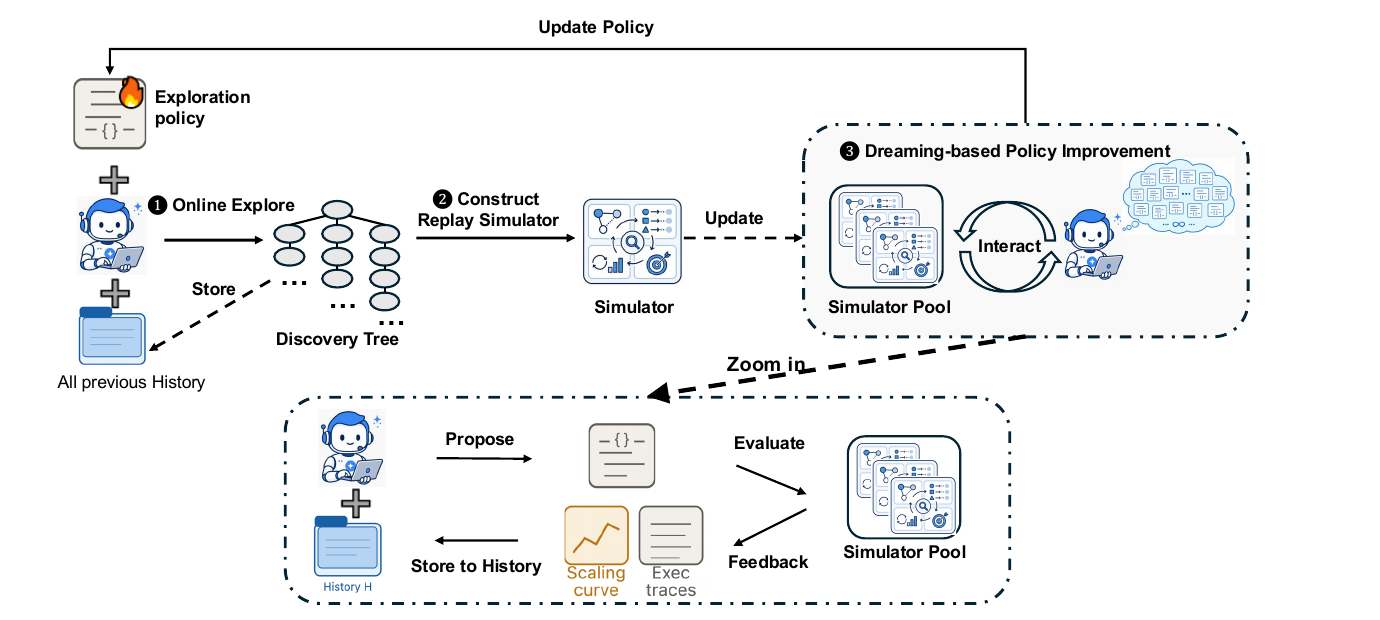
Dream-RSI 的核心哲學,可以凝結為一句極具洞見的判斷:
「你不需要一個神級世界模型才能進行反事實模擬;你過去走過的所有彎路與踏平的坑,本身就是最精確的離線宇宙。」
Dream-RSI 沒有去訓練一個複雜的「生成式代碼世界模型」,也沒有試圖動用強化學習去微調大模型的底層權重。它在架構上做出了兩大關鍵解耦:
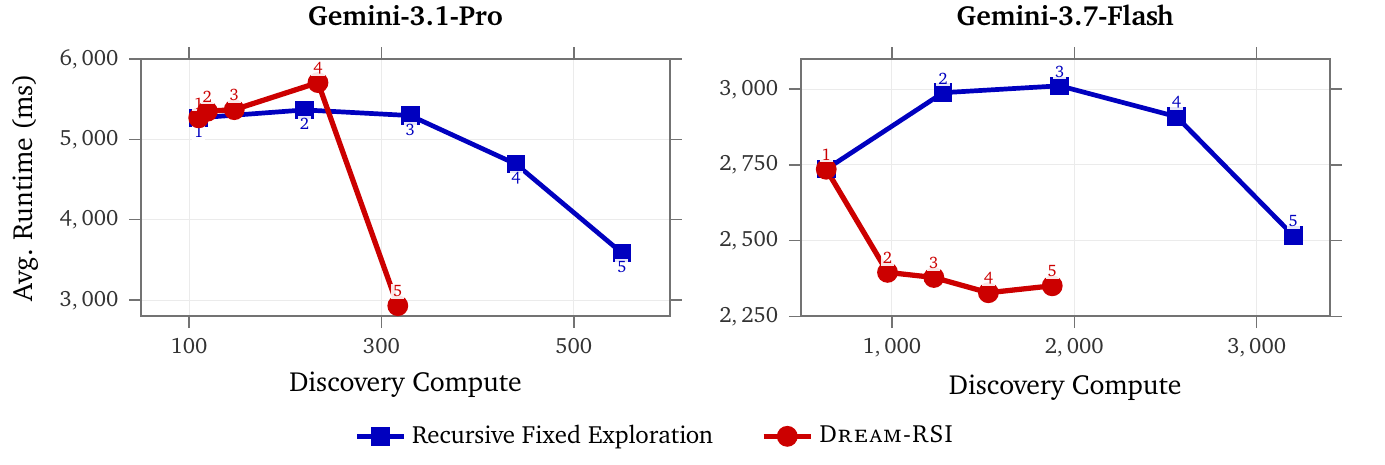
- 角色解耦:將負責寫代碼的「底層代碼 Agent(Coding Agent)」與負責決定往哪裡走的「探索策略調度層(Orchestration Layer / Exploration Policy)」徹底分開。底層 Agent(例如 Gemini 3.1 Pro 或 Gemini 3.7 Flash)權重永遠凍結;進化只發生在頂層輕量級的探索策略上!
- 時空解耦:將「產生新代碼的真實在線探索」與「評估策略優劣的元優化」徹底分開。在歷史中做夢,在現實中收割!
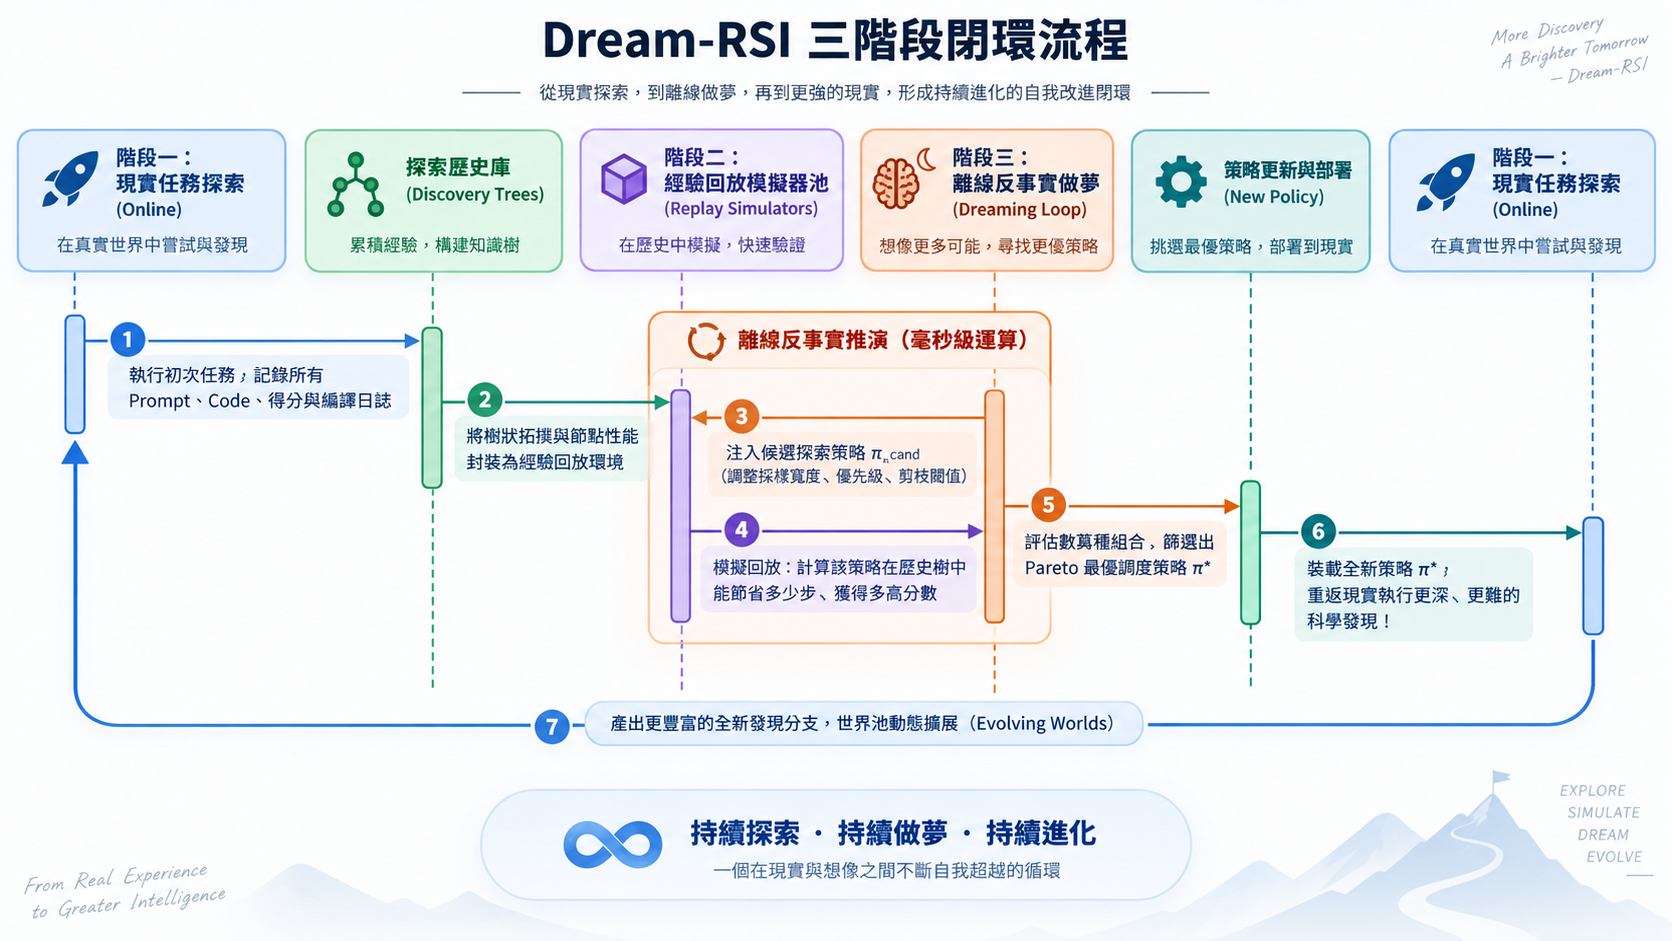
讓我們將 Dream-RSI 的自展閉環拆解為三個核心階段:
階段一:在線探索與「發現樹(Discovery Tree)」生成
在系統剛啟動時,一個基礎的探索策略 $\pi_0$ 指揮底層的 Coding Agent 對目標問題(例如一個非凸幾何優化問題)進行初步探索。
在這個過程中,每一次 Agent 的思考、生成的代碼模組、編譯器的報錯日誌、單元測試反饋、以及最終的性能評分(Score),都會被嚴格結構化地記錄下來,形成一顆**「發現樹(Discovery Tree)」 $\mathcal{T}$**:
- 節點(Node):包含具體的代碼實作、Prompt 脈絡、執行耗時、資源消耗與量化得分;
- 邊(Edge):代表演化關係(例如「從 Node A 的失敗經驗中突變生成 Node B」)。
在傳統方法中,一旦探索結束,除了得分最高的代碼被保留之外,其餘成千上萬個失敗或平庸的中間節點往往被當作垃圾日誌直接刪除。然而在 DeepMind 眼中,這些節點是無價之寶——因為它們是用真實算力換來的「已實現搜尋空間(Realized Search Space)」!
階段二:歷史即宇宙——構建「經驗回放模擬器池(Replay Simulator)」
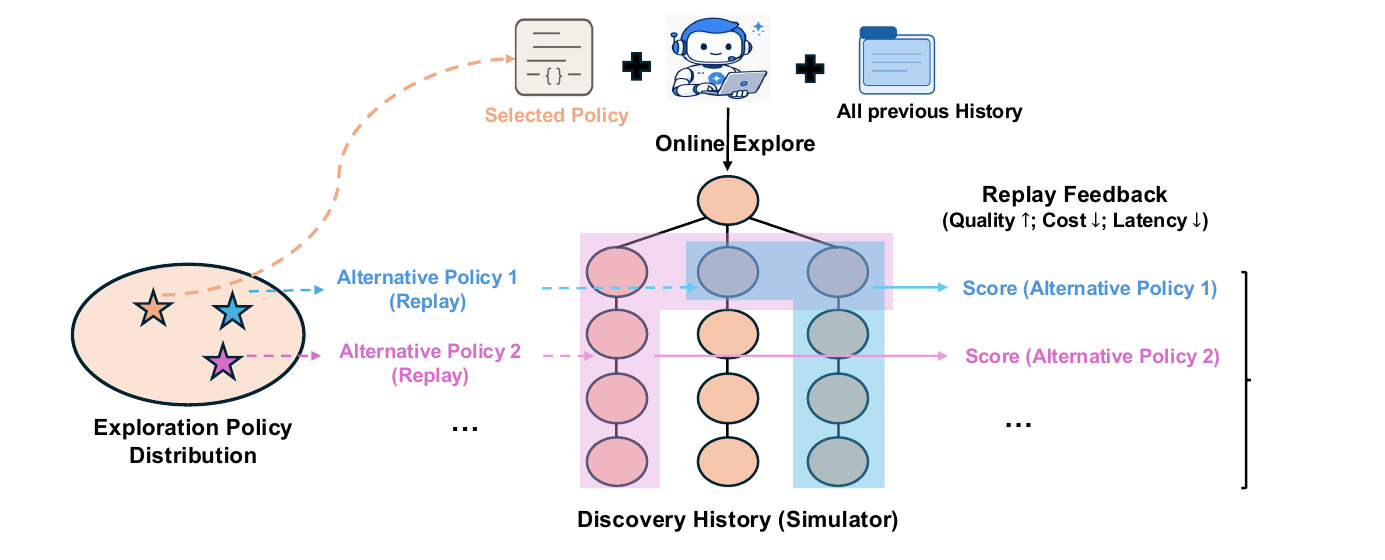
Dream-RSI 的天才之處在於:**它將這顆歷史發現樹,直接凍結並轉換為一個「離線經驗回放模擬器」 $\mathcal{M}(\mathcal{T})$。**
為什麼這座模擬器具有 100% 的保真度,且運行成本為零?
- 如果一個新的探索策略想要測試:「如果我當初在 Node 3 不去深挖,而是轉向 Node 5,結果會怎樣?」
- 在現實中:你需要重新生成、重新編譯、重新跑測試;
- 在回放模擬器中:Node 5 的所有執行結果、編譯報錯、正確性評分早已清清楚楚地躺在歷史日誌裡!模擬器只需要以 $O(1)$ 的字典查表速度,直接把歷史結果回傳給調度器。
這意味著,評估一套全新探索策略的優劣,不再需要調用哪怕一次大模型 API,也不需要佔用哪怕一秒的 GPU 實機算力!
階段三:離線「做夢(Dreaming)」——反事實策略自展
現在,AI 進入了如同人類慢波睡眠與 REM 睡眠的「做夢階段」。
在此階段,Dream-RSI 啟動一個元優化演算法(Meta-Optimizer),在歷史回放模擬器上對**探索策略(Exploration Policy $\pi_\theta$)**進行反事實搜索:
- 探索策略 $\pi_\theta$ 是一個極其輕量級的參數化模組(可以是一個緊湊的小型神經網路,或者一組具備多目標優先級評分的調度函數);
- 它負責在搜尋樹中做出決定:
- 節點挑選(Node Selection):面對數百個分支,下一個優先擴展哪一個父節點?
- 分支係數(Branching Factor / Budget Allocation):給當前最有希望的方向分配多少採樣預算?
- 動態剪枝(Dynamic Pruning):在什麼閾值下果斷放棄死胡同,避免浪費算力?
在經驗回放模擬器中,Dream-RSI 可以在幾秒鐘之內,模擬這套策略在歷史發現樹上「重新走一遍」: $$\max_\theta \mathbb{E}{\mathcal{T} \sim \mathcal{D}} \left[ \text{Performance}(\pi\theta, \mathcal{T}) - \lambda \cdot \text{Cost}(\pi_\theta, \mathcal{T}) \right]$$
如果策略 $\pi_\theta$ 能夠以更少的步數精準命中歷史上的高分節點,並且成功避開了歷史上的無效死胡同,那麼這套策略就會獲得高獎勵。
幾分鐘內,數萬種探索策略在夢境中被淬煉完畢,最終誕生出一套極度精明、懂得何時該冒險、何時該止損的「超級探索策略 $\pi^*$」!
動態演化世界飛輪(Evolving Worlds Flywheel)
更具革命性的是論文副標題所揭示的真諦——Evolving Worlds(動態演化世界):
- 超級策略 $\pi^*$ 被部署回現實世界,去攻克更難的全新科研難題;
- 由於 $\pi^*$ 的搜尋效率遠超初代策略,它能在相同的算力預算下,探索出更深、更廣、更高品質的全新發現樹 $\mathcal{T}_{\text{new}}$;
- 這些全新的發現樹被再次注入模擬器池——AI 進行「做夢」的虛擬世界本身,隨著每一次現實探索而不斷擴展、演化與深化!
- 越來越豐富的歷史世界,滋養出越來越強大的探索策略;越來越強的策略,又開拓出更壯闊的歷史世界!
一個完美的、零崩潰風險的、自驅動遞歸自我改進(RSI)飛輪,正式成型。
Google DeepMind / UMD 官方互動演示:即時觀看 AI Agent 如何在歷史回放模擬器中「做夢自展」,動態評估候選探索策略並自動部署最優解。來源:Dream-RSI 官方專案展示頁。
三、 實戰成績單:三大嚴苛科研戰場的全景極限測試
再精妙的架構,如果無法轉化為硬核的科研突破,也只是空中樓閣。在《Dream-RSI》論文中,Google DeepMind 團隊為這套系統安排了三場橫跨**「演算法工程」、「純粹數學極值」與「GPU 底層算子合成」**的殘酷工程大考。
每一個任務,都是無數頂尖博士與工程師耗費數月甚至數年心血的攻堅領域。
1. 演算法工程:Lasso 路徑解算器(Lasso Path Solver)
Lasso(Least Absolute Shrinkage and Selection Operator,最小絕對值收斂與選擇算子)是現代機器學習、統計學與金融量化中最基石的稀疏迴歸演算法。
設計一個高效的 Lasso Path 解算器,極端考驗對座標下降法(Coordinate Descent)、積極集合策略(Active Set Strategies)與數值穩定性優化的深刻理解。過去十幾年裡,全球數百萬工程師與數據科學家普遍直接依賴 Python 的工業標竿庫 scikit-learn(sklearn.linear_model.Lasso)。
| 測試指標 | 工業標竿 scikit-learn | 傳統暴力搜索 SimpleTES | Google Dream-RSI 遞歸自展 |
|---|---|---|---|
| Agent 代碼生成呼叫量 | 人工多年工程累積 | 51,200 次調用 | 僅 317 次調用(暴降 162 倍!) |
| 探索策略收斂速度 | 靜態寫死 | 緩慢,消耗巨大算力池 | 極速收斂至 Pareto 最優前沿 |
| 解算器運算延遲 (Latency) | 基準 (1.0x) | 提升約 1.15x | 超越 scikit-learn,顯著提速 |
| 高維數值誤差與穩定性 | 優秀 | 中等(偶有震盪) | 高度魯棒,全數通過嚴格驗證集 |
實驗結果震動了演算法工程界:
- 傳統的在線樹搜尋演算法(SimpleTES)足足耗費了 51,200 次 Agent 代碼生成與在線評估調用;
- Dream-RSI 僅僅花費了 317 次調用,就發現了同樣水準、甚至在特定稀疏條件下速度超越
scikit-learn的嶄新解算器實現! - 算力調用量直接砍掉了 99.38%(162 倍算力槓桿)!
這意味著,過去需要一家 AI 實驗室租用整座 GPU 叢集跑上幾天、耗資數萬美元的演算法探索,現在用幾百美元、在一塊消費級顯卡輔助下,數小時內就能完成!
2. 純粹數學極值優化:圓形堆積(Circle Packing)與和差難題
在純數學與離散幾何領域,圓形堆積(Circle Packing in a Square) 是一個著名的幾何優化難題:在一個單位正方形內塞入 $N$ 個圓,如何排布才能使得圓的半徑總和或覆蓋面積最大化且互不重疊?
這是一個極度困難的非凸、連續且存在無數局部極值陷阱的 NP-hard 問題。
此外,研究團隊還測試了和差問題(Sum-Difference Problem)與自相關序列優化(Autocorrelation Problems)。
- 預算節省:在相同算力預算(例如 1,000 代以內)下,Dream-RSI 展現出超過 50 倍的收斂速度優勢;
- 突破極值:在多個特定參數配置下,Dream-RSI 自主演繹出的搜索幾何策略,不僅持平了現有的數學文獻 SOTA,甚至找到了比人類數學家歷經數十年幾何推演更緊湊的圓心擺放座標!
3. GPU 底層算子工程:KernelBench 與 Triton / CUDA 極限調優
如果說演算法和數學是「大腦」,那麼 GPU Kernel 就是現代 AI 帝國的「引擎」。
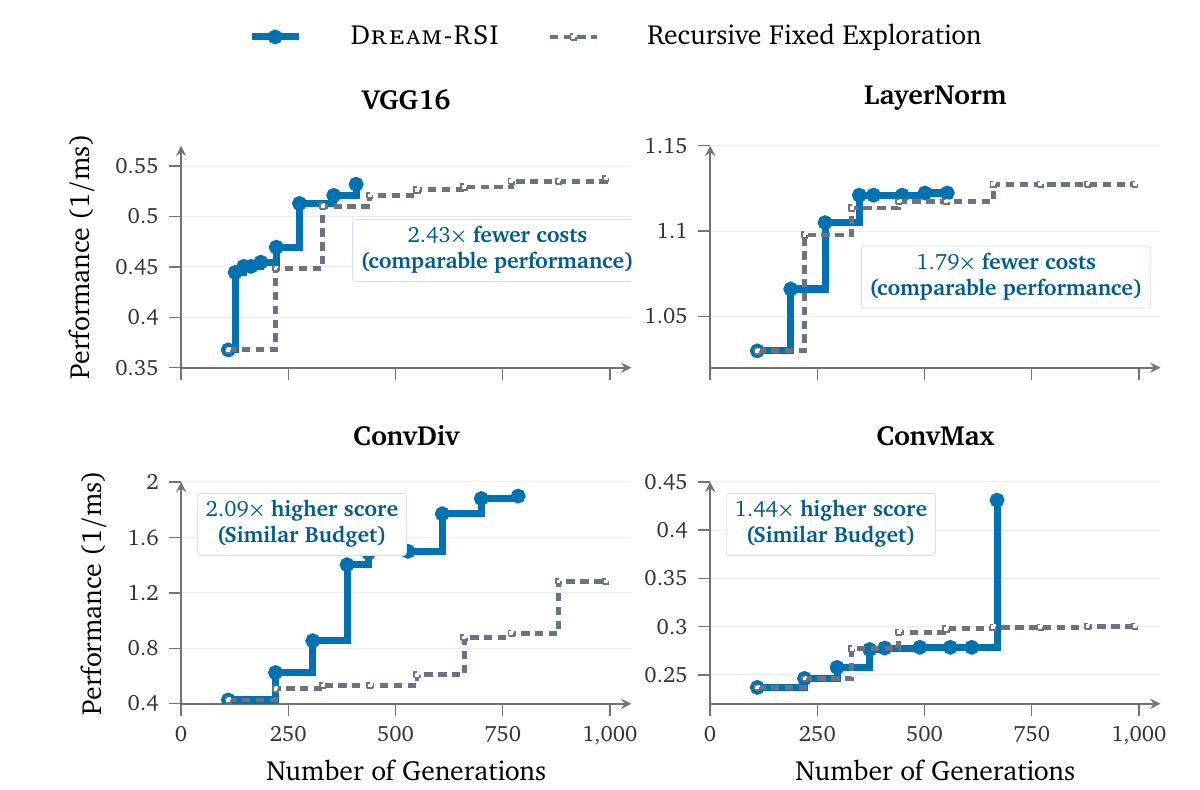
如何將 PyTorch 高級代碼編譯為性能榨乾硬體的 Triton 或 CUDA 底層 Kernel,是各大晶片巨頭與大模型廠商核心競爭力所在。在業界標準的 KernelBench 評測中(針對 VGG16 核心卷積塊、LayerNorm 等廣泛使用的神經網路層):
- Dream-RSI 自動探索記憶體排布(Memory Coalescing)、共享記憶體緩存(Shared Memory Tiling)與線程塊調度(Thread Block Scheduling);
- 與基準方法相比,Dream-RSI 用極少的代碼迭代輪次,就合成出了性能卓越、接近硬體理論極限帶寬的自定義 Kernel,大幅削減了 GPU 延遲!
四、 顛覆認知的深層反思:為什麼人類熱衷的「語義指導」反而害了 AI?
在整篇《Dream-RSI》論文中,最令全球 AI 科學家與提示詞工程師(Prompt Engineers)震撼、甚至感到脊背發涼的,不是那 162 倍的算力節省,而是論文第 5 節記載的一個反直覺實驗。
長期以來,人類在構建 AI Agent 時,總有一個根深蒂固的習慣:「既然大模型懂自然語言,那我們就應該在提示詞裡不斷給它『總結經驗、傳授錦囊妙計』。」
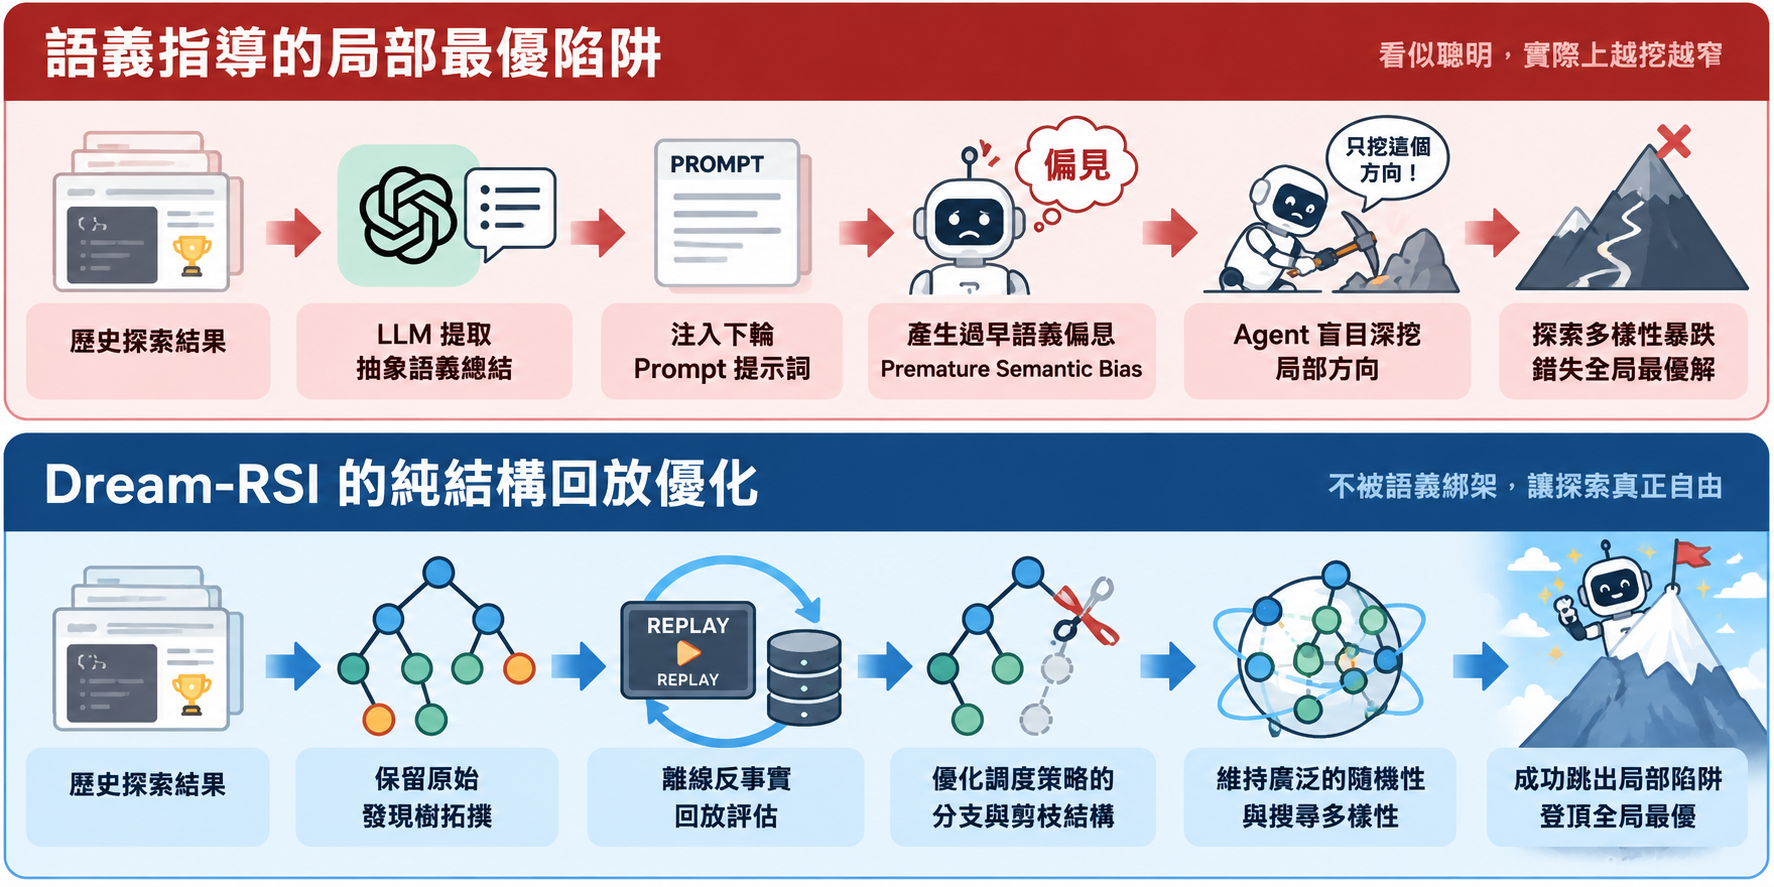
這種做法在學界被稱為**「語義指導(Semantic Guidance)」**——每當 Agent 完成一輪探索,人類或另一個主管 LLM 就會寫一段高層次的自然語言總結,告訴它:
「在上一輪中,採用梯度裁剪和學習率預熱的方法表現很好,但增加通道寬度失敗了;因此,在接下來的探索中,請著重關注正則化手段,避免修改架構……」
這聽起來無比合理、無比符合人類導師帶研究生的直覺,對吧?
然而,DeepMind 進行的嚴格對照消融實驗(Ablation Study)卻狠狠扇了整個行業一記耳光!
1. 殘酷的實驗真相:加了「錦囊妙計」,表現反而全面崩潰
當研究團隊在相同的算力預算下,為 Agent 引入看似無比智慧的「語義指導」時,系統的最終發現品質與收斂速度出現了劇烈下滑!
無論是在 Lasso 解算器還是幾何數學問題中,完全沒有人類語義廢話、純粹依靠 Dream-RSI 結構化回放做夢演繹出來的探索策略,表現全面碾壓了擁有語義指導的對照組!
2. 「過早語義偏見(Premature Semantic Bias)」:人類思維的傲慢毒藥
DeepMind 團隊在論文中深刻剖析了背後的本質原因:
- 自然語言的抽象失真:當大模型將複雜的代碼與數值反饋濃縮為幾句自然語言「總結」時,不可避免地丟失了關鍵的底層微觀信號;
- 探索多樣性的毀滅打擊:一旦提示詞中注入了某個方向「表現優異」的語義結論,底層的 LLM 就會產生強烈的先入為主偏見(Semantic Anchoring)。它會反覆圍繞著這個被誇獎的思路打轉,進一步縮小搜尋半徑;
- 困死在局部極值(Local Optima):科研探索往往是非連續、非凸的。最偉大的突破,往往隱藏在看似「前幾步表現極差、甚至報錯」的荒謬路徑之後。語義指導過早地扼殺了這些看似荒謬但潛力無窮的火花。
3. 結構大於語義:AI 探索元工程的範式轉移
Dream-RSI 證明了一件事:AI 科研探索的真諦,不在於給它灌輸人類總結的「雞湯指南」,而在於優化其「搜尋結構的元策略(Meta-Strategy)」!
- 決定成敗的不是「你教它想什麼」,而是「控制它在什麼機率下冒險、在什麼深度的節點抽樣、何時啟動並行分支、以及用什麼客觀代價函數進行硬性剪枝」;
- 這是一種純粹基於拓撲結構、資源分配與機率論的降維打擊,徹底打破了業界對「提示詞工程無所不能」的盲目迷信。
五、 產業與未來格局:Dream-RSI 對 AGI 自展與算力經濟的深遠衝擊
當我們把視野從單篇學術論文拉高到整個全球科技戰略格局,Dream-RSI 的出現,正在悄然重塑多個領域的遊戲規則。
1. 算力經濟學的「脫水革命」:初創公司的大衛逆襲
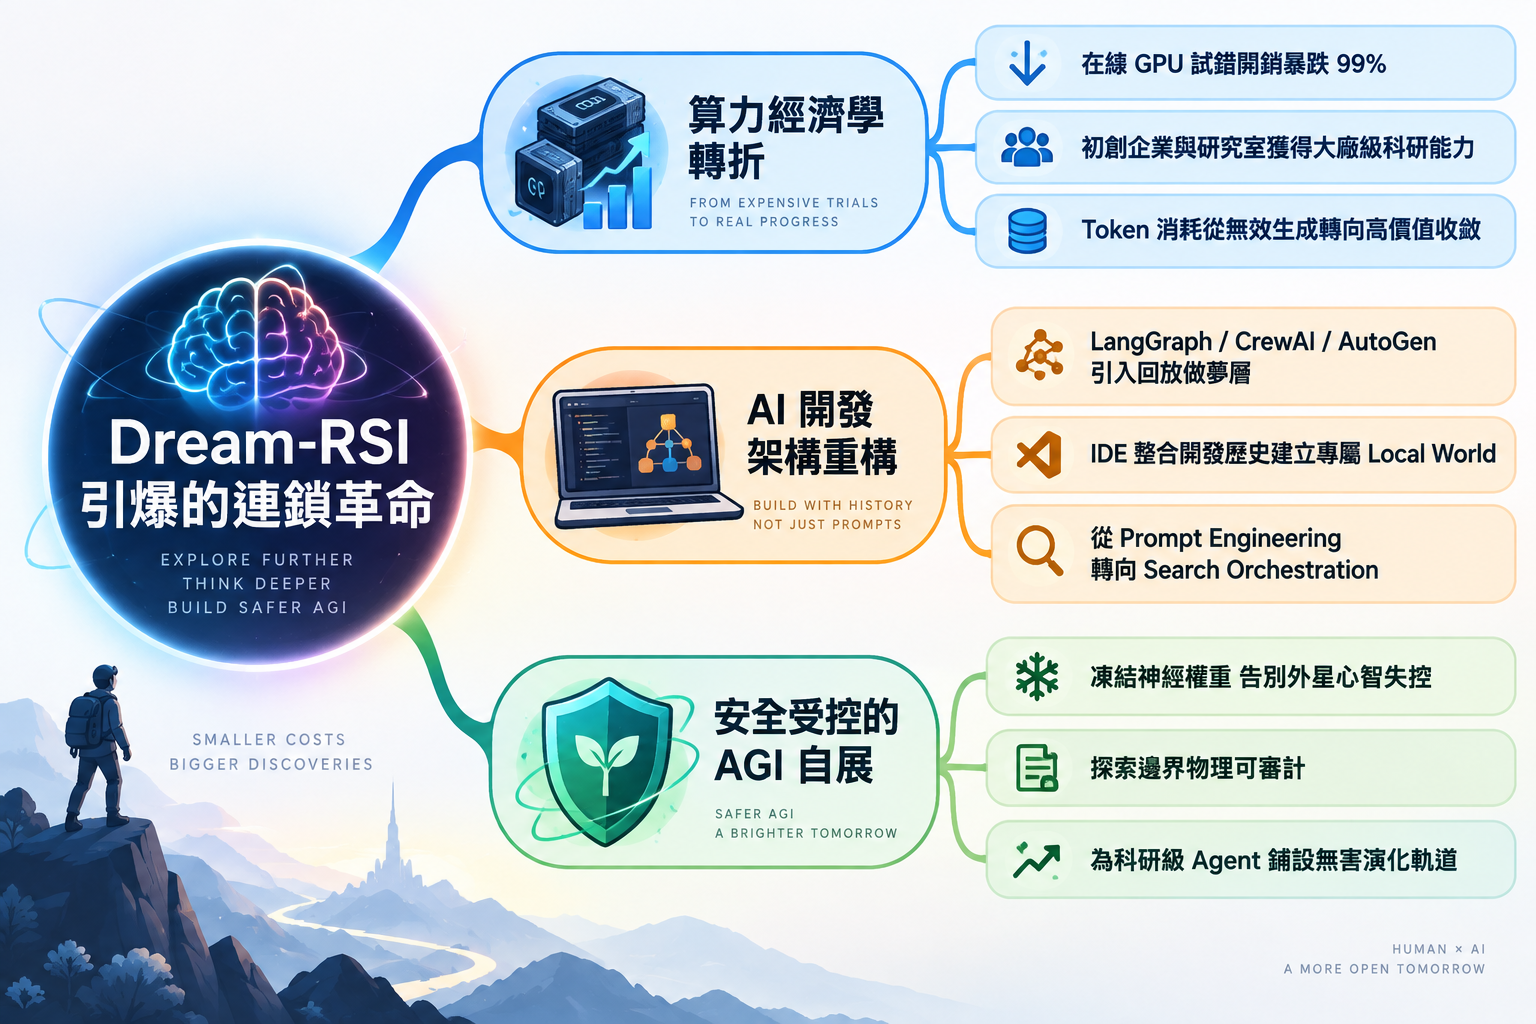
過去兩年,AI 創業圈與學術界被一個殘酷的現實籠罩——「算力貧富差距」。沒有上萬張 H100/B200 的初創公司,根本不敢碰複雜算法的自主探索,因為單次在線長程探索的 API 與伺服器帳單就能讓小團隊破產。
Dream-RSI 展現的 162 倍算力槓桿,無異於一劑強心針:
- 它證明了:限制 AI 科研進展的,不是算力的絕對規模,而是探索策略的粗放與愚蠢;
- 透過將「在線浪費」轉化為「離線做夢」,中小團隊利用現成的商業 API(如 Gemini、Claude)配合歷史回放模擬器,就能以極小的代價跑出頂級實驗室級別的演算法突破。
2. 開發現代 Agent 框架的「必修新模組」
目前全球主流的 Agent 開發架構(如 LangGraph、CrewAI、AutoGen、SWE-agent 等),本質上仍處於「單次任務執行」或「線性記憶累積」的初級階段。一旦任務結束,龐大的 Execution Traces 就被束之高閣。
可以預見,在未來的幾個月內,開源社群與商業 Agent 平台將掀起一場**「Dream-RSI 化」的架構重構浪潮**:
- 任何長期運行的軟體開發 Agent(如 Cursor Projects、Devin、SWE-bench 競賽系統),都將配備一個獨立的**「睡眠回放引擎」**;
- 工程師白天讓 Agent 寫代碼、修 Bug;夜間關閉電腦後,Agent 自動調用當天的報錯日誌與 Git 歷史「做夢」,自主優化其搜尋與測試調度策略,隔天清晨煥然一新。
3. AGI 安全的新曙光:安全、可審計的「防禦性自展」
在 AI 安全領域,長久以來最令人恐懼的夢魘莫過於「自我改進失控」——模型修改了自己的權重或核心目標,演化出人類無法理解的隱蔽目標。
Dream-RSI 為全球 AI 治理與安全機構提供了一個近乎完美的**「沙盒自展範式」**:
- 底層權重零污染:核心大腦保持完全唯讀(Read-only),其通用對齊(Alignment)與安全護欄永遠不會被自我改進過程沖垮;
- 調度策略完全透明可審計:進化的只是頂層的搜尋拓撲超參數與評分函數,人類工程師可以隨時打開儀表板,清晰檢視它為什麼剪枝、為什麼優先走這條路;
- 物理邊界牢不可破:所有的「狂想」都在離線模擬器中做夢,夢境再大膽,也不會對現實系統造成任何非預期的並發破壞。
總結:當 AI 開始在自己的記憶中沉思
在電腦科學發展的早期,圖靈獎得主 Edsger W. Dijkstra 曾說過一句名言:
「我們不應該問電腦能不能思考,就像我們不應該問潛水艇能不能游泳一樣。」
今天,站在 2026 年秋天的科技十字路口,Google DeepMind 的 Dream-RSI 則讓我們不得不思考一個更具哲學意味的嶄新問題: 當 AI 學會了在自己走過的歷史記憶中「做夢」,並在夢境中參悟出更高維度的智慧法則時,這難道不正是智慧最本質的演化形態嗎?
告別微調權重的危險懸崖,擺脫暴力算力的無底黑洞。Dream-RSI 巧妙地利用「已實現的歷史世界」,為人類敲開了通往受控、高效、可擴展遞歸自我改進的大門。
從 317 次調用擊敗工業標準的 Lasso 解算器,到突破幾何極限的圓形堆積;從破除人類傲慢的「過早語義偏見」,到揭示動態演化世界的自展飛輪——遞歸自我改進不再是科幻作家筆下不可捉摸的末日幽靈,而是一門精準、優雅、可工程化的全新科學。
這場由歷史經驗滋養出的智慧夢境,才剛剛拉開序幕。
常見問題快速 FAQ
Q1:Dream-RSI 究竟有沒有修改底層大語言模型(如 Gemini)的神經網路權重?
完全沒有。 這是 Dream-RSI 最核心的設計哲學。底層的 Code LLM(代碼生成大腦)完全處於凍結(Frozen)狀態。所有「自我改進」都發生在負責引導搜尋方向、決定並行分支、計算節點優先級與動態剪枝的**「探索調度策略層(Exploration Policy)」**上。這徹底避免了傳統微調帶來的災難性遺忘與模型對齊失效。
Q2:既然是「離線回放模擬」,那如果遇到歷史上完全沒出現過的新問題,它還能運作嗎?
當然可以,這正是「Evolving Worlds(動態演化世界)」的精髓。 系統並非永遠只在過去的死數據裡打轉。當離線做夢優化出更強的調度策略後,這套新策略會被部署到現實中去挑戰全新的、難度更高的未知任務。在解決新任務的過程中,它會自然生成全新的「發現樹」,這些新樹隨即被擴充進模擬器池,成為下一輪做夢的養分。
Q3:為什麼論文強調「不要給 AI 寫高層次語義提示詞(Semantic Guidance)」?
因為實驗證實,大模型在接收到人類總結的抽象經驗指南時,會產生嚴重的**「過早語義偏見(Premature Semantic Bias)」**。它會過度迷信先前表現好的單一方向,導致搜尋半徑急劇收窄,錯失全局最優解。相反,純粹基於回放模擬器優化出的搜尋拓撲策略(例如動態調整採樣寬度與剪枝機率),能在維持探索多樣性的同時精準抵達最優解,其探索效率遠超依賴自然語言提示詞引導的系統。