NVIDIA 震撼發表 CUDA Rust!GPU 核心編程迎來記憶體安全革命:cuda-oxide 與 cutile-rs 雙軌並進、原生編譯 PTX 徹底告別 C++ 記憶體未定義行為深度解析
NVIDIA 官方宣布全力進軍原生 GPU Rust 編程!推出 SIMT 底層編譯器 cuda-oxide 與支援穩定版 Rust 1.89+ 的 Tile 程式設計庫 cutile-rs。透過 DisjointSlice 與張量分區所有權,徹底在編譯期消滅 GPU 資料競爭與未定義行為。本文完整拆解底層架構、向量加法代碼實測與產業影響。
「在現代 AI 系統工程中,推論引擎、服務框架、核心驅動與 Agent 執行環境正全面向 Rust 遷徙——因為 Rust 能在完全不犧牲極致效能的前提下,於編譯期扼殺整整一整個維度的記憶體漏洞。
然而,GPU 核心(Kernel)一直是個孤島。過去你只能用 Rust 『啟動(Launch)』核心,核心本身卻必須用其他語言撰寫。
今天,NVIDIA CUDA Rust 正式終結了這道鴻溝! 開發者現在能直接在 Rust 中編寫 GPU 核心並原生編譯為 PTX,徹底將型別安全與防別名機制延伸至加速硬體的最深處。」
—— NVIDIA 官方技術團隊(Sri Koundinyan, Melih Elibol, Jonathan Bentz,2026 年 9 月)
在人工智慧與高效能運算(HPC)由數十萬張 GPU 節點交織而成的今日,軟體工程界正經歷一場波瀾壯闊的「底層重構」。
從推論伺服器架構、分散式通訊中介軟體、Linux 核心驅動到新一代 AI Agent 執行環境,系統工程師們正以驚人的速度將舊時代的 C/C++ 基礎設施替換為 Rust。背後原因極為純粹且致命:在不向垃圾回收機制(GC)妥協任何一微秒延遲的前提下,利用 Rust 嚴苛的編譯期所有權(Ownership)與型別系統,徹底根除記憶體未定義行為(Undefined Behavior, UB)與資料競爭(Data Races)。
NVIDIA 自身早已是這場浪潮的領跑者——其新一代開源 Linux GPU 驅動 Nova 採用 Rust 打造;分散式推論核心架構 NVIDIA Dynamo 奠基於 Rust;甚至連 CUDA 底層效能剖析工具 NVTX 亦已提供官方 Rust 綁定。
然而,在這張看似日益堅固的記憶體安全拼圖中,始終遺落了最關鍵、也是最神聖的最後一塊版圖:GPU 運算核心(GPU Kernel)本身。
長久以來,Rust 開發者在面對 GPU 運算時始終處於「半殘」狀態:你能夠在 Rust 宿主端(Host)分配顯存、透過 FFI 綁定(如 cudarc 或 cust)呼叫預編譯的二進位檔案;但每當需要撰寫真正運行在數千個串流多處理器(SM)上的核心邏輯時,工程師依然不得不退回 CUDA C++ 或各類基於 Python 的 DSL(如 OpenAI Triton)。這意味著:
- 💥 記憶體別名混亂(Aliasing Hell):數千個執行緒同時讀寫裸指標,缺乏編譯期約束,極易引發難以復現的靜默資料競爭(Silent Data Corruption);
- 📉 啟動參數崩潰(Launch Mismatches):Grid 與 Block 維度、共享記憶體(Shared Memory)配額與暫存器溢出(Spilling)全憑人工計算,稍有不慎即引發
cudaErrorLaunchOutOfResources執行期崩潰; - 💸 天文級除錯成本:在訓練超大型前沿模型時,單一節點因為指標越界產生的硬體 Page Fault 或 NaN 梯度,足以讓耗資數百萬美元的叢集訓練任務中斷數天。
這場長達二十年的「GPU 核心安全真空」,在 2026 年 9 月迎來了歷史性的終局!
NVIDIA 高效能運算開發團隊(@NVIDIAHPCDev)正式投下震撼彈,向全球發表 CUDA Rust,宣告 GPU 核心正式迎來原生 Rust 時代!NVIDIA 一口氣推出兩大官方專案:專攻傳統 SIMT(單指令多執行緒)裸機硬體控制的 cuda-oxide,以及專為現代 Tensor Core 與穩定版 Rust 設計的 Tile-based 抽象庫 cutile-rs。
本文將帶你深入 NVIDIA CUDA Rust 的技術核心,全面拆解 cuda-oxide 如何透過客製化 rustc 後端與 Pliron IR 將 Rust 核心直譯為 PTX、解析 DisjointSlice 如何用型別系統馴服執行緒競態,並評估 cutile-rs 如何攜手 Hugging Face Grout 與 mistral.rs 掀起次世代推論引擎革命!
一、CUDA Rust 核心突破速覽:五大典範轉移
NVIDIA 本次發布並非單純的語法糖包裝,而是從編譯器前端、中間表示(IR)到執行期契約的全面重構。以下是 CUDA Rust 的五大關鍵突破:
- 🦀 原生編譯為 PTX(Native PTX Compilation): 徹底告別外部 C++ 編譯器依賴!GPU 核心程式碼直接以純正 Rust 撰寫,由專屬後端攔截並經由中介層直接編譯為 NVIDIA GPU 原生組合語言 PTX(Parallel Thread Execution)。
- 🛤️ 「雙軌並進」戰略架構(Two-Track Architecture):
- SIMT 軌道(
cuda-oxide):面向需要微觀掌控執行緒、Warp Shuffle、暫存器預算與硬體特性的底層專家,支援單檔混寫(Single-Source)宿主端與設備端程式碼。 - Tile 軌道(
cutile-rs):面向張量運算與深度學習推論,基於 穩定版 Rust 1.89+ 與 CUDA 13.3,由編譯器自動調度 Tensor Core 與硬體記憶體對齊,現已登陸crates.io。
- SIMT 軌道(
- 🛡️ 顛覆性的編譯期記憶體安全(Compile-Time Aliasing Prevention):
cuda-oxide發明了DisjointSlice<T>,以數學級型別保證將全局可變緩衝區安全解耦為各執行緒專屬的互斥寫入切片,打破了 Rust 「多執行緒無法安全持有同一可變借用(&mut)」的禁錮;- 引進強型別執行緒索引
thread::index_1d(),將陣列越界強制轉化為必須顯式處理的Option<&mut T>,在編譯期扼殺 Buffer Overflow。
- 📜 形式化啟動契約(Launch Contracts): 引入
#[launch_contract]屬性標記。宿主端在呼叫核心前,必須透過prepare階段通過硬體邊界與維度校驗,取得編譯期證書(Proof Token),從根源杜絕維度錯配導致的硬體異常。 - 🌐 跨語言互操作性與 2027 長遠藍圖: NVIDIA 明確宣示:CUDA Rust 與成熟的 CUDA C++、CUDA Python 並列為一等公民生態。NVIDIA 正著手構建跨語言互通層,確保 Rust 撰寫的頂級高效能 Kernel 能無縫被 PyTorch、JAX 或 C++ 系統調用,並承諾一路支援至 2027 年與下一代硬體架構。
二、CUDA Rust 全維度架構規格對決
為了讓系統架構師與效能工程師快速定位技術選型,我們彙整了 CUDA Rust 雙軌與現有 CUDA 生態的完整對比表:
| 評測核心維度 | cuda-oxide(SIMT 軌) | cutile-rs(Tile 軌) | 傳統 CUDA C++ | Triton / CUDA Python |
|---|---|---|---|---|
| 程式設計範式 | SIMT(單指令多執行緒) 微觀執行緒級抽象 |
Tile-based(分塊張量) 宏觀子張量操作 DSL |
SIMT 底層硬體指標與執行緒 |
Tile-based JIT Python 語法張量分塊 |
| Rust 工具鏈要求 | Nightly 鎖定版 (如 nightly-2026-04-03) |
Stable 穩定版 1.89+ (直接 cargo add cutile) |
無(需 g++ / clang) | 無(需 Python 3.10+) |
| CUDA Toolkit 版本 | CUDA 12.x 或更高 | CUDA 13.3 或更高 | 任意 CUDA 版本 | 任意 CUDA 版本 |
| 編譯後端管線 | rustc MIR ➔ Pliron IR ➔ LLVM IR ➔ PTX | 嵌入式 AST ➔ CUDA Tile IR JIT ➔ SASS | nvcc ➔ EDG/LLVM ➔ PTX ➔ SASS | Python AST ➔ Triton IR ➔ LLVM ➔ PTX |
| LLVM 依賴 | 需系統 LLVM 與 libclang 標頭檔 | 完全不需要自訂 LLVM | 內建於 nvcc | 內建預編譯二進位 |
| 記憶體安全機制 | DisjointSlice 防別名強型別索引( Option 邊界) |
張量分區(partition)Rust 線性所有權轉移 |
完全無保護 (仰賴人工與 Valgrind/Compute Sanitizer) |
依賴 Python 執行期邊界檢查 |
| 硬體資源調度 | 人工手動管理 執行緒配置、Shared Mem、Warp |
編譯器全自動管理 自動對齊 Tensor Core / TMA |
人工手動管理 | 編譯器半自動啟發式調度 |
| 原始碼整合度 | 單一檔案(Single-Source)#[cuda_module] 宿主/設備同存 |
單一檔案(Single-Source)#[cutile::module] 嵌入式 AST |
需 .cu 檔與 C++ 宿主代碼 |
Python 單檔或與 C++ 混編 |
| 硬體相容門檻 | Compute Capability 8.0+ (Ampere / Hopper / Blackwell) |
Compute Capability 8.0+ (Ampere / Hopper / Blackwell) |
任意 NVIDIA GPU | 任意支援 Tensor Core 之 GPU |
| 生態現況與成熟度 | 早期 Alpha(Research) NVIDIA Labs 開源探索 |
Crates.io 正式發布 已整合於 Grout 與 mistral.rs |
工業級成熟(Enterprise) 二十年歷史金標 |
工業級成熟(Enterprise) PyTorch 2.0 預設編譯器 |
| 最合適應用場景 | 自訂非正規算子、密碼學運算、物理模擬、底層驅動 | 矩陣乘法(GEMM)、FlashAttention、大模型推論核心 | 既有龐大 C++ 專案、極端客製化硬體微指令 | 演算法工程師快速原型、PyTorch 訓練階段算子融合 |
三、SIMT 軌道深度剖析:cuda-oxide 如何用編譯器重塑安全?
對於習慣編寫 __global__ void my_kernel(...) 的傳統 CUDA 工程師而言,cuda-oxide 是最親切、卻又在底層架構上最顛覆的解決方案。
1. 編譯管線架構:Rust MIR 遇上 Pliron IR
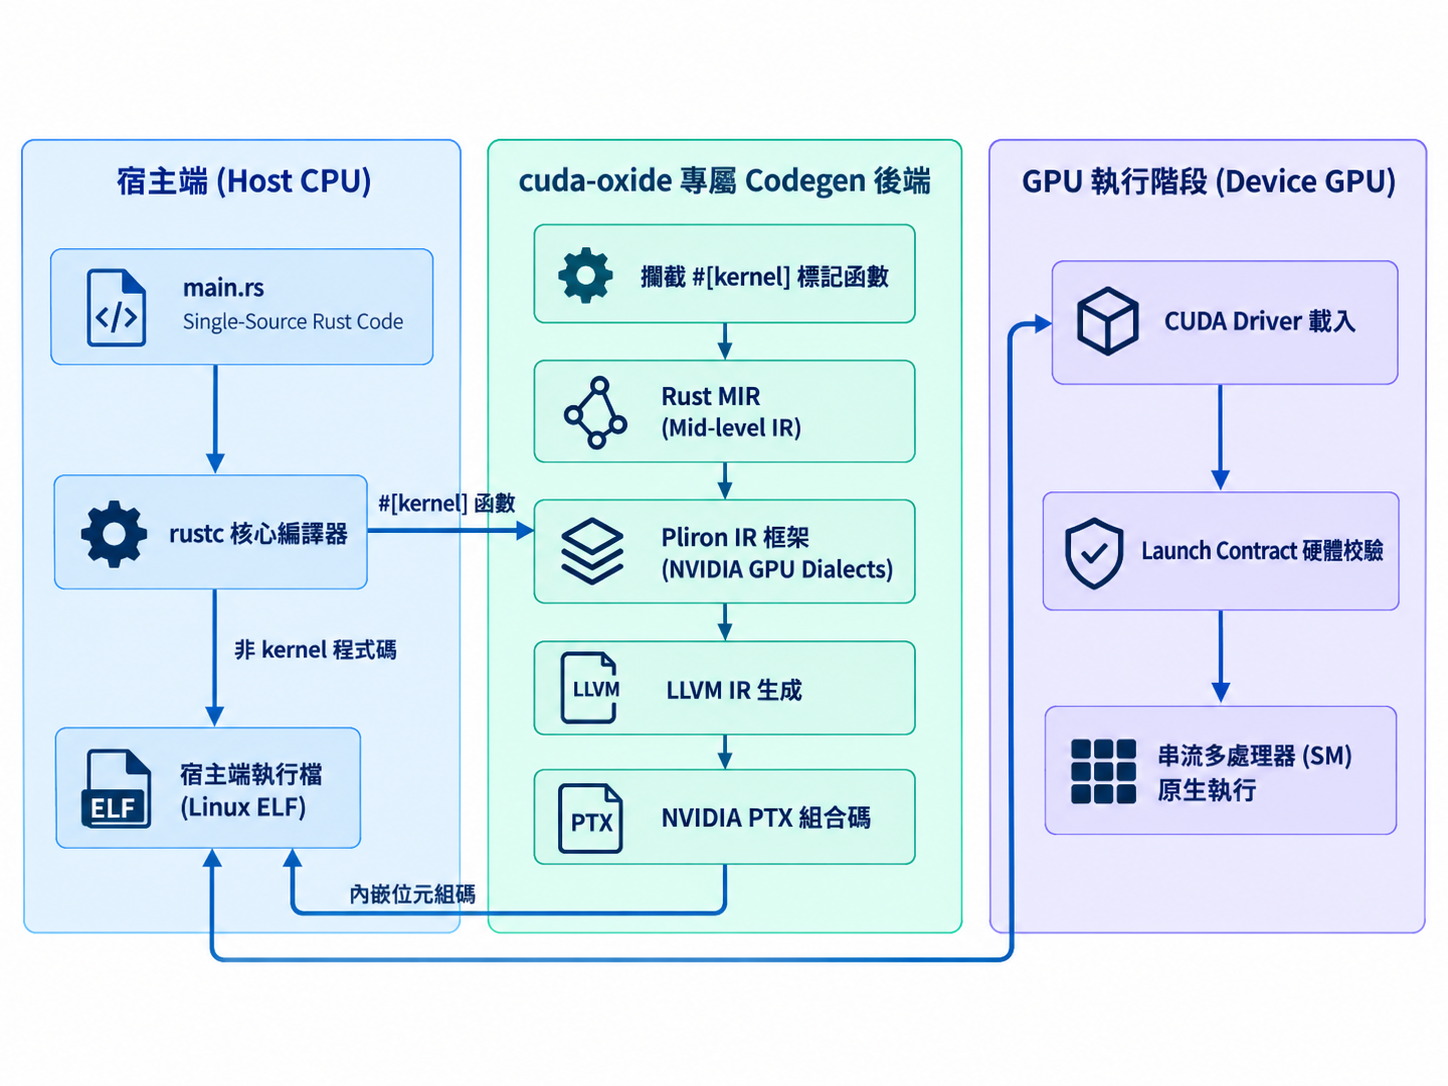
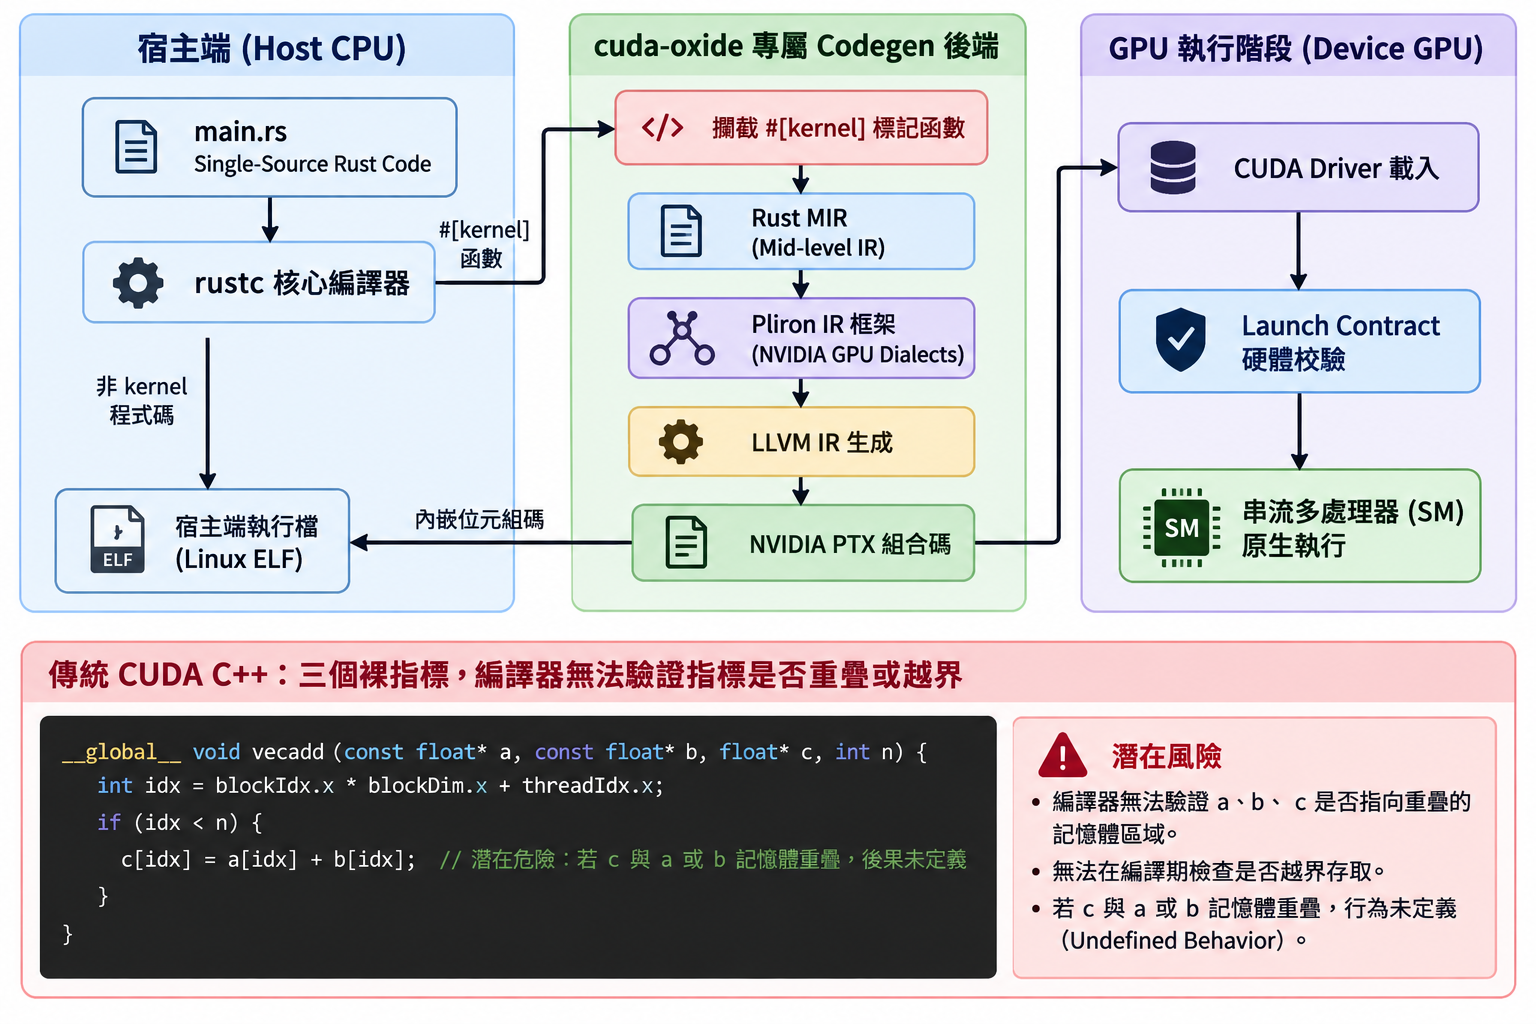
cuda-oxide 並不是一個獨立的編譯器,它被設計為 rustc 的客製化程式碼生成後端(Custom Codegen Backend)。當你執行 cargo oxide run 時,整個建構管線的運作邏輯如下:
- 宿主與設備解耦:編譯器在 MIR(Mid-level Intermediate Representation)層級介入,掃描程式碼中的模組。常規的 Rust 宿主端程式碼繼續走標準的 LLVM 後端產出 CPU 機器碼;
- 前進 Pliron IR:凡標註有
#[kernel]的 GPU 進入點函數,其 MIR 會被轉譯至開源社群專案 Pliron(由 Rust 撰寫、語意高度借鑑 MLIR 的可擴展中介表示框架)。NVIDIA Labs 在 Pliron 之上建立了專屬的 GPU Dialects(方言),所有的 GPU 硬體變換、記憶體階層映射與資料流分析全部在純 Rust 環境中完成; - 直落 PTX:在 Pliron 完成最佳化後,核心被降級為 LLVM IR,並由標準 LLVM NVPTX 後端直接發射為 PTX。隨後,這段 PTX 陣列被自動壓縮並作為靜態資料內嵌(Embed)回宿主端二進位檔中。
這造就了極為優雅的 「單一原始碼(Single-Source)」 體驗:工程師不再需要配置複雜的 CMakeLists.txt,更不需要忍受 extern "C" 的型別丟失與醜陋的二進位檔案打包流程。
2. 馴服資料競爭:DisjointSlice 的型別魔法
在傳統 CUDA C++ 中,最常見的平行向量加法簽名通常長這樣:
如果直接將此邏輯搬移至 Rust,你會立刻撞上 Rust 最堅固的哲學高牆:可變借用的排他性規則(Aliasing XOR Mutability)。當數千個執行緒同時執行同一個閉包或函數時,每個執行緒都試圖持有 c: &mut [f32] 的可變借用——Rust 編譯器會斬釘截鐵地拒絕編譯,因為這在定義上就是潛在的資料競爭!
為了解決這個長達數年的死結,cuda-oxide 團隊祭出了劃時代的型別創新:DisjointSlice<T>。
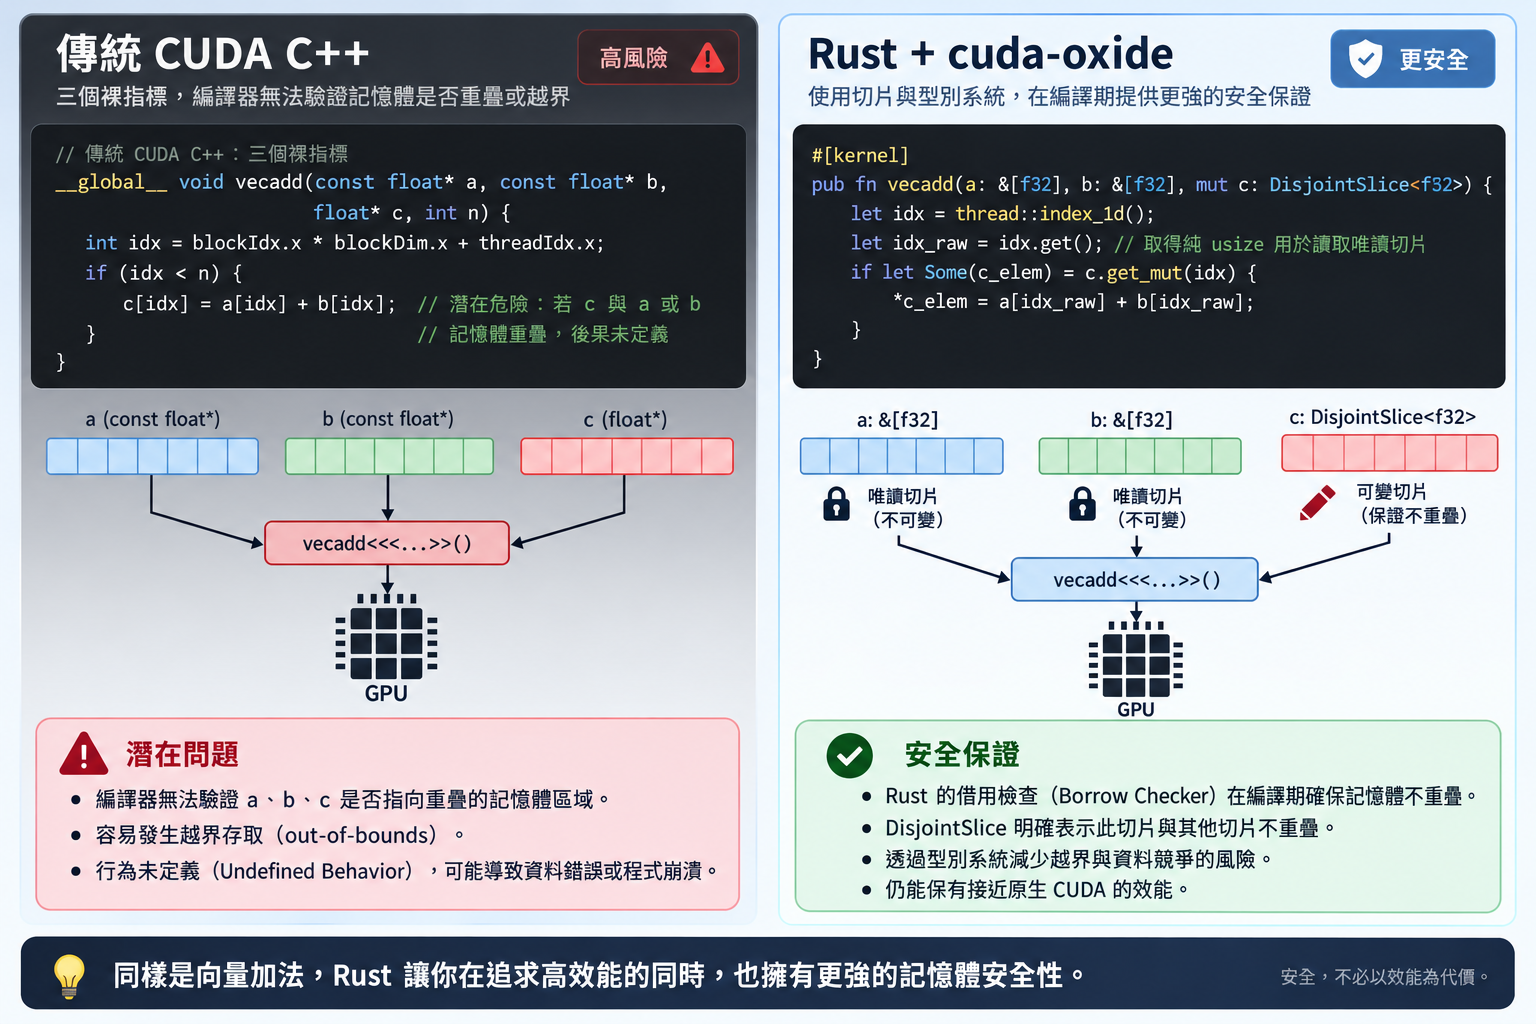
DisjointSlice 的核心機制:
- 非重疊空間保證:
a與b宣告為常規的不可變切片&[f32],代表多個執行緒同時讀取完全合法;但輸出緩衝區c則被封裝為DisjointSlice<f32>。在型別系統中,它代表「一塊已經被保證互斥分割的連續記憶體」; - 強型別索引防越界:注意到
c.get_mut(idx)所接收的參數並非隨意的usize整數,而是由硬體內建函數thread::index_1d()所產生的 專屬索引權杖(Typed Index Token)! - 強制解構
Option<&mut T>:get_mut(idx)返回的是標準的Option<&mut T>。如果執行緒計算出的索引超出了硬體或契約邊界,它只會安全地返回None。這強制開發者在編寫 GPU 核心的第一天,就必須顯式處理邊界分支,傳統 CUDA 中因為忘記寫if (idx < n)導致整張顯卡當機的低級失誤,在編譯期便被徹底物理抹煞。
3. Launch Contracts:拒絕信任,強制驗證
在 CUDA C++ 中,核心調用採用特有的三重角括號語法:vecadd<<<blocks, threads>>>(...)。如果工程師不小心將 Block 大小傳成了 2048(超過現代 GPU 單一 SM 1024 執行緒的物理上限),C++ 編譯器完全不會報錯,直到執行期呼叫失敗、返回一個晦澀的錯誤碼。
cuda-oxide 引入了形式化驗證工具 #[launch_contract]:
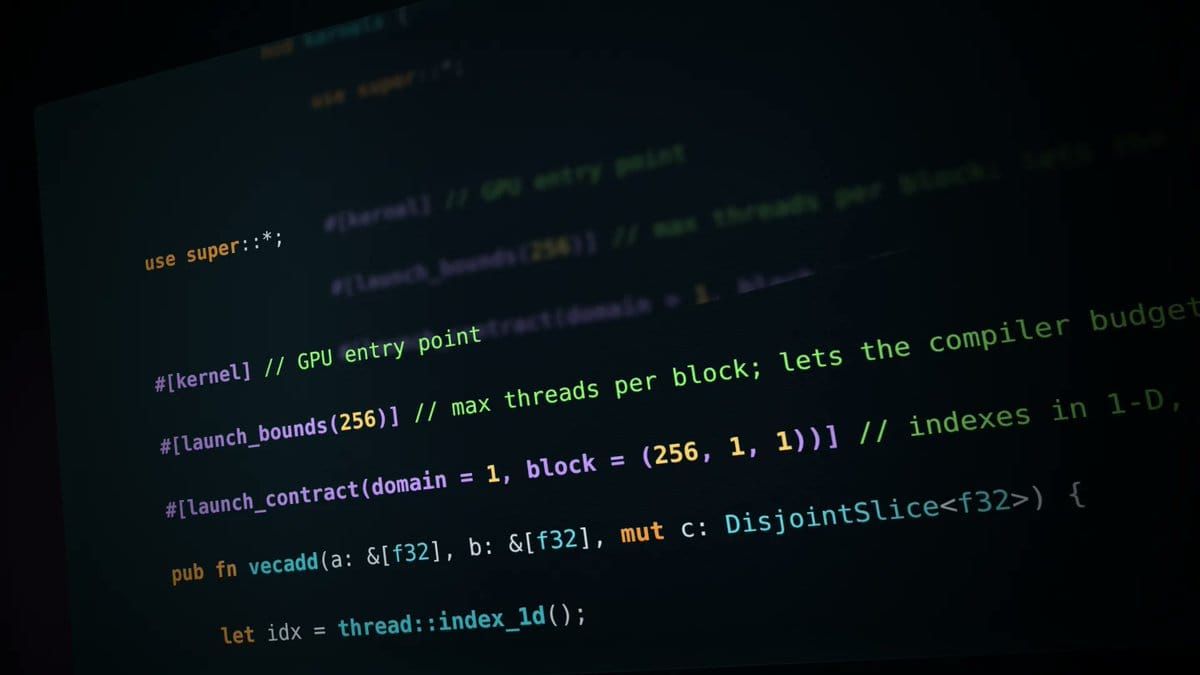
#[kernel]
#[launch_bounds(256)] // 宣告單一 Block 最大 256 執行緒,利於編譯器分配暫存器
#[launch_contract(domain = 1, block = (256, 1, 1))] // 嚴格宣告:1 維幾何拓撲、區塊維度 256
pub fn vecadd(a: &[f32], b: &[f32], mut c: DisjointSlice<f32>) { ... }
在宿主端啟動核心時,你不能直接傳入隨意的數字。系統強制要求走「兩階段調用」:
// 第一階段:校驗契約與硬體上限
let prepared = module.prepare_vecadd(
    LaunchConfig1D::new((N as u32).div_ceil(256), 256, 0)
)?;

// 第二階段:只有持有 prepared 權杖,才能呼叫安全的 vecadd 方法
module.vecadd(&stream, &prepared, &a_dev, &b_dev, &mut c_dev)?;
若你傳入的幾何維度與核心所宣告的契約不合,或者要求的共享記憶體超過硬體承載能力,prepare_vecadd 會在第一時間返回具體的 Rust Result::Err,完全不會將錯誤指令發送給 GPU 驅動。
四、Tile 軌道深度剖析:cutile-rs 如何讓穩定版 Rust 執掌 Tensor Core?
如果說 cuda-oxide 是為底層硬體駭客打造的手術刀,那麼 cutile-rs 就是為現代 AI 算子工程師量身打造的重型巡洋艦。
1. 從「純量思維」躍遷至「張量分塊思維」
在傳統 SIMT 模式下,工程師的大腦必須扮演「單一執行緒」,思考「第 $i$ 號執行緒該抓哪一個 float、做什麼加法、存到哪裡」。然而,現代 GPU 的硬體核心架構早已發生了翻天覆地的變化:NVIDIA 从 Volta、Hopper 到 Blackwell,真正的算力怪獸是 Tensor Core、矩陣乘法加速單元以及非同步張量記憶體加速器(TMA)!
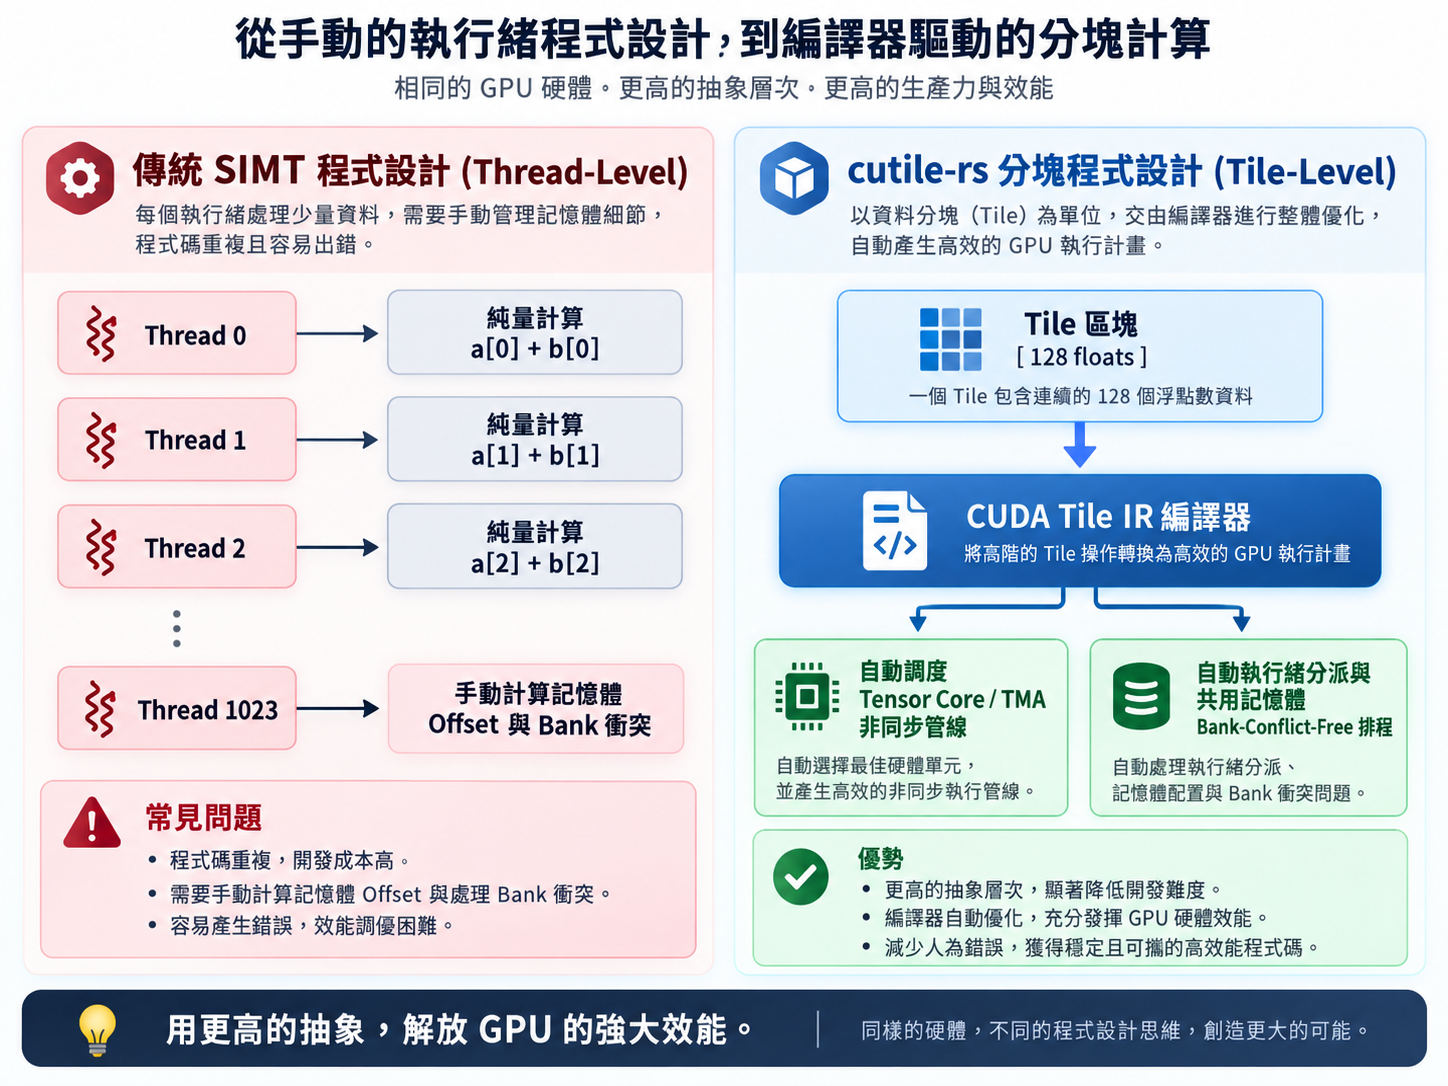
cutile-rs 徹底屏棄了以執行緒為單位的純量思考,直接將抽象層級拉升至 Tile(多維子張量):
- 在
cutile-rs中,整個核心函數在邏輯上只是一個單執行緒!它所操作的基本單元不是一個數字,而是一個「Tile」; - 你只需要定義一個 Tile 大小為 $B$ 的向量該如何與另一個 Tile 相加,至於底層究竟是由 32 個執行緒的 Warp 協同、還是由 4 個 Warp Group 呼叫 TMA 進行非同步搬運,完全交由 NVIDIA 官方的 CUDA Tile IR 編譯器全權決策!
2. 零門檻上手:無須 Nightly、無須自編 LLVM!
長期以來,任何試圖將 Rust 代碼編譯為 GPU 組合語言的專案(如早期社群的 Rust-GPU),最大的痛點就是對編譯器工具鏈的極度苛刻:必須綁定特定日期的 Nightly 版本、必須自己下載數十 GB 的 LLVM 源碼進行魔改編譯,環境配置動輒耗費整整一天。
cutile-rs 徹底打破了這個魔咒:
- ✅ 支援穩定版(Stable Rust 1.89+);
- ✅ 不需要任何自訂 LLVM 或 Clang 開發套件;
- ✅ 只需 CUDA 13.3 驅動環境;
- ✅ 直接在
Cargo.toml宣告cutile = "0.x"即可開箱即用!
它是如何做到的?答案正是 嵌入式 AST + CUDA Tile IR JIT 即時編譯:
use cutile::prelude::*;

#[cutile::module]
mod kernel {
    use cutile::core::*;

    #[cutile::entry()]
    fn add<const B: i32>(
        z: &mut Tensor<f32, { [B] }>, // 獨佔輸出的子張量,長度為編譯期常數 B
        x: &Tensor<f32, { [-1] }>,    // 共享輸入,-1 代表動態長度,啟動時確定
        y: &Tensor<f32, { [-1] }>,
    ) {
        // 單一邏輯執行緒直接載入整個分塊!
        let tx = load_tile_like(x, z);
        let ty = load_tile_like(y, z);
        z.store(tx + ty); // 對整個 Tile 進行平行加法與存儲
    }
}
宏 #[cutile::module] 會在編譯期捕獲該模組的抽象語法樹(AST),並將其序列化儲存在 CPU 二進位檔中。當程式在 GPU 上第一次被啟動時,NVIDIA 的 CUDA Tile IR JIT 引擎 會根據當前電腦上真實插著的顯卡型號(無論是 RTX 4090、H100 還是 B200),現場即時產出針對該微架構最佳化到極致的 SASS 機器碼!
3. 張量分區與 Rust 線性所有權的完美共振
在宿主端調用時,cutile-rs 展現了近乎藝術級別的 Rust 所有權語意設計:
fn main() -> Result<(), Error> {
    let device = Device::new(0)?;
    let stream = device.new_stream()?;

    // 1. 惰性初始化:此時 GPU 尚未有任何動作
    let x = api::ones::<f32>(&[1024]);
    let y = api::ones::<f32>(&[1024]);

    // 2. 分區(Partitioning):一舉三得!
    //    - 賦予每個 Tile 獨佔 128 個元素的寫入權
    //    - 自動將 Grid 固定為 1024 / 128 = 8 個 Tiles
    //    - 將常數泛型參數 B 推導綁定為 128
    let z = api::zeros::<f32>(&[1024]).partition([128]);

    // 3. 所有權轉移與非同步排程:
    //    kernel::add 消耗了 z, x, y 的所有權,確保在 GPU 執行期間宿主端絕不可篡改
    let c: Vec<f32> = kernel::add(z, x, y)
        .first()            // 取出輸出張量 z
        .unpartition()      // 解除分區包裝(零拷貝)
        .to_host_vec()      // 註冊拷回主機請求
        .sync_on(&stream)?; // 此時才正式向 GPU 發射指令並同步!

    println!("PASSED: 成功運算 {} 個元素!", c.len());
    Ok(())
}
這個設計徹底解決了 GPU 非同步非阻塞調用(Asynchronous Streams)中最惡名昭彰的痛點:主機端懸垂指標與競態存取。傳統 C++ 中,CPU 將指標扔給 GPU 後,若不小心提前釋放或覆寫了該記憶體,就會引發未定義行為;而 cutile-rs 透過 Rust 的移動語意(Move Semantics),強制在核心調用時完全移交張量所有權,直到同步完成前,CPU 程式碼根本無法觸碰該記憶體區塊。
4. 產業落地先行者:Hugging Face Grout 與 mistral.rs
cutile-rs 絕非實驗室裡的玩具。事實上,在 NVIDIA 正式發表技術部落格的當下,開源社群兩大頂級推論專案已經完成接入並交出亮眼成績單:
- 🤗 Hugging Face Grout: Hugging Face 全新打造的純 Rust 次世代推論引擎 Grout,已全面採用
cutile-rs重寫其核心 Attention 與混合專家(MoE)路由算子,在完全脫離 Python 執行環境的前提下,締造了比傳統 vLLM 更低的主機端排程開銷; - ⚡ mistral.rs: 由 Eric Buehler 主導、目前 GitHub 最炙手可熱的純 Rust 前沿 LLM 推論框架
mistral.rs,率先整合了cutile-rs的 GEMM(通用矩陣乘法)核心,在各類量化權重(FP8、AWQ)下的推論吞吐量大幅超越傳統 C++/CUDA 綁定。
五、同場實測對照:SIMT vs. Tile 向量加法代碼透視
為了讓讀者深刻感受兩種範式的本質差異,我們將兩種寫法並列於下表進行極致對比:
// ==========================================
// 軌道一:cuda-oxide (SIMT 裸機控制軌道)
// 特色:手動索引、DisjointSlice 防護、強型別邊界
// ==========================================
#[cuda_module]
mod kernels {
    use super::*;

    #[kernel]
    #[launch_bounds(256)]
    #[launch_contract(domain = 1, block = (256, 1, 1))]
    pub fn vecadd(a: &[f32], b: &[f32], mut c: DisjointSlice<f32>) {
        let idx = thread::index_1d(); // 取得強型別索引權杖
        let idx_raw = idx.get();      // 轉為純 usize

        // 必須透過 Option 安全解構,消滅越界風險
        if let Some(c_elem) = c.get_mut(idx) {
            *c_elem = a[idx_raw] + b[idx_raw];
        }
    }
}

// ==========================================
// 軌道二:cutile-rs (Tile 現代分塊軌道)
// 特色:無執行緒概念、張量為單位、Tile IR 自動降級
// ==========================================
#[cutile::module]
mod kernel {
    use cutile::core::*;

    #[cutile::entry()]
    fn add<const B: i32>(
        z: &mut Tensor<f32, { [B] }>, // 獨佔分塊
        x: &Tensor<f32, { [-1] }>,
        y: &Tensor<f32, { [-1] }>,
    ) {
        // 單一邏輯流,直接以整塊 Tile 進行代數運算
        let tx = load_tile_like(x, z);
        let ty = load_tile_like(y, z);
        z.store(tx + ty);
    }
}
兩者該如何抉擇?
- 👉 黃金選型法則:「能用 Tile,就絕不碰 SIMT!」
NVIDIA 官方極力建議開發者優先採用cutile-rs。因為 Tile 抽象不綁定任何具體硬體架構,當未來 NVIDIA 推出次世代架構時,你的 Tile 核心只需重新 JIT,就能自動吃滿新硬體的特殊單元;反之,若你的演算法存在高度不規則的稀疏資料存取、需要直接使用 Warp-level Primitive(如__shfl_sync),才需要降級至cuda-oxide。
六、戰略深意:NVIDIA 為何在此刻發動「CUDA Rust」革命?
這場發表表面上是一次編譯器技術的重大升級,但若放在全球半導體與 AI 霸權競爭的棋局中審視,背後蘊含著深遠的戰略算計:
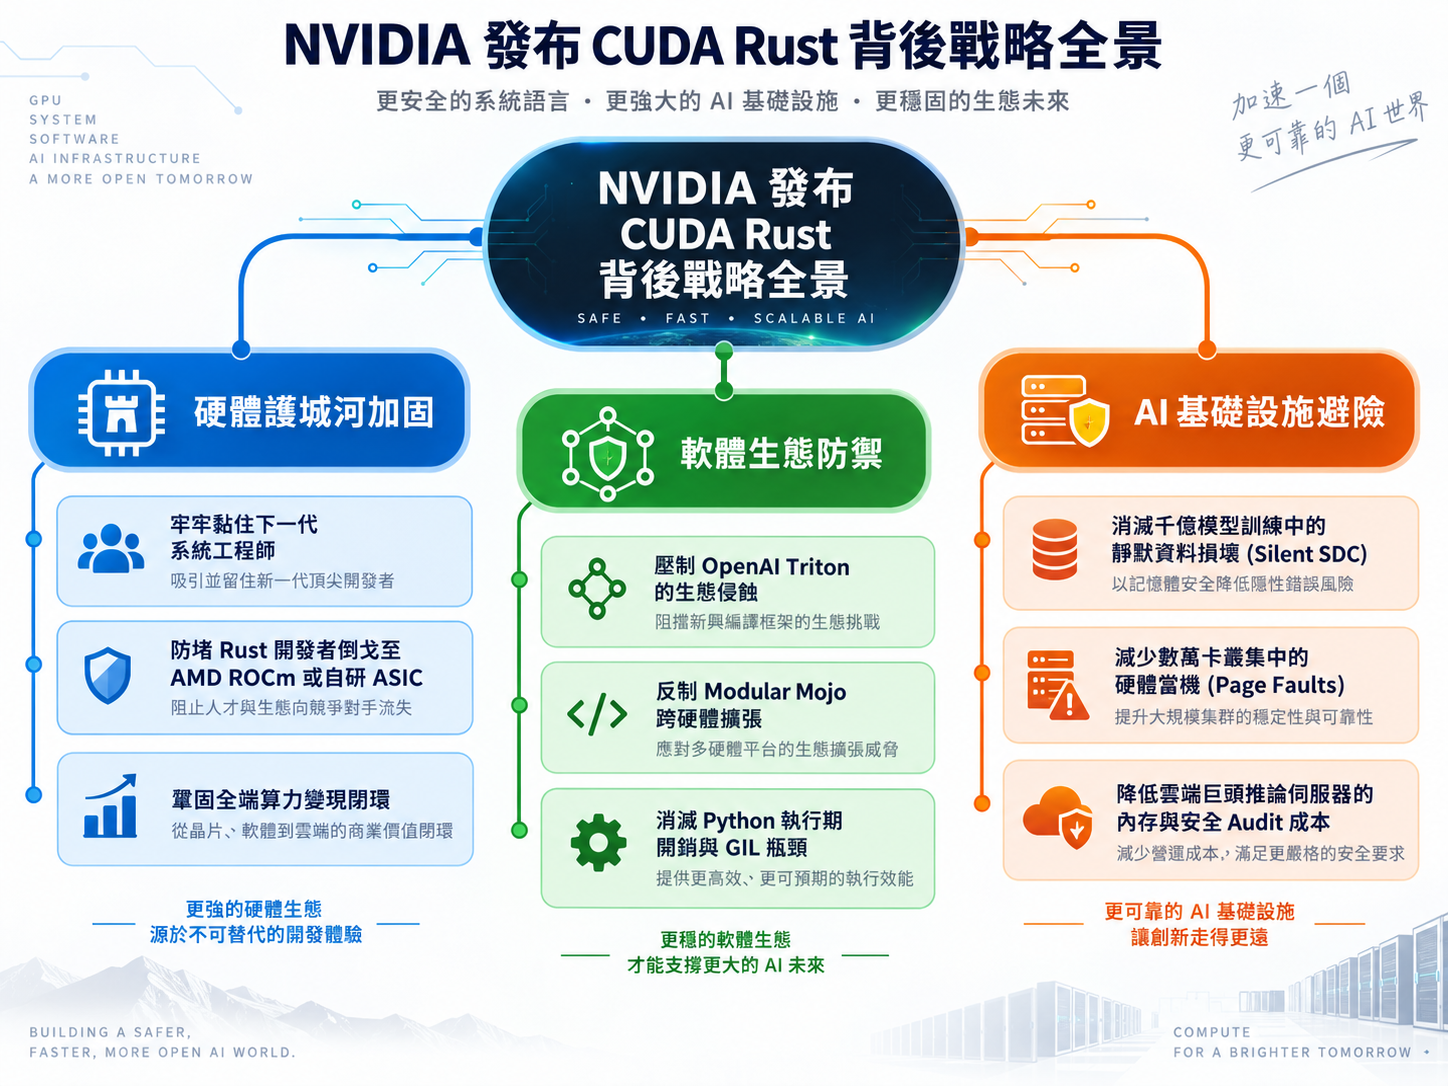
1. 壓制 Triton 與 Mojo:鞏固軟體護城河
過去幾年,AI 核心編程領域出現了兩大異端挑戰者:
- OpenAI Triton:利用 Python 語法簡化 GPU 核心撰寫,成功被 PyTorch 採納為底層預設,但其對 Python 環境的依賴與在極致系統級工程中的疲軟始終是痛點;
- Modular 的 Mojo 語言:主打相容 Python 語法且具備 Rust 級別的型別安全與硬體加速,試圖繞過 CUDA 直接編譯至多種硬體。
面對這股壓力,NVIDIA 的反擊快狠準:既然高階系統開發者渴望記憶體安全與型別契約,NVIDIA 就親自把最正統、最受歡迎的系統語言之王——Rust,請進 CUDA 的神殿之中! 藉由提供官方等級的 cuda-oxide 與 cutile-rs,NVIDIA 徹底粉碎了競爭對手試圖以「記憶體安全」或「現代語意」為切入點顛覆 CUDA 霸權的野心。
2. 百億美元級叢集的「靜默錯誤(Silent SDC)」止血計
在訓練 5,000 億參數以上的超級多模態模型時,全球頂級實驗室動輒調用數萬張 H100/B200 連續運轉數月。在如此龐大的分散式系統中,最令架構師膽戰心驚的不是顯卡燒毀,而是 「靜默資料損壞(Silent Data Corruption, SDC)」。
傳統 C++ 核心若存在微小的資料競爭或邊界錯誤,往往不會立刻 Crash,而是產出極其微小、不易察覺的數值偏差。經過數萬層 Transformer 反向傳播放大後,最終導致模型損失函數在訓練兩週後突然爆炸(Loss Spike),直接蒸發數百萬美元的電費與算力!CUDA Rust 透過強型別契約與編譯期防別名保證,將這類致命的幽靈錯誤徹底封死在編譯階段,為全球 AI 基礎設施提供了前所未有的工程確定性。
七、開發者 5 分鐘快速上手實戰指南
想要立刻在你的機器上體驗用 Rust 寫 GPU 核心的快感嗎?請依照以下步驟操作:
方案 A:體驗現代 Tile 核心(cutile-rs,推薦首選)
只需確認系統安裝有 CUDA 13.3 與 Rust 1.89+ 穩定版:
# 1. 建立全新 Rust 專案
cargo new cutile_demo
cd cutile_demo

# 2. 直接自 crates.io 引入 cutile
cargo add cutile

# 3. 將前文的 Tile 向量加法代碼貼入 src/main.rs
# 4. 直接執行編譯與 JIT 運行!
cargo run
方案 B:體驗底層 SIMT 裸機核心(cuda-oxide)
需要 Linux 系統、NVIDIA GPU(Compute Capability 8.0+)、CUDA 12.x+ 以及 Clang/LLVM 開發庫:
# 1. 安裝專屬的 cargo 子命令(鎖定專用 nightly 版本)
cargo +nightly-2026-04-03 install --git https://github.com/NVlabs/cuda-oxide.git cargo-oxide

# 2. 建立示範專案範本
cargo oxide new vecadd_demo
cd vecadd_demo

# 3. 診斷環境工具鏈是否齊全(檢查 CUDA、libclang 等)
cargo oxide doctor

# 4. 編譯並運行(首次運行會自動建構 codegen 後端)
cargo oxide run
八、結語:異質加速運算全面邁向「記憶體安全」新紀元
回顧半導體與軟體工程的發展史,硬體架構的每一次巨大躍進,終究需要與之相配的程式語言來解放其真正威力。
2006 年,NVIDIA 推出 CUDA C/C++,將 GPU 從純粹的 3D 繪圖卡解放為撼動世界的通用平行運算引擎(GPGPU),點燃了二十年後生成式 AI 的熊鬼烈火;
2026 年,NVIDIA 正式推出 CUDA Rust,宣告 GPU 運算由「裸奔除錯的野蠻時代」,正式跨入「編譯期形式化安全」的理性時代!
無論是追求極致微觀控制的 cuda-oxide,還是將張量分塊抽象發揮到極致的 cutile-rs,CUDA Rust 的誕生象徵著異質加速運算的最後一塊拼圖終於歸位。當 Rust 的編譯期智慧與 NVIDIA 的矽晶算力在最底層無縫交融,一個更安全、更確定、更大規模的軟體與 AI 新紀元,已經呼之欲出。
官方開源專案與延伸資源索引
- cuda-oxide 官方 GitHub:https://github.com/NVlabs/cuda-oxide
- cutile-rs 官方 GitHub:https://github.com/NVlabs/cutile-rs
- cuda-oxide 官方開發者手冊:https://nvlabs.github.io/cuda-oxide/
- cuTile Rust 官方文檔:https://nvlabs.github.io/cutile-rs/main/
- NVIDIA 官方技術發布專文:https://developer.nvidia.com/blog/introducing-cuda-rust-two-tracks-for-writing-gpu-kernels/