Google 員工內部測試 Gemini 4 新版本 Carbon:Argon 還沒全面開放,「像 Opus 5.5」能信多少?
Google 員工在內部測試 Gemini 4 新版本 Carbon,有人說寫程式像 Anthropic 的 Opus 5.5。本文核對原始報導,說明 Argon 開放進度與這句評價的分量。
Google 在 9 月 30 日公布 Gemini 4 Argon,到現在多數開發者仍無法直接呼叫它。
但在 Google 內部,員工已經開始試用下一個版本。
Business Insider 在 10 月 9 日報導,代號 Carbon 的 Gemini 4 新版本,最近幾天開放到 Google 內部的程式平台 Jetski。
一名員工形容 Carbon 寫程式「感覺像 Opus 5.5」,同時補充還需要更多測試。Opus 5.5 是 Anthropic 的 Claude 模型,Google 自己公布的比較表也拿它當對手。
這句帶著保留的感想,在 X 上被轉述成「Carbon 追平 Opus 5.5」。
我的判斷是,Carbon 說明 Google 內部已有比公告更新的版本,但還不能當成公開版能力的證據。
而公開的 Argon,現在也只開放給一小群資安團隊。
公開版 Argon 目前只開放給少數資安夥伴
Argon 是 Google 新一代的旗艦模型。官方公告說,它在程式、企業知識工作與資安防禦都有進展。
不過開放範圍很窄。Google DeepMind 資深副總裁 Koray Kavukcuoglu 在公告中寫道,Argon 先透過 Fairwind 計畫提供給一批受信任的資安防禦者。
Fairwind 是 Google 先讓受信任的資安團隊試用新模型的計畫。公告說,這批測試者的回饋會先用來強化系統,之後才擴大到付費 API 客戶與 Google AI Ultra 訂閱者。
API 是讓開發者用程式直接呼叫模型的介面。企業要把模型接進自己的產品或內部工具,通常得等這個管道開放。
公告列出了價格,卻沒有寫出擴大開放的日期。路透社報導也指出,Google 沒有提供公開發布的時間表。
這代表一般開發者看到的 Argon,目前大多還只是公告頁上的介紹與比較表。
公開版還在排隊,內部已經在測更新的版本,Carbon 的消息就是在這段空窗期出現的。
Carbon 是什麼:可能是 Argon 的新存檔點
Business Insider 記者 Hugh Langley 根據內部文件、截圖與員工訊息寫成這篇報導。
報導說 Carbon 可能是 Argon 的新 checkpoint。checkpoint 可以想成訓練途中存下的版本,模型繼續訓練,就會產生更新的存檔點。
Google 內部用 Argon、Barium、Carbon 等代號標記測試中的 Gemini 4 版本。其中名為 Barium-B 的版本,最後被選為公開發布的 Argon。
Carbon 未來會用 Argon 的名稱更新,還是成為另一款 Gemini 4 模型,報導說目前無法確定。Google 則拒絕評論。
所以 Google 內部確實有比公開公告更新的版本在測試,但報導裡關於它能力的線索,只有員工的幾句使用感想。
「感覺像 Opus 5.5」能證明多少?
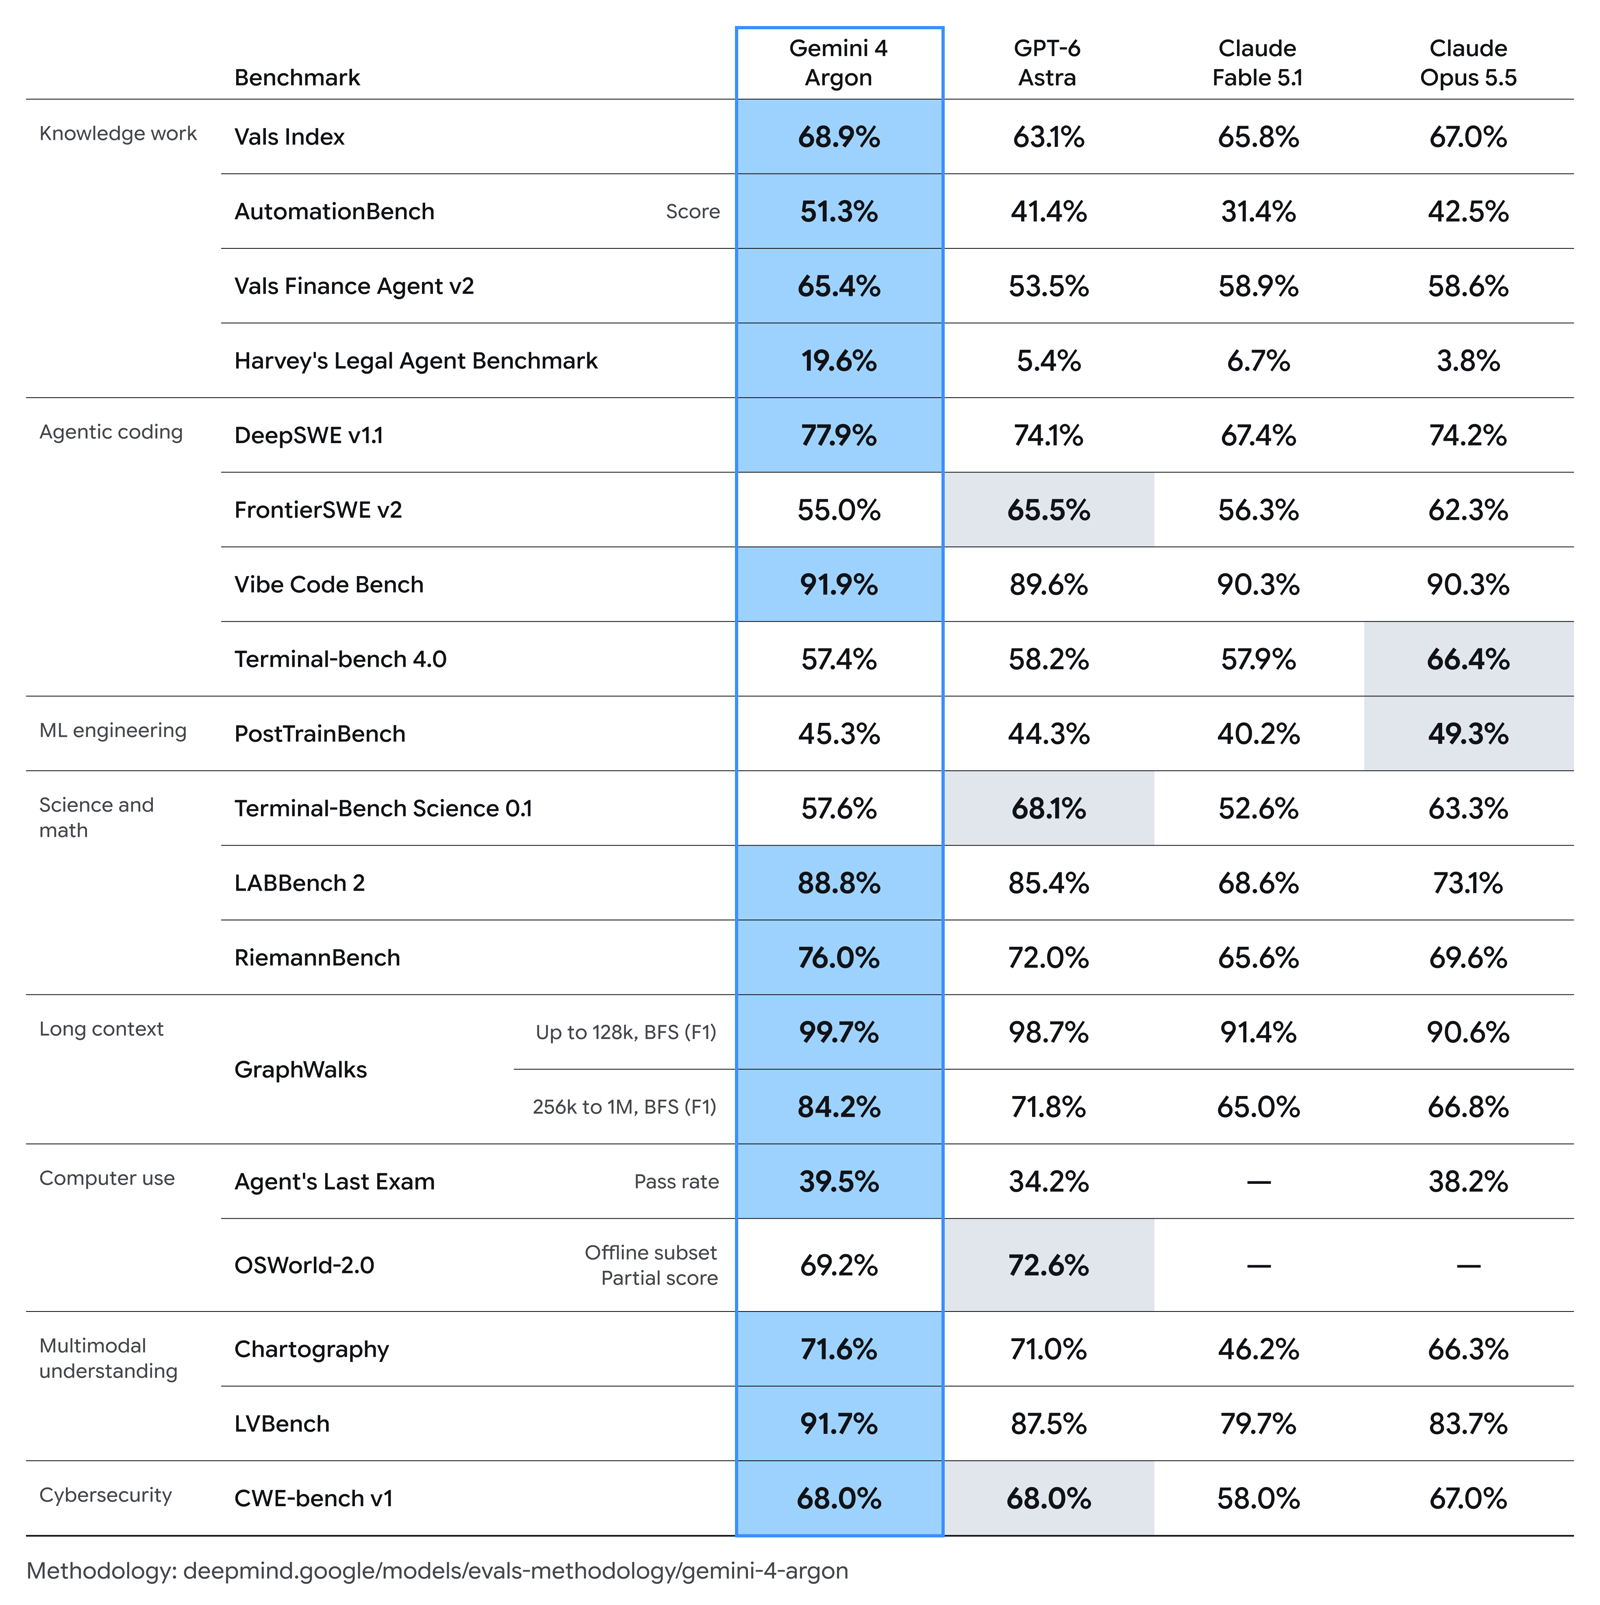
Google 公告的比較表,是目前唯一能拿來對照的公開數字。Argon 在 DeepSWE v1.1 拿到 77.9%,高於表上 Opus 5.5 的 74.2%。
DeepSWE 是測試模型處理長時間、真實軟體工程任務的基準。這組分數由 Google 自己公布,目前沒有看到第三方重測。
同一張表也顯示 Argon 有落後的項目。Terminal-bench 測的是模型在命令列環境完成操作的能力,Argon 在 4.0 版是 57.4%,低於 Opus 5.5 的 66.4%。
在另一項軟體工程測試 FrontierSWE v2,Argon 是 55.0%,也低於 Opus 5.5 的 62.3%。
Business Insider 另外提到,有員工認為早期 Argon 在部分程式任務上,只接近較舊的 Opus 5。
這些數字顯示,Argon 的程式能力在不同測試上有高有低。Carbon 有沒有補上這些落後項目,目前只有少數員工的感受,沒有任何分數。
「感覺像」是主觀描述,「在同一組測試追平」需要數據,兩者的證據等級差很多。
但在 X 上,這句感受已經被改寫成更強的說法。
讀內部消息時,該看哪些訊號
最先要看的是原話有沒有被改寫。同一則報導,Andrew Curran 的貼文寫成 Carbon 寫程式「matches Opus 5.5」,kimmonismus 則寫成「approaching」,強度已經不同。
也有評論把 Carbon 和遞迴自我改進連在一起,意思是讓 AI 自己做出更強的下一代 AI。這個說法沒有出現在原始報導裡,只能算社群推測。
其次是看證據來自哪裡。員工訊息、內部截圖和官方比較表,可信度各不相同,引用時要分開寫。
最後是看有沒有發布計畫。報導只說 Carbon 最近幾天上線內部平台,也提醒這些更新可能補上差距,但 Google 不一定會對外釋出。
對打算導入 Gemini 的團隊來說,會影響決策的是 API 開放時間,以及公開版和內部版的差距。
在那之前,比較穩妥的做法是先整理自己的程式任務測試集,等 Argon 或後續版本開放,就能直接拿同一批任務比較。
測試集可以保留團隊曾修過的錯誤與驗收標準。除了看程式能不能跑,也記錄模型花多久、需要人提醒幾次,避免只靠一段流暢的示範選工具。
模型版本也要記錄。Carbon、公開 Argon 和後續更新若沒有用相同任務測試,就無法知道提升來自模型、工具設定,還是使用者提供了更多提示。
常見問題
Carbon 會取代 Argon 嗎?
目前不知道。報導說 Carbon 可能是 Argon 的更新版,也可能是另一款 Gemini 4 模型,Google 拒絕評論。
現在可以用到 Gemini 4 Argon 嗎?
一般使用者還不行。官方說先開放給 Fairwind 計畫的資安夥伴,之後才擴大到付費 API 客戶與 Ultra 訂閱者,沒有給日期。
Argon 寫程式比 Opus 5.5 強嗎?
依 Google 自己的比較表,Argon 在 DeepSWE v1.1 較高,在 Terminal-bench 4.0 與 FrontierSWE v2 較低,結果要看測的是哪一種任務。
結語
Carbon 讓人看到 Google 內部已有比公開版更新的版本,但一句「感覺像 Opus 5.5」撐不起能力排名。等 Google 公布開放日期與獨立測試結果,再決定要不要調整工具選擇也不遲。
延伸閱讀:Gemini 4 Argon 正式亮相:現在誰能用、怎麼收費,值得先準備什麼?
延伸閱讀:Gemini 4 Argon 開始處理大型程式遷移:Google 的 Rust 案例,團隊可以學到什麼?