Hugging Face 多框架強化學習:同一個 AI 模型,換工作工具為什麼就變了?
Hugging Face 發布多框架強化學習指南,讓開放模型在 Claude Code、Codex 等工具內練習。本文解析任務成功率、工具呼叫下降與實際導入意義。

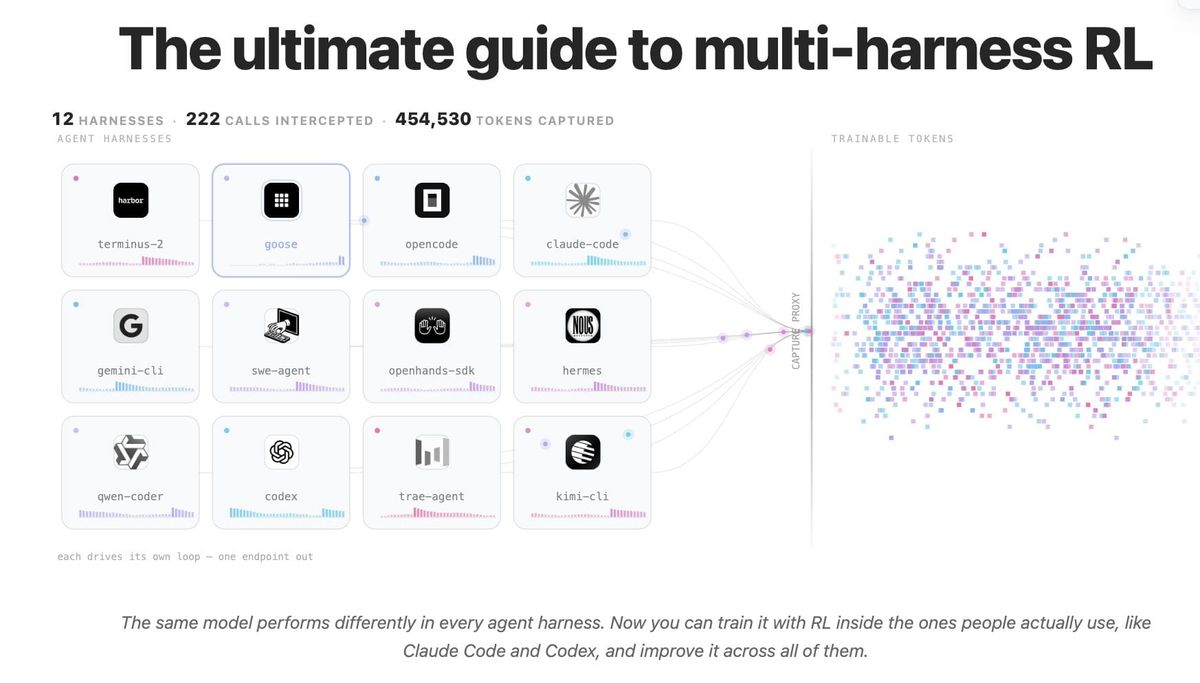
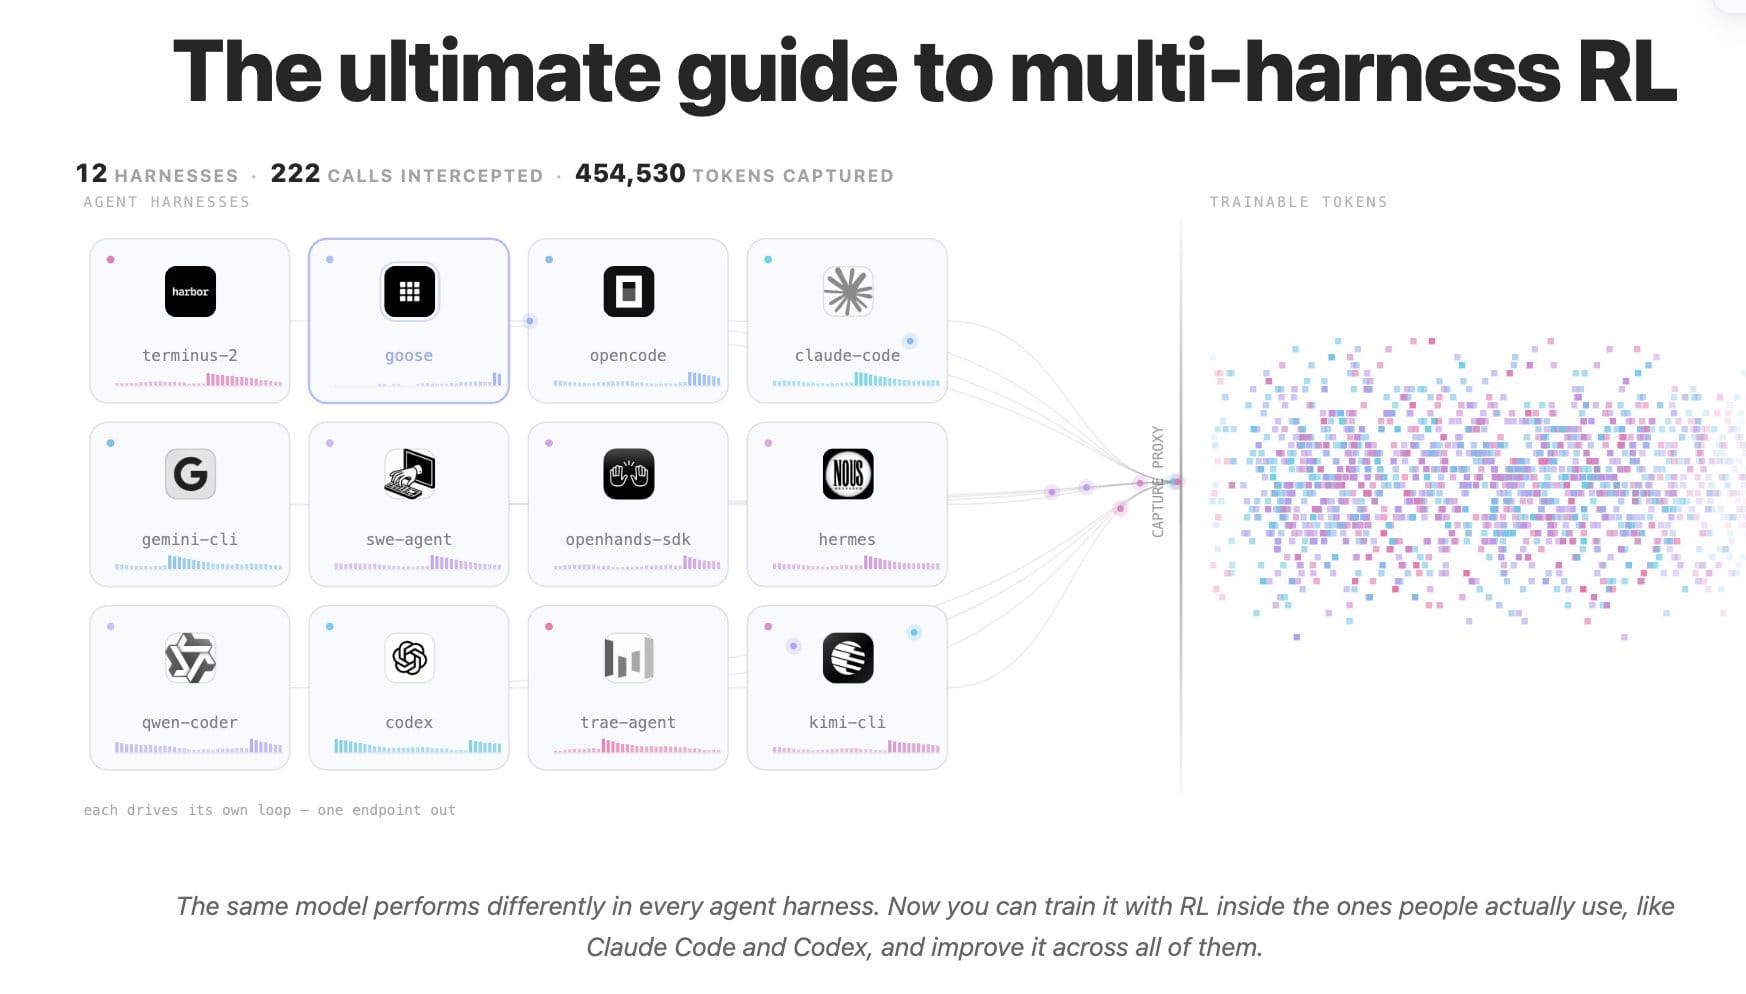
你可能在兩個程式工具裡使用同一個 AI 模型,卻得到不同結果。一個能修改檔案並完成測試,另一個反覆呼叫錯誤工具。Hugging Face 新發布的研究把問題指向模型周圍的工作框架,並提出在多種框架內一起訓練的方法。
這份指南於 2026 年 10 月 1 日發布,官方 X 帳號在 10 月 2 日再次介紹,成為今天研究的熱門線索。它最有意思的結果,是小型開放模型在四種框架上的平均任務成功率,從 42% 升至 54%。這是特定實驗的結果,也提醒團隊:採購或比較 AI 時,應同時看它實際在哪個工具裡工作。
工作框架決定模型看見什麼
工作框架的英文是 harness,指的是包在模型外面的程式。它提供工具、整理對話內容、執行操作,也決定何時重試與停止。模型可以選擇呼叫工具,但框架決定工具如何執行,以及結果如何送回模型。
例如,兩個工具都提供「改檔案」,名稱與參數格式卻不一定相同。模型若一直沿用熟悉的格式,換到另一套工具時,請求可能在真正修改前就被拒絕。這類失敗和模型是否知道程式語法,是不同的問題。
Hugging Face 官方指南因此把研究重點放在模型如何適應多種工具環境。對使用者的意義是,排行榜上的能力需要在自己的工具組合裡重現,才適合用來預估工作成果。
強化學習讓模型練習完整任務
強化學習是讓模型嘗試行動,再根據結果得到獎勵或扣分的訓練方式。用在程式代理時,它練習的是讀檔、修改、執行與檢查等連續操作。代理是能使用工具並接續行動的 AI,任務完成後才評估整體結果。
研究團隊沒有修改各框架的內部程式,而是在框架與模型之間放入一層轉接服務。這層服務接收不同格式的模型請求,記錄實際生成的資料,再供訓練程式使用。研究工具由 OpenEnv、Harbor 與 TRL 等開放專案組合而成。
這個設計的價值,是讓訓練盡量接近使用者真正操作的環境。只練習單一工具,可能會讓模型更熟悉那個工具的習慣,卻無法把進步帶到其他環境。多框架訓練則把「換工具也能完成工作」納入目標。
42% 到 54%,應該怎麼看
官方實驗使用 LFM2.5-2.6B 小型開放模型,在四種框架一起訓練。未用於訓練的測試任務平均成功率從 42% 增加到 54%,相差 12 個百分點。測試任務的意義,是檢查模型能否把所學帶到另外的題目。
研究也報告,對原本就能解決的任務,工具呼叫次數減少 31%。這個範圍很重要:它描述的是該批任務的操作次數,不能直接換算成所有使用者的費用都下降 31%。實際成本還包含模型讀取與生成的內容、機器資源與執行時間。
我會把這兩個結果一起看。成功率提高表示模型做成更多工作,操作次數下降則表示部分工作更俐落。若只追求少呼叫工具,模型也可能略過必要檢查,因此效率需要和完成品質一起衡量。
團隊可以先做小規模比較
這份研究最容易帶進日常工作的做法,是固定模型與任務,再比較不同框架。可以選一組常見修改,保留相同檔案版本、完成要求與時間限制,查看哪個工具組合更常產出可接受的成果。
例如,同一項表單修正,除了畫面能用,還要確認輸入驗證與原有功能。完成標準固定後,才看出差異來自框架、模型,或只是某次任務運氣較好。這是一個示意評估方法,本文沒有自行執行對照實驗。
如果你已經準備自行訓練模型,官方開放的程式與資料是研究起點。一般團隊則可以先用同條件測試改善工具選擇,不必直接投入訓練成本。
常見問題
同一模型的排行榜成績可以直接搬到另一個工具嗎?
不一定。工具格式、上下文整理與停止方式都可能改變結果,應查看排行榜使用的完整環境。
多框架訓練保證所有工具都會進步嗎?
這次研究支持的是指定模型、框架與任務下的結果。新工具與不同工作仍需要另外驗證。
工具呼叫較少就一定比較好嗎?
要先確認工作完成。少做了必要檢查的代理,即使操作較少,也不應算成效率改善。
結語:比較完整工作系統
這份指南讓 AI 能力比較更貼近使用者的實際經驗。對我來說,最有價值的啟發是把模型、工具與完成標準放在一起看,並用相同任務確認成果。
選模型時加上工具環境,驗收時保留必要檢查,才能看出成功率與效率是否一起改善。對小型開放模型的研究,也因此有機會從一次漂亮分數,走向多種工具裡都能使用的能力。