NVIDIA Nemotron 3 Diarization 是什麼?1 億參數模型標記 8 位說話者
Nemotron 3 Diarization 把說話者分段延伸到 8 位並支援重疊發言。先看懂它與 ASR 的分工,再拆解排行榜測試範圍、模型授權和實際部署限制。
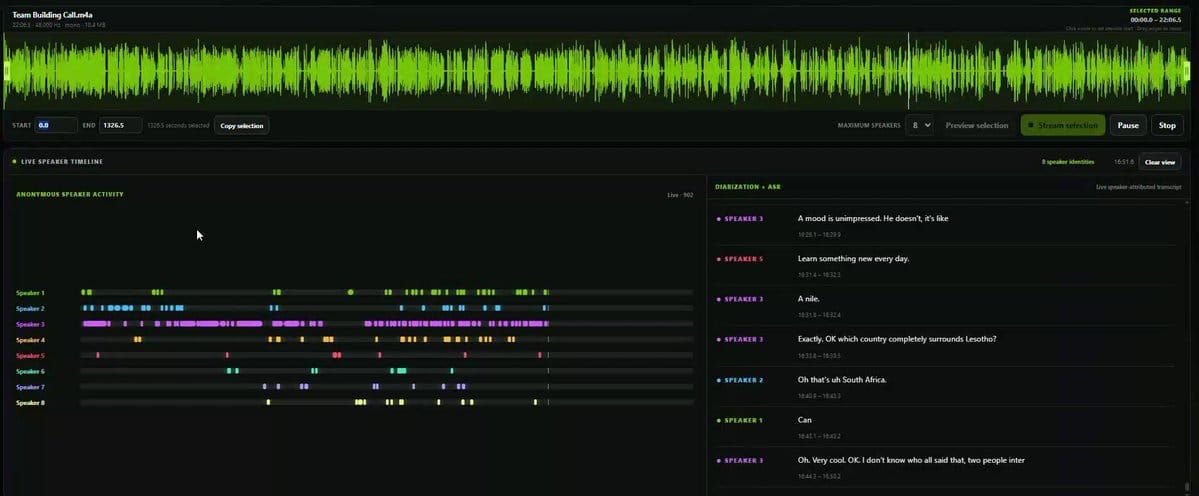
一場會議的逐字稿就算把每個字都聽對了,如果看不出是誰說的,行動項目、反對意見和承諾仍可能被記錯。NVIDIA 在 2026 年 9 月 23 日公開 Nemotron 3 Diarization,主打把音訊中的「誰在什麼時間說話」標記出來,最多追蹤 8 位說話者,也能處理多人同時發言。
這個模型值得注意的地方,不只是參數量小,而是它把離線錄音和即時串流(邊收音邊分析)放進同一套模型,並提供多種延遲設定。不過,它不會自己把語音轉成文字,也不會認出說話者的真實姓名。要了解它能不能用在會議或客服產品裡,先得分清楚它和語音辨識各自做什麼。
NVIDIA AI 官方貼文附有模型展示影片:
Nemotron 3 Diarization 是什麼?它回答「誰在何時說話」
說話者分段(speaker diarization)是把一段音訊切成不同人的發言區段,並標上時間與匿名代號,例如 speaker_0、speaker_1。它處理的是「誰在什麼時候發聲」,不一定知道對方的名字。
語音辨識(ASR)則負責把聲音轉成文字。兩種工具合在一起,才會得到「speaker_0 在 00:12 說了某句話」這種帶有說話者標籤的逐字稿。NVIDIA 的模型卡指出,Nemotron 3 Diarization 每 10 毫秒可輸出各說話者正在發聲的機率。多人重疊時,同一時間可以有不只一個聲道被標記為活躍。
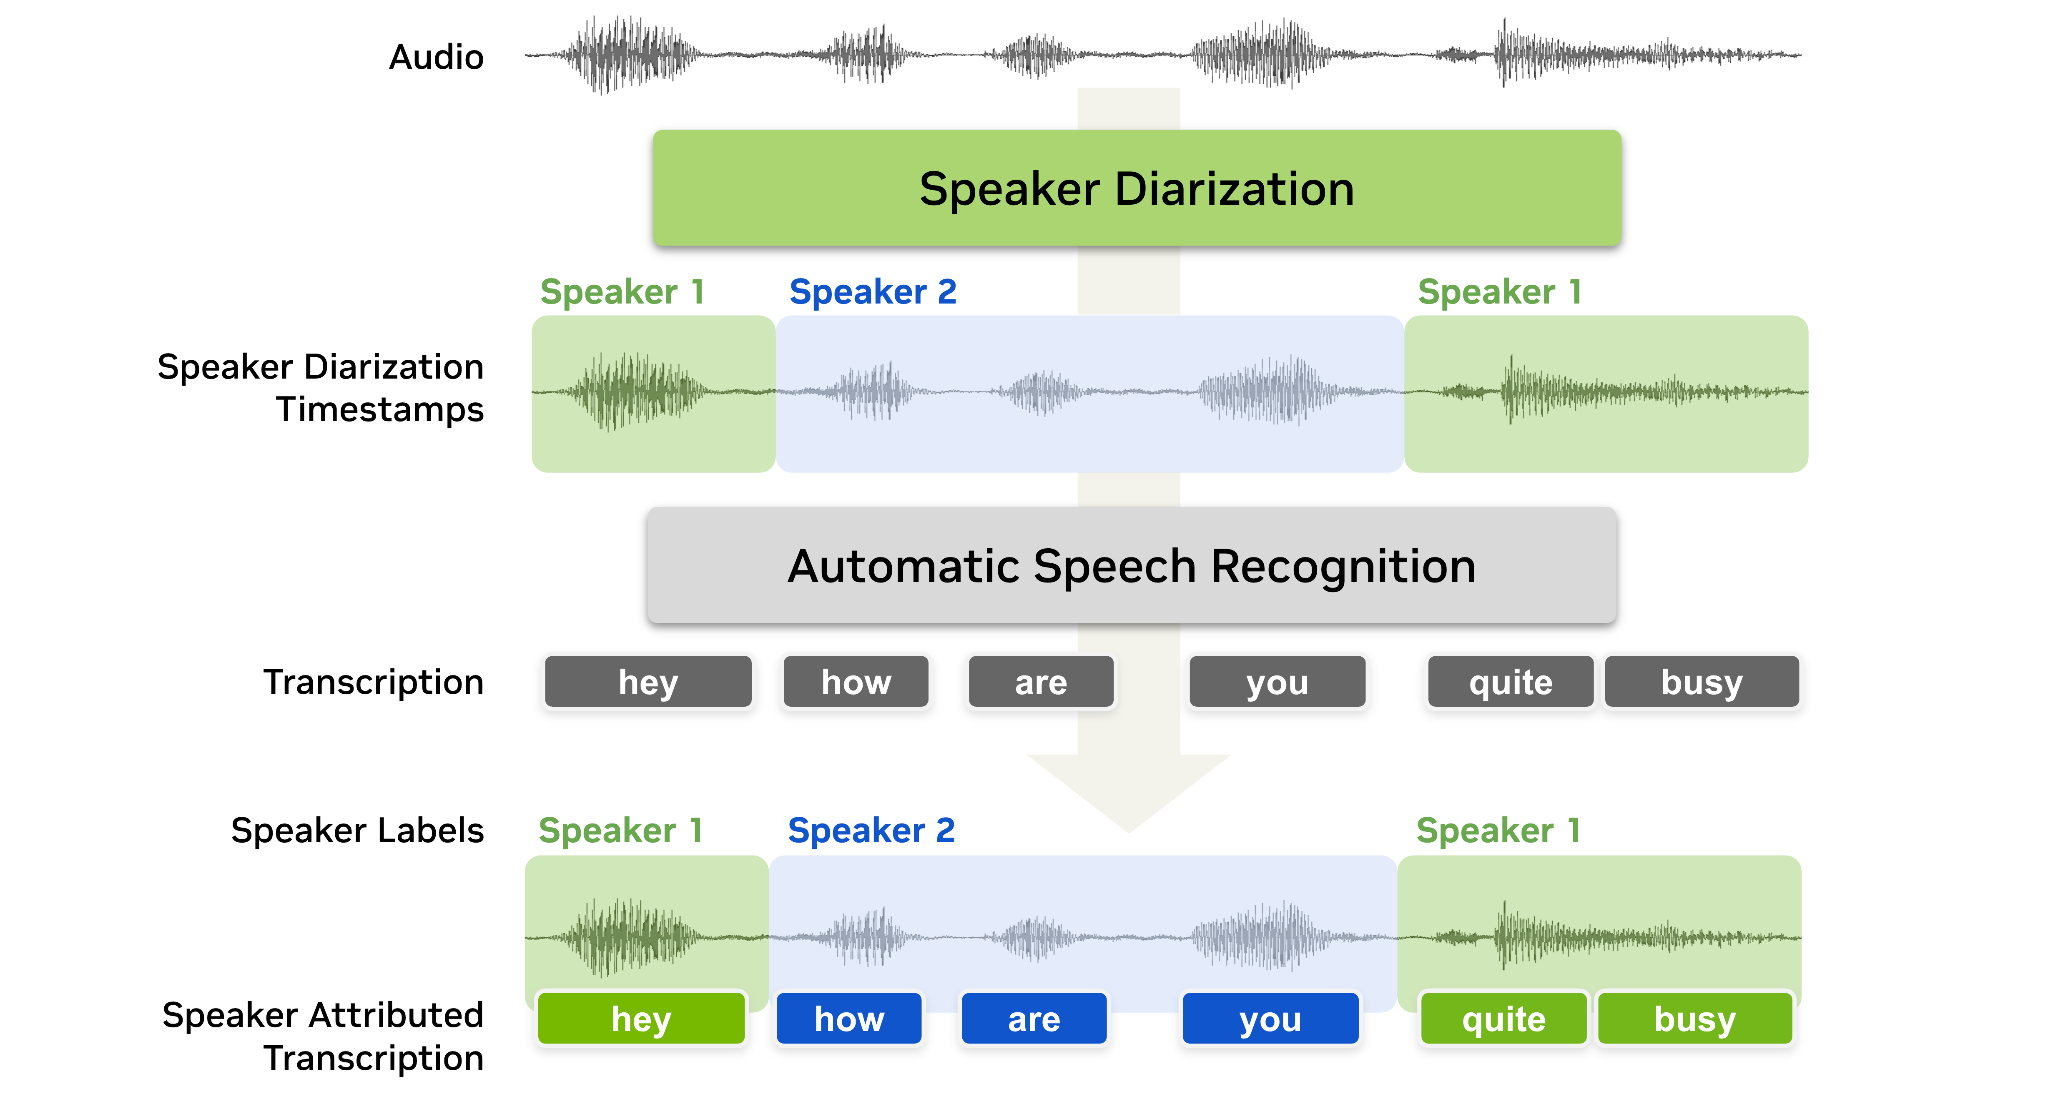
這個差異直接影響使用方式。若你需要會議逐字稿,還要同時串接 ASR 模型。若只要量測客服對話中誰說得比較多,說話者時間軸本身就可能有用。它不會把兩個人的重疊聲音分離成兩條乾淨錄音,也不會替 speaker_0 查出真實姓名。
1 億參數、最多 8 位說話者,支援錄音與即時串流
Nemotron 3 Diarization 有 1 億個模型參數。參數是模型運算時使用的內部數值,但參數量不等於可直接推論的準確度或硬體需求。比較實際的規格如下:
| 項目 | NVIDIA 公開資訊 |
|---|---|
| 模型大小 | 1 億參數 |
| 追蹤人數 | 最多 8 位,輸出為匿名說話者標籤 |
| 使用情境 | 即時串流或錄音後處理 |
| 音訊輸入 | 16 kHz、單聲道(mono)音訊 |
| 串流延遲設定 | 官方建議最低輸入緩衝約 0.32 秒。也可選 0.64、1.04 秒 |
| 離線設定 | 可使用約 30.4 秒輸入緩衝,以較完整的前後文處理 |
「0.32 秒」是模型開始處理前需要累積的輸入音訊時間,不是整個應用程式從收音到顯示結果的總延遲。計算、網路傳輸、語音辨識和畫面更新都會再花時間。若要做即時字幕,開發者仍需在速度和正確率之間測試取捨。
最多 8 位也有明確邊界。遇到超過 8 人、背景噪音大、回音重或收音太遠的情況,模型可能漏掉發言或把人分錯。NVIDIA 也提醒,長時間錄音或音訊環境和訓練資料差異很大時,準確度可能下降。
NVIDIA 說它在說話者分段基準測試排名第一,成績怎麼看?
Nemotron 3 Diarization 在 VoiceArena 初版 Diarization-Bench 的 12 個系統、17 種設定中排名第一。該測試涵蓋 139 段英文對話,合計約 22 小時。評分會計入重疊發言,且不排除時間邊界誤差。NVIDIA 公布的錯誤率為 14.72%,排名第二的系統為 19.3%。
這裡的錯誤率叫說話者分段錯誤率(DER),會把漏掉語音、把安靜誤判成說話,以及把發言歸錯人等情況納入計算。數字越低越好。14.72% 不等於「有 85.28% 的句子都正確」,也不能直接當成你公司的會議錄音準確率。
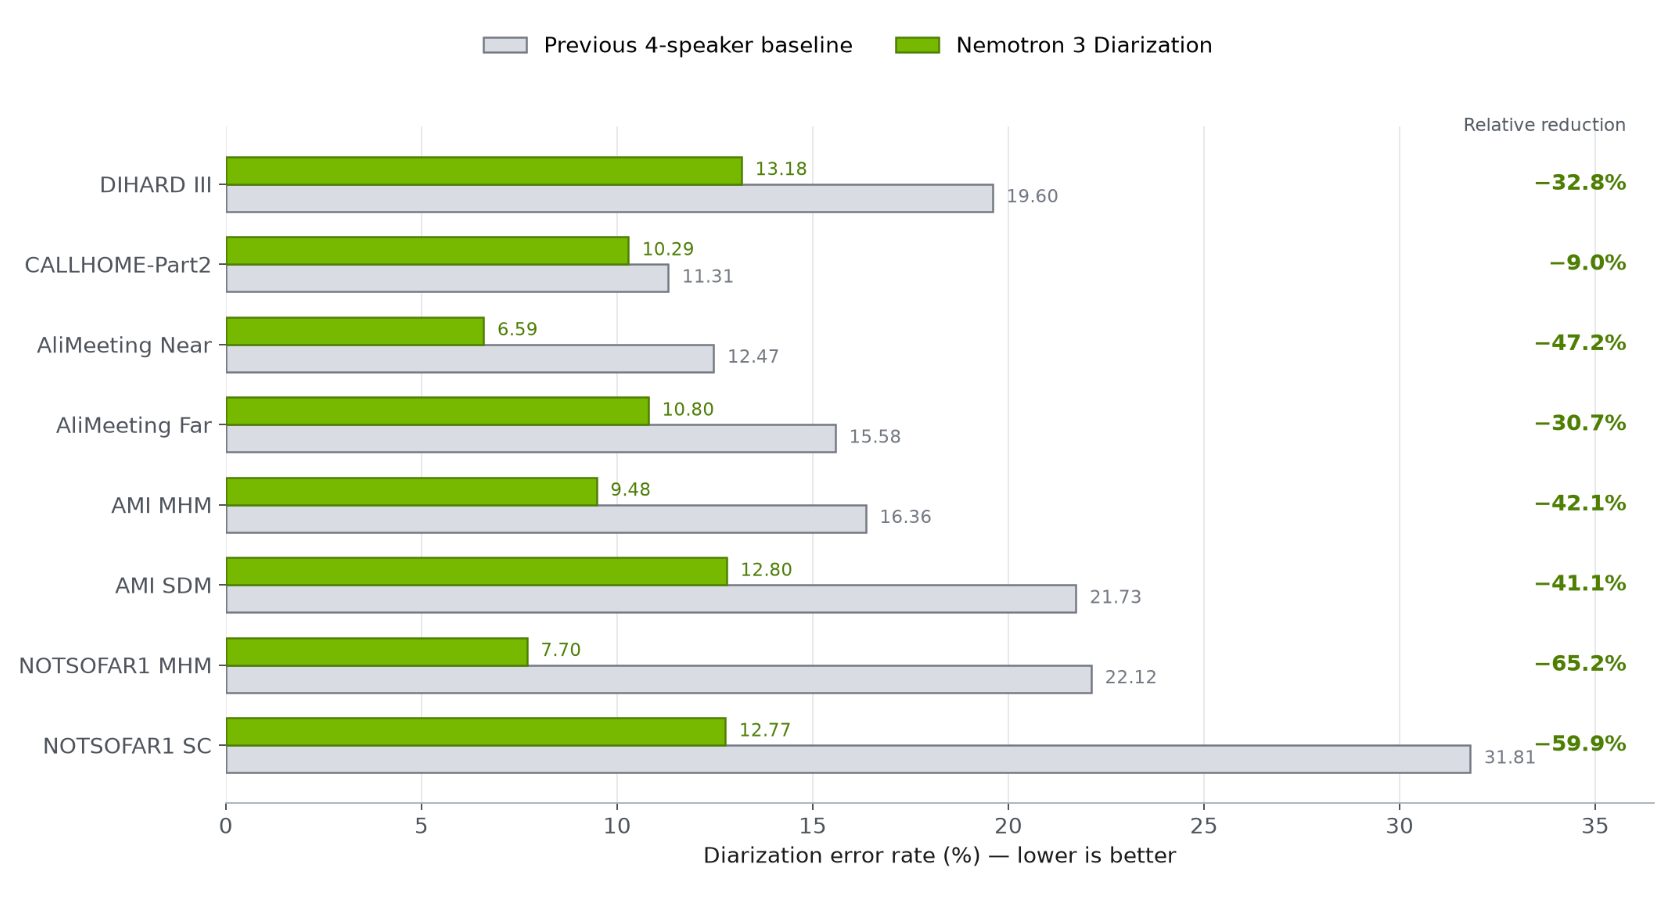
NVIDIA 另外比較自家前一代最多 4 位說話者的 Sortformer,在 8 個資料集、1.04 秒輸入緩衝下,新模型的 DER 相對改善平均為 41%。這是把各資料集的相對改善幅度取平均,不是把所有音檔合併後得出的整體分數。兩種測試口徑不同,不應把 41% 和 VoiceArena 的第一名混成同一項成績。
還有一個重要細節:在 CALLHOME 的雙人子集、30.4 秒設定下,新模型 DER 是 5.98%,前一代則是 5.68%。它並非每種人數和情境都領先。整體測試和較多人數子集的改善仍有參考價值,但正式導入前,最好拿自己的會議、電話和麥克風環境試跑。
權重已上架 Hugging Face,但不是一鍵式線上轉錄服務
NVIDIA 已將模型權重放上 Hugging Face 官方模型頁。模型權重是訓練完成、供模型執行的數值檔。模型卡標示採 OpenMDW-1.1 授權,允許依授權條款用於商業或非商業用途。開放權重的好處是團隊可自行下載、部署和整合,也能接到雲端 API。API(應用程式介面)是讓兩套軟體交換請求與結果的通道。雲端代管則是由服務商替使用者執行模型,使用者不用自行管理伺服器或 GPU。
但「上架 Hugging Face」不代表一般使用者上傳錄音就能直接拿到完整逐字稿。Hugging Face 模型頁目前未列出代管推論服務。自行運行需要安裝相容的模型工具與運算環境。模型卡提供 NeMo 和 Transformers 使用方式,並列出多代 NVIDIA GPU(圖形處理器,也常用作 AI 運算晶片)與 Linux 作業環境的支援資訊。
對團隊來說,授權只是第一步。還要確認錄音是否能用於模型處理、是否需去除個資、部署硬體費用,以及 ASR 與說話者分段結果如何互相校正。尤其會議錄音含有員工或客戶聲音。模型能標記發言,不代表可以跳過告知、保存期限和存取權限的規劃。
哪些產品會用到它?先把逐字稿「對回發言者」
Nemotron 3 Diarization 適合評估的情境包括多人會議紀錄、播客剪輯、客服通話分析和語音助理。假設逐字稿中有人說「週五前我會寄出報告」,系統若能保留說話者與時間,後續摘要才比較有機會把承諾交給正確的人。
但 speaker 標籤仍是模型判斷,不是身分驗證。會議中途有人加入、換麥克風、背景聲混入,或兩人同時說話,都可能讓片段歸屬出錯。越是會影響績效、客訴處理或法律紀錄的用途,越需要抽樣人工覆核,不能把模型標籤當成已證實的身分。
我對這次發布的看法是:最值得關注的是「最多 8 位」與重疊語音處理,因為它們直接補上多人會議逐字稿最常缺的一層資訊。100M 參數和 0.32 秒緩衝則是規格,不等於產品已經達到即時、低成本或免校對。對多數團隊來說,它是值得拿自有錄音驗證的基礎元件,不是拿來取代整套會議轉錄服務的成品。
Nemotron 3 Diarization 常見問題
Nemotron 3 Diarization 會幫我把錄音轉成文字嗎?
不會。它標記每位說話者何時發聲,文字內容要由 ASR 語音辨識模型產生。兩者合併後,才可建立帶有說話者標籤的逐字稿。
它可以辨識每個人的真實姓名嗎?
不行。模型輸出 speaker_0、speaker_1 等匿名標籤。若要對應姓名,需要另外使用會議名單、登入資訊或經本人同意的身分驗證機制。
Nemotron 3 Diarization 支援中文嗎?
NVIDIA 模型卡列有普通話訓練和評測資料,但 VoiceArena 排名所用的 139 段對話是英文。這不能直接證明它對台灣口音、台語或每種多人會議都同樣準確,正式使用前應用自己的音檔驗證。
Nemotron 3 Diarization 可以商用嗎?
模型卡標示可依 OpenMDW-1.1 授權用於商業或非商業情境。實際使用前仍應閱讀完整授權條款,並另外處理音訊資料的同意、隱私和保存規範。
結論:它補上「誰說了什麼」的一半,產品成敗仍看整條流程
Nemotron 3 Diarization 把可追蹤人數提高到 8 位,並支援重疊發言和串流處理,讓會議逐字稿更有機會保留討論脈絡。NVIDIA 公布的基準成績值得留意,但測試條件有限,不能代替真實產品驗證。
真正的產品價值要看完整流程:說話者標籤是否穩定、ASR 文字是否正確、延遲是否符合使用情境,以及資料治理是否到位。若你的團隊有大量多人錄音,這個開放權重模型值得列入評估。如果只是想要開箱即用的逐字稿服務,還需要再找能整合 ASR、說話者標記與資料管理的完整工具。