NVIDIA Nemotron 公佈競賽成果:IOI 與 IMO 達金牌門檻,專家模型如何做出答案?
NVIDIA 整理 Nemotron 專家系統在 IOI、IMO 2026 達金牌分數門檻的成果。本文深入解讀非正式競賽測試與官方評分的差別、SFT 與 RL、GenCorrect 回饋修訂、運算門檻、開放材料及企業應用仍需的驗證。

AI 解出一道難題,與穩定完成整場競賽,是不同的能力證據。程式題要通過看不到的測試,數學題要交出能被逐步檢查的證明。NVIDIA 最新整理的 Nemotron 成果之所以值得看,是它把專門訓練、候選答案生成、檢查與修訂放在同一套流程中,展示模型能力如何變成可評分的結果。
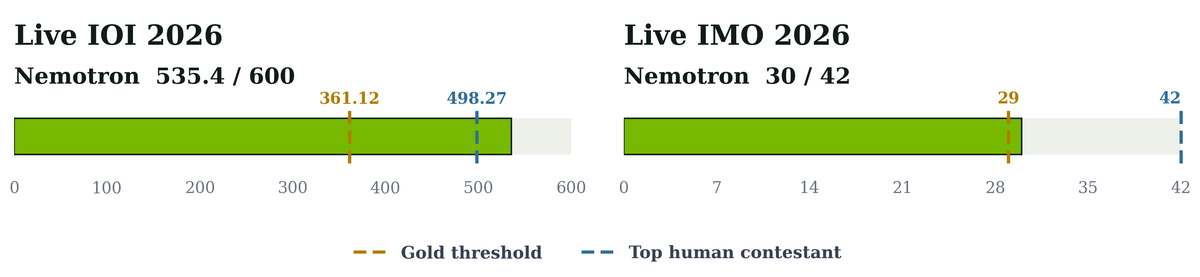
NVIDIA 在 2026 年 10 月 7 日於 Hugging Face 發表官方成果文章,介紹以 Nemotron 3 為基礎的程式與數學專家系統。公司報告 IOI 2026 得分 535.4/600,IMO 2026 得分 30/42,都高於相應金牌門檻。兩個結果的評分與參與方式不同,需要分開解讀。
IOI 是依競賽限制進行的非正式、無監督即時評測,沒有列入官方排名。IMO 提交的證明則由官方評分者評閱。因此,這則新聞支持的是專家系統達到高水準解題表現,不能寫成 NVIDIA 正式拿到兩面競賽金牌,也不能直接當成一般聊天或企業開發任務的成功率。
兩種競賽,要求模型交出不同形式的證據
國際資訊奧林匹亞 IOI 的程式題,要求解法兼顧正確性與效率。程式在示範輸入上輸出正確,不代表它能通過所有隱藏測試。限制也可能涉及時間、記憶體與提交次數。模型需要理解題目結構,選出合適演算法,再把想法轉成能執行的程式。
國際數學奧林匹亞 IMO 則要求完整論證。算出某個數值、提出看似合理的猜想,都不能代替證明。評分者會檢查每個關鍵推導是否成立,缺少必要條件便可能失分。因此,數學模型的品質要看它能不能找出論證缺口,而不只是產生漂亮且熟悉的數學文字。
NVIDIA 報告的 IOI 分數高於當年金牌門檻 361.12,也高於最高人類選手分數 498.27。這是公司公佈的特定系統評測結果,並非官方參賽名次。IMO 的 30 分則高於當年 29 分的金牌門檻,六題中四題拿到滿分,成績來源是官方評分者對提交證明的判讀。
這些分數能證明系統在指定題目與條件下處理高難度任務的能力。它們無法單獨證明 AI 在所有思考活動都超越人類。競賽問題、工具條件、候選數量與運算投入都有特定安排。合理的讀法,是先了解取得分數的方法,再判斷哪些做法可能移植到自己的工作。
新聞焦點是整套專門化方法,並非所有模型剛剛推出
這次文章把程式與數學成果並列,強調同一家族的基礎能力能適應不同領域。它沒有表示所有相關權重都在十月七日首次開放。程式專家模型的官方模型卡列出九月三日的發布日期,讀者若要下載或研究,應以個別模型頁的版本與條款為準。
所謂專門化,是在既有基礎模型上增加領域訓練。監督式微調,英文縮寫 SFT,讓模型從挑選過的解題範例學習;強化學習,縮寫 RL,則利用評分回饋調整輸出傾向。兩者都需要明確的資料與目標,並非只在提示裡寫上「你是專家」就完成。
NVIDIA 的整理指出,方法包括挑選領域問題、準備高品質推理資料、進行後訓練,再加入生成、評估與改善的推論迴圈。這裡的推論指模型被使用來產生答案的階段。訓練讓模型有較好的起點,使用時的檢查與修訂則讓系統有機會把初稿變成較可靠的提交。
這種設計的企業意義,是能力建置可以按任務拆開。一家需要處理特定資料或程式問題的組織,可以先檢查基礎模型在哪些地方不足,再決定要補訓練資料、驗證工具或修訂流程。競賽成果提供參考方向,真正的選擇仍要回到自己的錯誤類型與預算。
程式成果顯示,微調與使用時的檢查各有貢獻
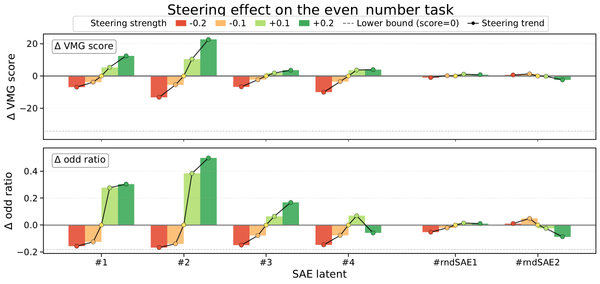
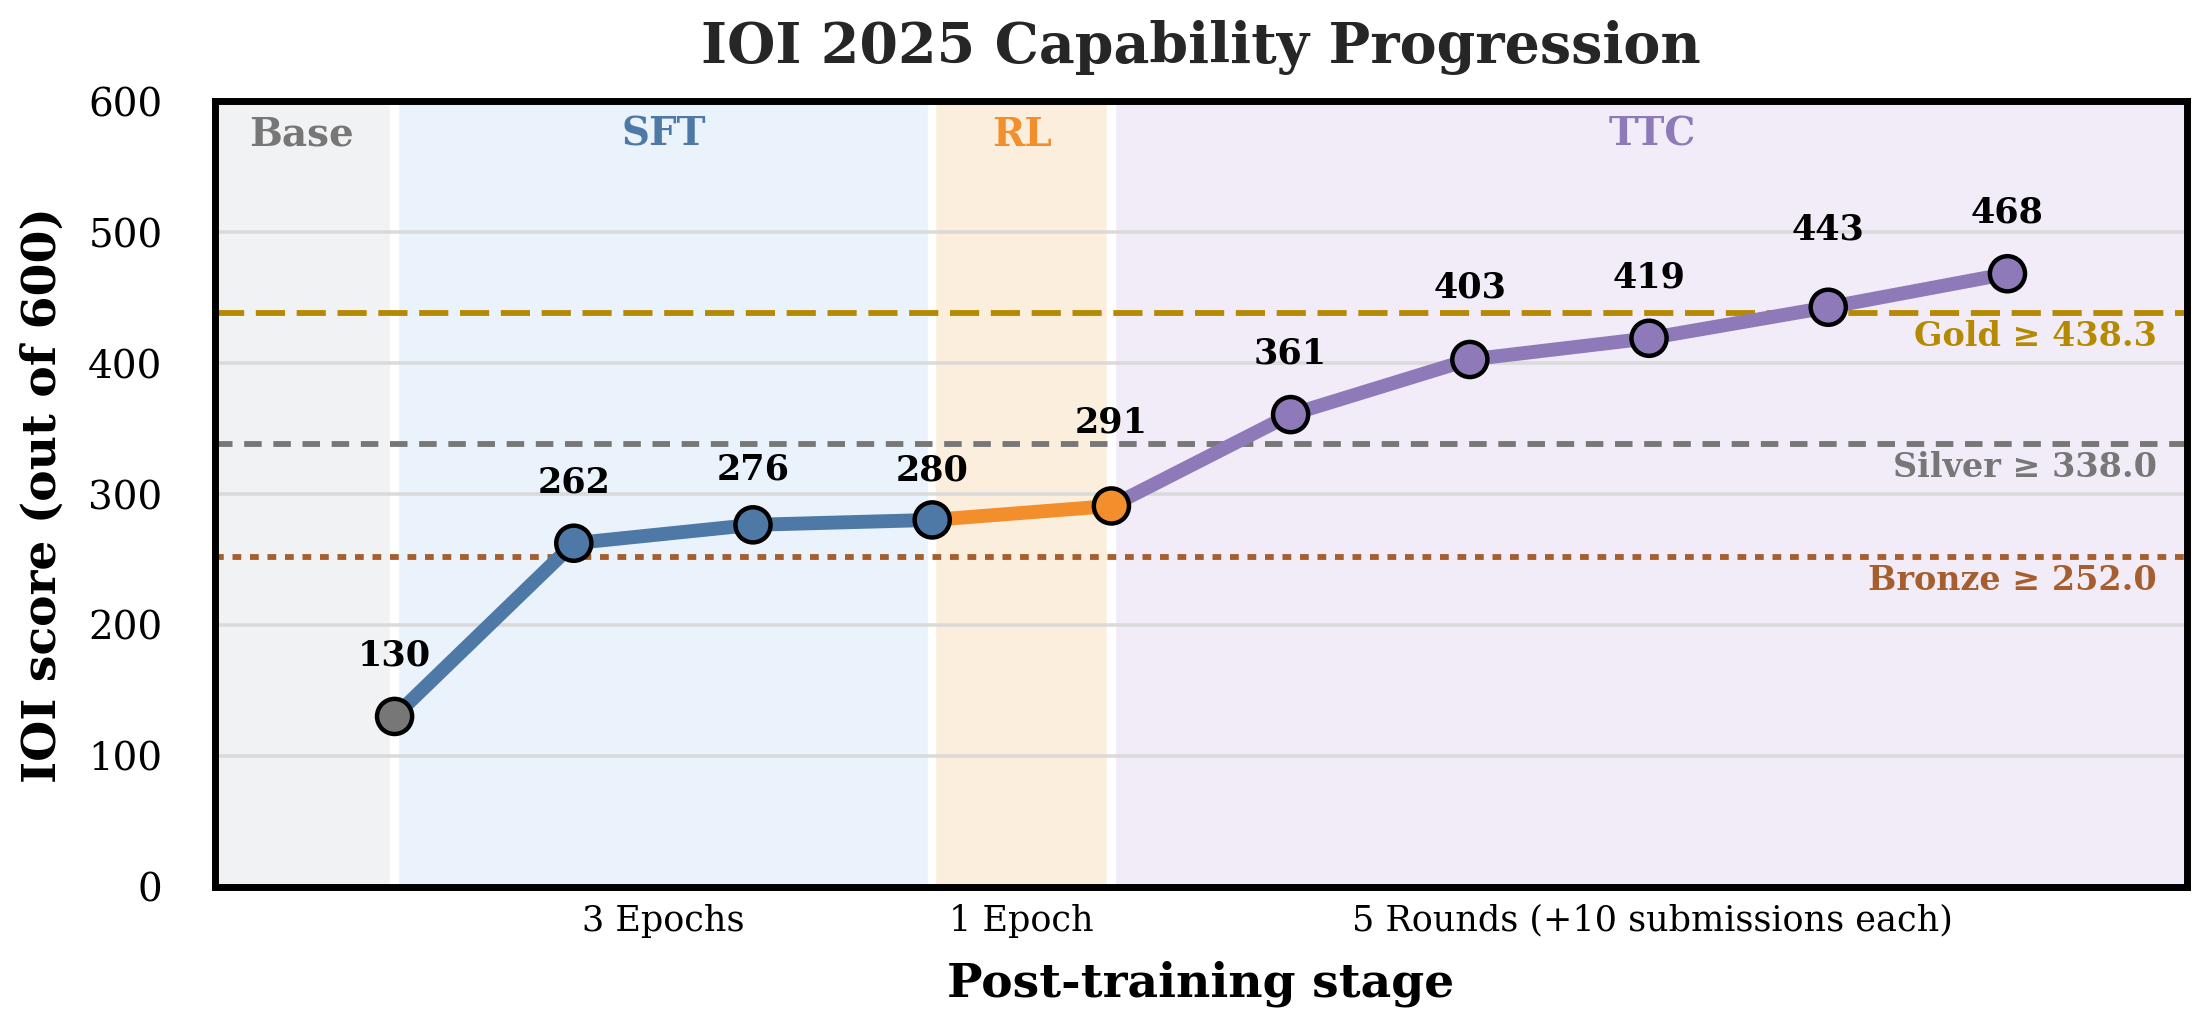
官方以 IOI 2025 開發評測說明進展。Nano 的分數從後訓練前約 130 分,經 SFT 提升到 280 分,RL 再提升到 291 分。加入 GenCorrect 後達到 468 分,高於該年 438.3 的金牌門檻。Ultra 程式專家配合同類策略則達到 502 分。
這張圖的不同階段不能只用一個總提升比例概括。SFT 改變模型本身,RL 加入另一段訓練,GenCorrect 則在使用時投入多輪候選與回饋。若把最後分數當成模型一次作答的能力,就會忽略系統為挑選和修正答案所做的工作,也難以比較自己的使用成本。
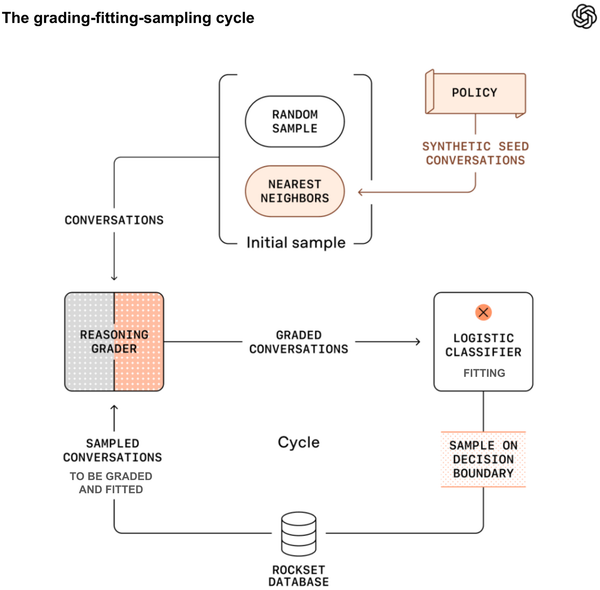
GenCorrect 可以理解成讓模型產生不同解法、挑選候選、取得評估回饋,再修訂下一輪。程式競賽有可執行測試與子任務分數,能提供較具體的回饋。它的價值在於利用錯誤訊息改進答案,而非只是讓模型重複回答相同問題,最後挑一個語氣最有信心的版本。
對企業開發者而言,這個思路可以延伸到可驗證的程式任務。例如為某個函式補齊邊界條件,再讓測試檢查修訂是否有效。這是本文的應用分析,並非官方在企業產品上公佈的測試。移植時需要保留有意義的測試,否則代理可能改善測試畫面,卻沒有真正修正需求。
程式專家模型很大,開放權重仍有實際運算門檻
官方程式模型卡說明,Ultra 專家以 550B 總參數、55B 活躍參數的基礎架構為起點。活躍參數較少,代表一次計算只使用部分專家,但完整模型仍需要儲存與部署資源。讀者不能把 55B 當成整份權重只有那麼大,也不能推論普通筆電就能重現競賽系統。
模型卡列出的 SFT 訓練使用一輪訓練、約四十七萬筆合成推理軌跡,來自約兩萬兩千道程式問題。訓練配置使用 128 顆 GB300 GPU,部署範例也使用多顆高階 GPU。這些是官方配置,本文沒有租用硬體重跑,不能把它們寫成已測得的最低成本方案。
即時競賽推論另採用量化。量化把部分數值精度降低,以提高執行效率,可能同時改變單次答案品質。官方模型卡比較了量化與未量化配置的速度及分數取捨,說明提高吞吐量是為了在固定競賽時間內產生較多候選,而不只是追求單次回答更快。
因此,評估部署時應同時記錄每題候選數、總等待時間與整體費用。若某個模型一次答案略差,卻能在相同時間裡產生更多可檢查候選,系統最後可能更好;若任務缺少有效驗證,多產生答案也可能只增加審核負擔。速度的價值需要與工作流程一起衡量。
IMO 系統把證明、批評與修訂一起訓練
數學專案也從 Nemotron 3 Ultra 開始,分別訓練 SFT 與 RL 專家。官方整理的 SFT 資料涵蓋證明生成、修訂、驗證與再驗證,共有 414,890 筆經品質篩選的例子,涉及 15,818 道不同證明題。重點在於多種角色都有訓練範例,而非只記住最終答案。
RL 模型使用 9,597 道靠近模型能力邊界的證明題。這個邊界指的是難度接近模型目前能處理的範圍,讓回饋有機會推動進步。它不能當成所有題目都同樣適合的通用門檻,也沒有說明企業隨意蒐集同樣數量的題目,就能取得相同效果。
在開發實驗中,SFT 專家於第一輪搜尋較強,RL 專家則有較好的整體單一檢查點結果。最終系統同時使用兩個專家與一般模型,讓它們產生候選證明、評分、提出批評並修訂,再以另外一個高運算量階段選出最終提交。這份成績應歸給整套系統。
官方說明,IMO 流程以自然語言工作,沒有使用形式化證明器、外部工具或網路。形式化證明器指依嚴格邏輯規則機械檢查推導的系統。自然語言方案的成果因此需要回到評分者對證明的評閱,不能把它寫成每一步都已獲機械驗證的數學保證。
自我檢查為什麼有用,又為什麼不能只信自我評分?
一個擅長產生答案的模型,可能仍會漏看自己的錯誤。若檢查模型與生成模型受到相同資料或推理盲點影響,它們也可能共同認可一份有問題的證明。多個版本的互補性有價值,但「多個模型同意」與「答案正確」之間,仍需要一個能獨立檢查的依據。
程式題可以執行測試,數學題可以由評分者審閱,兩種回饋的形式不同。企業若要借用這個方法,也要先問自己的任務有沒有可用的驗證信號。資料欄位能否與原檔比對、程式能否通過有效測試、推論前提能否回到來源,會影響迴圈是否真正改善品質。
假設公司要整理合約欄位,可以讓一個流程先抽取,再由另一個流程回到原文逐項查核。這個例子僅說明資料抽取與核對的分工,尚未用 Nemotron 實測。若第二輪只看第一輪摘要,沒有原文,它得到的只是重複確認,與官方強調的回饋改善仍有距離。
修訂次數也需要停止條件。可以記錄每輪新增了哪些有效修正、仍有哪些未解問題,以及等待時間是否值得。當多輪只是改寫語氣,沒有提高可驗證成果,繼續加算力未必有用。競賽成果最值得學習的,是讓回饋能改變候選品質,而非無限制延長推理。
開放資料與方法,讓別人更容易檢查主張
NVIDIA 提供相關模型、訓練資料集合、論文及 NeMo-Skills 工作流。IMO 集合也包含兩種專家檢查點、資料集及兩百題的 Nemotron-IMO-Bench。這些材料讓研究者有機會檢查怎麼準備問題、怎麼評分與怎麼挑答案,比只發布一張成績圖更有研究價值。
不過,公開方法與下載權重,不等於使用者已重現結果。版本、提示、工具、候選數與硬體配置都可能影響表現。需要可重現性的團隊,應保存完整設定與輸出,不要只把模型名稱寫在報表上。模型相同、系統不同,也可能有很不同的答案品質與費用。
程式模型卡標示採用 OpenMDW 1.1 條款,並列出商業與非商業用途。若實際部署,仍應閱讀該版本的正式條款與相關資料條件。模型的使用條款與新聞圖表、品牌素材的權利是不同範圍,不能因為模型可下載,就推論所有附帶材料都沒有使用限制。
模型卡也明確把程式專家定位在競賽程式、推理研究與評測,與一般聊天或直接部署成完整生產開發助理的用途有區別。這個定位應影響導入順序:先以自己的代表性任務驗證,再考慮是否值得整合,而非把高競賽分數直接轉成企業全面採用決定。
常見問題:這次結果對一般使用者有什麼意義?
它是否代表 AI 已正式贏得 IOI 與 IMO 金牌?這次報告用金牌門檻描述成績水準。IOI 測試不在官方排名,IMO 則有官方評分者評閱證明,兩者不能合成正式雙金牌得獎敘述。讀者應保留不同的參與與評分條件,才不會把能力證據說得超過事實。
下載模型後是否能立即得到相同答案?最高成績來自專家模型與多輪搜尋、驗證、修訂共同運作。只有權重、沒有相同流程與預算,不足以支持同等表現。即使完整重現研究設定,也仍需觀察不同題目與重複執行的變化,才能判斷穩定性。
是不是模型越大、多抽幾次就一定比較好?官方成果顯示,領域資料、訓練方式與回饋策略都有貢獻。不同專家在不同搜尋階段各有優勢。較大的模型與更多候選只是部分條件,若缺乏有效評估,系統可能產生更多看似合理卻不合格的答案。
這則新聞的長期意義,是解題能力正在走向可組合的工作流。基礎模型提供起點,專門訓練改善候選,回饋與修訂決定最終成果。一般使用者可以先借用這個分工:把初稿、檢查與完成條件分清楚,再用真正可核對的結果,判斷 AI 是否替自己省下工作。
資料來源
- NVIDIA:One Model Family, Two Gold-Level Results,2026 年 10 月 7 日。成績、評分範圍與兩項專案的整理以此為準。
- NVIDIA 程式專家模型卡,部署、發布日期、訓練與用途限制。
- NVIDIA NeMo-Skills 與 IMO 2026 集合。本文採用官方成績與發展圖,未重跑訓練、競賽或硬體評測。