不再只是生成短片!Odyssey 發表 Odyssey-3 基礎世界模型:20 小時模擬數據攻克印度街頭自駕、聯手 Flexion 顛覆人形機器人,具身智能迎來「物理基礎大腦」革命
Odyssey 正式發表新一代基礎世界模型 Odyssey-3!透過自回歸擴散 Transformer 與解耦動作解碼器,僅憑 20 小時模擬數據攻克印度混亂街頭自駕,更聯手 Flexion 顛覆人形機器人全身控制。深度剖析底層架構、Sim-to-Real 突破與 AI 練 AI 閉環。
「傳統視訊生成模型的終點是欺騙人類的雙眼,但世界模型(World Model)的起點是理解並模擬物理因果。當一個神經網路能在僅憑 20 小時的模擬想像下,於印度最混亂無序的街道上自如穿梭,並能以同一套大腦指揮雙足人形機器人完成精細操作——我們終於看見了實體物理世界專屬的『GPT-3 時刻』。」——矽谷具身智能資深研究員
2026 年 9 月 15 日,全球人工智慧與具身智能(Embodied AI)賽道迎來了一次具里程碑意義的技術衝擊。
由自動駕駛傳奇先驅、前 Cruise 產品副總裁 Oliver Cameron 與前 Wayve 技術副總裁 Jeff Hawke 共同創立的物理 AI 實驗室 Odyssey(@odysseyml),正式向全球揭曉了其研發已久的重量級旗艦成果——Odyssey-3 基礎世界模型(Foundation World Model)。
在官方公布的研究預覽與實測影片中,Odyssey 展現了顛覆傳統機器人學習典範的兩大震撼成果:
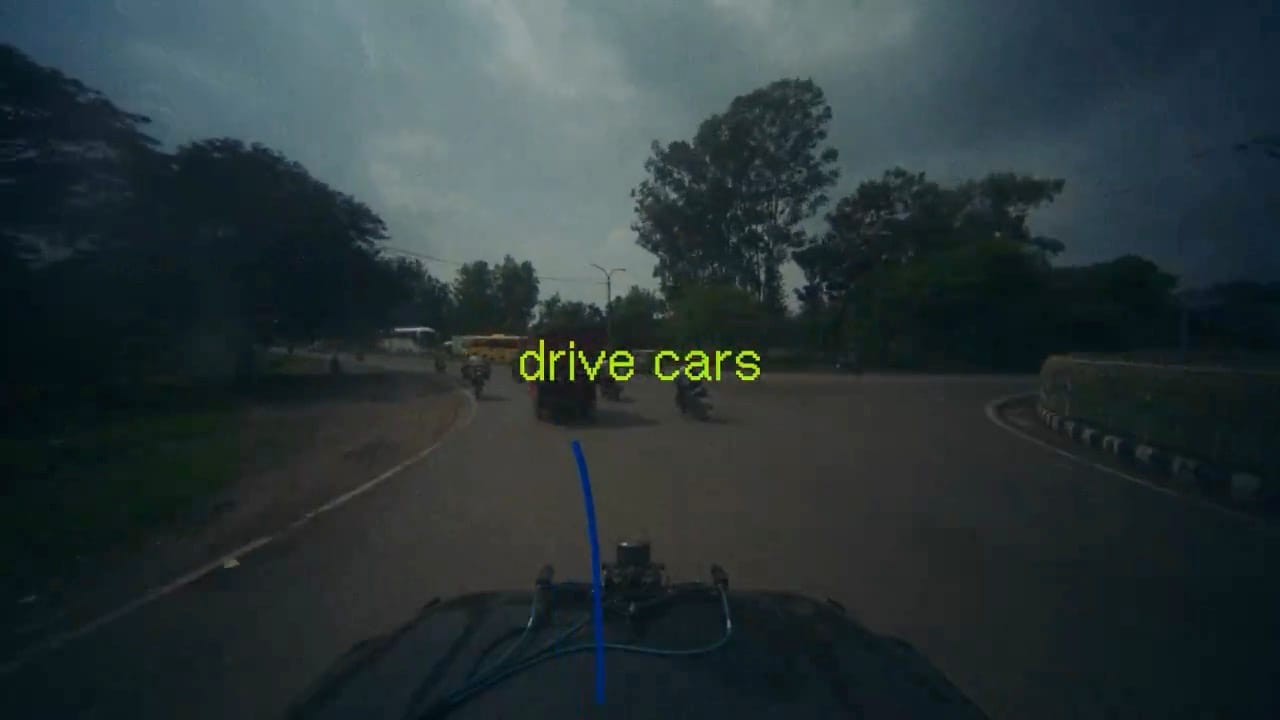
- 極限自駕測試:僅憑藉 20 小時的純模擬駕駛數據(Simulated Data),Odyssey-3 就能在交通路況極度複雜、非結構化且突發狀況層出不窮的印度真實城市街道上,完成閉環自主駕駛,其實路干預表現甚至達到了真實路測影片訓練模型的 77%!
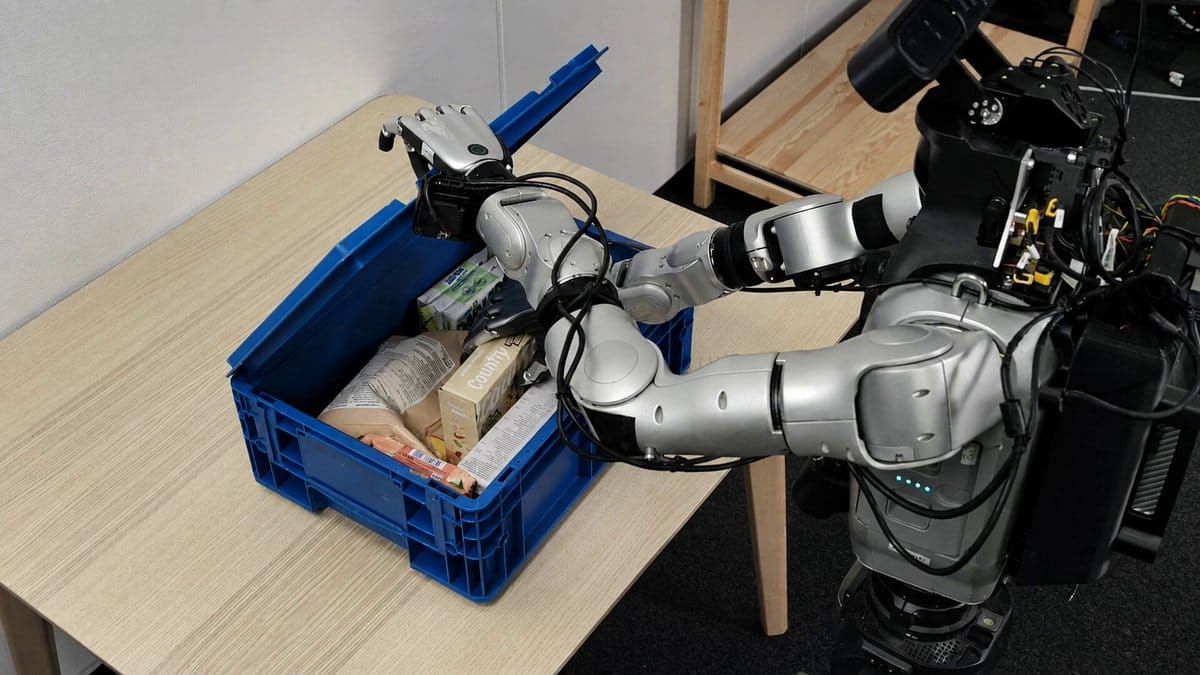
- 頂級人形機器人協同:與全球頂尖機器人控制先鋒 Flexion 展開深度研究合作,利用 Odyssey-3 作為物理基座,僅需「數十小時」示教數據即建構出人形機器人的全身動態協同策略,在強光驟變、雜亂無序的非結構化環境中,展現出遠超現有 Vision-Language-Action(VLA)模型的超強零樣本魯棒性。
這項發表迅速在社群平台 X 上引爆巨量轉發與討論。長期以來,業界對於「世界模型」的認知大多停留在 Runway、Sora 等視訊生成工具的畫面擬真度上,然而 Odyssey-3 用最無可辯駁的實體交互數據向產學界宣告:世界模型不是用來「看」的,而是用來給實體 AI 賦予「物理直覺與因果推演能力」的底層大腦。
▲ Odyssey-3 官方展示實測影片:涵蓋印度街頭自駕、Flexion 人形機器人雙手協同、多自由度機械臂操作與物理世界模擬。(影片來源:Odyssey 官方發布實測)
快速重點摘要(TL;DR)
- 基礎世界模型的正式定名:Odyssey 於 2026 年 9 月 15 日正式發表 Odyssey-3,不再侷限於單一任務或單一機器人本體,而是定位為可跨載體適配的「通用物理智能(General-Purpose Physical Intelligence)」大腦基座。
- 核心架構創新——解耦式動作解碼器:底層採用自回歸擴散 Transformer(Autoregressive Diffusion Transformer),在大規模多樣化真實視訊中預訓練空間幾何、牛頓力學與因果律。在面對不同硬體載體時,龐大的世界模型主幹保持完全凍結(Frozen),僅需掛載輕量級的動作解碼器(Action Decoder),徹底終結「換一台機器人就得重訓千億參數模型」的成本惡夢。
- 20 小時模擬數據征服印度街道:在被公認為全球自動駕駛「地獄級難度」的印度城市混亂路況下,Odyssey-3 僅使用 20 小時純模擬數據即訓練出具備閉環控制能力的自駕策略,實路平均干預里程(MPI)高達真實數據訓練模型的 77%,極大幅度跨越了困擾學界數十年的 Sim-to-Real 鴻溝。
- 聯手 Flexion 突破人形機器人瓶頸:機器人控制公司 Flexion 以 Odyssey-3 為基座開發人形機器人全身策略,在開箱、搬運及桌面精細擺放任務中,面對極端光影變化與突發干擾,展現出輾壓傳統端到端 VLA 大模型的抗干擾與即時決策能力。
- 真正的「AI 練 AI」遞歸學習閉環:Odyssey-3 具備可微、即時、具有物理保真度的動態狀態生成能力,不僅能輸出控制信號,更能作為「無限生成、無限互動的物理沙盒」,讓其他 AI 智能體在虛擬世界中以數千倍速自我碰撞演化,從根源化解具身智能「真實數據採集高昂且危險」的數據荒漠。
- 全明星資本與圖靈獎級陣容:Odyssey 甫於 2026 年 6 月完成 3.1 億美元 B 輪融資,估值達 14.5 億美元。投資陣容包括 GV(Google Ventures)、Amazon、NVIDIA、AMD Ventures 等巨頭;董事會坐鎮皮克斯共同創辦人 Ed Catmull,顧問名單更赫見 Google 首席科學家 Jeff Dean 與 PyTorch 之父 Soumith Chintala。
- 即將展開公測:Odyssey-3 目前處於研究預覽階段,官方已承諾將在未來數週內釋出第一批公測 API 與技術報告。
為什麼說 Sora 是「畫家」,而 Odyssey-3 才是「物理心智」?
在探討 Odyssey-3 的硬核技術架構前,我們必須先釐清一個長年充斥於 AI 產業的行銷迷思:究竟什麼才算真正的「世界模型(World Model)」?
自 2024 年 OpenAI 發表 Sora 以來,幾乎所有視訊生成新創都紛紛在新聞稿中將自己標註為「世界模擬器」。然而,當深入工程與機器人底層時,工程師們很快就會發現殘酷的真相:大部分所謂的世界模型,本質上只是高階的「神經渲染器(Neural Renderer)」。
| 評估維度 | 傳統視訊生成模型(如 Sora / Gen-3) | 基礎物理世界模型(Odyssey-3) |
|---|---|---|
| 終端輸出目標 | 2D 像素矩陣(以欺騙人類視覺為目的) | 潛在物理狀態、3D 幾何因果與控制信號 |
| 交互時間模式 | 離線非即時(算完 5-10 秒影片才給看) | 即時連續串流(逐幀推進,毫秒級響應) |
| 物理定律一致性 | 統計關聯(物體常憑空消失、手指變形) | 因果約束(遵循動量守恆、碰撞、摩擦) |
| 動作因果閉環 | 無閉環(無法接收外部手柄/馬達反饋) | 完整閉環(輸入 Action -> 輸出新狀態) |
| 下游應用場景 | 影視分鏡、短影音廣告、視覺特效 | 自駕車、人形機器人、無人機、AI 訓練 |
1. 像素統計 vs 物理狀態
人類觀看影片時,大腦會自動利用心理學中的「格式塔效應」修補畫面邏輯;哪怕影片中桌子上的茶杯在旋轉後稍微變形,或是貓咪的影子角度稍微偏差,觀眾也不一定會察覺。
然而,對於一輛以時速 60 公里前進的自動駕駛車,或是手握昂貴玻璃杯的人形機器人而言,「稍微偏差」就意味著致命的災難。機器人不能依賴「看起來很像」的像素,它必須精確掌握:
- 前方障礙物的精確 3D 空間坐標與體積包圍盒(Bounding Box);
- 地面摩擦係數、輪胎抓地力極限、煞車時的重心前傾量;
- 手臂接觸物體時的法向接觸力(Normal Force)與反作用力動態。
傳統視訊擴散模型是純粹的「視覺畫家」,它在像素空間中玩弄機率分佈;而 Odyssey-3 則是「物理引擎+心智」,它推演的是一個具有內在連貫幾何、剛體拓撲與時間因果的潛在空間(Latent State Space)。
2. 從單向生成到雙向可微交互
Runway 在 2026 年 9 月初推出的 GWM Worlds 2,證明了神經網路可以接收文字提示(WorldPrompt)並以串流渲染虛擬場景,朝世界模型邁出了重要一步。但 GWM Worlds 2 的主要對象仍然是「人類玩家與相機導航」。
Odyssey-3 的野心更進一步——它是為「實體具身(Embodied Agents)」量身打造的。它不僅能輸出未來的視覺觀察,還能直接與機器人的執行器(Actuators)、馬達編碼器和傳感器進行即時閉環通訊。這正是具身智能領域夢寐以求的統一架構。
深度拆解:Odyssey-3 的核心神經架構
Odyssey 團隊之所以能用同一套模型跨越「自動駕駛」與「人形機器人」這兩個過去被視為完全不同專業的領域,關鍵在於其精妙的分層解耦架構。
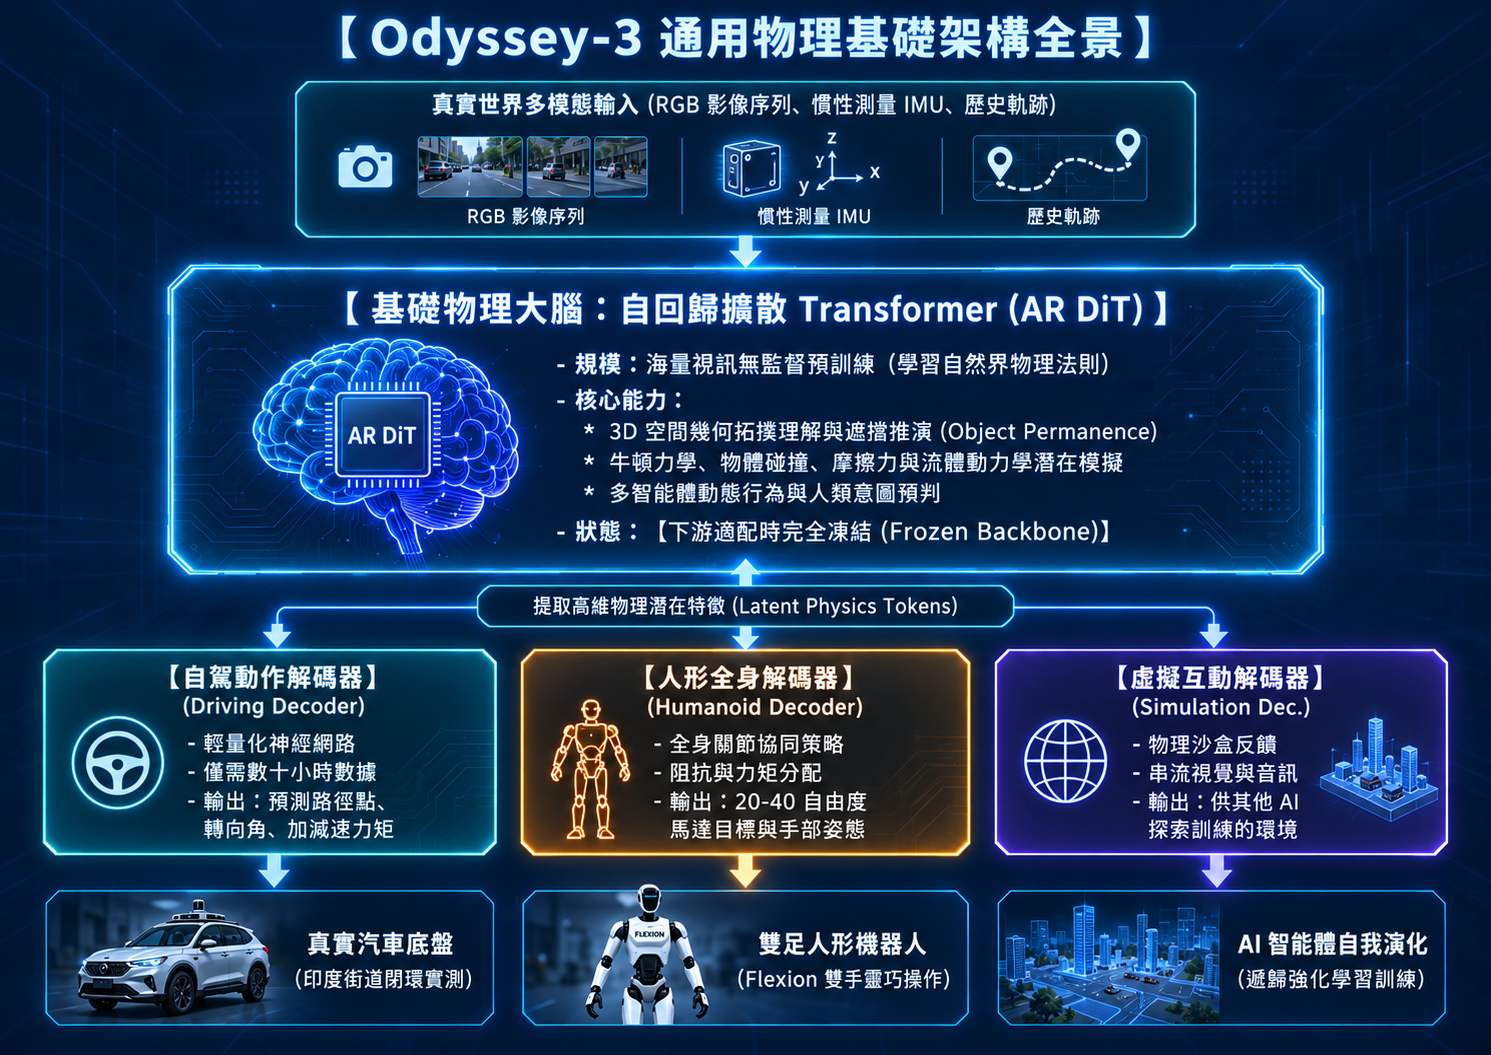
1. 自回歸擴散 Transformer(Autoregressive Diffusion Transformer)
Odyssey-3 結合了兩大主流架構的精華:
- 自回歸(Autoregressive)特性:賦予模型因果時間感。它將時間視為單向流動的箭頭,能夠根據歷史觀測與當前狀態,嚴格按照時間因果關係推演下一幀的微觀變化,避免了非自回歸模型在長序列推演中常見的「時間邏輯混亂」與「因果倒置」。
- 擴散 Transformer(Diffusion Transformer, DiT):賦予模型捕捉物理世界極度複雜、非線性多模態分佈的能力。不管是雨天路面的動態反光、輪胎打滑時的細微側傾,還是機器人手指觸碰柔軟布料時的表面變形,DiT 都能在潛在空間中透過漸進去噪精準還原。
2. 凍結主幹(Frozen Backbone)與輕量動作解碼器(Action Decoders)
過去具身智能領域的一大死穴是**「硬體碎片化」**。波士頓動力的 Atlas、特斯拉的 Optimus、宇樹的 G1,各家關節數量、馬達扭矩曲線、傳感器視角完全不同;每開發一款機器人,演算法工程師就必須重組數據集、從頭訓練一個大模型,成本高達數百萬美元且難以跨機種遷移。
Odyssey-3 採取了類似大語言模型(LLM)的突破路徑:
- 物理世界的常識是通用的:不管是自駕車看見的行人、機械手臂拿起的扳手,還是人形機器人踢到的箱子,自然界的重力加速度($9.8 , m/s^2$)、動量傳導規律、光學折射幾何都是一致的。因此,Odyssey 將這套「物理常識」封裝在一個龐大的視覺物理主幹中,並在下游適配時進行完全凍結(Frozen)。
- 針對硬體僅訓練動作層(Action Layer):當要讓模型開車時,工程師只需要在主幹後方掛接一個小型的自駕解碼器,讓它學習如何將「前方有坑洞」的潛在世界特徵轉化為方向盤微調角度;當要讓人形機器人收拾桌子時,只需掛接一個機械臂解碼器。
- 數據預算驟降 95%:由於不必重新教模型「什麼是物體、什麼是引力」,適配特定機器人所需的示教數據量,從過往動輒數萬小時,直接斷崖式下降至數十小時(Tens of hours)!
震撼實測一:20 小時模擬數據,攻克印度街頭自駕
在 Odyssey 官方公布的技術驗證中,最令全球自駕業界瞠目結舌的,莫過於其在印度城市道路上的自主駕駛閉環實測。
為什麼是印度?自駕技術的「終極惡夢試煉場」
對於任何研究自動駕駛的工程師而言,美國加州的山景城或鳳凰城簡直是「溫室花園」:那裡有清晰的白色標線、嚴格遵守號誌的駕駛、寬闊的多線道與標準化的路口。Waymo 與 Cruise 能在這些區域實現商業運營,很大程度依賴於高精地圖(HD Map)與結構化道路的預設規則。
然而,印度的城市道路則是自駕規則的完全崩塌之地:
- 極度非結構化:道路標線經常缺失或模糊,車道劃分名存實亡;
- 超高密度混合路權:重型卡車、小轎車、摩托車、嘟嘟車(Auto-rickshaw)、自行車、橫穿馬路的行人,甚至牛群、流浪犬共享同一個路面;
- 不可預測的博弈動態:車輛之間的行車間距往往只有幾公分,會車與切入全靠駕駛之間的微表情與侵略性博弈,傳統基於規則的自駕系統在此類環境中會因「安全邊界過於保守」而陷入永久死鎖(Freeze Robot Problem)。
| 策略類型 | 訓練所需數據量 | 實路表現(MPI 平均干預里程) |
|---|---|---|
| 傳統端到端自駕模型 | 數萬小時真實路測視訊 | 基準線(100%),採集成本極高 |
| 傳統物理模擬器策略 | 數千小時 CARLA 數據 | < 20%(嚴重 Sim-to-Real 崩潰) |
| Odyssey-3 世界模型 | 僅 20 小時模擬數據 | 高達 77%(大幅弭平真實差距) |
20 小時模擬數據的「以假亂真」
Odyssey 團隊並未派遣車隊在印度街頭採集長達數年的高昂真實影像。相反地,他們利用 Odyssey-3 先構建了一個具有高度動態交通流的模擬世界,在這個虛擬沙盒中僅運行了 20 小時的模擬駕駛數據,用於訓練輕量自駕解碼器。
測試結果震驚了業界:
- 即時軌跡生成(Waypoint Generation):車載電腦在印度複雜道路上行駛時,Odyssey-3 透過單眼或多眼視覺連續輸入,即時預測車體前方數十米內的運動航點(Waypoints)。
- 77% 的驚人效率:在真實印度街道的實地測試中,這套完全沒見過幾小時真實印度路況、純靠模擬數據訓練出的大腦,其平均安全干預里程(Miles Per Intervention, MPI),竟然達到了由「海量真實印度道路影片直接監督訓練」模型性能的 77%!
這項數據徹底顛覆了產業界的常識。它證明了 Odyssey-3 在虛擬空間中所建立的物理動力學、交通流博弈與空間幾何,已經逼真且精準到可以直接指導實體車輛在地球上最混亂的街道上生存。
震撼實測二:聯手 Flexion,人形機器人告別 VLA 脆弱神話
如果說自駕車是 Odyssey-3 在「大尺度巨觀環境」下的考驗,那麼與 Flexion 合作的人形機器人項目,則是其在「精細微觀交互」上的極限展示。
VLA 模型的死穴:光線一變,大腦就盲
在 2024–2025 年間,機器人學界最熱門的方向是 VLA(Vision-Language-Action,視覺-語言-動作)大模型,例如 Google DeepMind 的 RT-2 或開源的 OpenVLA。VLA 的想法很直觀:把大語言模型的文字 Token,直接擴充套件出機器人關節角度的 Action Token。
然而,在真實工廠與家庭部署中,工程師們發現 VLA 存在嚴重的**「脆弱性(Brittleness)」**:
- 視覺過擬合:VLA 模型是直接從 2D 像素映射到動作。當陽光穿過窗戶在地板上投下一道刺眼的強光、或是天花板吊燈熄滅了一盞,原本運作良好的機器人抓取動作就會瞬間失誤,因為「特徵像素改變了」。
- 缺乏物理直覺:VLA 本質是統計語言模型的分支,它不知道「箱子有多重」,也不知道「倒水時重心的連續位移」。它只是在模仿人類示教的表面姿勢。
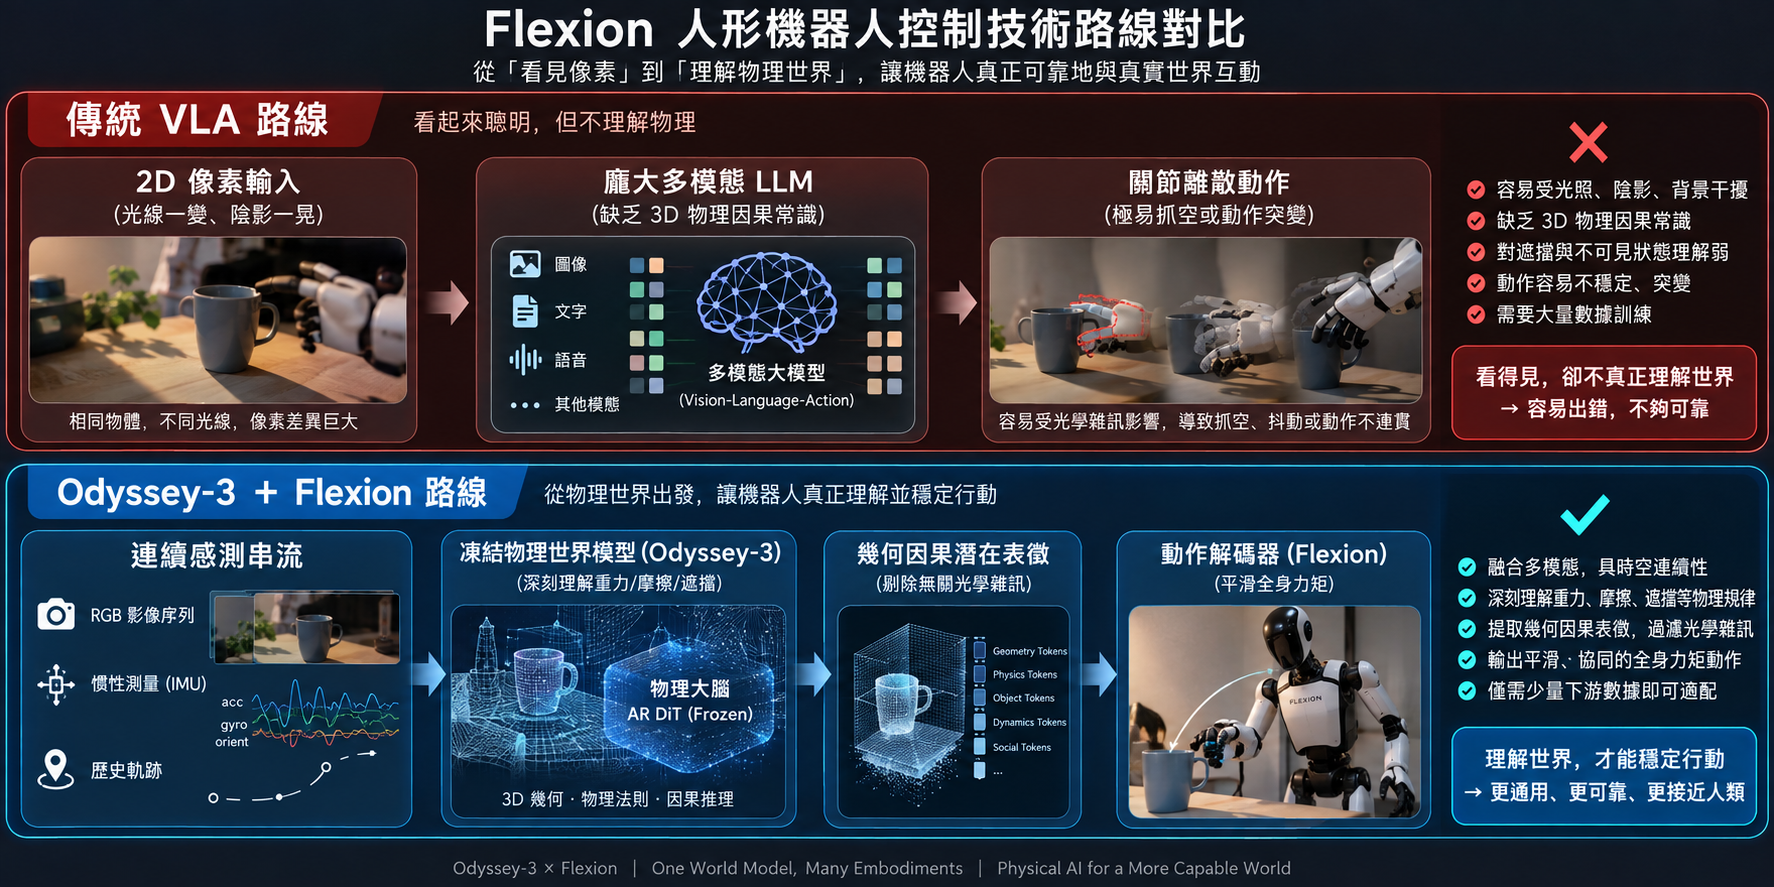
Flexion 的突破:十幾小時示教,解鎖複雜全身協同
Flexion 團隊將 Odyssey-3 作為底層觀察與推演引擎,在其上方掛載了自研的全身動力學動作解碼器(Action Decoder)。
在官方釋出的展示中,人形機器人完成了多項極具挑戰性的長序列精細任務:
- 不規則紙箱雙手搬運:機器人必須即時感知箱子在搬起瞬間的微小形變與重心偏移,動態調整雙臂的夾緊力道與雙腿的平衡補償,防止箱子滑落或本體後仰。
- 桌面餐具精緻佈置與容器開闔:精準辨識叉子、湯匙、餐盤的 3D 姿態,在存在多重物體遮擋的雜亂桌面上完成毫米級操作。
- 極限光照干擾測試:測試人員刻意在機器人作業時切換強聚光燈、製造深色動態陰影。傳統 VLA 模型在該測試中抓取成功率暴跌至 30% 以下,而基於 Odyssey-3 的策略幾乎不受任何光影擾動影響。
為什麼 Odyssey-3 能免疫光影干擾? 因為世界模型在預訓練階段,已經將 2D 像素解耦為「光照渲染層」與「底層 3D 幾何物理實體層」。對於動作解碼器而言,它接收到的是物體真實的空間曲面、碰撞邊界與質量分佈,光影只是表象。這種真正的物理泛化能力,讓人形機器人第一次具備了踏入非結構化家庭與工地環境的底氣。
終極殺招:「AI 練 AI」的合成物理數據飛輪
除了直接控制硬體,Odyssey-3 最具戰略破壞力的價值,在於它能夠建構一個自我閉環的「合成物理世界飛輪(Synthetic Physical Data Flywheel)」。
具身智能的「數據斷崖」
大語言模型之所以能在過去幾年突飛猛進,是因為網際網路上沉澱了全人類數十年累積的數十兆 Token 文字數據。但機器人領域沒有這樣的「免費午餐」。
- 實體機器人採集數據成本高昂,一套高精度的遠端遙操作(Teleoperation)採集台動輒數萬美元;
- 人類示教效率極低,一位熟練技工一天頂多採集幾百次抓取動作;
- 更危險的是,許多極端長尾邊界案例(Corner Cases,如機器人摔倒、撞車、油鍋翻倒)在真實世界中根本無法故意採集,因為代價是昂貴硬體的毀損與人員傷亡。
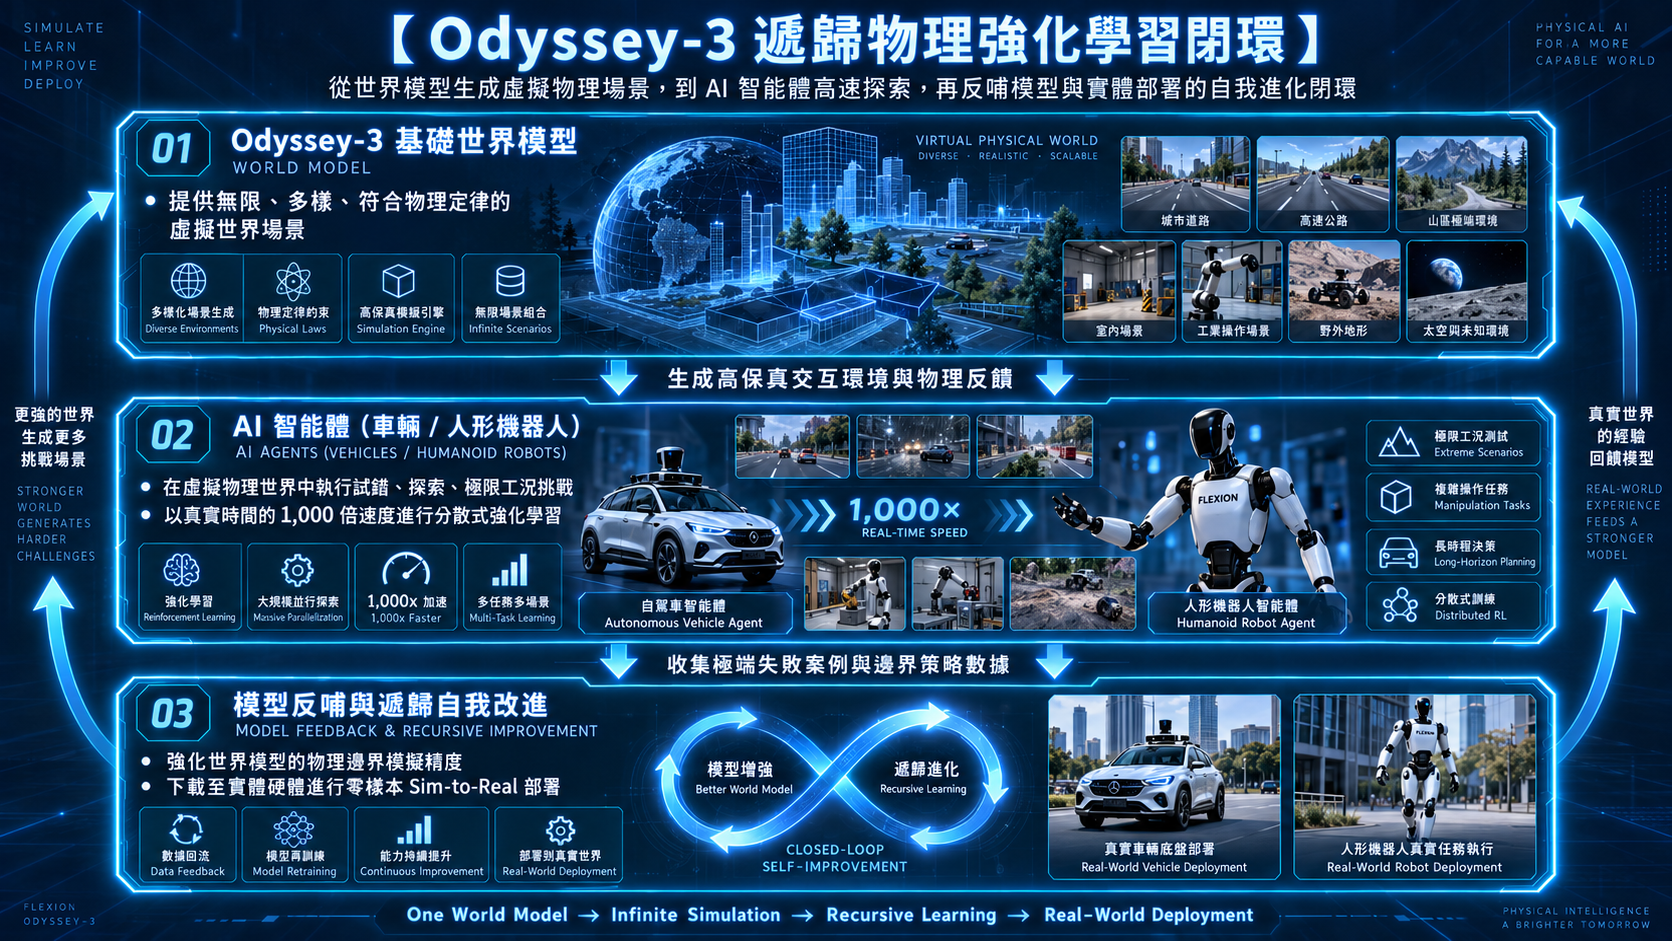
Odyssey-3 扮演了「虛擬母體(The Matrix)」的角色。它不再需要真實攝影機拍攝,而是能根據需求隨機生成無限種具有真實重力、光學與摩擦反饋的複雜場景。
AI 智能體可以在 Odyssey-3 所建立的世界裡:
- 以千倍速狂奔:不受真實世界時間限制,幾小時內累積相當於人類數百年的駕駛與操作經驗;
- 無懼毀滅性試錯:車輛可以隨意撞牆、機器人可以隨意摔落懸崖,系統會在百萬次「粉身碎骨」的模擬失敗中,自動萃取出最強韌的安全避險策略;
- 遞歸進化(Recursive Learning):智能體在虛擬世界中發現的世界漏洞,會反過來成為世界模型的微調數據,讓虛擬世界愈來愈真實,形成真正意義上的技術奇異點閉環。
資本與陣容:為什麼全球晶片巨頭與圖靈獎得主都在押注 Odyssey?
在矽谷當前的 AI 新創版圖中,Odyssey 的融資陣容堪稱近年來具身智能領域最頂級的「豪華全明星艦隊」。
1. 豪華創辦雙雄:Cruise 與 Wayve 的終極合體
- Oliver Cameron(執行長):自駕車領域無人不知的傳奇人物。他於 2017 年創立自動駕駛公司 Voyage,率先在美國高爾夫退休社區成功實現商業化低速自駕運營;2021 年 Voyage 被通用汽車旗下 Cruise 高價收購後,Cameron 出任 Cruise 產品副總裁,深度掌管數百輛 Robotaxi 規模化落地與技術工程。
- Dr. Jeff Hawke(技術長):英國牛津大學 AI 博士,曾任英國端到端自駕明星獨角獸 Wayve 的技術副總裁。Wayve 是全球最早將大型神經網路與世界模型應用於自動駕駛的先驅團隊之一。
這對組合完美融合了**「大模型世界前沿理論(Wayve)」與「真實世界工程與商業化冷酷實戰(Cruise)」**的基因。
2. 圖靈獎坐鎮董事會,Google 與 PyTorch 之父當軍師
- Ed Catmull(董事會成員):皮克斯動畫(Pixar)共同創辦人、圖靈獎得主、電腦圖形學之父。Catmull 的加入極具象徵意義——過去半個世紀,他用演算法為好萊塢創造了無數栩栩如生的虛擬世界;而現在,他正在指導 Odyssey 用神經網路重構真實物理世界的法則。
- Jeff Dean(顧問):Google 首席科學家、Google Brain 奠基人、當代分散式計算與深度學習架構的教父。
- Soumith Chintala(顧問):Meta 傑出工程師、全球 AI 開發者基石 PyTorch 的創造者。
3. 巨頭共投:Amazon、NVIDIA 與 AMD 的戰略陽謀
在 2026 年 6 月完成的 3.1 億美元 B 輪融資中,Odyssey 的投資名單引發了晶片與雲端市場的高度關注:
- NVIDIA 與 AMD Ventures 同台注資:很少有一家 AI 新創能讓競爭白熱化的兩大 GPU 晶片霸主同時出資。原因很簡單——基礎世界模型的訓練與即時串流推演,所消耗的張量浮點運算與記憶體頻寬,比起純文字 LLM 高出數個數量級。押注 Odyssey,就是押注未來五到十年最大的硬體算力消耗來源。
- Amazon(亞馬遜)的戰略佈局:亞馬遜全球倉儲帝國中部署了數十萬台物流機器人,同時旗下擁有自駕車公司 Zoox。Odyssey-3 的跨載體物理基座,對於亞馬遜龐大的無人化智慧物流版圖具有無法估量的整合潛力。
- In-Q-Tel 的國家級戰略背書:作為具備美國戰略背景的創投基金,In-Q-Tel 的注資明確標誌著「通用物理世界模型」已被視為關乎未來自主無人機、應急救援與國防智能體競爭的核心戰略高地。
冷靜審視:Odyssey-3 當前仍面臨哪些技術瓶頸?
儘管 Odyssey-3 展現出了震撼業界的物理模擬與控制能力,但在其邁向大規模商業生產環境的道路上,仍有幾座難以忽視的高山需要跨越:
1. 物理漂移(Physics Drift)與長週期幻覺
在短期(數秒至數十秒)的推演中,Odyssey-3 展現了極高的幾何與動力學保真度。然而,在缺乏外部感測硬約束的超長週期預測下,神經網路仍難以完全避免**「累積誤差(Compounding Errors)」**。 微小的力矩預測誤差在自回歸循環中會被不斷放大,最終可能導致物體在數十步後發生違背物理定律的漂移(例如輪胎抓地力莫名增加、物體質量突然微變)。如何在不依賴昂貴符號求解器的前提下,給神經網路戴上嚴格的物理守恆定律緊箍咒,是團隊必須攻克的難關。
2. 即時推論(Inference Latency)與端側算力代價
自駕車在面對橫穿馬路的行人時,安全決策時間窗通常只有 50 至 100 毫秒;人形機器人維持動態平衡的底層力矩迴路更需要以 200 至 500 Hz 的頻率運作。 自回歸擴散 Transformer 具備龐大的參數體系,要將這樣一個龐然大物壓縮、剪枝並量化至能在車載晶片(如 NVIDIA Thor)或機器人胸腔內的小型邊緣計算盒上低功耗、毫秒級穩定推論,考驗著極致的系統級工程最佳化能力。
3. 公測考驗與安全介入標準
雖然官方宣稱在印度自駕實測中達到 77% 的真實訓練水平,但 77% 與自動駕駛量產落地所要求的「99.9999%(6 個 9)」安全可用性之間,仍然橫亙著巨大的長尾鴻溝。在接下來數週即將開啟的公測中,開發者社群將如何在各種極端嚴苛的壓力測試下檢驗 Odyssey-3,將是決定其能否真正奠定「具身智能安卓地位」的關鍵一役。
結論:物理世界的「ChatGPT 時刻」正在加速降臨
回顧人工智慧的演進史:
- 2012 年,AlexNet 點燃了電腦視覺的火種;
- 2022 年底,ChatGPT 讓語言模型突破了自然語言理解的奇異點;
- 2026 年的今天,我們正在見證第三次浪潮的全面爆發——物理世界的具身革命。
Odyssey-3 的出現,宣告了機器人與自動駕駛領域長達數十年的「煙囪式(Siloed)研發時代」正在走向終結。未來,我們不再需要為每輛車、每隻機械手、每個雙足機器人單獨發明輪子;一個強大的、擁有通用物理直覺的基礎世界模型,將成為所有實體智能體的底層操作系統。
當 AI 不僅能理解人類的文字與話語,更能深刻洞悉牛頓的引力、愛因斯坦的空間幾何,並在毫秒間駕馭鋼鐵軀體改變真實世界時——我們距離通用物理智能(General Physical Intelligence)的終極彼岸,顯然又邁出了決定性的一大步。