Perplexity Computer 如何從錯誤學習?21.2% 工具失敗率下降解析
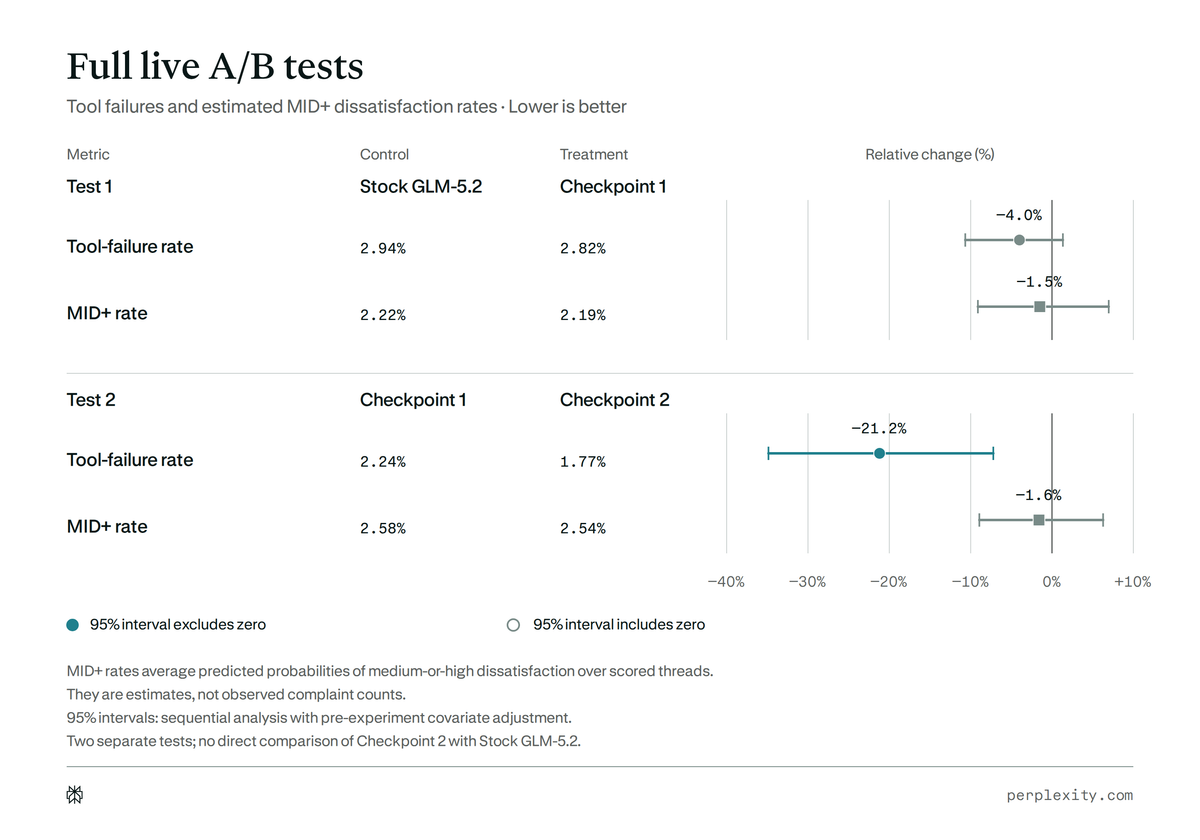
Perplexity 以使用者修正與工具錯誤後訓練 Computer 模型,並公布工具呼叫失敗率相對下降 21.2%。這個數字是兩個後訓練版本之間的比較。
AI Agent(人工智慧代理)要完成任務,往往得多次搜尋、讀檔或操作工具。只看最後有沒有交出結果,會漏掉中間那些「先失敗、再補救」的步驟。只挑成功案例訓練,也會把已經發生的錯誤一起丟掉。
Perplexity 在 2026 年 9 月公布一種訓練 Computer 模型的方法:把使用者修正與工具錯誤整理成可學習的提示,再讓模型透過「提示引導自我蒸餾」修正後續行為。公司在 X 貼文中稱,較新的訓練版本讓工具呼叫失敗率相對下降 21.2%。
這個結果值得注意,但不能解讀成 Computer 的整體能力提升 21.2%。實際數字是兩個已訓練版本之間的比較,衡量的是有記錄狀態的工具呼叫是否失敗。同一場測試裡,使用者不滿意度沒有顯著改善。以下拆解方法與證據的範圍。
為什麼 AI Agent 需要從「中間錯誤」學習?
一般的模型訓練可能先判斷一段工作階段最後有沒有成功,再保留成功的過程供模型模仿。這種做法有個盲點:Agent 可能先用錯工具、收到錯誤訊息,後來才繞路完成任務。只看最後結果,錯誤步驟也可能被當成成功軌跡的一部分。
反過來說,失敗的工作階段也不一定毫無價值。模型或許只在某個步驟犯錯,其他操作仍然正確。如果整段都丟棄,就少了一次指出「哪裡做錯、當時其實知道什麼」的機會。
Perplexity 的研究把這兩種訊號分開處理:成功過程中有用的動作可以保留來模仿。若某個錯誤能由當時已存在的資訊避免,就可以另外訓練模型修正那一步。這比單純按最終成敗篩選整段對話更細。
延伸閱讀:Perplexity Computer 是什麼?一次搞懂 AI 數位員工的終極使用教學
提示引導自我蒸餾怎麼運作?
Perplexity 把兩種訓練方式組合起來。第一種是拒絕採樣微調(RFT),也就是挑出任務成功的對話,讓模型模仿其中有用的步驟。第二種是策略內自我蒸餾(OPSD):同一個模型分別扮演「老師」與「學生」,老師會看到一段指出可避免錯誤的提示,學生則看不到提示,再學習老師因此產生的下一步預測。
研究用一個程式錯誤說明這個差別:工具文件已寫明,搜尋結果會以清單回傳。模型卻把清單當成字典處理,接著收到型別錯誤。若該錯誤確實能從先前文件避免,訓練提示就會點出資料格式與錯誤步驟。老師讀到提示後,會提高正確操作的可能性。學生不會直接看到提示,而是學習老師在同一段上下文中如何改變預測。
這套方法不是叫模型「把整段失敗重做一次」。在 Perplexity 的流程裡,成功工作階段的好步驟仍可作為模仿目標。成功或失敗工作階段中,只有具備有效、可追溯提示的錯誤步驟才作為修正目標。其餘內容保留作上下文,不直接當成要模仿的答案。公司也指出,模仿目標能替訓練定錨,降低老師與學生只靠忽略上下文而看似一致的風險。
21.2% 降幅代表什麼?
Perplexity 公布的是兩次分開進行的線上 A/B 測試。A/B 測試會把使用者分到不同版本,觀察產品指標是否改變。這裡的指標是工具呼叫失敗率,不是任務整體完成率。
| 測試 | 比較版本 | 工具呼叫失敗率 | 公司公布的結論 |
|---|---|---|---|
| 第一次 | 原始 GLM 5.2 對第一個後訓練版本 | 2.94% 對 2.82% | 差異未達統計顯著 |
| 第二次 | 第一個後訓練版本對較新的版本 | 2.24% 對 1.77% | 相對下降 21.2%,達統計顯著 |
第二次測試的絕對差距是 0.47 個百分點,約等於每 1,000 次有狀態紀錄的工具呼叫少 4.7 次失敗。21.2% 是用前一版失敗率作分母計算的相對降幅,不是新模型完成任務的機率提高 21.2%。Perplexity 表示每個測試條件約有 10 萬名使用者,不過公開資料沒有列出每組實際納入計算的工具呼叫總數。
兩次測試不能合併成「新版本比原始 GLM 5.2 少失敗 21.2%」。第一次比較新版與原始模型,差異並不顯著。第二次有顯著差異的比較,是兩個後訓練版本之間。Perplexity 明確說明,沒有在線上直接把第二個版本拿去和原始 GLM 5.2 比較。
使用者回饋也沒有同步出現顯著變化。第二次測試中,中度或高度不滿意的估計平均機率從 2.58% 變成 2.54%,差異不具統計顯著性。這是模型估計的指標,不是實際收到的抱怨數量。因此,目前比較有力的證據是工具呼叫的可靠度改善,而不是使用者整體感受已經變好。
訓練資料如何篩選?
這套方法使用 Perplexity Computer 的真實工作階段,研究描述的樣本來自 GLM 5.2。公司表示,資料流程會排除含有個人識別資訊的工作階段,也會排除選擇退出模型訓練的使用者資料。工具錯誤也不會一律算在模型頭上。研究排除了已知的基礎設施故障與權限遭拒情況,錯誤提示還必須能指向模型當時可取得的工具文件、系統指示或前文內容。
這些限制很重要。工具呼叫失敗可能來自模型,也可能來自服務中斷、權限設定或模糊指令。若把所有錯誤都當成模型缺陷,模型反而可能學到錯的修正方式。要求提示能回溯到當時已有的資訊,至少讓「模型可以避免的錯誤」和「外部環境出問題」有機會分開。
不過,公開說明仍是 Perplexity 對自家資料流程與測試結果的描述,並非外部機構審計。這也不表示模型會在每次對話後立即記住某位使用者的修正。研究描述的是經過篩選與後訓練,再把新版本提供給 Computer 使用的流程。
這項研究目前能證明到哪裡?
它展示了一種較細緻的 Agent 訓練思路:保留任務成功時值得模仿的步驟,也利用可驗證的中途錯誤提供修正方向。對需要連續操作搜尋、程式或辦公工具的 Agent 來說,減少無效呼叫有實際價值,因為錯誤工具操作常會拖慢整條工作流程。
但工具失敗率只是其中一個局部指標。它沒有直接回答回答內容是否更正確、複雜任務完成率是否提高、是否減少安全風險,也沒有證明這套方法在其他模型與產品上同樣有效。加上第二次 A/B 測試只比較相鄰的後訓練版本,使用者不滿意度沒有顯著差異,目前更適合把它視為一個有量化訊號的工程改進,而非 Computer 全面變聰明的證據。
我的判斷是,這項研究最有意思的地方不是「21.2%」這個單一數字,而是它把模型最後的成敗與中間每一步的品質拆開訓練。若後續能在任務完成率、答案正確性與使用者體驗上也看到穩定改善,這種方法才更能證明它帶來了全面的 Agent 進步。
FAQ
什麼是提示引導自我蒸餾?
它讓同一個模型扮演老師和學生。老師看得到針對錯誤的提示,學生看不到。訓練時,學生學習老師看到提示後如何調整下一步預測,讓模型之後有機會在沒有提示的情況下避開同類錯誤。
Perplexity Computer 會即時記住我的每次修正嗎?
研究描述的是篩選真實工作階段,再用於後續模型訓練,之後把後訓練版本提供給 Computer 使用。它不是說每位使用者修正後,模型就會立即、個別地更新。
21.2% 是否代表 Computer 的任務成功率提高 21.2%?
不是。這是較新版本相較前一個後訓練版本,在有狀態紀錄的工具呼叫失敗率上的相對降幅。任務完成率與使用者不滿意度沒有因此被證明提高。
研究有沒有官方影片?
Perplexity 的 X 貼文附有 A/B 測試圖表,研究文章也提供方法示意圖,但這兩個官方來源都沒有附上與這項研究相關的影片。
結語
Perplexity 的做法提醒我們,AI Agent 的訓練不必只看「最後有沒有做完」。可避免的中途錯誤也能成為訓練訊號,但前提是錯誤原因可以從當時已知資料中被驗證。現階段的線上數據支持工具呼叫失敗率下降,還不足以證明整體任務品質或使用者滿意度同步提升。
資料來源: