Training Season 火車挑戰(Phone Sticking)台北做不到,我用 Claude+Seedance 讓 AI 版的我做了
Training Season 火車挑戰(又叫 Phone Sticking)在台北捷運做不到,因為全站有月台門。我用 Claude 做 3D 預演、Seedance 2.5 出片,讓 AI 版的我來做:第一輪 9 次、888 點,後續加碼共 2,138 點(約 NT$684),附完整提示詞、每次嘗試、有/無預演對照、臉部表情不失真與追車段重做的做法。

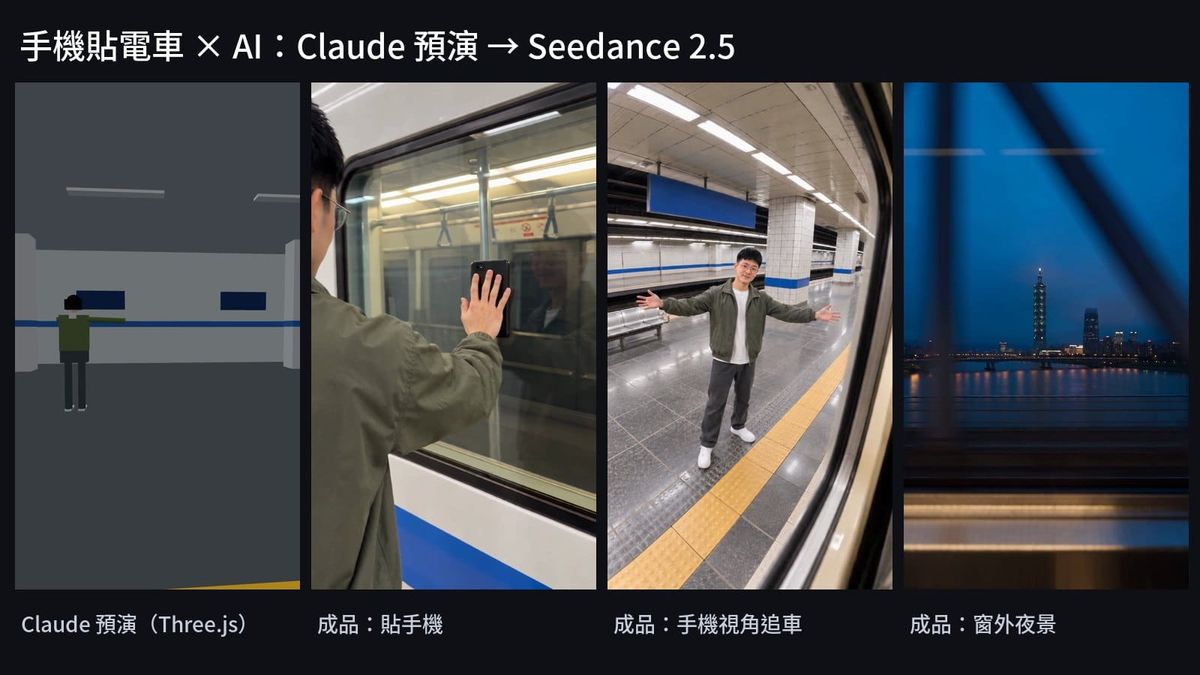
手機貼在地鐵車窗上、人在月台追,列車開走後鏡頭轉向窗外,露出整座城市夜景——這個玩法在 TikTok 和 IG 上通稱 Training Season 火車(地鐵)挑戰(Train/Subway Trend),新聞也叫它 Phone Sticking;10 月初靠 Ollie Muhl 的巴黎版在 IG 衝到約 1 億次觀看,配的是 Dua Lipa《Training Season》的現場版。這篇用中文叫它「手機貼電車」。但台北捷運全站都有月台門(北捷 2018 年 9 月宣布完成),真人版在台北根本做不到。
所以我試了 AI 版:用日本創作者 Zeto 10 月 23 日公開的做法——先請 Claude 做 3D「預演」,再把預演交給 Seedance 2.5 出片——主角換成我自己,場景換成台北捷運風格的月台。結果是一支 31 秒的成品,加上一份誠實的實測紀錄:第一輪試了 9 次、用掉 888 點(約 NT$284);之後照 IG 上原版的開頭和追車分鏡加碼重做,總共 19 次、2,138 點(約 NT$684)。
先說四個結論(都是單次實測,不是統計):
- 鏡頭邏輯比提示詞重要。貼上手機之後,鏡頭必須變成「貼在車窗上的手機」(廣角、回頭看月台、柱子滑過),不是旁邊跟拍的第三人稱。我第一版就是這裡做錯,結果像一般追跑片。
- 預演有用,用在「人要留在畫面裡」。同一張圖、同一段提示詞:沒預演,人跑兩秒就變成月台盡頭的小黑點;有預演,人一路追在車旁。
- 用自己的臉可行,但要先生全身定場圖。我的照片在 Seedance 2.5 沒被擋,全片臉都穩;只是追車那段人很小。
- 表情不失真靠流程,不靠運氣。臉大的鏡頭只做 4 秒、先用 Draft 逐 0.5 秒看臉,確定眼鏡、嘴型、牙齒都正常才花正式點數。
這個梗叫什麼?Training Season 火車挑戰,也叫 Phone Sticking
玩法是:把手機貼在列車車窗上,人在月台上說話、跳舞或對嘴,列車開走時追著跑;手機畫面最後「露出風景」。名稱有三層:①配上 Dua Lipa《Training Season》的版本,TikTok 話題頁通稱 Training Season trend/train trend(Training Season 火車挑戰);②只看動作,印度新聞叫 phone-sticking(Phone Sticking 挑戰);③X 上有人用 #PhoneOnTrain。這首歌也被拿去做別的趨勢(例如顯化、水瓶舞),搜尋時要加 train 才不會跑偏。Know Your Meme 我查不到條目。
時間線(都是新聞或頁面上看得到的):9 月初,德里創作者 Nikhil Kochar 的 IG reel 讓 phone sticking 在印度爆紅(IBTimes India 報導約 1.35 億觀看,配的是寶萊塢歌曲,不是 Dua Lipa);9/5 德里捷運 DMRC 公開警告;9/11 Ollie Muhl 發紐約版,配《Training Season》;10/3 他的巴黎版衝到約 1 億觀看。換句話說,「手機貼窗+追車」先紅在印度,配上 Training Season 的西方版才叫 Training Season 火車挑戰。最早是誰發明的,我沒有找到來源。
| 來源 | 說了什麼 | 日期 |
|---|---|---|
| Ollie Muhl(IG @olliemuhl) | 巴黎版,音訊標「Dua Lipa • Training Season (Live from the Royal Albert Hall)」:約 1 億觀看、824.8 萬讚(IG 顯示「1億」是概略值) | 10/3 發布,10/24 查看 |
| Ollie Muhl 紐約版 | 1,473 萬觀看、100 萬讚 | 10/11 發布,10/24 查看 |
| Ollie Muhl 另一支紐約版 | 26.7 秒、約 5.9 萬讚;說明欄「They're laughing cause I got a new phone」;開頭是他迎著鏡頭走來、白色有線耳機、跟著歌唱的表情 | 9/11 發布,10/25 查看 |
| Le Parisien(HeadTopics 轉載) | 巴黎捷運 RATP 稱這種做法「危險且輕率」,列出落軌、卡門等風險 | 10/21(二手,未見原文) |
| NewsGram | 德里捷運 DMRC 在 IG 警告創作者別拍 phone sticking | 9/5 聲明、9/7 報導(二手) |
| IBTimes India | 德里創作者 Nikhil Kochar 的 reel 讓 phone-sticking 爆紅,約 1.35 億觀看;DMRC 稱將採取必要行動 | 9/6 報導(二手) |
| Just Jared/Yahoo | Ollie 10/15 在 IG 限動說 AI 在拿他的內容,點名 Messi、Neymar、一隻狗、Peter Griffin 的版本(我沒找到那些貼文本身) | 10/15(二手) |
所以這篇的做法很清楚:致敬 Ollie 的原創,不放他的影像,也不用任何「上傳你的臉就套進去」的模板站(那種站是把你的臉放進別人的場景,深偽與肖像風險都高)。我們只做自己的 AI 影片,並標清楚是 AI 生成。
為什麼台北做不到?月台門與拍攝規定
- 月台門:Newtalk 2018 年 9 月 29 日報導,北捷宣布全站月台門完成(117 站,其中 59 站建站時就有、58 站後來加裝,最後一站是土城站)。月台上的人碰不到車窗,真人版在台北做不到。2018 年之後的新站我沒有逐一查,發文前請看北捷官網。
- 拍攝規定:臺北捷運官網常見問答(2020 年更新、2026/10/22 審視)寫明:一般紀念性照相攝影不需事先申請,但不得違法或妨礙他人與系統安全;商業性質的拍攝須先依媒體拍攝須知申請。品牌或媒體帳號的內容可能算商業,所以我沒有到站內實拍,也沒有拍參考照。
- 形象與標誌:北捷形象、標誌、車廂外觀的使用規定我沒有找到,所以成品不出現 logo、站名或可讀文字(Seedance 生成的文字常是亂碼,也順便避開這件事)。
安全的部分不需要解釋太多:巴黎與德里的捷運公司都警告過,別真的去貼、別真的去追。
Zeto 的做法,以及他沒公開的部分
Zeto(X @ZetoGroovin,日本創作者,4,181 追蹤)在 10 月 23 日貼出一支 29 秒的並排影片:左邊是 Three.js 做的積木人預演,右邊是 Seedance 2.5 的成品,截至 10 月 24 日夜約 40 萬觀看。原貼文在這裡。他自述的流程是三步:
- 用語音輸入對 Claude Opus 5.5「狂講」想要的畫面,在一個對話裡請它用 Three.js 做簡單 3D 預演(人物動作與背景動作)。
- 把預演影片當參考,交給 Seedance 2.5。
- 夜景等細節靠提示詞(他回覆「Seedance 2.5 照提示詞做出來的」)。
回覆區還有個實用技巧(ARLO @byarlooo):預演不需要手腳,拿掉四肢讓模型更自由、比較不僵;Zeto 也同意「腳的動作怎樣都會僵」。他沒有公開的:提示詞原文、對 Claude 講了什麼、試了幾次、花多少、用哪個平台。這些就是這篇要補的。
我把他的 29 秒逐秒看了一遍(只看,沒有下載,也不重貼他的畫面),整理出這個梗真正的鏡頭結構——這是整件事最關鍵的發現:
| 秒數 | 鏡頭 | 在演什麼 |
|---|---|---|
| 0–3 | 第三人稱中遠景 | 人站月台上對鏡頭揮手、指向鏡頭,列車在畫面一側 |
| 3–6.5 | 肩後視角/背影 | 轉身走到車窗前,雙手把手機貼上車窗 |
| 6.5–16 | 手機視角(超廣角、回頭看月台) | 人退到月台中間張開雙手,列車開動,人追著跑;柱子、看板、磁磚牆從兩側滑過 |
| 16–29 | 窗外夜景(佔 41%) | 鏡頭轉向窗外,橋的鋼樑一根根掠過,露出夜景天際線 |
他整支是 Seedance 2.5 一次生成 29 秒,所以同一張臉全程一致。預演也不是逐格複製:服裝顏色與成品一致,場景用色塊標出位置(車窗、柱子、看板),鏡頭路線與節奏對齊,細節由模型自己補。
我的實測:流程、提示詞與每一次嘗試
設定:主角是我(短黑髮、圓框細銀框眼鏡、橄欖綠教練外套、白 T 恤、深灰長褲、白球鞋),場景是台北捷運風格的月台(白色磁磚牆、藍色色帶、白色柱子、黃色導盲磚,沒有月台門)。工具:Claude 做預演、ChatGPT 用我的照片生全身定場圖、Dreamina 的 Seedance 2.5(Basic 方案)出片。
第 1 步:請 Claude 做預演(免費)
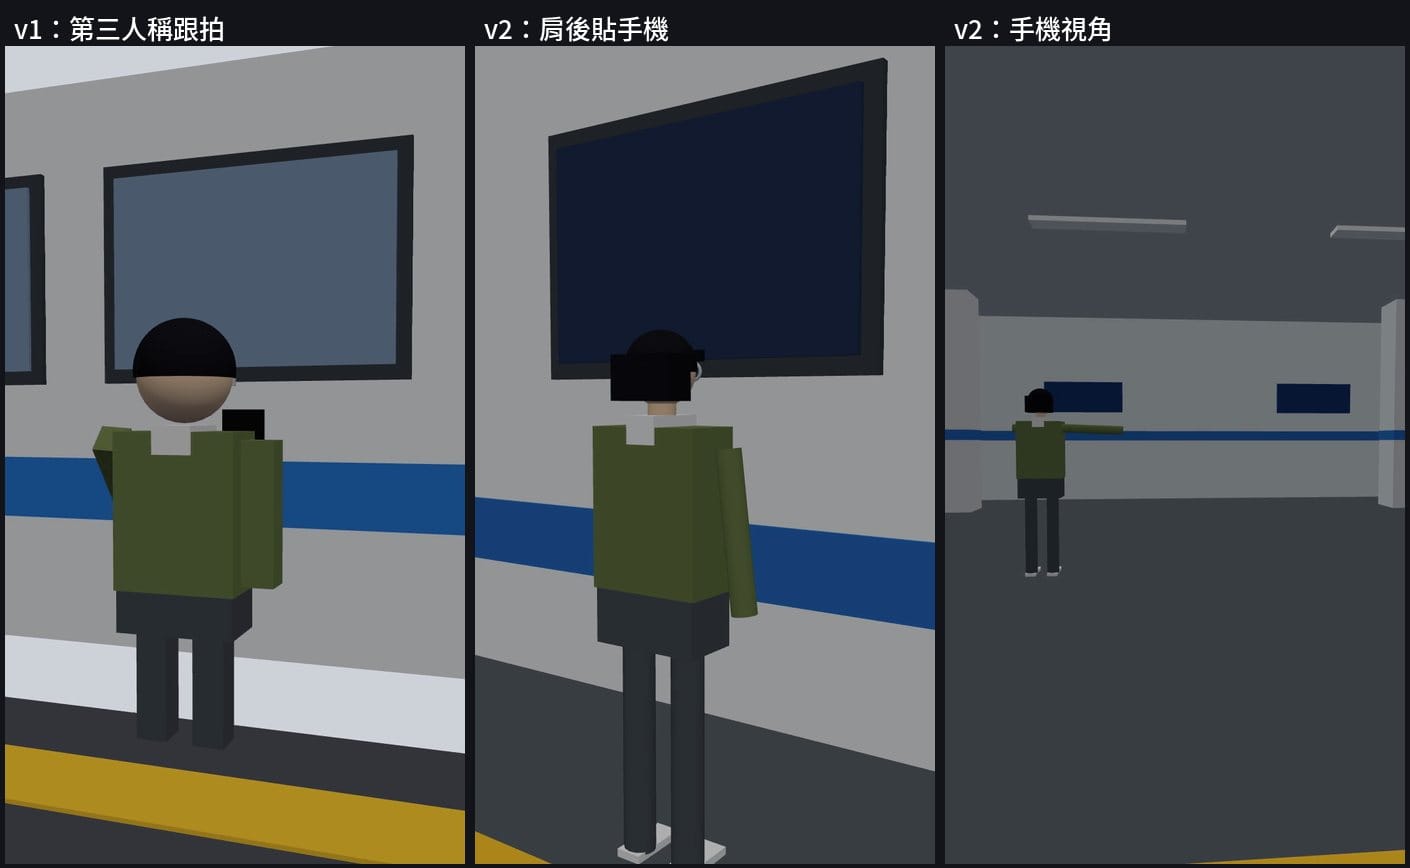
我請 Claude 寫成單一 HTML(Three.js,固定版本、9:16、30fps、15 秒,寫成可逐格輸出的函式),再用 Playwright 逐格截圖、ffmpeg 合成 mp4。第一版(v1)失敗了:人偶比例怪、手機漂在半空中,而且貼完手機後我仍用第三人稱跟拍,沒有切到手機視角。照 Zeto 的鏡頭結構重寫成 v2:第三人稱 → 肩後貼手機 → 手機視角(廣角,柱子滑過,人張開雙手再追車)→ 窗外夜景。
第 2 步:用我的照片生全身定場圖
我的照片只到上半身,所以先請 ChatGPT 用它生 4 張 9:16 圖:站姿揮手、側面跑步、背影把手機貼在車窗上、以及「貼在車窗上的手機」視角的第一格(超廣角、回頭看月台、我張開雙手)。提示詞都明講「兩手各五根手指、眼鏡一直戴著、沒有任何文字或標誌、沒有月台門」。這一步免費,臉與眼鏡都穩。
第 3 步:Dreamina 出片
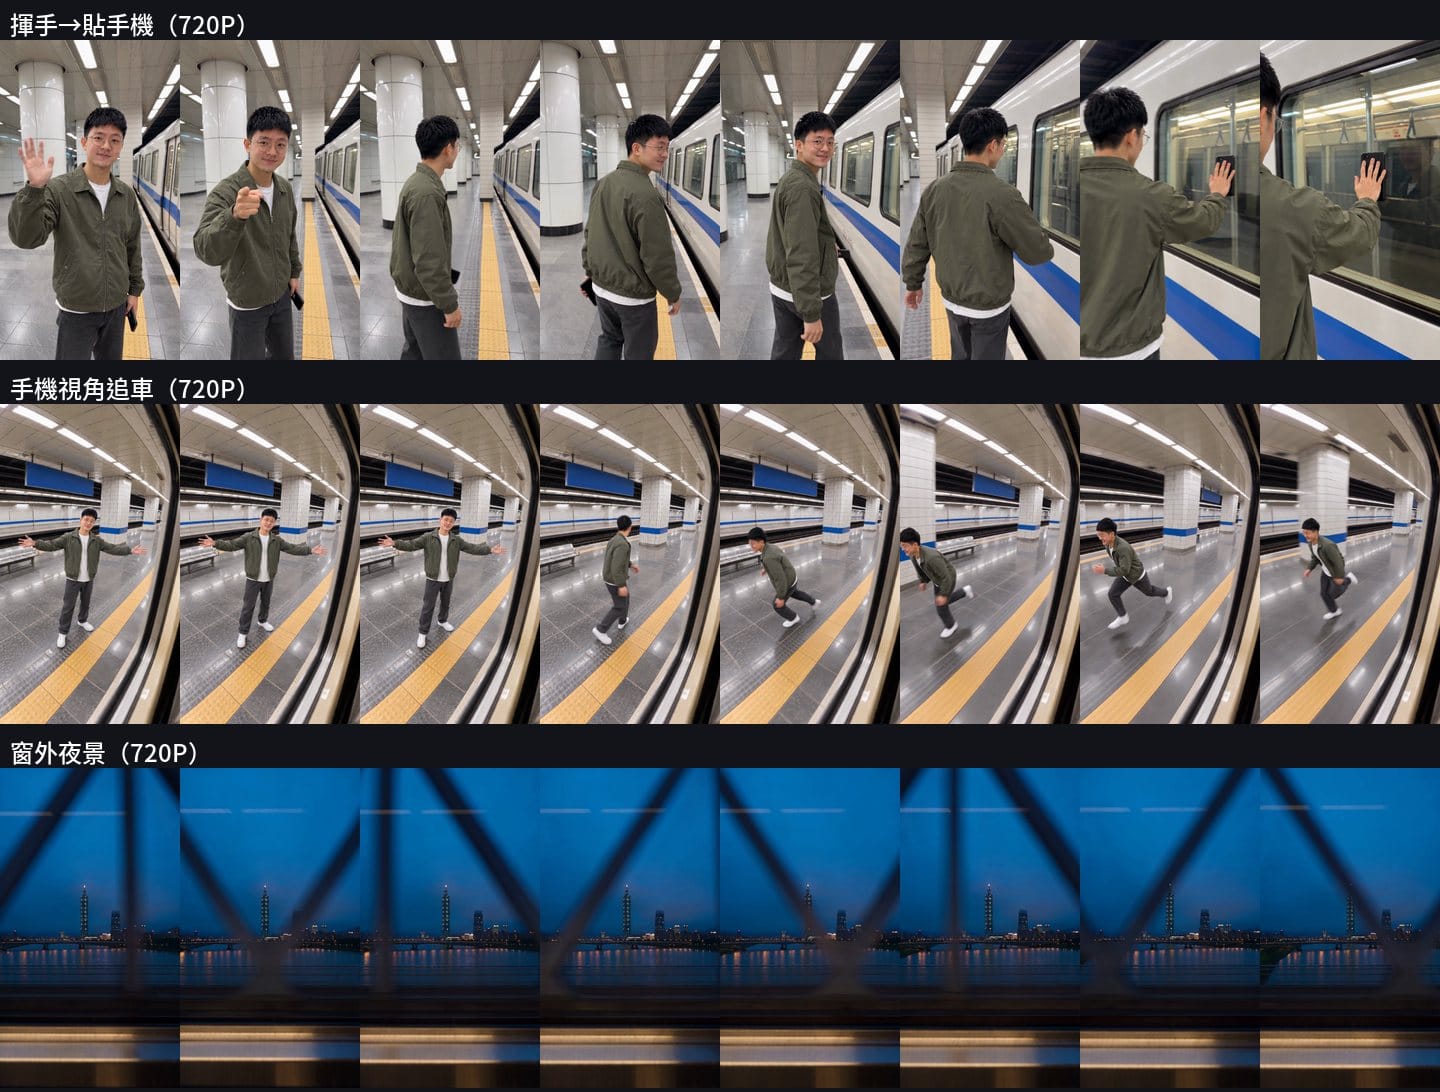
模型選 Seedance 2.5(Omni reference),比例 9:16。參考圖片與預演影片都可以上傳、再在提示詞裡用「圖片一」「影片一」指定用途。我分段生成(預算取捨,後面會講):開場揮手到貼手機、手機視角追車、窗外夜景,後來又加了開頭走向鏡頭與唱歌近景兩段。追車那段的提示詞(全文):
圖片一是第一幀:手機貼在列車車窗上、超廣角回頭看月台的視角,主角站在月台中間張開雙手。圖片二是主角正面外貌:亞洲男性,短黑髮,圓框細銀框眼鏡,橄欖綠教練外套、白色 T 恤、深灰長褲、白球鞋;全程同一張臉,眼鏡一直戴著。鏡頭就是貼在車窗上的手機,不是第三人稱:廣角、略有魚眼感、輕微手持晃動,固定在列車上隨列車前進。0 到 2 秒:主角站在月台中間張開雙手,笑著看鏡頭,然後轉身。2 到 5 秒:列車開動加速,手機鏡頭隨車前進,白色柱子、藍色看板和白色磁磚牆從畫面兩側滑過;主角笑著沿月台往前跑,追著列車,越來越小。月台:白色磁磚牆、藍色色帶、白色柱子、黃色導盲磚,沒有月台門,畫面中不要出現任何標誌、站名或文字。保留列車與腳步的環境音,不要字幕,不要背景音樂。影片一只提供主角的動作時間點和鏡頭路線,請依描述重新生成寫實場景和人物,不要保留預演的積木外觀。
開場那段(揮手 → 轉身 → 貼手機)用站姿圖當第一幀、背影圖當第二張參考,提示詞依秒數寫動作;這一段沒有給預演,鏡頭用文字指定成第三人稱:
圖片一是第一幀:主角站在月台上面向鏡頭揮手,手裡拿著手機。圖片二是他背對鏡頭把手機貼在列車車窗玻璃上的樣子。主角:亞洲男性,短黑髮,圓框細銀框眼鏡,橄欖綠教練外套、白色 T 恤、深灰長褲、白球鞋;全程同一張臉,眼鏡一直戴著。0 到 2 秒:主角站在月台上笑著對鏡頭揮手,再指向鏡頭,旁邊停著一列白色捷運列車(藍色線條)。2 到 4 秒:他轉身走向列車,回頭笑了一下。4 到 6 秒:他背對鏡頭,右手把手機貼在列車車窗玻璃上,手掌壓住手機。鏡頭:第三人稱,手持感,從正面慢慢移到他身後的肩後視角。月台:白色磁磚牆、藍色色帶、白色柱子、黃色導盲磚,沒有月台門,畫面中不要出現任何標誌、站名或文字。保留環境音,不要字幕,不要背景音樂。
窗外夜景只用提示詞:
手機貼在行進中的列車車窗上,鏡頭固定朝向窗外:夜晚的台北城市天際線,台北 101 在遠處,河面與橋樑延伸到遠方,橋的鋼樑一根一根從畫面前方掠過,窗台在畫面下緣,遠處的車道上有橘色和白色的車燈流動。輕微手持晃動,寫實、電影感,藍色時刻的天空。畫面中沒有人物、沒有文字、沒有標誌。保留列車行進的環境音,不要字幕,不要背景音樂。
結尾的台北 101 夜景是 AI 想像,我沒有查到哪條線真的看得到 101,所以不標哪一線。
每一次嘗試(全部的紀錄)
| 編號 | 條件 | 模型・長度 | 點數 | 結果 |
|---|---|---|---|---|
| T2 | 兩張圖(站姿+跑姿),無預演;提示詞寫「側面跟拍」 | Draft 480P・4 秒 | 36 | 臉像、眼鏡在、跑得自然;但是第三人稱,不是這個梗的鏡頭 |
| T3a | 同 T2+預演 v1(4 秒) | Draft・4 秒 | 0(失敗退點) | Dreamina 回「Couldn't generate…Credits returned」,點數退回;重送即成功 |
| T3b | 同上重送 | Draft・4 秒 | 72 | 和 T2 差不多(預演 v1 與提示詞都是第三人稱,看不出差別) |
| D1 | 手機視角第一幀+站姿圖+預演 v2 手機視角 5 秒 | Draft・5 秒 | 90 | 對了:貼在車窗的廣角視角,張開雙手→轉身→追著跑→越來越小,柱子與藍色看板滑過 |
| G1(Draft) | 站姿圖+背影圖(參考欄殘留一支 5 秒預演,實際以 11 秒計價) | Draft・6 秒 | 99 | 揮手、指向鏡頭、轉身回頭笑、背影貼手機;臉穩;鏡頭比預期近 |
| F0 | 把 D1 升成正式品質(只報價,沒送出) | Draft→1080P | 報價 640 | 只提供 1080P(720P、4K 灰掉),太貴,沒採用 |
| G1 | 同 G1,直接用正式模型 | Seedance 2.5・720P・6 秒 | 156 | 成品採用 |
| POV | 同 D1,直接用正式模型 | 720P・5 秒(+預演 5 秒) | 260 | 成品採用 |
| REV | 只有提示詞,窗外夜景 | 720P・5 秒 | 130 | 成品採用:台北 101、河面倒影、鋼樑掠過 |
| C1 | 對照組:同 D1 但不給預演 | Draft・5 秒 | 45 | 人跑兩秒就消失在月台盡頭 |
| H1 Draft | 第二輪:走向鏡頭的定場圖+身份圖,無預演 | Draft・4 秒 | 36 | 臉與眼鏡穩,走路自然,後半嘟嘴哼唱不變形 |
| H2 Draft | 第二輪:唱歌近景定場圖+身份圖 | Draft・4 秒 | 0(失敗退點) | 頁面顯示沒有輸出,點數退回;重送即成功 |
| H2 Draft(重送) | 同上 | Draft・4 秒 | 36 | 半閉眼唱歌→看鏡頭微笑,沒有失真 |
| P | 第三輪:隔著窗框唱歌的定場圖+身份圖,無預演 | 720P・5 秒 | 130 | 成品採用:真實感強,臉穩,窗框、路人都自然 |
| C1 Draft | 追車第一版:貼著鏡頭大喊的定場圖+身份圖+預演 v3(8 秒) | Draft・8 秒 | 144 | 分鏡走對了,但人離鏡頭太近、表情太用力 |
| C1 | 同 C1 Draft,直接用正式模型 | 720P・8 秒 | 416 | 棄用:人物看起來怪(近、敞開的外套、大喊皺眉、手上還拿著手機) |
| C3 Draft | 追車第二版:離 2 公尺、開心的笑、外套拉好、兩手空;無預演 | Draft・8 秒 | 72 | 自然很多;沒有預演也能貼著鏡頭跑 |
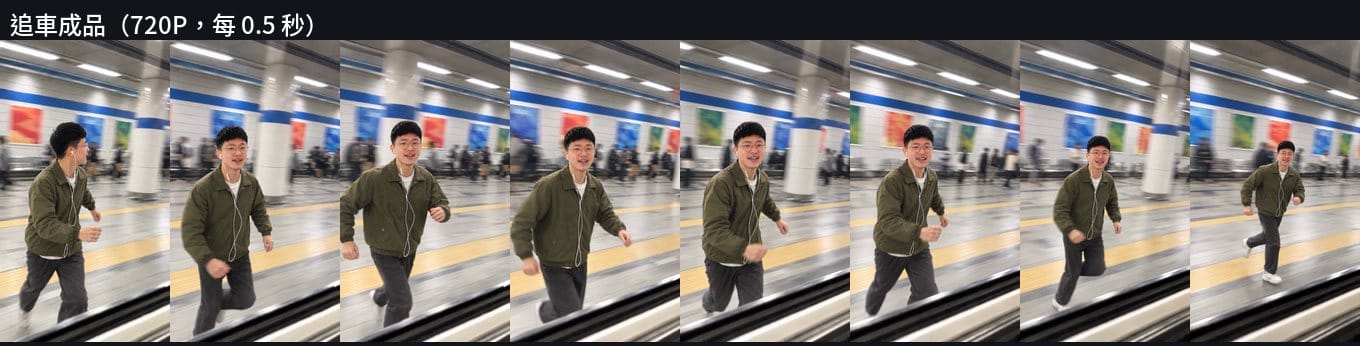
| C3 | 加 2 張分鏡參考圖(被甩開、月台盡頭)共 4 張圖;無預演 | 720P・8 秒 | 208 | 成品採用:照分鏡走,臉、比例、手臂都自然 |
| H1 | 同 H1 Draft,直接用正式模型 | 720P・4 秒 | 104 | 成品採用(取前 3 秒) |
| H2 | 同 H2 Draft,直接用正式模型 | 720P・4 秒 | 104 | 成品採用 |
第一輪合計 888 點(Dreamina 點數約 NT$0.32/點,約 NT$284),「9 次」是實際送出的 9 次生成,其中 T3a 失敗、點數已退回;F0 只是查價,沒有送出。第二輪(H1、H2)加碼 280 點;第三、四輪(表演 P、追車 C1/C3)加碼 970 點。累計 2,138 點(約 NT$684)、19 次,其中 2 次失敗已退點。其中 C1 那 560 點(Draft+720P)是整個過程最貴的一次失敗,原因在下一節。
有預演 vs 沒預演:同一張圖、同一段提示詞
為了知道預演到底有沒有用,我做了對照:同一張第一幀、同一張身份圖、同一段提示詞(沒預演那次只拿掉最後一句「影片一只提供動作時間點和鏡頭路線……」),一次不給預演、一次給預演 v2 的手機視角段落(都是 Draft 480P、5 秒,各跑一次)。
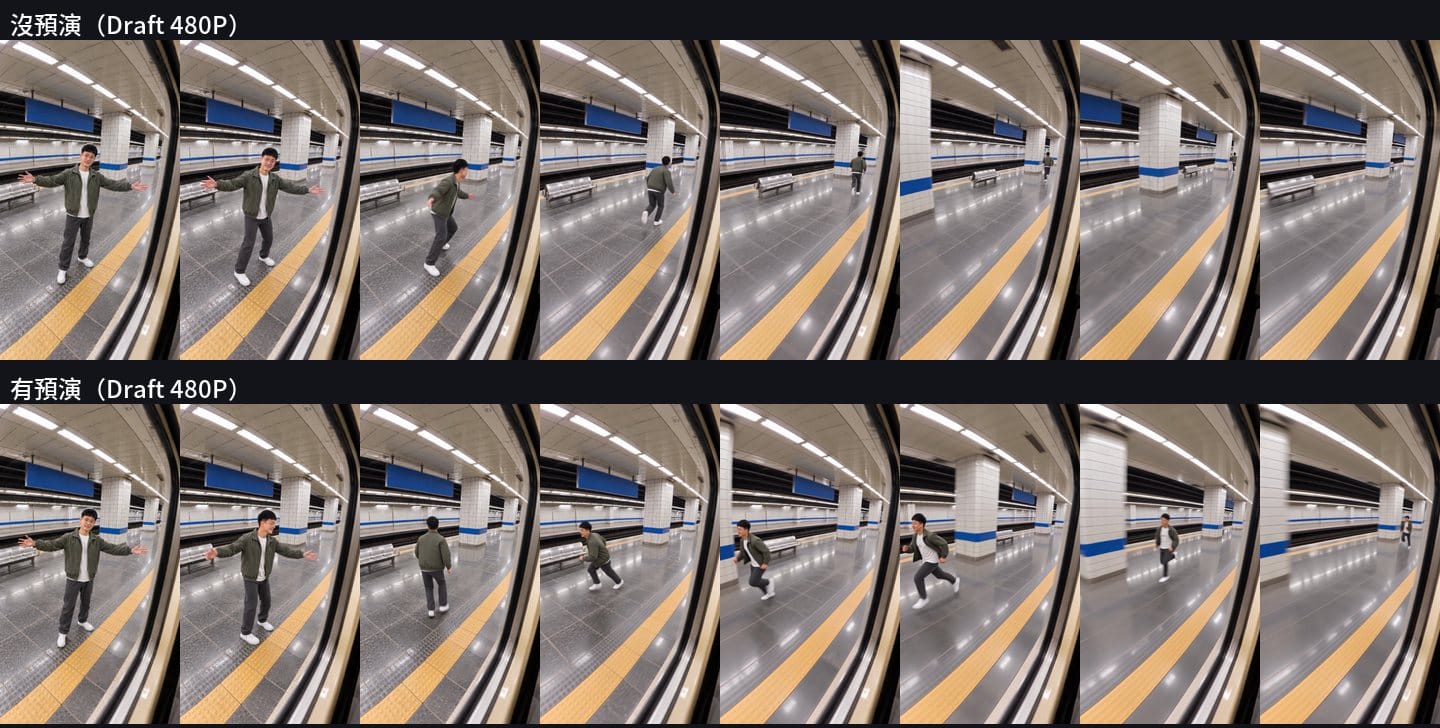
結果:沒預演,人轉身跑兩秒就變成月台盡頭的小黑點,後半段鏡頭只剩柱子滑過;有預演,人一路追在車旁,直到最後才變小。這是單次結果,不是統計——Dreamina 沒有 seed,同一組條件每次都會不一樣。但它說明了預演最值得花力氣的地方:不是畫質,而是「人要留在畫面裡的哪個位置、什麼時候出現」。
我沒有測的:沒手腳的預演版本(ARLO 的建議,預演 B 版已渲染好但沒花點數跑)、用 Leafy 之類的品牌角色、1080P 以上、API。這些留給下一輪。
加碼第二輪:照 IG 原版的開頭重做,臉部表情怎麼不失真
把第一版成品跟 IG 上那些 Training Season 影片比,差在兩處:開頭沒有表情(我們是揮手),而且追車段看不到臉。所以我照 Ollie 9/11 紐約版的開頭——迎著鏡頭走來、白色有線耳機、直視鏡頭、跟著歌唱的表情——加碼重做兩個鏡頭:H1「走向鏡頭」、H2「唱歌近景」。這兩段都沒有用預演(人一直在畫面中央,不需要)。
表情不失真,我是這樣做的:
- 短鏡頭:臉大的鏡頭只做 4 秒(之前記錄是 4 秒後臉容易飄),成片裡 H1 只取前 3 秒。
- 先生定場圖:用 ChatGPT 從我的照片生第一幀,臉、短黑髮、圓框眼鏡一模一樣;第一版多了一個背包,我請它重畫成沒有背包、表情更明顯。
- 表情寫得具體但溫和:「半閉眼、嘴巴自然開合像在投入地唱、眉頭微皺」,不寫「大叫」「扭曲」;提示詞明講「牙齒正常、嘴型自然、五官不變形、眼鏡一直戴著」。
- 先 Draft,逐 0.5 秒看臉:眼鏡在不在、嘴型、牙齒、兩手各五指;通過才花 720P 點數。正式版是另一次生成,所以正式版出來還要再看一次。
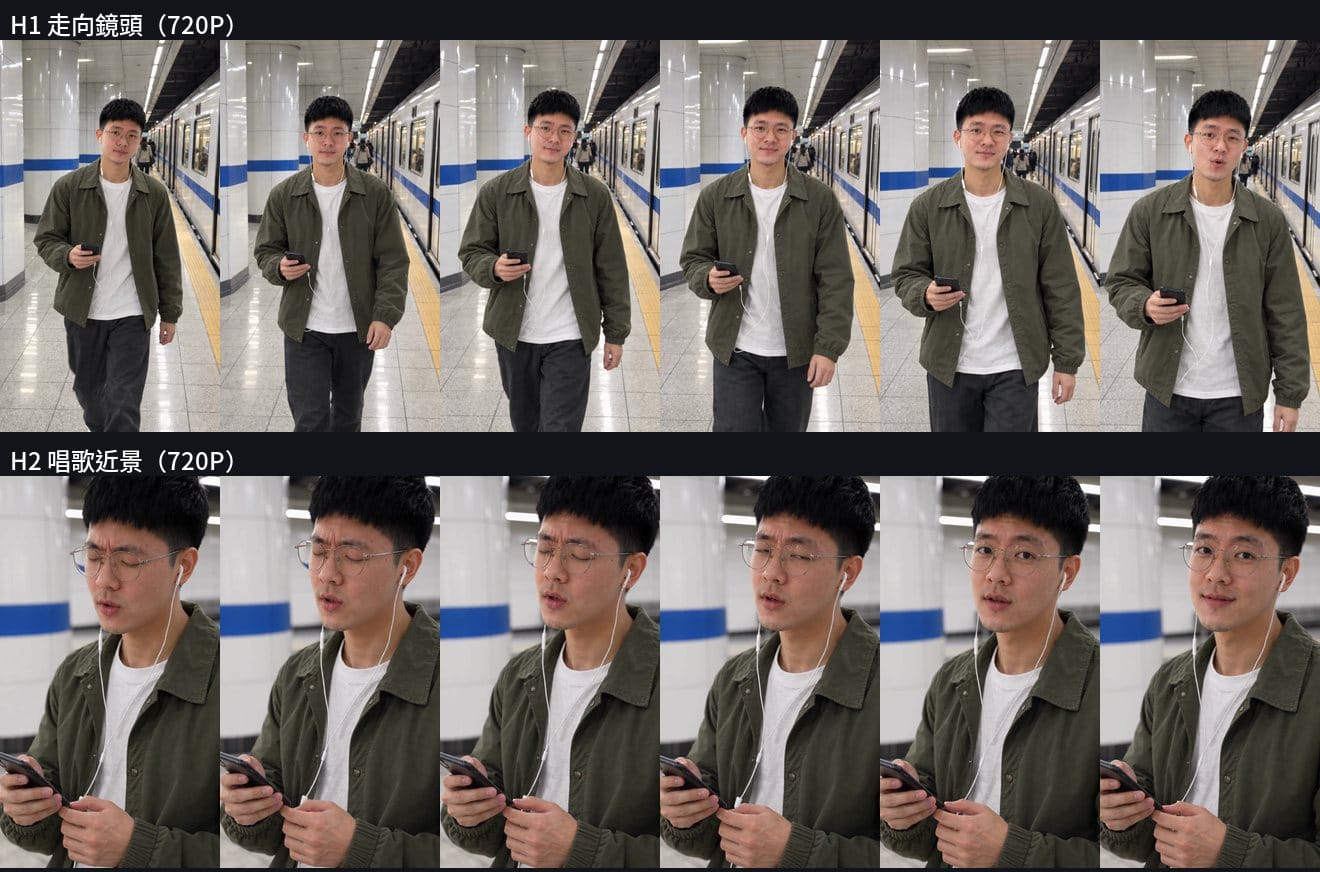
H1 的提示詞(全文,第一幀與身份圖用「圖片一」「圖片二」指定):
圖片一是第一幀:主角在台北捷運風格月台上迎著鏡頭走來。圖片二是主角的完整外貌參考。主角:亞洲男性,短黑髮,圓框細銀框眼鏡,橄欖綠教練外套、白色 T 恤、深灰長褲,戴著白色有線耳機,右手拿著黑色手機;全程同一張臉,眼鏡一直戴著,五官自然不變形。鏡頭:像朋友用手機手持拍攝,略微手持晃動,固定在他正前方,隨著他往後退一點點。0 到 2 秒:他迎著鏡頭自信地走近,眼神一直直視鏡頭,嘴角帶著得意的微笑,一邊眉毛微挑,耳機線隨步伐輕輕晃動。2 到 4 秒:他走到鏡頭前方,頭微微點著節拍,嘴唇輕輕跟著歌哼唱起來,表情有點傻氣但自然。不要大幅度轉頭,不要誇張表情,牙齒正常,兩手各五根手指。背景:月台白色磁磚牆、藍色色帶、白色柱子、黃色導盲磚,右側停著白色捷運列車,沒有月台門,畫面中不要出現任何標誌、站名或文字。保留環境音,不要字幕,不要背景音樂。
H2 的提示詞(全文):
圖片一是第一幀:主角近景,稍微側身,正在跟著歌投入地唱。圖片二是主角的完整外貌參考。主角:亞洲男性,短黑髮,圓框細銀框眼鏡,橄欖綠教練外套、白色 T 恤,戴著白色有線耳機,右手拿著黑色手機;全程同一張臉,眼鏡一直戴著,五官自然不變形。鏡頭:像朋友用手機手持拍攝的近景,胸口以上,輕微手持晃動,固定在他前方。0 到 2 秒:他半閉著眼,嘴巴自然地跟著歌詞開合,像在投入地唱,眉頭微皺,頭隨節拍輕輕點動,耳機線輕輕晃動。2 到 4 秒:他把眼睛慢慢打開,轉頭看向鏡頭,露出得意又有點傻氣的笑,嘴角上揚。不要大幅度甩頭,不要誇張扭曲的表情,牙齒正常、嘴型自然,眼鏡一直戴著,兩手各五根手指。背景:台北捷運風格月台,淡淡模糊的白色磁磚、藍色色帶、白色柱子,右側有白色列車,沒有月台門,畫面中不要出現任何標誌、站名或文字。保留環境音,不要字幕,不要背景音樂。
花費:Draft 72 點(兩個 36 點;H2 第一次送出失敗、點數退回)+ 720P 208 點(兩個 104 點)= 280 點。成品開頭大字用「台北捷運有月台門,所以我讓 AI 版的我去貼」,放在畫面下方,不遮臉。這仍然是單次結果:Draft 通過不保證正式版也通過。
追車段重做兩次:照真實影片的分鏡,以及第一次為什麼人物怪
前兩輪做完,我把成品和 Ollie 巴黎版逐格比了一遍(只看、不下載、不放他的畫面)。真實影片的「追車」其實是這樣拍的:
| 階段 | 大約秒數(巴黎版) | 鏡頭與動作 |
|---|---|---|
| 表演 | 約 5 秒 | 鏡頭=窗上的手機,列車還沒動;人離鏡頭約 2 公尺,頭到大腿,對著鏡頭唱、做手勢、大喊——表情是重點 |
| 追車 | 約 7 秒 | 列車起步加速;人貼在鏡頭旁跑(約 1–1.5 公尺),身體前傾、手臂擺動、臉轉向鏡頭;背景的海報、招牌、柱子、長椅往後滑、越來越糊,路人中途跨進畫面 |
| 被甩開 | 約 2 秒 | 列車越來越快,人落後、往畫面一側漂出去、離開畫面 |
| 月台盡頭 | 約 2.5 秒 | 沒有人,只剩被拉長的牆、路人身影、販賣機一閃而過,出站 |
| Reveal | 約 8 秒 | 鏡頭轉向窗外,夜景佔大半支片的獎勵 |
對照我第一輪的追車段,差在三處:①鏡頭:我用超廣角、有魚眼感,真實是一般手機主鏡頭;②距離:我的人在 5–10 公尺外、很小、看不到臉,真實是貼在鏡頭旁,臉和表情是主角;③比重:我的追車只有 5 秒,真實的表演+追車+被甩開+月台盡頭加起來佔了約三分之一。
所以我重做了「表演」和「追車」。但第一次重做,人物看起來怪(C1,花了 560 點):人離鏡頭只有約 1 公尺、上半身很大、頭相對很小;外套敞開飄起來,裡襯看起來像背包;表情是大喊加皺眉,一邊眉毛挑、五官不對稱;手上還拿著手機,但手機已經貼在車窗上了。
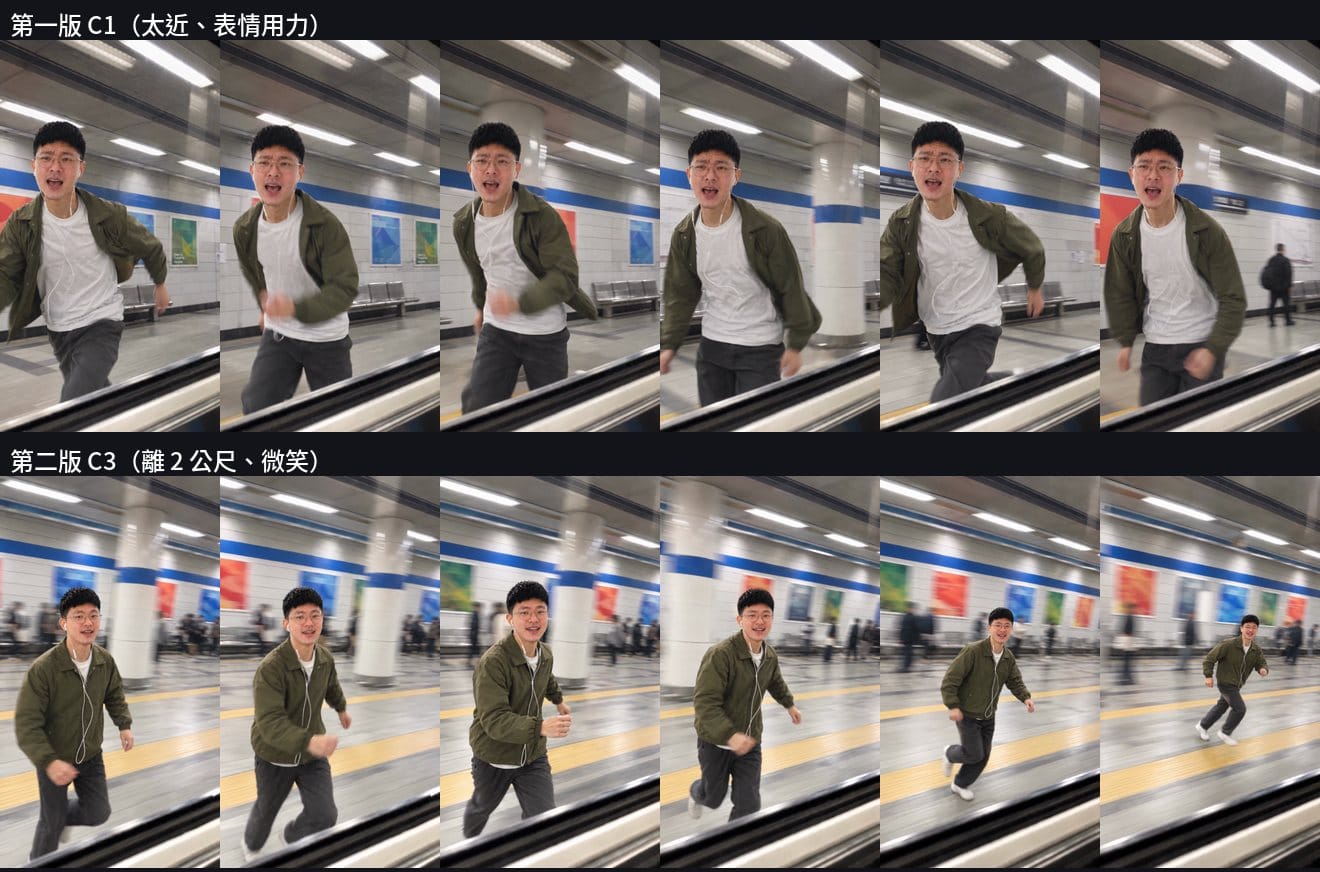
第二次我改了五件事:
- 放遠一點:離鏡頭約 2 公尺、頭到臀部以下,人佔畫面約一半,頭和身體比例才自然。
- 表情改成開心的笑:嘴角上揚、嘴巴微張、牙齒正常,提示詞明講「不要大喊大叫、不要皺眉、不要誇張的表情」。
- 外套拉鍊拉好、兩手空的:衣服不敞開、不飄,減少 AI 要處理的形狀。
- 多給參考圖,讓模型知道分鏡怎麼走:除了第一幀,再生 4.5 秒(被甩開、在畫面右側揮手)和 7 秒(月台盡頭、沒有人、右側隧道入口)兩張,加身份圖共 4 張,並在提示詞寫「圖片一 → 二 → 三」的順序。
- 不給預演影片:Draft 實測(72 點)沒有預演,他一樣貼著鏡頭跑 4 秒、再被甩開;方塊人的動作反而可能讓身體變僵,也省下預演秒數的點數。
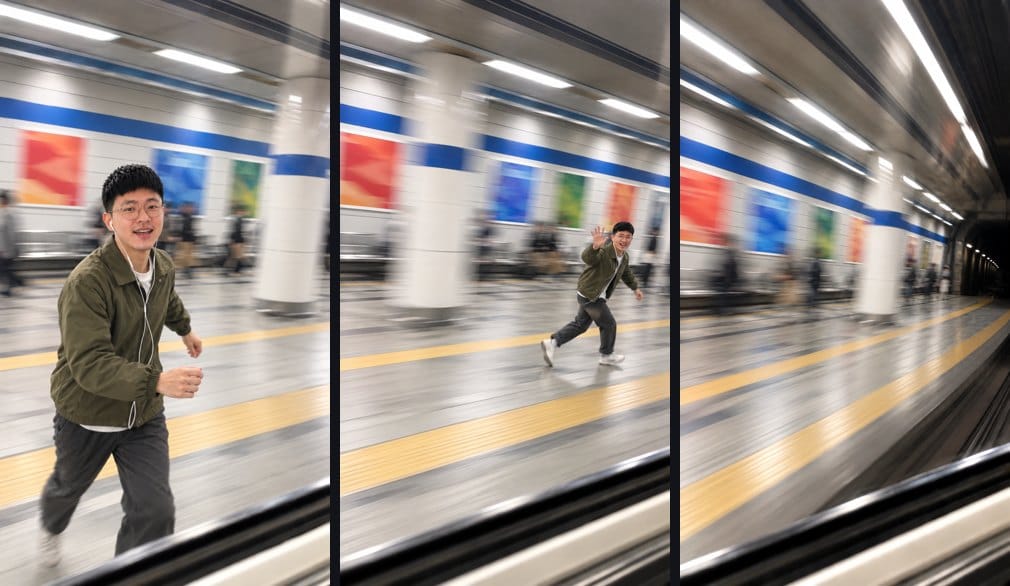
最後這一段的提示詞(全文,圖片一到三是分鏡參考圖,圖片四是身份圖):
這四張圖片說明這一鏡到底的順序。圖片一是第一幀(0 秒):他貼在鏡頭旁輕鬆地跑,轉頭向鏡頭,開心地笑。圖片二是 4.5 秒左右的畫面:列車加速,他被甩開、離鏡頭較遠、在畫面右側,笑著向鏡頭揮手。圖片三是 7 秒左右的畫面:列車駛離月台盡頭,畫面沒有人,只剩拉長模糊的牆和右側昏暗的隧道入口。圖片四是主角的完整外貌參考。請照 圖片一 → 圖片二 → 圖片三 的順序,用一鏡到底的連續畫面把中間補起來。主角:亞洲男性,短黑髮,圓框細銀框眼鏡,橄欖綠教練外套(拉鏈拉好,不要敞開、不要飄起來)、白色 T 恤、深灰長褲,白色有線耳機,兩手空的,不拿手機;全程同一張臉,眼鏡一直戴著,五官自然不變形,牙齒正常,雙臂和雙腿都完整,人體比例正常,兩手各五根手指。鏡頭:貼在列車車窗外的手機,一般主鏡頭,不是魚眼,稍微仰起,輕微晃動,車窗邊框一直在畫面下方邊緣。0 到 4 秒:列車起步加速,他貼在鏡頭旁輕鬆地跑,身體微微前傾,左右手自然前後擺動,開心地笑(嘴角上揚、嘴巴微張、牙齒正常),有點喘,頭部到臀部以下入鏡,他佔畫面約一半;背景的磁磚牆、色塊海報、白色柱子、長椅快速往後滑,有動態模糊,但他本人清楚。4 到 6 秒:列車越來越快,他漸漸落後,往畫面右側移動、變小,笑著向鏡頭揮一下手,然後離開畫面。6 到 8 秒:月台盡頭,畫面只剩被拉長模糊的牆、路人和日光燈燈條,之後進入昏暗的隧道。不要大喊大叫,不要皺眉,不要誇張的表情,動作自然。月台:白色磁磚牆、藍色色帶、色塊海報(只有抽象圖案)、白色柱子、長椅,沒有月台門,畫面中不要出現任何文字、標誌或站名。保留列車和腳步的環境音,不要字幕,不要背景音樂。
這次的教訓:AI 人物的「怪」多半來自太近、表情太極端、衣服形狀太複雜;真實影片的鏡頭可以參考,但 AI 版要把人放遠一點、表情收一點。另外,「表演」那段(P)用隔著窗框唱歌的定場圖,一次就過,因為距離和表情都在安全範圍。這仍然是單次結果。
花費與時間:點數是怎麼花的(第一輪 888 點,加碼 280 點)
| 項目 | 數字 | 備註 |
|---|---|---|
| 點數單價 | 約 NT$0.32/點 | 點數包 1,000=NT$320、1,500=NT$480、3,000=NT$960(Dreamina Basic 方案頁面 10/24) |
| Draft 480P | 9 點/秒 | 5 秒 45、15 秒 135、30 秒 270 |
| 正式 720P | 26 點/秒 | 5 秒 130、6 秒 156 |
| 參考影片的秒數也計費 | (輸出秒數+參考影片秒數)× 單價 | 4 秒輸出+4 秒預演=72 點;開場 Draft 因殘留一支 5 秒預演,從 54 點變 99 點 |
| Draft→正式轉換 | 640 點(5 秒輸出+5 秒預演、1080P) | 只有 1080P,比直接用 720P 生成(260 點)貴 2.5 倍,沒採用 |
| 排隊與生成 | 約 5–8 分鐘/支 | 可以同時排好幾支 |
最省的路線(依我的經驗):圖片免費、預演要剪短、先用 Draft 驗證提示詞(5 秒只要 45 點)、確認可行再直接用 720P 正式模型生成,不要用 Draft 轉 1080P。Zeto 那種一次 29 秒+29 秒預演,在我的帳號要約 1,500 點,所以我改成分三段:預演只用在最需要的「手機視角追車」那一段(5 秒),代價是臉要靠參考圖維持。
兩個踩雷:①提示框的參考欄會殘留上一次的素材,影片殘留會被多收點數(開場 Draft 因此從 54 點變 99 點);②我用程式貼圖時出現過重複的參考縮圖,要先刪掉重複的。送出前先看按鈕上的點數報價,和你預期的不同就先找原因。
用自己的臉,怎麼做才安全
- 先有全身定場圖,再開 Seedance。用自己的照片請 ChatGPT 生全身站姿與跑姿;第一幀用圖片鎖定,臉比較穩。
- 提示詞寫死:「全程同一張臉,圓框眼鏡一直戴著」(我的眼鏡每一幀都在)。
- 臉小就容易飄:追車那段人很小,我的結果沒飄,但這是單次結果;飄的鏡頭就別用,改用背影或手機特寫。
- 只用自己的臉。不用 Ollie、Dua Lipa 或任何名人的臉,也不用「上傳你的臉就套進去」的模板站。
- 標示:影片常駐「AI 生成影片」,IG 發文打開 AI 內容標示;畫面看起來像你真的在捷運做危險動作,所以也要寫「請勿模仿」。
- 真人臉規則:我的照片這次在 Seedance 2.5 沒被擋;官方規則我沒找到,規則可能改,請以你當天的介面為準。
風險與規則
| 項目 | 要注意什麼 |
|---|---|
| 安全 | 只示範 AI 版;別真的去貼、別真的去追。北捷有月台門,真去貼也做不到。 |
| 肖像/深偽 | 用自己的臉同意問題最小;仍要標 AI 生成,避免被誤會。不要拿別人的臉。 |
| 音樂版權 | 《Training Season》是 Dua Lipa 的歌(唱片公司為 Warner)。我們的 Reels 版本配的是官方現場版音訊,IG 可能因音樂版權把影片靜音或下架;本文內嵌的影片不含這首歌。歌詞我們不引用。 |
| 別人的影片 | Ollie、Zeto 的影片沒有授權,只引用數字、連結署名,不放影像。文案寫成致敬,不酸、不嘲諷(Ollie 10/15 公開說 AI 在拿他的內容)。 |
| 北捷 | 不實拍;成品不出現 logo、站名、可讀文字;文字裡提「台北捷運」只是描述事實,不暗示合作。商業拍攝要先向北捷申請。 |
| 平台條款 | Dreamina Basic 方案的商用條款我沒有查,請自己確認再用在商業內容。 |
常見問題
真人臉會不會被擋?
我的照片這次在 Seedance 2.5 沒被擋。但規則會變,請以你當天的介面為準。
一定要預演嗎?
不一定。靜態鏡頭或單人說話不需要;但這個梗的重點是「人要留在畫面裡、柱子要在對的時候滑過」,預演就很值得。
可以真的去北捷拍嗎?
北捷官網寫明:一般紀念性拍攝不需申請,商業拍攝要先申請。月台有門,也碰不到車窗;而且巴黎與德里都警告過,別這樣做。
可以換成品牌角色嗎?
我沒有測。預演與提示詞可以直接沿用,只要換角色圖;建議先用 Draft 驗證。
資料來源與查詢日
數字與規則查詢日為 2026 年 10 月 24–25 日;觀看數、點數價格、平台規則都會變動,以當天為準。新聞多為二手轉載,AI郵報沒有核對過後台。
- Zeto 原貼文(X,2026/10/23)
- Ollie Muhl 巴黎版 Reel(IG,2026/10/3)
- Just Jared:Ollie Muhl 回應 AI 抄他(2026/10/15)
- Le Parisien(HeadTopics 轉載):RATP 警告(2026/10/21)
- IBTimes India:德里捷運警告 phone-sticking reels(2026/9/6)
- NewsGram:德里捷運警告 phone sticking(2026/9/7)
- Newtalk:歷經 14 年,捷運月台門全數建置完成(2018/9/29)
- 臺北捷運官網常見問答:旅客可以在車站或月臺上照相或攝影嗎?
- Dreamina(CapCut):價格頁與創作介面,點數與價格取自我的帳號(2026/10/23–25)
- fal:What is Seedance 2.5(2026/8/12)