RoboJev 開放機器人成功判斷模型:95.2% 成績、每千次 0.19 美元怎麼讀?
RoboJev-27B 從機器人操作影片判斷任務是否完成。解析 268 段 SO-101 評測的 95.2% 平衡準確率、跨實驗室退步、輸入影格差異,以及 H100 每千次約 0.19 美元的計算範圍。

機器人伸手把環套到柱子上,看起來就快成功了。下一秒環掉下來,整段操作卻應該算失敗。整理大量影片時,這種結果標記往往還要靠人逐段確認。
RoboJev 想把這項工作交給開放的視覺語言模型:給它任務描述與操作影片的代表影格,讓它回傳成功或失敗的機率,而不是只替影片寫一段旁白。
作者在 2026 年 10 月 23 日於 X 公開介紹,隔日提交論文,並釋出 RoboJev-27B、推論程式與評估結果。它從既有 JEV-27B-VL 微調而來,並非全新訓練一個通用機器人。
模型在 268 段 SO-101 保留影片上達到 95.2% 平衡準確率,但換到未見實驗室與機器人時,基底模型的部分成績反而較好。這個落差是採用前必須看的重點。
每千次預測約 0.19 美元的數字,也只是指定 H100 租金與模型計算時間的換算,沒有含影片處理或服務成本,不能當成公開 API 呼叫介面的售價。
如果團隊需要的是替影片標成功與失敗,RoboJev 值得拿自己的案例驗證。若要追蹤每一步完成幾成,它的輸出就回答了另一個問題。選對判斷目標,比先比較便宜多少更重要。
RoboJev 成功機率和動作進度,為什麼不是同一件事?
RoboJev 判斷片段中的任務最終是否完成,輸出的成功機率不是機器人已完成幾成工作的進度條。
這個區別直接影響用途。機器人可能一度把環套上柱子,最後卻掉下來。前段看似接近成功,不代表整段嘗試已完成。作者的展示也用這種狀態變化說明,隨著後續畫面加入,對成功的信心可以降低。
因此,一個高成功機率不能解讀成「已完成八成動作」,低機率也不一定表示機器人完全沒有進展。模型回答的是給定任務在所見片段中是否達成,不是逐步估計每個操作階段完成多少。
這讓它較接近影片資料整理中的結果檢查器。研究者可以先依任務指令和片段產生成功、失敗的候選標記,再對不確定或高影響案例複核。它不會因為能判結果,就同時具備操控手臂或找出失敗原因的完整能力。
原始論文也將這項工作與更廣的資料標註流程區分。替影片描述人物、物件、操作過程和結果,可以是不同任務。成功偵測只涵蓋其中一層,不能把它寫成另一套完整標註引擎的重複發布。
如果資料只有模糊的任務文字,或關鍵結果剛好被遮住,模型也可能無法可靠判斷。這不是把同一片段再問一次就能保證補回的資訊。缺失影格與結果定義本身,都會限制輸出機率的意義。
要讓這個判斷可比較,必須先知道模型看到哪些影格,以及它如何從既有模型調整出來。
RoboJev: people are watching thousands of videos to label task success.
— Josef Chen (@josefchen) October 23, 2026
Now, you can grade robot data faster than you make it. 48x cheaper and 28x faster than 6 Astra.
27B parameters, open weights. pic.twitter.com/6g3gUVsIt8
十張影格、輔助視角與微調各改了什麼?
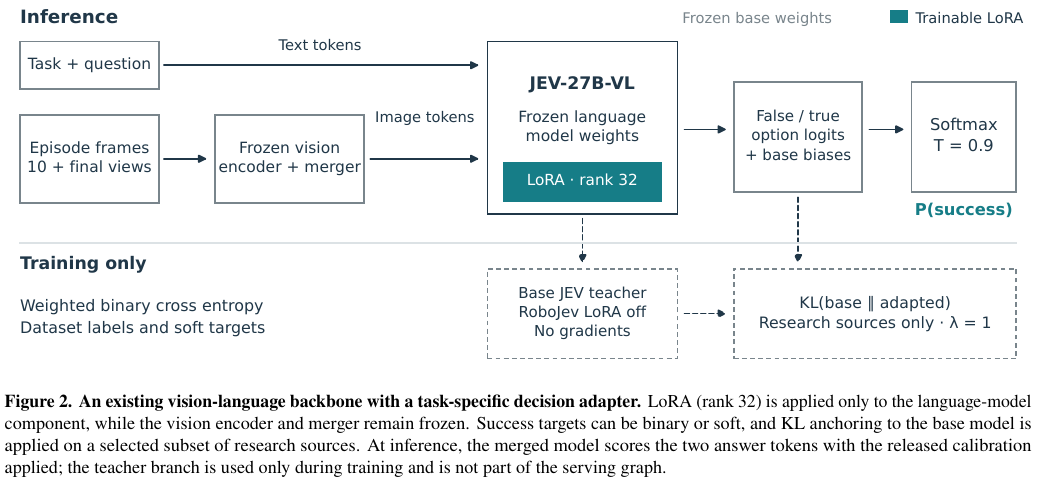
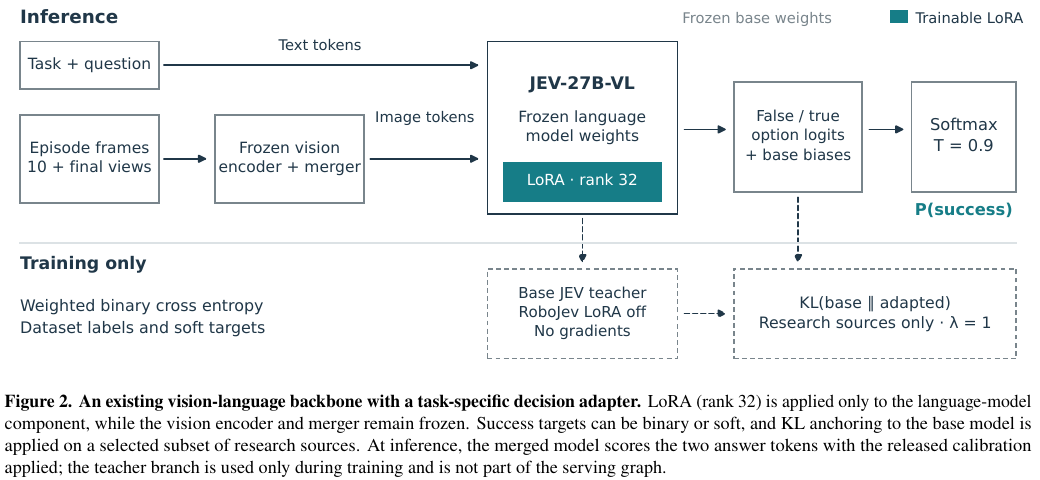
模型讀取十張均勻抽取的主要鏡頭影格,以及可取得的輔助鏡頭最後影格,再以校正後的成功與失敗分數作判斷。
十張主要影格涵蓋起點到終點,用來保留部分時間順序與結果。輔助鏡頭則只取最後影格,有助補充主要視角可能看不見的終局狀態。它沒有逐格觀看整支影片,短暫掉落或細小接觸仍可能在抽樣間隔中遺漏。
模型以 JEV-27B-VL 為基底,使用低秩轉接微調,也就是只新增較少量可訓練參數,調整語言模型部分。視覺編碼器與合併影像特徵的部分保持固定,不能把成果描述成從零訓練一個全新的視覺系統。
訓練使用 52,598 筆片段紀錄,標記包含模型教師產生的判斷與其他來源。這個數字是依資料拆分後計算的紀錄,作者並沒有將它聲稱為同樣數量、彼此獨立且完全去重的真人手工標註示範。
模型教師可能有共同盲點,從截短或修改任務取得的負例也可能帶入雜訊。研究另對部分研究資料加入約束,讓預測不要離基底模型太遠。這項約束並非套用在全部來源,不能說每一筆訓練都使用相同保護規則。
推論時,模型比較代表「成功」與「失敗」的輸出分數,再依驗證資料做校正,讓數值較適合解讀為機率。這種方式能用一次模型運算得到結果,但校正適用範圍仍與驗證資料有關,不是所有新場域的可信度保證。
訓練中的影像擴增又產生約 102,172 個樣本,這是在一輪訓練裡組織觀察的方式,不能再算成同樣多段新的操作。若希望判斷資料來源是否真的變多,應看原始片段與採集來源,而非把擴增後的數量當成新機器人經驗。
這套輸入與微調共同決定結果,因此測試不能只挑一個總分,也不能忽略其他模型看到的畫面不同。
268 段 SO-101 的 95.2%,能和哪些模型直接比?
95.2% 是 SO-101 保留資料上的平衡準確率,同輸入的基底模型比較較可對照,但與只看四張影格的 API 模型並非完全同條件。
268 段 SO-101 影片包含 111 段成功與 157 段失敗。平衡準確率會分別計算兩類判對多少,再平均,避免只猜較多的那一類就得到看似漂亮的總分。因此它不等於直接把所有判對片段除以 268。
資料依錄製時段保留,其中只有 80 段來自兩種完整未見任務,各有 40 段。其餘保留影片不能全寫成全新任務,否則就會把同機器人、不同錄製時段的測試,擴張成所有工作都從未出現過的泛化實驗。
RoboJev 的平衡準確率為 95.2%,同輸入基底模型為 88.1%。這是較接近控制影像輸入後、比較微調前後的結果。作者報告的配對差異約增加 7.08 個百分點,但仍是在這組機器人與任務分布中觀察到的優勢。
與前沿 API 模型相比,RoboJev 看十張主要影格並可加入輔助視角,對照則只有四張主要影格。因此差異可能同時包含資訊量與模型能力,不能將所有幅度都算成微調方法單獨帶來的進步。
和 Astra 的配對差異約為 1.91 個百分點,但不確定範圍包含零,不能寫成已確證勝出。兩種未見任務的 80 段子集上,RoboJev 的平衡準確率亦低於部分 API 模型,結果並非每一個分項都領先。
同機器人的優勢不保證能搬到別的場域,下一步要看未見實驗室與社群影片。
延伸閱讀:NVIDIA Flora 是什麼?機器人資料引擎宣稱低 125 倍成本與非商用授權怎麼讀
換實驗室與機器人後,微調優勢還在嗎?
在 459 段未見實驗室與機器人的影片上,RoboJev 的 AUROC 為 0.890,低於同輸入基底模型的 0.900。
AUROC 觀察模型把成功案例排在失敗案例前面的能力,會綜合不同判斷門檻,和選定門檻後的準確率不同。不能把 0.890 直接寫成 89% 影片判對,也不能與前一節的 95.2% 相減,當成泛化下降幅度。
這組資料來自八個未見領域。同輸入基底模型略高,說明專門微調不一定把同機器人的增益一起帶到外部環境。作者列出的差異不確定範圍也包含零,較合理的結論是未觀察到穩定跨場域優勢。
機率校正同樣出現落差。SO-101 的校正誤差較低,轉到外部場域後提高,表示一個看起來很有信心的分數,在不同資料上未必具有相同可信程度。部署時直接沿用同一門檻,可能改變漏判和誤判的取捨。
社群資料則有另一個限制。200 段影片由一名標註者判讀,65 段結果含糊而排除,剩下清楚的 135 段中,模型判對 126 段,準確率為 93.3%。這不是全部 200 段的成績,也沒有多名標註者的一致性估計。
作者提供逐筆結果,讀者可以查看哪些任務和判斷出現分歧。公開的 29 個項目是模型與輸入設定的組合,不是 29 種獨立架構。缺少的預測也不能當成答錯零分,配對比較必須在雙方都有結果的片段上進行。
部分不確定範圍由對既有片段反覆重抽估計而來,能反映這份樣本中的變化,卻不等於重新招募另一批實驗室後仍會得到相同差距。機器人、拍攝角度和任務一起改變時,未知的場域差異仍需要實際資料回答。
場域落差使本地驗證不可省略,而實際部署還必須把模型速度和影片前後處理拆開估算。
0.26 秒與每千次約 0.19 美元包含哪些工作?
官方數字來自單張 H100 的序列推論時間,再乘以每小時 2.69 美元的 GPU 租金,沒有計入媒體處理與服務開銷。
GPU 是處理大量平行運算的晶片,這裡是模型計算的主要資源。
論文量到的中位模型推論時間約為 0.257 秒,四捨五入為 0.26 秒。以指定租金換算,每千次預測約 0.192 美元。這個計算可以估模型運算的量級,但前提是硬體價格和工作方式接近該實驗。
影片下載、解碼、抽取影格、等待佇列和提供服務的開銷都不在其中。若資料分散在不同網站,準備十張合適畫面的時間可能相當重要。如果 GPU 經常等待資料,也不能只把實際運算秒數當成全部付費時間。
這個 27B 模型的 BF16 權重約 55GB,預期使用 80GB 級 GPU。BF16 是權重保存的數值格式,不是一般個人電腦記憶體就能直接代替顯示記憶體。模型能載入與整套服務能穩定跑起來也有差別。
作者與部分 API 的延遲比較還受到不同服務基礎設施影響。網路、供應商排程和輸入影格數都沒有完全控制,因此不宜把倍數宣傳成任何部署都會獲得的加速,更不能將計算換算價稱作官方 API 報價。
論文也估算批次處理更大公開資料目錄的可能成本,但並未把整個目錄都重新標記完成。模型速度可以支援規模估算,實際資料整理仍取決於片長、取樣、來源可用性,以及哪些結果需要人工複核。
是否划算取決於資料流與硬體利用率,最後還要確認權重、程式和影片各自的使用條款。
公開工件適合怎麼用,哪些效果還沒測?
作者公開模型、推論程式與逐筆評測,方便研究成功判斷。接到機器人策略訓練後是否能提升學習,則尚未量測。
模型和評估內容可從官方網站取得,這是截至 2026 年 10 月 27 日的公開狀態。公開資料有助查出錯在哪裡,而不是只看一張排名表。同時,作者也說明建立發布工件時曾檢視測試集,不能把它描述成完全未看過結果的前瞻盲測。
權重與程式採 Apache 2.0,但訓練及評測影片有不同來源條款。模型開放不會把所有第三方鏡頭內容一起變成可任意重製素材,缺少授權的來源也不能因為出現在公開目錄就自動視為無限制使用。
對已有成功與失敗定義的資料團隊,它提供一個能自行驗證的起點。對需要逐步因果解釋、細緻動作進度或安全監控的工作,則還需要其他設計與證據,不能只因為能輸出機率就延伸成所有判斷工具。
因此最穩妥的起點是用自己的保留影片核對成功標記,並把模型授權與各影片來源條款分開處理。
延伸閱讀:Cosmos3-H-Embodied-Nano 開放手術機器人研究模型:同時預測動作與影片,二點四秒能說明什麼?
常見問題 FAQ
RoboJev 的 95.2% 代表所有機器人影片都判對九成五嗎?
不是。這是 268 段 SO-101 保留影片的平衡準確率。其他實驗室與機器人的結果不同,部分指標甚至低於基底模型。
每千次 0.19 美元是 API 售價嗎?
不是。這是指定 H100 租金與模型計算時間的換算,沒有包含媒體處理、閒置、排程及服務成本。