Sage-A1.5 是什麼?35B 開放權重模型對上 Kimi-K3,基準勝負與授權怎麼看
Sage-A1.5 是上海人工智慧實驗室釋出的 35B 開放權重智能體模型,啟用參數約 3B。本文依模型卡與技術報告,整理它在 22 項基準中勝過 Kimi-K3、GLM-5.3 與 GPT-5.6-sol 的項目、輸掉的項目、Apache-2.0 授權與自架條件。

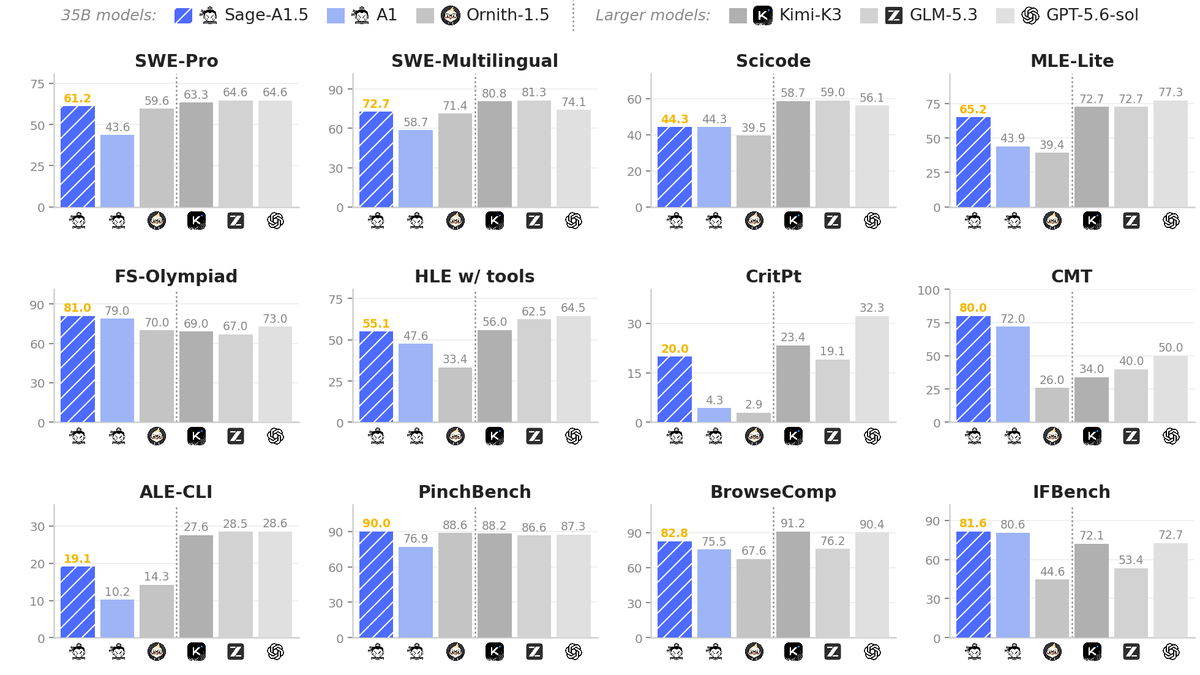
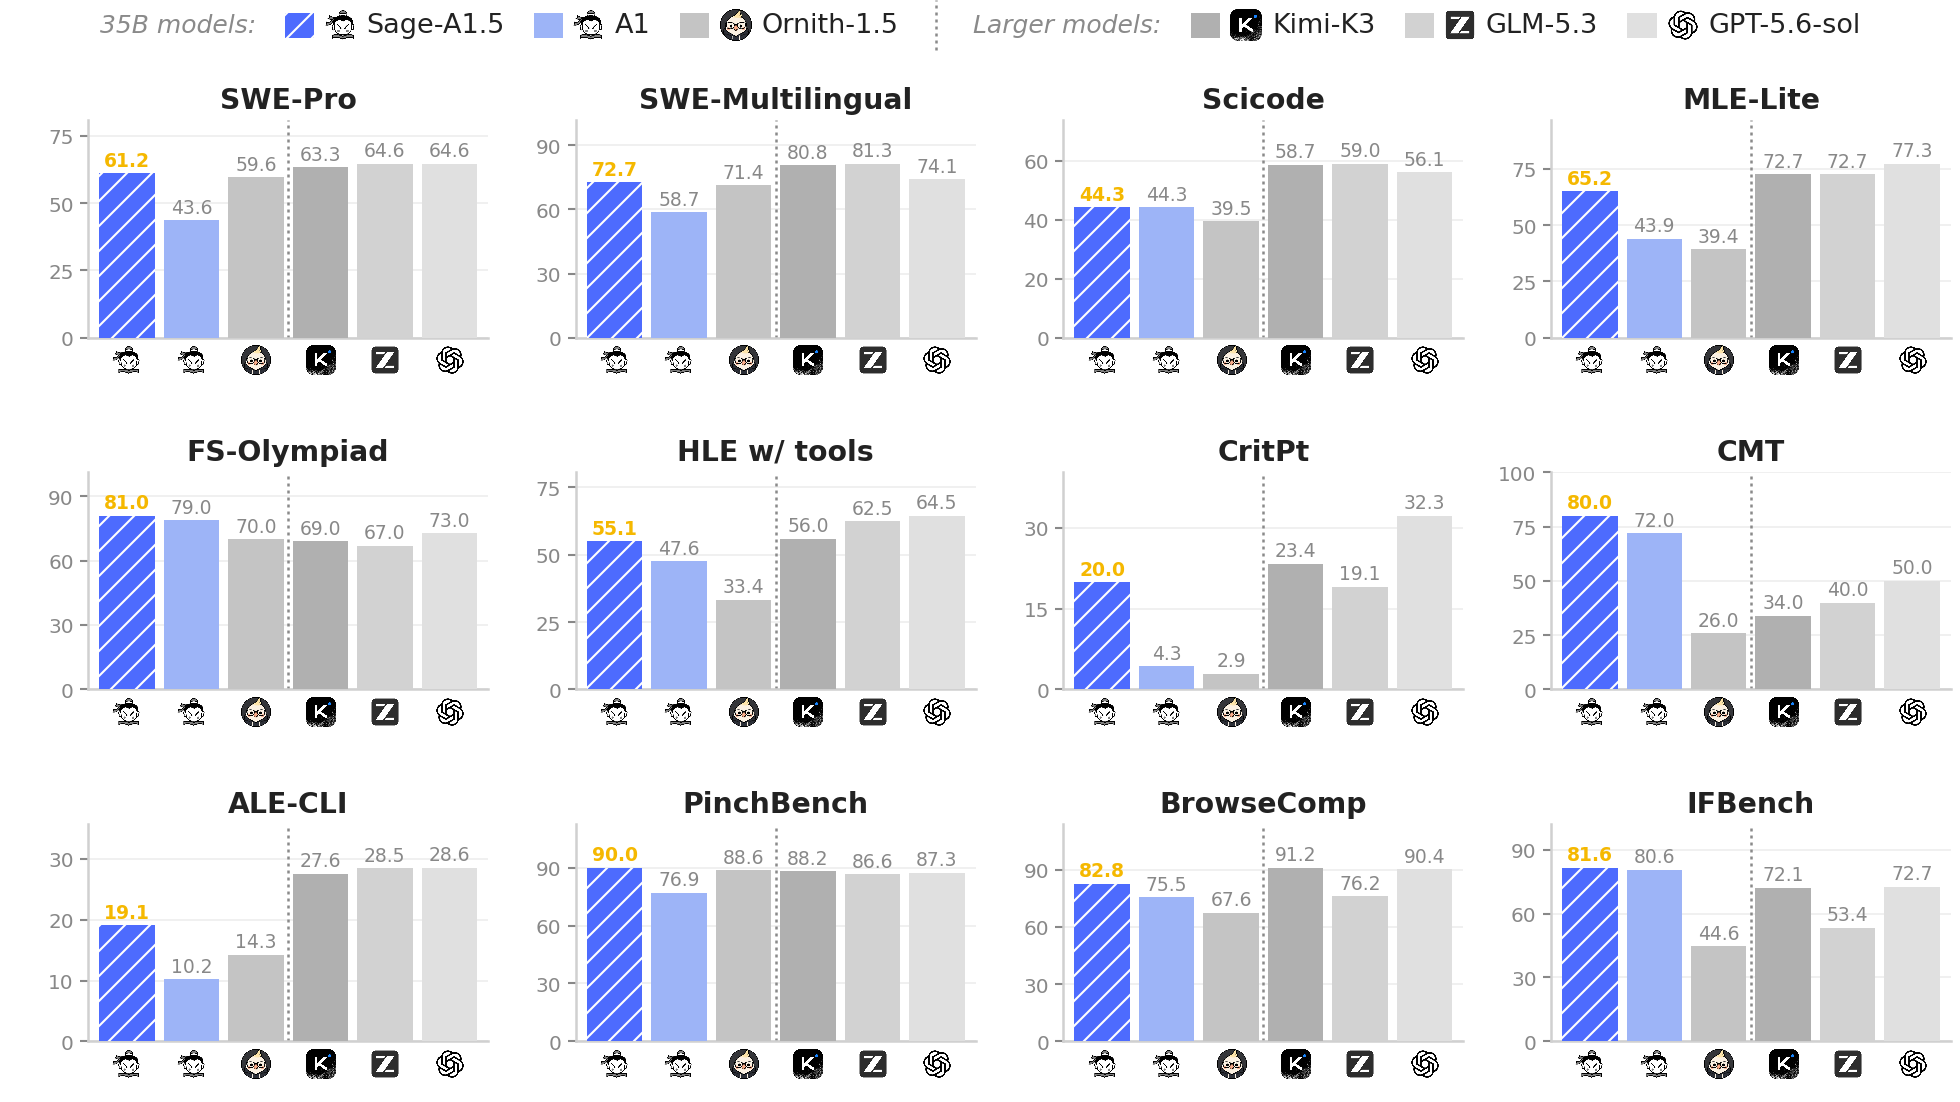
Sage-A1.5 在 2026 年 10 月 21 日下午(台灣時間)被一則中文貼文推上 X 熱門,貼文說這個只有 35B 的模型在多個指標上壓過 Kimi-K3、GLM-5.3 和 GPT-5.6-sol。
這句話很容易讓人以為,一個實際運算只用到約 3B 參數的小模型,已經在各方面追上規模大得多的模型。參數是模型內部可調整的數值,數量愈多通常愈大也愈耗資源,所以「小贏大」值得回頭查證。
回到官方模型卡與技術報告,這些數字確實存在,但範圍比貼文窄。模型卡的比較表有 22 項基準,Sage-A1.5 同時勝過三個大模型的有 8 項,三個都輸的有 9 項,其餘 5 項介於中間。
貼文列出的 SWE-Bench Pro 61.2 與 BrowseComp 82.8,沒有一項同時贏過三個大模型,前者還是三個都輸。這個差別會影響用法,因為它的勝場集中在搜尋、科學問答與指令遵循,寫程式的成績仍落後。
Sage-A1.5 以 Apache-2.0 釋出權重,又擅長多步驟查資料與科學問題,所以對想自架的團隊值得測試。如果主要需求是修大型程式庫,現有證據不支持拿它取代前沿模型。
要判斷這個結論站不站得住,得先從它是什麼模型、從哪裡來看起。
Sage-A1.5 是什麼?從 Agents-A1 延伸出來的專家混合模型
Sage-A1.5 是上海人工智慧實驗室的 Sage-A1.5 團隊釋出的 35B 專家混合模型,權重放在 Hugging Face 的 InternScience 帳號下,目標是執行多步驟的智能體任務。
智能體是能自己規劃步驟、呼叫搜尋或程式工具、再依結果調整做法的模型。專家混合(MoE)把模型拆成許多小專家,每個詞元只啟動其中一部分。詞元是模型處理文字的單位。
所以總參數是 35B,實際運算只動用約 3B。依官方模型卡,它以 Qwen3.6-35B-A3B 為底座,這個底座在 Hugging Face 上同樣標示 Apache-2.0。
技術報告把它定位成前一代 Agents-A1 的後續版本。Agents-A1 的 GitHub 倉庫建立於 2026 年 6 月 23 日,報告也拿 Agents-A1 與 Ornith-1.5 當作同級對照。
時間點需要分清楚。Hugging Face 倉庫在 10 月 15 日建立,技術報告 10 月 20 日上傳 arXiv,X 貼文 10 月 21 日才讓它被更多人看到。它不是當天才發布的新聞,而是公開約一週後被中文圈熱傳。
原始權重檔共約 72 GB,採 BF16 格式,也就是每個參數占 2 位元組。這個大小是我把 Hugging Face 檔案清單加總得到的,其中約 1.7 GB 是多詞元預測用的檔案,後面談自架條件時會用到。
了解來歷之後,下一個問題是它多出了哪些能力,因為這些能力決定後面的成績怎麼讀。
Sage-A1.5 新增三項能力:子代理分工、驗證模式與科學探索
技術報告把這次升級歸納成三項:任務分工、中途驗證與開放式科學探索。
任務分工稱為 Agentic Orchestration。模型可以呼叫名為 spawn_subagent 的工具,把互相獨立的子問題交給多個子代理並行處理,每個子代理都有自己的上下文與工具。上下文是模型單次工作能看到的資料範圍。
子代理完成後回傳答案、狀態、證據與未解決問題四個欄位,由主代理整合。模型卡寫明批次大小與回合上限是執行端設定,預設每批最多 5 個任務、每個子代理最多 20 回合。
因為子代理看不到主對話,所以每項任務都要寫成自足的描述。真正執行子任務的是你自己的框架,模型只負責決定何時派工。
論文表 4 顯示,啟用分工後 BrowseComp 從 81.7 升到 82.8,DeepResearch Bench II 從 43.7 升到 47.5。BrowseComp 只多 1.1 個百分點,所以這項功能對報告型任務的幫助比對單題搜尋明顯。
驗證模式稱為 Verification Mode,預設關閉。啟用方式是在請求裡傳入 chat_template_kwargs 的 verification 為 true,而且必須有非空的系統訊息,否則伺服器會回 HTTP 400。
開啟後,模型會在推理途中停下來,複查已確認的事實與失敗的路徑,再改變方向。這段自我檢查寫在 reasoning_content 裡,沒有另一個批評模型參與。
論文表 5 的驗證教師模型在 BrowseComp 得到 81.0(一般模式)與 85.5(驗證模式)。在兩種模式都有產出答案的成對題目中,平均輸出詞元從 23,245 降到 21,962。
但這是訓練用的教師模型,不是釋出的 Sage-A1.5 本體,所以不能直接當成開啟驗證後的成績。
第三項是科學探索。報告附了多個案例,例如用公開的小鼠腦區解碼資料重做分析,結果與先前研究的結論一致。報告自己也說,這些案例都在計算模擬與歷史資料重放中完成,沒有做實際的物理實驗。
能力清單聽起來很完整,但模型好不好用,最後還是要回到基準表。
Sage-A1.5 基準成績:哪些項目勝過 Kimi-K3、GLM-5.3 與 GPT-5.6-sol?
以模型卡的 22 項基準來看,Sage-A1.5 的強項集中在搜尋、科學推理與指令遵循,而不是軟體工程。
以下我把貼文提到的項目與幾個落後的項目放進同一張表,數字都取自模型卡的比較表,分數越高越好。
| 基準 | 測什麼 | Sage-A1.5 | Kimi-K3 | GLM-5.3 | GPT-5.6-sol | 對三個大模型 |
|---|---|---|---|---|---|---|
| IFBench | 遵守多重限制的指令 | 81.6 | 72.1 | 53.4 | 72.7 | 全勝 |
| FrontierScience-Olympiad | 奧林匹亞等級科學題 | 81.0 | 69.0 | 67.0 | 73.0 | 全勝 |
| CMT | 凝態物理專家題 | 80.0 | 34.0 | 40.0 | 50.0 | 全勝 |
| PinchBench | 代理執行日常任務 | 90.0 | 88.2 | 86.6 | 87.3 | 全勝 |
| GAIA | 網路搜尋助理題 | 95.1 | 92.2 | 92.2 | 88.3 | 全勝 |
| BrowseComp | 難找答案的網頁問題 | 82.8 | 91.2 | 76.2 | 90.4 | 只勝 GLM-5.3 |
| SWE-Bench Pro | 大型程式庫修改 | 61.2 | 63.3 | 64.6 | 64.6 | 全輸 |
| HLE w/ tools | 專家題加工具 | 55.1 | 56.0 | 62.5 | 64.5 | 全輸 |
| ALE-CLI | 真實工作任務 | 19.1 | 27.6 | 28.5 | 28.6 | 全輸 |
表中 BrowseComp 的 82.8 是啟用子代理分工的結果,不分工時是 81.7。前五列是勝出的項目,貼文提到的 IFBench、FrontierScience-Olympiad、CMT 與 PinchBench 都在其中。
前文的 8 項是我逐列比對模型卡表格的結果,規則是 Sage-A1.5 的分數高於三個大模型。除了表中的五項,還有 XBench-DS-2510、FrontierScience-Research 與 OmniDocBench。
OmniDocBench 的 GLM-5.3 沒有成績,因為它是純文字模型,所以只拿另外兩個模型比。
輸給三個大模型的 9 項,是 DeepResearch-Bench2、MLE-Lite、SciCode、SWE-bench Pro、SWE-bench Multilingual、HLE w/ tools、ALE-CLI、VitaBench 與 ChemCOTBench。
BrowseComp、AA-LCR、HiPhO、CritPt 與 MatTools 這 5 項介於中間。BrowseComp 與 DeepResearch-Bench2 不論取分工前或分工後的分數,歸類都一樣。
貼文把 SWE-Bench Pro 61.2、BrowseComp 82.8 與 IFBench 81.6 放在同一串「壓過」的敘述,但前兩項都落後 Kimi-K3 與 GPT-5.6-sol 約 2 到 8 個百分點。技術報告自己的寫法比較謹慎,說在這兩項是「具有競爭力」。
另外,模型卡也主張在同為 35B 的模型中,它在大部分項目排第一。這個說法有例外,因為 Agents-A1 在 GAIA 拿到 96.0,比 Sage-A1.5 的 95.1 高,HiPhO 與 MatTools 也是 Agents-A1 較高。
還有一點容易漏掉,對照組裡的 OpenAI 模型是 GPT-5.6-sol。依 OpenAI API 更新日誌,GPT-6 Sol 在 2026 年 9 月 22 日發布,GPT-6.1 Sol 在 9 月 29 日發布,所以這張表不是與目前最新的 OpenAI 模型比。至於這些分數是在什麼條件下測出來的,才是下一個要確認的地方。
延伸閱讀:Kimi K3 開放權重下載:2.8 兆參數、100 萬 Token,真的能在本機執行嗎?
這些分數怎麼來的?誰測的、什麼條件、哪裡要打折
這些分數都是研究團隊自己公布的資料,我查詢時沒有看到第三方複現,所以每一項都要連同測試條件一起讀。
最需要留意的是對手的數字。技術報告表 1 說明,為求公平,對手分數優先採用原始技術報告,沒有公布的項目才用同一套協議自行評測。
這表示同一列裡可能混著對手自己的數字與 Sage 團隊代測的數字。表格說明只交代這個原則,沒有逐列標出哪些是哪一種。
SWE-Bench 系列用 mini-SWE-agent 框架,溫度 1.0、top-p 0.95,上下文 200K,開自動壓縮,全程離線並限制能看到的 Git 歷史。框架與參數不同時,同一個模型的分數就會不同,所以直接與對手原報告相比要保留空間。
BrowseComp 加了重試機制。當代理超過 300 次工具呼叫或用完上下文,就清掉累積的內容從頭再跑,最多 5 輪。這讓分數包含了重新嘗試的機會,與只跑一次的設定不同。
PinchBench 只有 23 項任務,每項跑 5 次,並由 DeepSeek-V4-Flash 擔任 LLM 評分者。LLM 評分者是用另一個模型來打分數,所以評分標準會受那個模型影響。
CritPt 則是把解答送到 Artificial Analysis 做官方評測,是報告中少數由外部單位評分的項目。
技術報告的限制段也承認幾件事。分工與驗證的訓練仍集中在搜尋與研究整合,超長軌跡會累積大量上下文負擔,而且合併後的單一模型還沒有完全保留每位領域教師的巔峰表現。
最後一點可以用數字佐證。搜尋教師模型在 BrowseComp 得 85.5,釋出的 Sage-A1.5 是 81.7,這 3.8 個百分點的落差,和報告所說合併後沒有完全保留教師表現相符。
分數有了條件,下一步就是看自己能不能把它跑起來,以及授權允不允許用在工作上。
延伸閱讀:Prime Agent 是什麼?ARC-AGI-3「95.5%」背後,AI 能力開始從模型轉向 Harness
自己部署 Sage-A1.5:授權、硬體與兩個選用模式
授權方面,模型卡標頭與 Hugging Face 標籤都寫 Apache-2.0,GitHub 上的 Agents-A1 倉庫也是 Apache-2.0。Apache-2.0 是常見的寬鬆授權,允許商業使用與修改,但要保留授權與版權聲明。
但我在 10 月 21 日查看 Hugging Face 倉庫的檔案清單,裡面沒有獨立的 LICENSE 檔案,授權只出現在模型卡標頭。所以要商用的話,建議把當天的授權頁面存檔,並一起確認底座模型的授權條款。
硬體方面,主模型卡的 vLLM 範例標示為單張 GPU、262,144 詞元上下文,沒有列出顯示卡型號或顯存門檻。
原始權重檔約 72 GB,所以用 BF16 載入時,單卡顯存必須大於這個數字,再加上上下文的快取空間。這是我依檔案大小推算,並不是官方規格。
主模型卡沒有提到的是,同一個 Hugging Face 帳號在 10 月 21 日另外放出四個量化版本。量化是把數值壓成較少位元,換取較小的檔案。
FP8 版約 39 GB,GGUF 格式的 Q4_K_M 約 22 GB、Q8_0 約 38 GB、F16 約 71 GB。GGUF 是 llama.cpp、Ollama 與 LM Studio 這類本機工具使用的格式。
這幾張卡片自己給了顯存參考。Q4_K_M 說單張 24 GB 的 GPU 在中等上下文長度下可以舒適服務,Q8_0 建議單張 48 GB。F16 則建議兩張 48 GB、單張 96 GB,或至少 96 GB 統一記憶體的 Apple 晶片 Mac。
代價是準確度。量化卡片註明所有基準分數都是用原始 BF16 權重測的,量化版只說會犧牲少量準確度,沒有公布量化版的基準成績,所以前面那張表不能直接套用到 Q4_K_M。
它同時是視覺語言模型,所以官方提供「只跑文字」的選項,用 --language-model-only 參數跳過視覺編碼器,把顯存留給 KV 快取。KV 快取是模型記住前文計算結果的暫存區。
服務框架有 SGLang 與 vLLM 兩種範例。兩者都有選用的多詞元預測(MTP)設定。這是讓模型一次預測好幾個後續詞元、再由主模型驗證的加速做法。
官方建議的取樣參數是 temperature 1.0、top_p 0.95、top_k 20、min_p 0、presence_penalty 1.5 與 repetition_penalty 1.0。如果不照建議設定,分數可能與卡片上的數字有落差。
子代理分工需要註冊工具,權限要自己收斂。模型卡說明子代理沒有固定工具組,預設繼承主代理的全部工具,可以包含程式執行與內部介面,所以要在你的框架裡限制它能用什麼。
安裝時建議固定版本,先在隔離環境測試,再接上內部資料。卡片的安裝範例用 uv 建立虛擬環境,這是比直接裝在系統層更容易回復的做法。
能不能跑只是第一關,值不值得跑,還要看你的工作屬於哪一類。
適合誰、不適合誰:導入前先做這幾項檢查
我的判斷是,Sage-A1.5 適合已經有自己的代理框架、想在內網跑搜尋與科學問答流程的研究團隊,也適合想拿開放權重模型做微調或對照實驗的開發者。
它不適合想直接取代前沿模型來修程式的工程團隊,也不適合只想用現成聊天介面的人。因為它在 SWE-Bench Pro 與 ALE-CLI 都輸給三個大模型。
硬體也是門檻。原始版本需要約 72 GB 以上的顯存,要用量化版才能放進單張 24 GB 的卡,而量化版的準確度缺少官方數字。
導入前可以先用自己的 20 題真實任務做小測試,題目要涵蓋查資料、整理報告與一兩個程式修復。同一批題目也交給你現在使用的模型,這樣比較才有意義。
接著分別記錄開與不開驗證模式、開與不開子代理分工的結果。因為這兩項功能會增加輸出量與回合數,所以要把成本與延遲一起記下,而不只看答對率。
最後把授權頁面、模型版本與框架版本存檔。開放權重模型更新很快,今天的分數換一個框架版本就可能不同。
Sage-A1.5 常見問題
Sage-A1.5 真的壓過 Kimi-K3 了嗎?
在 22 項基準中,它同時勝過 Kimi-K3、GLM-5.3 與 GPT-5.6-sol 的有 8 項,主要是搜尋、科學與指令遵循。程式修復與真實工作任務仍落後,所以只能說部分項目勝出。
Sage-A1.5 可以商用嗎?
模型卡與標籤標示 Apache-2.0,原則上允許商用。但倉庫沒有獨立 LICENSE 檔,建議存檔授權頁面,並由法務確認底座模型與使用情境。
跑 Sage-A1.5 需要多少顯存?
主模型卡沒有給門檻,只提供單 GPU 的 vLLM 範例。原始 BF16 權重約 72 GB,所以顯存要大於這個數字,另需預留 KV 快取。量化版的卡片有參考值:Q4_K_M 約需單張 24 GB,Q8_0 約需單張 48 GB,但量化版沒有公布基準分數。
驗證模式與子代理分工要怎麼開?
驗證模式靠 chat_template_kwargs 傳入 verification 為 true,並提供非空系統訊息。子代理分工要在你的框架註冊 spawn_subagent 工具,並自行執行子任務。
Sage-A1.5 和 Qwen3.6-35B-A3B 差在哪?
Sage-A1.5 以後者為底座,再用多領域監督微調與強化學習訓練。
報告的表 3 與表 5 拿 Qwen3.5-35B-A3B 當未訓練基線,MLE 那張表才用 Qwen3.6-35B-A3B。這些表比的是中間的教師模型,例如搜尋教師的 BrowseComp 是 85.5,基線是 61.0,但教師不是釋出的 Sage-A1.5。
先用自己的任務測,再決定要不要換
Sage-A1.5 的價值在於,一個約 3B 啟用參數的開放權重模型,在搜尋、科學推理與指令遵循上可以和規模大得多的模型同場比較。這是值得追蹤的進展,也讓自架代理的選擇變多。
但貼文的「壓過」只在 8 項基準成立,程式修復仍有明顯差距,而且所有分數都是團隊自己公布的。如果你的工作偏研究與資料搜尋,可以排進測試名單。
想持續追蹤開放權重與智能體模型的新進展,可免費訂閱 AI 郵報,引用數字時再回到官方模型卡與技術報告核對。
資料來源
- Sage-A1.5 模型卡(Hugging Face):https://huggingface.co/InternScience/Sage-A1.5
- Sage-A1.5 技術報告(arXiv 2610.28578):https://arxiv.org/abs/2610.28578
- Agents-A1 專案與評測框架(GitHub):https://github.com/InternScience/Agents-A1
- Sage-A1.5 FP8 版(Hugging Face):https://huggingface.co/InternScience/Sage-A1.5-FP8
- Sage-A1.5 Q4_K_M GGUF 版(Hugging Face):https://huggingface.co/InternScience/Sage-A1.5-Q4_K_M-GGUF
- Sage-A1.5 Q8_0 GGUF 版(Hugging Face):https://huggingface.co/InternScience/Sage-A1.5-Q8_0-GGUF
- Sage-A1.5 F16 GGUF 版(Hugging Face):https://huggingface.co/InternScience/Sage-A1.5-F16-GGUF
- Qwen3.6-35B-A3B 模型頁(Hugging Face):https://huggingface.co/Qwen/Qwen3.6-35B-A3B
- OpenAI API 更新日誌:https://developers.openai.com/api/docs/changelog
- X 貼文(中文轉述,熱度線索):https://x.com/NFT_Chen/status/2112825844305682477