Swarms-RS 是什麼?Rust AI 代理框架喊快 400 倍,真正加速的是哪一段?
Swarms-RS 在 X 分享 Rust 與 Python 代理框架的效能比較。本文拆解啟動時間、框架開銷與模型等待的差別,介紹多代理流程、工具整合及選型方式,避免把 400 倍誤讀成 AI 回答速度。

「Rust 做的 AI 代理框架,比 Python 框架快一百到四百倍。」Swarms-RS 開發者在 X 分享的效能比較,很容易讓人聯想到 AI 回答也能快幾百倍。實際上,框架啟動、記憶體使用、任務協調與大型語言模型生成,是不同的工作階段,不能用一個倍數把它們全部包在一起。
Swarms-RS 是用 Rust 開發的多代理框架,目標是降低協調多個 AI 工作單位的額外負擔。它安排任務、串接模型與工具,讓開發者用不同方式組合代理。模型是否聰明、回覆需要多久,仍會受到所選服務、網路與輸出長度影響。
這則消息值得追蹤,因為 AI 應用正在從一次問答變成多步工作。當一個任務需要叫用許多代理,周圍程式的成本就可能變得明顯。本文先解釋效能數字該怎麼看,再整理 Swarms-RS 提供哪些能力,最後說明什麼團隊值得試用,什麼情況應先找出真正的瓶頸。
AI 代理框架做什麼?用餐廳廚房理解
大型語言模型可以理解輸入並生成內容,代理框架則安排它如何和工具、記憶與其他工作單位合作。以研究報告為例,一個代理搜尋資料,一個整理表格,另一個檢查來源。框架負責決定執行順序、傳遞成果,以及處理失敗或逾時。
可以把模型想成廚師,框架則是廚房的派單與交接系統。派單更快,有助於減少等待與溝通負擔。但一道需要燉一小時的菜,不會因派單系統快四百倍,就在幾秒內煮好。AI 模型生成與外部工具操作,也有自己不能直接省略的時間。
Python 在 AI 生態中很普遍,因為模型、資料處理與開發工具豐富,寫原型也方便。Rust 的特色則包括較低的執行負擔與明確的記憶體管理方式,適合需要控制資源、處理大量併發工作的系統。兩種語言各有優勢,選擇應由工作需求決定。
Swarms-RS 的消息正好落在兩者交界。它改善的是代理周圍的協調層,使用的模型仍由開發者選擇與接入。了解這個定位,才能判斷公開的效能比較和自己的應用是否相關。
快 100 到 400 倍,先問比較了什麼
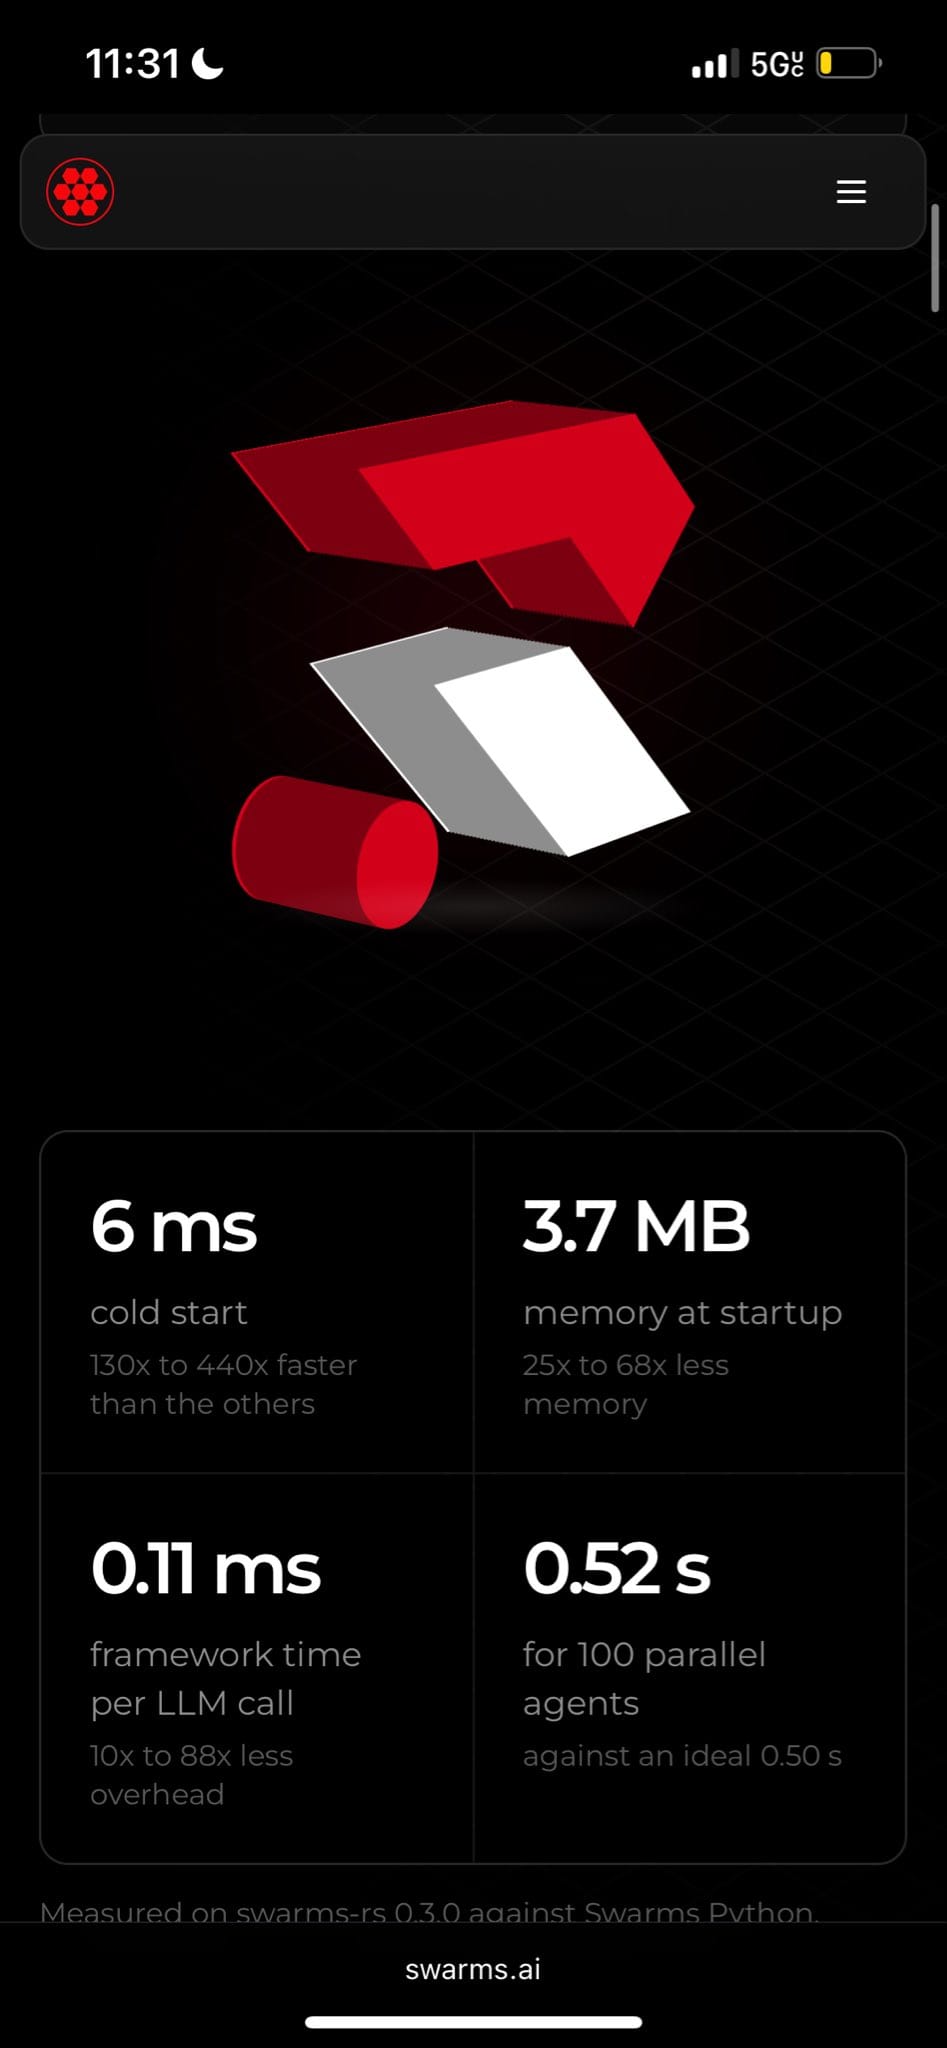
官方儲存庫與開發者分享的測試,強調框架啟動與執行開銷等指標。這些結果由專案方提出,評估時應查看測試環境、版本與操作內容。本文沒有在相同硬體上重跑,因此不把它當成獨立驗證的通用排名。
冷啟動指一個程式從尚未執行到可以接受工作的時間。如果服務會頻繁建立新執行環境,這個指標可能影響使用者等待。若程式長時間常駐,啟動只發生一次,相同的改善對每次問答就可能比較不明顯。
框架開銷指安排代理、傳遞狀態等額外時間,通常和模型生成分開測量。假設原本協調需要一百毫秒,模型生成需要五秒,即使協調降到一毫秒,整體仍接近五秒。這是示意計算,目的是說明倍數很大,不一定等於端到端等待大幅下降。
記憶體也要看範圍。框架本身占用較少,不代表整個 AI 應用都只需要少量記憶體。對話歷史、工具結果、資料庫連線,以及自行運行的模型,會另外使用資源。若模型由遠端服務提供,則本地框架與遠端運算更應分開看。
| 指標 | 說明 | 對使用者的可能影響 |
|---|---|---|
| 冷啟動 | 程式開始到能處理工作的時間 | 新環境啟動時的等待 |
| 協調開銷 | 安排代理與傳遞成果的成本 | 多次短任務累積的額外延遲 |
| 框架記憶體 | 框架自身占用的資源 | 同機可承載的服務數量 |
| 模型生成 | 模型產生答案的時間 | 長回覆通常仍需等待 |
| 完整任務延遲 | 從交辦到驗收完成 | 最接近實際工作體驗 |
因此,閱讀「快四百倍」時,最有用的追問是:哪一項操作、哪個版本、多少工作量,以及有沒有真的呼叫模型。把這些條件寫清楚,比直接以語言名稱判定所有 Python 應用都慢,更能幫助技術選型。
Swarms-RS 提供哪些代理組合方式?
官方文件示範了代理、模型供應商、工具與多種工作流程。模型接入包含不同服務及透過 OpenRouter 等方式串接,使用時仍需要對應帳號與憑證。框架支援某種供應商,不代表供應商所有模型與功能都具有相同的接入條件。
順序流程讓工作一個接一個進行,例如先找資料,再整理重點,最後檢查引用。它比較容易理解,也能清楚追蹤哪一步失敗。缺點是後面的工作要等待前一步,如果其中某個工具慢,整個任務就會受到影響。
並行流程讓多個工作同時進行,例如分別查產品規格、發布時間與研究文件。這可能縮短獨立工作的等待,但要注意服務的速率限制,也需要把結果重新整合。多叫幾個代理並不保證答案更準確,若它們都引用相同錯誤來源,錯誤也可能一起放大。
圖形流程把任務表示成節點與連線,讓某些工作能在條件滿足後才執行。路由流程則根據輸入選擇不同處理路線。這些能力有助於建立較複雜的應用,但真正的規則仍要由開發者決定,框架不會自動知道公司業務的完成標準。
工具整合則讓代理不只生成文字,也能查資料或執行其他操作。MCP 是讓 AI 應用與工具交換資訊的一種協議,支援 MCP 有助於接入現有工具。能接入與能安全使用仍是兩件需要分別驗證的事,尤其是具有寫入或付款能力的工具。
什麼情況值得評估 Rust 代理框架?
如果系統同時處理大量短任務,框架協調的比例可能較高。例如許多簡短分類請求,需要快速建立工作、調用服務並回傳結果。降低額外開銷,有機會提高吞吐量,也就是同一段時間可完成的工作數,但效果仍要用實際流量測試。
另一種情況是資源受到限制。某些服務希望在小型伺服器上部署多個工作單位,或需要更可預測的記憶體使用。這時候框架體積、常駐資源與尖峰行為都值得量測。不過,如果主要資源被資料處理或模型占用,單換框架未必解決問題。
對原本已有 Rust 經驗的團隊,Swarms-RS 也可能更容易融入既有服務。開發者可以在熟悉的工具鏈中安排代理、處理錯誤與監控運行。對完全以 Python 建立資料流程的團隊,則要把遷移與學習成本一起計算。
最不適合只看倍數就搬遷的情況,是目前應用主要在等待遠端模型,且每天只有少量長任務。若使用者一次請 AI 寫幾千字,模型生成可能占絕大部分時間。這時先調整輸出需求、資料搜尋與工具呼叫次數,可能比重寫整個框架更有效。
做一個有意義的小測試,應量測哪些項目?
先選一個原本就在使用的任務,不要只跑空白代理。把相同模型、相同提示與相同工具條件保留,比較新舊框架完成整項工作的時間。若某一方用了不同的模型或更短的回答,結果就很難歸因於框架效能。
再分段記錄時間:啟動、模型等待、工具執行、流程整合與驗收。這可以看出改善發生在哪裡,也避免用整體平均掩蓋少數很慢的請求。對多人同時使用的服務,除了平均值,也應看較慢的一批任務是否有明顯退步。
接著量測實際資源與錯誤。快速回傳錯誤不能算成功完成,低記憶體也不能以丟失工作狀態為代價。應檢查逾時、重試、服務限制、模型回應格式不同,以及某個代理失敗後整個流程會怎麼處理。
最後評估開發維護成本。團隊是否有足夠的人能修改 Rust 程式、閱讀錯誤、處理相依套件,以及理解現有工具整合方式?當效能收益有限,維護能力卻明顯下降,可能並不是值得採用的改動。這個判斷應用實際工作量與人力條件支撐。
測試結果也應附上環境資訊,包含處理器、作業系統、框架版本、併發數與執行次數。若只有一張倍數圖,讀者無法知道差異是否來自不同預設功能,例如其中一方開啟較完整的紀錄,另一方只做最少工作。對自己的服務進行比較時,可以把必要功能先對齊,再分開測量新增功能的成本。
另一個容易忽略的條件是網路連線是否已建立。重複使用連線與每次重新連線,可能產生不同的延遲。如果應用平常使用常駐服務,測試也應包含常駐狀態,讓結果反映真實使用方式。這些條件並不否定低開銷框架的價值,而是讓數字能對應到實際工作。
Rust 的記憶體安全,會讓 AI 行動自動安全嗎?
Rust 的所有權與型別系統能減少某些程式層面的記憶體錯誤,這是語言設計帶來的優點。但它不能自動防止代理讀錯資料、誤解使用者要求,或在權限過大的工具中做出不適當操作。程式安全與業務行為,需要不同的控制方式。
假設一個代理可以修改客戶資料,真正要檢查的是它是否鎖定正確對象、是否只修改允許的欄位,以及完成後是否讀回驗證。框架使用 Rust,不會替代這些規則。選型時如果只看執行速度,可能忽略決定結果可靠性的其他條件。
多代理流程還需要防止重複操作。當兩個工作同時處理相同任務,重試與併發控制會影響外部結果。這類問題應由應用設計、操作識別與服務端機制處理,不能單靠增加代理數量或降低協調時間解決。
常見問題:一般人需要把 Python 全部換掉嗎?
Swarms-RS 可以讓 ChatGPT 回答快四百倍嗎?
不能根據框架比較做這個推論。模型生成由模型服務與任務內容決定,框架主要影響安排與協調的開銷。對使用者有感的提升,應以完整任務從開始到正確完成的時間衡量,而不是套用某一項微型測試的倍數。
它是否免費,也不用支付模型費用?
開源框架與模型服務費用是不同項目。即使能取得程式碼,使用遠端模型、工具或雲端運算仍可能需要付費。正式使用前應查看儲存庫的授權與模型供應商條件,不能把「可以下載」直接理解為所有使用成本都為零。
不會 Rust 的人適合先試嗎?
若目標是學習,可以從官方文件與小型示例了解代理結構。若目標是立即改善正式服務,應先由能維護工具的人評估。Python 生態中的現有方案可能已經足夠,選工具的依據應是需求與證據,而不是熱門貼文裡的最大倍數。
結語:代理變多,協調成本確實值得看
Swarms-RS 的話題反映了 AI 應用的變化:當任務包含更多代理與工具,框架本身的資源使用開始影響系統規模。Rust 提供了值得評估的實現路線,專案公開的效能比較也提供了測試方向。
真正有用的下一步,是量測自己應用的瓶頸。把啟動、模型等待、工具時間與正確完成率拆開,才能判斷低開銷框架是否帶來實際收益。當比較條件清楚,「快四百倍」就能從吸引點擊的數字,變成幫助開發決策的一項證據。