tiny.london 是什麼?AI 畫出整個大倫敦等距像素地圖,做法與授權限制
tiny.london 是 Boris Starkov 做的大倫敦等距像素地圖,作者稱由程式代理建資料集、微調 Qwen LoRA 並整張大圖一起生成。本文整理製作流程、接縫問題的解法、31 GPU 小時的算力,以及 Google 圖資與 Qwen 模型的授權限制。

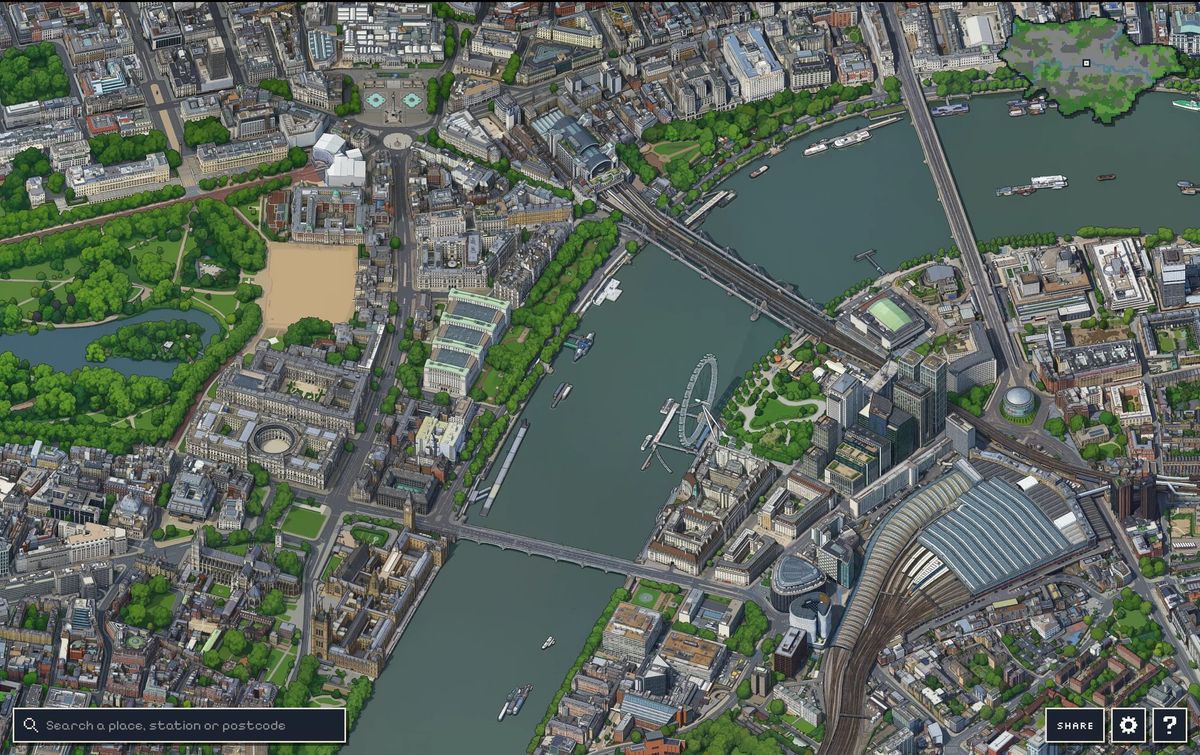
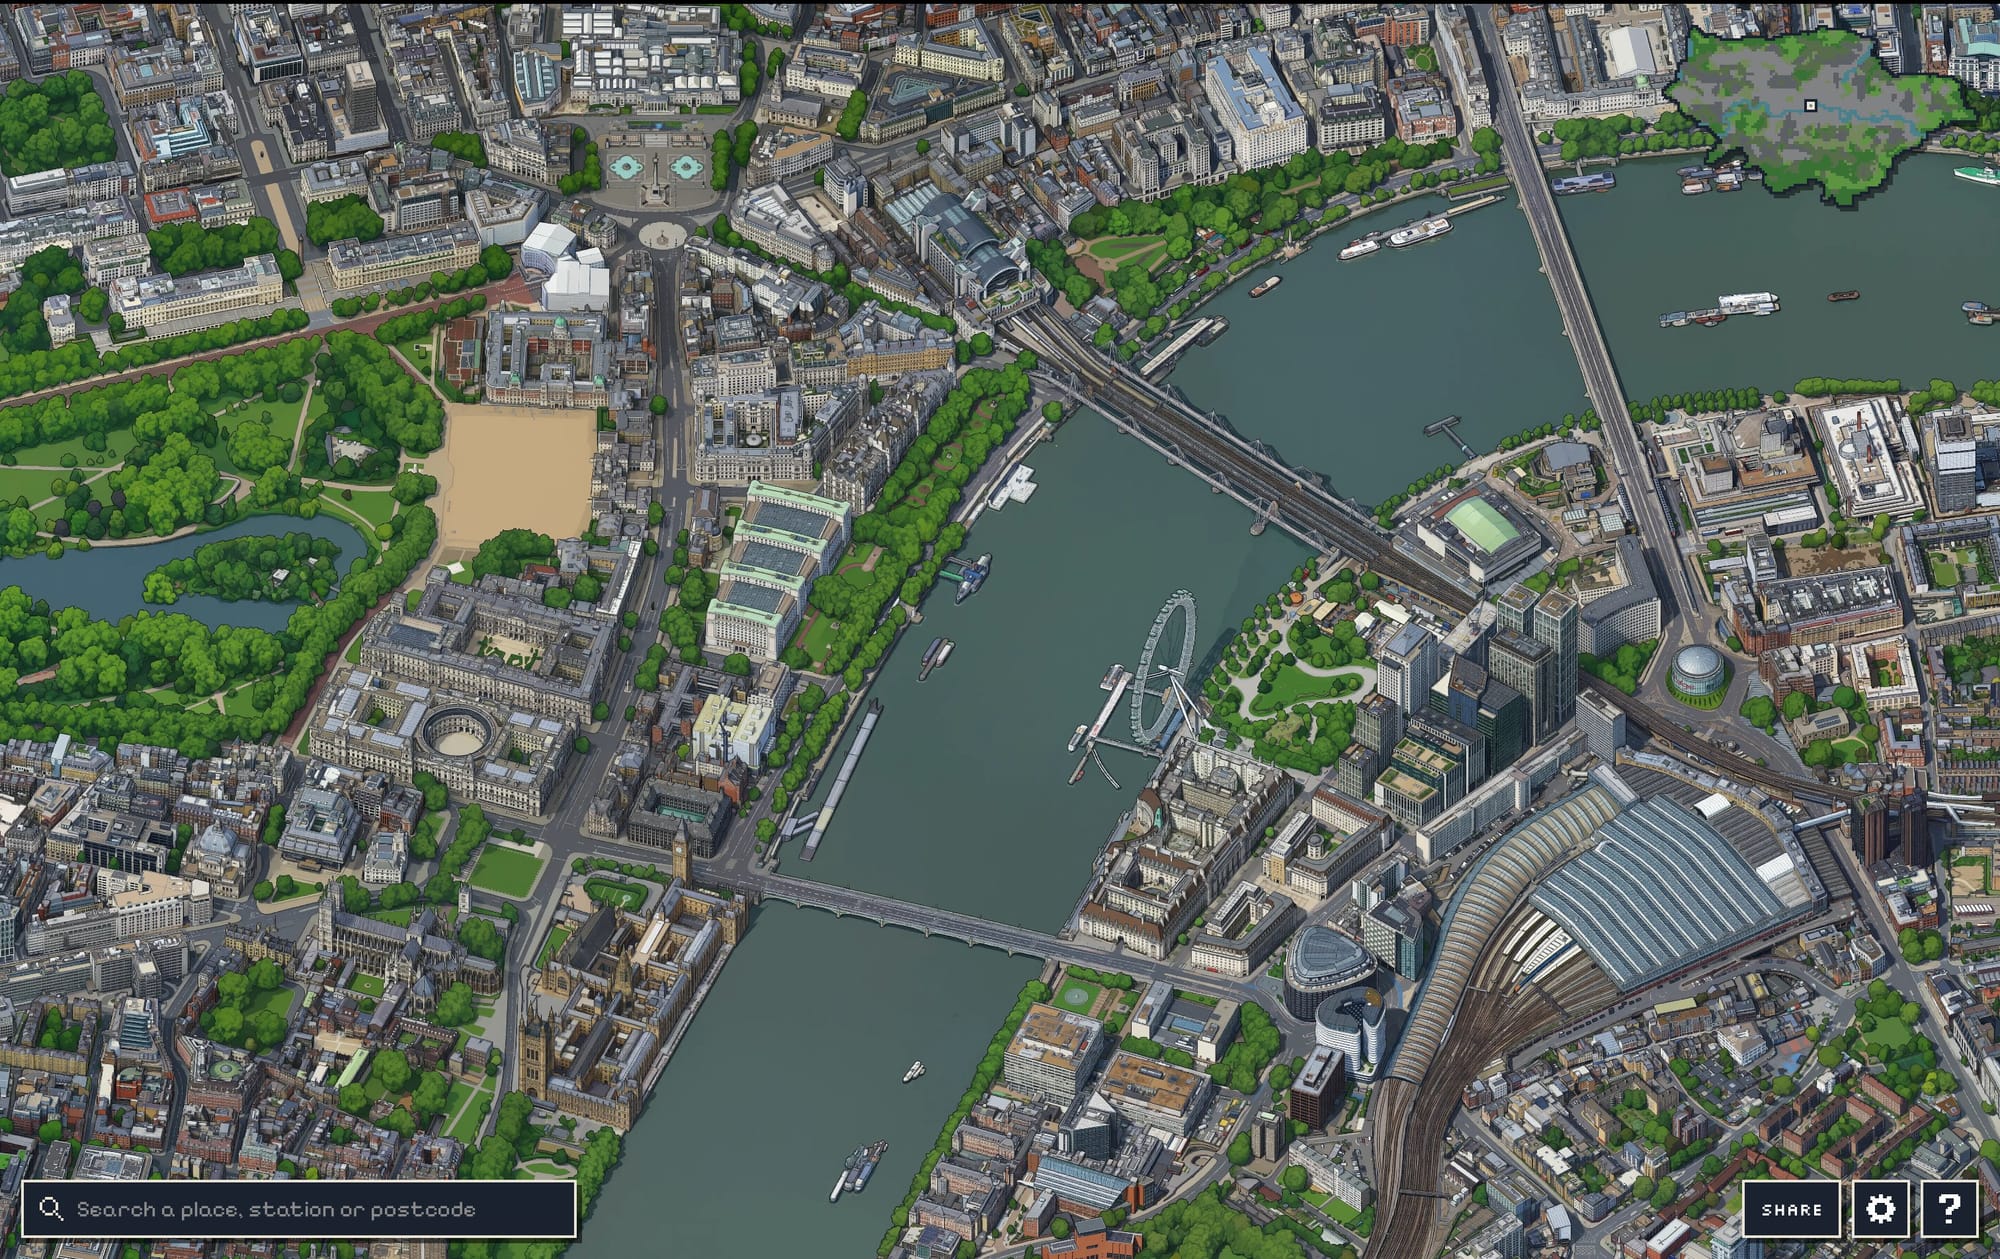
tiny.london 把 1,591 平方公里的大倫敦,畫成一張可以縮放的等距像素地圖。你可以從整座城市一路放大到單一街道,還能搜尋地名、車站與郵遞區號。
作者 Boris Starkov 在 10 月 13 日讓網站上線,10 月 20 日台灣時間下午 3 點,他在 X 正式介紹這件作品。
這則貼文在 10 月 21 日早上查詢時,約有 2,560 個讚、約 25 萬次觀看。貼文提到,它延續 Andy Coenen 九個月前做的紐約版 isometric.nyc。
作者還稱自己的程式代理建了資料集、微調 Qwen 圖像 LoRA、跑了多天推論,並寫出圖磚瀏覽器。
先交代一層關係:Boris 在個人網站寫他目前在 ElevenLabs 實驗語音 AI 應用,製作說明裡 Gemini 的呼叫也走 ElevenLabs 的 API。貼文與說明都沒有出現贊助或合作標示,但這層關係值得讀者知道。
「AI 畫的城市」聽起來像一鍵生成,但作者在製作說明裡反覆強調的,是怎麼讓許多小圖合成一張沒有接縫的大圖,還有怎麼檢查模型有沒有亂畫。
這些細節都有數字可以對照。整張畫布是 221,184 × 135,168 像素,倫敦範圍內約 142 億像素,最後一次正式運算用了 31 個 GPU 小時,流程裡的每個環節也都有作者自己設的檢查。
但好看的地圖不代表可以任意使用。地圖底圖衍生自 Google 的 3D 圖磚,生成模型 Qwen-Image-2.1-Turbo 則是非商用授權,這兩件事直接限制了你能拿它做什麼。
我的判斷是,想學大圖生成、資料集自動檢查與代理協作流程的創作者與開發者,這篇製作說明很值得讀。想把地圖圖塊拿去商業使用的人,則要先處理授權,因為站上與說明裡都找不到可以直接重用圖塊的條款。
要看懂它的做法,得先知道這張地圖本身長什麼樣子。
tiny.london 是什麼?一張可縮放的大倫敦等距像素地圖
tiny.london 是一個網頁地圖,把整個大倫敦畫成斜 45 度俯視的像素風格。官方頁面的簡介寫得很直接:整個大倫敦做成一張等距像素地圖,從全城拉近到單一街道,可以搜尋任何地點、車站或郵遞區號,也能分享你找到的位置。
等距是一種固定角度的俯視畫法,建築的三個面同時可見,早期城市建造遊戲常用。作者沿用了紐約版的角度,所以兩張地圖看起來像同一個系列:傾斜 45 度、轉 15 度,每個像素對應 0.293 公尺,一棟約 5 公尺寬的倫敦排屋大約是 17 個像素寬。
規模上,地圖面積是 1,591 平方公里,含泰晤士河潮汐段。整張畫布約 299 億像素,其中倫敦範圍內約 142 億像素,外圍還有一圈雲層。圖磚是 432 × 264 格的 512 像素 WebP,共 10 個縮放層級。
使用上有幾個功能。搜尋涵蓋 3,180 個來自 OpenStreetMap 的地點與全部倫敦交通局車站,郵遞區號則在瀏覽器裡呼叫 postcodes.io 轉換成座標。設定裡可以開小地圖、票價區與行政區圖層。
首頁開啟速度也被調整過。作者說,預設的 Westminster 畫面在快速網路下一開始要 1.9 秒,現在降到 0.3 秒,但圖磚本身並沒有改,做法是提早計算首屏需要哪些圖磚並預先下載。
地圖能這樣用,背後的製作流程才是重點。
製作流程:三條規則與五個步驟
作者在動手前先立了三條規則:整張圖不能有接縫、不用人工標註訓練資料、成本接近零。倫敦面積是紐約市的兩倍,所以任何需要每塊圖手工處理的做法都被排除了。
作者先用同一台正交相機,從 Google 的 3D 圖磚渲染整座倫敦,共 3,570 張、像素完全對齊的畫面。
接著請 Gemini 3 Pro Image 把約 2,500 張渲染圖重畫成像素風,因為模型常出錯,所以自動檢查會退掉其中 31% 的嘗試,通過的才成為訓練集。
有了訓練集,就在 Qwen-Image-2.1-Turbo 上微調 LoRA,在一張 H100 顯示卡上訓練 3 小時 50 分鐘。LoRA 是只調整模型少部分參數的輕量微調方法,檔案小,適合學一種特定畫風。
生成時,整座城市被當成一張潛空間大圖,用重疊視窗一起去噪,所以沒有可以長出接縫的圖磚邊緣。最後再用 OpenStreetMap 找出模型在水面上亂畫的地標,做不留痕跡的局部修補。
時間軸也很緊湊。作者 10 月 8 日重啟專案,10 月 12 日開始大倫敦運算,10 月 13 日最後一個區塊完成並上線,距重啟只有五天。
作者說,整個專案幾乎都由程式代理完成。Claude Code 寫程式、把任務丟上雲端 GPU、建訓練集、訓練 LoRA、跑整張地圖的推論,作者則負責設定規則與風格,並決定什麼算錯誤。這是作者自述,我沒有看到代理操作紀錄可供驗證。
流程中最關鍵的一步,是怎麼解決接縫。
為什麼沒有接縫?把整座城市當一張大圖一起去噪
接縫是逐塊生成大圖的老問題,作者也是先踩過才找到解法。8 月他先試最直覺的做法:不微調,請 Gemini 一次重畫一塊 512 像素的圖磚,並把已完成的鄰塊放進輸入,讓模型接著畫。
兩天、776 次呼叫後,他得到特拉法加廣場周圍 10 × 10 的圖磚。近看每塊都很漂亮,但邊緣對不上。
他用視覺模型與固定評分表檢查全部 169 條邊界,有 55 條(約三分之一)出現明顯接縫,常見問題是屋頂花紋斷掉、樹的風格改變、河水色調不同。
他又加了八層自動檢查,但接縫率仍沒降到三分之一以下。作者的結論是,提示模型逐塊重畫,每塊都像換了一位略有差異的畫家,重試只是從同一個寬分布再抽一位畫家,所以接縫不會消失。
解法來自 2023 年的 MultiDiffusion 論文。擴散模型從雜訊逐步還原圖像,一次只能看固定大小的視窗,這裡是 1,024 × 1,024 像素。常見的做法是一個視窗接一個視窗生成再拼接,接縫就是這樣來的。
MultiDiffusion 改成整張畫布只維持一份潛空間資料。每一步都在重疊的視窗上跑模型,重疊處取加權平均,因為相鄰視窗改的是同一組數字,所以沒辦法長期不一致。圖磚到最後才從完成的大圖切出來,採樣過程中根本沒有邊界。
作者還補了兩個細節。奇數步的視窗網格錯開半個步長,因為這樣視窗邊緣不會連續兩步落在同一處。已完成的像素每一步都被固定住,所以新區域是從舊區域長出來,而不是拼接上去。
第一次測試是大笨鐘周圍 2,560 像素見方,切成 4 × 4 圖磚後可以逐位元組還原。接縫指標是邊界色差與一般色差的比值,有接縫時會明顯高於 1。這次試做是 0.93,渲染原圖本身是 1.0,所以沒有出現接縫的跡象。
整座城市太大,潛空間放不進一張 GPU,所以最後以 12,288 像素的區塊分批執行。每個區塊先從磁碟讀入 1,024 像素的鄰塊邊緣當固定背景,再生成自己的部分。
區塊依行列奇偶分四個階段,因為同一階段的區塊互不相鄰,所以原則上可以放在不同 GPU 同時跑。
這個流程能運作,前提是訓練資料夠好。
延伸閱讀:Qwen-Image-2.1-Turbo 教學:用八步出圖與局部修改,做一套可比較的商品圖
訓練資料怎麼來:貴的模型當老師,便宜的模型當畫家
作者沒有人工標註任何資料,而是讓昂貴的 Gemini 3 Pro Image 當老師,微調過的 Qwen 當畫家。老師的弱點是畫不同畫面時風格不一致,但訓練資料的每一組都是獨立的,所以這個弱點不影響訓練。畫面之間的一致性,則由大圖去噪負責。
老師的輸出不能直接信,所以作者設計了一組自動檢查,每個目標圖都拿已知為真的東西對照:渲染圖用來驗證結構,OpenStreetMap 用來驗證水域。
針對 2,542 張目標畫面,老師共嘗試 3,456 次,最後 2,389 張通過,150 張重畫三次後仍失敗而捨棄。
有一項檢查特別有意思,叫照片複製偵測。老師有時只是在照片上加濾鏡,沒有真的重畫,但像素畫多半是大片平塗,所以作者量測每個像素周圍 3 × 3 範圍有多少是平的。認真重畫的畫面是 0.42 到 0.55,半複製的是 0.18 到 0.35。
提示語的調整也是重點。作者起初在提示裡描述倫敦:磚牆、灰泥立面、石板屋頂、斑馬線,結果只要渲染圖資訊少,老師就照著畫,農地上長出城鎮、公園裡出現馬路、水庫上蓋了一座城。
最後版本只講怎麼畫,不講畫什麼,並且為每張圖加上一句由 OpenStreetMap 產生的水域說明,例如「這個畫面沒有水」。作者說,光是這一句話,老師就不再把足球場畫成池塘。
為了讓訓練集代表整座城市,作者把 12,264 張渲染圖用 DINOv2 轉成向量,分成 64 群外觀類別,每群取 8 到 30 張。
再加上 230 個從 OpenStreetMap 挑出的困難地點、56 張水域與 95 個地標,最後湊成 6,326 筆訓練樣本。
LoRA 訓練設定是 rank 32、8,000 步、單張 H100 約 3 小時 50 分鐘,工具是 ai-toolkit。作者共訓練過四版,v1 用 86 組資料,v2 加入地標與玻璃大樓,Turbo 版改用八步取樣,v3 才涵蓋整個倫敦。
正式運算花了 31 個 GPU 小時,牆上時間 32.5 小時,所有實驗合計約 70 個 H100 小時。作者設定的目標是成本接近零,但文章沒有給出總花費金額,所以這個目標達成與否我無法核對。
但模型就算訓練得好,也還是會犯錯,所以作者怎麼抓錯,才是下一個重點。
模型犯的錯:水面上長出第二座國會大廈
水域是這次最難的部分,LoRA 學到了泰晤士河和大笨鐘、倫敦塔橋一起出現,所以當視窗裡全是空水面時,有時會自作主張畫出它們。作者在測試中看到羅瑟希德與金絲雀碼頭之間出現第二座倫敦塔橋,狗島外的河上出現第二座國會大廈。
要在 142 億像素裡找出這些東西,不能靠人眼。作者以 OpenStreetMap 的水域多邊形當真值,經過相同的相機投影,再檢查哪些位置地圖說是水、渲染圖也是平坦空白,成品卻有細節。
第一張完整地圖上,這個檢查找出 10 個物件,經核對全部是真的錯誤。
修補不用再叫模型重畫。作者把地標、陰影與倒影遮住,用附近乾淨水面的材質填補,再用泊松方程式讓補丁在邊緣與原圖銜接,所以沒有接縫。10 處修補總共改動 135 個圖磚檔案。
作者也故意留下兩個錯誤當彩蛋。一個是恩菲爾德附近 Lea Valley 水庫上的大笨鐘,另一個是 O2 體育館旁的藍色三角形,那其實是 Google 網格資料的破洞,渲染器的天空藍被模型忠實畫了出來。
地圖外圍也有一段故事。第一版在倫敦邊界直接變黑,所以作者後來多生成一圈 2,560 像素的外環,約多出 10% 的地圖,再用雲層蓋住。
這一圈的區塊又冒出直線,作者的代理量測後判斷是相鄰區塊色調不一致,寫了校正卻只改善一半。作者後來直接看圖才發現,那是解碼器在畫布邊緣留下的暗邊,最後用只改 2,137 個圖磚的補丁解決。
這個過程給了一個實用教訓:數字能告訴你哪裡有問題,但要知道問題是什麼,還是得看圖片。
接下來要面對的是能不能用的問題。
圖資與授權:Google 圖磚、OpenStreetMap 與 Qwen 條款
作者在網站頁尾與製作說明結尾列出了授權來源。地圖影像衍生自 Google 的 Photorealistic 3D Tiles,標示為 Map data ©2026 Google。
水域、地點與搜尋資料來自 OpenStreetMap,採 ODbL 授權。行政區邊界來自英國國家統計局,採開放政府授權第 3 版,車站與票價區資料來自倫敦交通局。
Google 的 Map Tiles API 政策寫明,這個 API 應用於地圖視覺化,不得用於影像分析、機器解讀、物件偵測辨識、地理資料擷取或轉售等非視覺化用途,並禁止預先抓取、索引、儲存或快取內容,除非符合條款中的有限條件。
tiny.london 的流程把 3D 圖磚渲染成圖片,再交給 AI 模型重畫。這是否落在政策允許的範圍,要看作者與 Google 之間的協議,而我在製作說明裡沒有看到作者交代是否取得額外許可。
所以本文不替作者下判斷,只提醒你,想用同一條圖資來源前,要先讀 Google 的政策。
模型授權比較明確,但兩個模型的條件不同。作者在說明裡寫了,Qwen-Image-Edit 採 Apache 2.0,Qwen-Image-2.1-Turbo 採 Qwen Research License。
我讀了 Hugging Face 上的授權全文,其中寫明非商業指的是僅限研究或評估,商業使用要另外向 Qwen 申請授權。
授權全文也要求,若使用材料或其輸出去訓練、微調或改進會對外提供的 AI 模型,要在相關產品文件顯著標示「Built with Qwen」或「Improved using Qwen」。作者在說明裡確實寫了 built with Qwen。
全文管的是模型材料的使用,沒有單獨列出輸出圖像的商用規則,所以地圖圖塊能不能商用,條款本身沒有給答案。
瀏覽與分享連結是網站本來就提供的功能,但要重製或商業使用圖塊,網站沒有提供條款,所以我會先聯絡作者,同時回頭確認 Google 圖資與 Qwen 授權。
這樣就能回答誰適合使用這個流程。
延伸閱讀:God’s Eye View 是什麼?X 熱傳開源 3D 地球,把航班、船舶與公共鏡頭放在同一張圖
適合誰、不適合誰與導入前檢查
最適合的是想學大圖生成流程的人。如果你要做超過單張圖尺寸的素材,像是城市地圖、遊戲關卡或長卷插畫,這份說明給了一套可以借用的思路:用整張潛空間一起去噪避免接縫,用貴的模型產生訓練資料,再用已知為真的資料來檢查輸出。
第二類是做資料集品質控管的團隊。作者的檢查方式很具體,例如用平塗比例抓照片複製、用 OpenStreetMap 抓水面上的幻覺物件,能直接套到其他影像生成專案。
不適合的是想直接使用這些圖塊或把流程原樣商用的人。Google 的政策限制快取與機器解讀,Qwen 研究授權又限定研究或評估,所以這種用途至少要先另外取得許可。作者也沒有附上自己的程式碼倉庫連結,只貼出取樣迴圈的節錄,要重現得自己寫。
動手前我會先做四項檢查。先確認你要用的底圖授權允許機器處理與衍生作品,再確認生成模型的授權是否涵蓋商用。
接著用小範圍試跑,看是否有接縫與幻覺物件。最後確認算力預算,因為依官方數字,一次完整運算約 31 個 GPU 小時,加上實驗總共約 70 個 H100 小時。
這些檢查通過後,才有必要面對作品本身的限制。
限制與風險:還有哪些地方無法驗證
最大的限制是流程細節出自作者單方說明。我讀到的是作者的製作文章與網站,沒有第三方重現,也看不到代理的操作紀錄,所以「幾乎全由代理完成」只能當作者自述。
第二個限制是準確性。像素畫是把真實城市藝術化,建築與道路不是測繪資料,作者的說明也提到後來的風格會省略所有車輛。作者承認模型會畫出不存在的東西,而說明裡針對最終地圖的幻覺檢查只有水面這一項,陸地上有沒有類似的錯誤,我沒有看到交代。
第三個限制是時間。地圖畫面衍生自 Google 的 3D 圖磚,但我在說明與頁尾都沒有看到圖磚的拍攝時間,所以它不是即時資訊,也不能當成最新的街景。
第四個限制是地圖仍在更新。作者 10 月 13 日上線後,14 日加入搜尋與票價區,15 日補上外環與雲層,19 日再改雲層與首屏速度,所以你看到的畫面與功能,可能已經和本文描述的不同。
至於成本,作者設定接近零,但文章沒有公開 Gemini 呼叫費用、雲端 GPU 費用與總花費,不能直接引用為「幾乎免費」。
tiny.london 常見問題
tiny.london 的地圖可以下載或商用嗎?
網站提供瀏覽、搜尋與分享連結,我沒有在站上或製作說明裡找到圖塊的重用條款。圖資來自 Google 3D 圖磚與 OpenStreetMap,而 Qwen-Image-2.1-Turbo 是研究與評估用途授權,商業使用前要另外取得許可。
這張地圖是 AI 一鍵生成的嗎?
不是。作者先渲染 3,570 張 3D 圖磚畫面,用 Gemini 產生約 2,500 張訓練目標並自動檢查,再微調 Qwen LoRA,最後整座城市一起去噪,之後還做了水面修補與外圍雲層。
我也可以做自己城市的版本嗎?
作者沿用 Andy Coenen 的 isometric-nyc 倉庫,它採 MIT 授權,含渲染器、檢視器與 LoRA。但你仍要面對 Google 圖資政策、模型授權與算力成本,並自己寫整張大圖去噪的程式。
為什麼不直接逐塊生成?
作者 8 月試過,169 條邊界中有 55 條出現接縫,加了八層檢查也沒改善。整張大圖共享同一份潛空間後,視窗之間無法長期不一致,接縫自然消失。
流程需要多少算力?
最後一次正式運算約 31 個 GPU 小時,LoRA 訓練約 3 小時 50 分鐘,所有實驗合計約 70 個 H100 小時,文章沒有列出雲端費用的實際金額。
先弄清楚圖資與授權,再決定要不要借用這套流程
tiny.london 最有參考價值的,是它把「大圖不留接縫」「訓練資料自動檢查」「用地面真值抓幻覺」三件事做成了可驗證的流程。想借用方法的人可以從 MultiDiffusion 與資料檢查開始。
想直接使用成果或擴張到商業產品的人,則要先把 Google 圖資、OpenStreetMap 署名與 Qwen 研究授權三條線理清楚。若想持續追蹤創作工具與圖像生成的實務更新,可以免費訂閱 AI 郵報。