Underdog Bark 3.0 是什麼?163 MB 語音辨識模型的準確度與第一名說法怎麼看
Underdog Bark 3.0 是 163 MB 的英文語音辨識開源模型,採 CC-BY 4.0。本文依官方頁面與模型卡,整理它與 NVIDIA Parakeet、Whisper large-v3 的逐組成績、第一名說法的口徑、速度條件與 Clean 版的取捨。

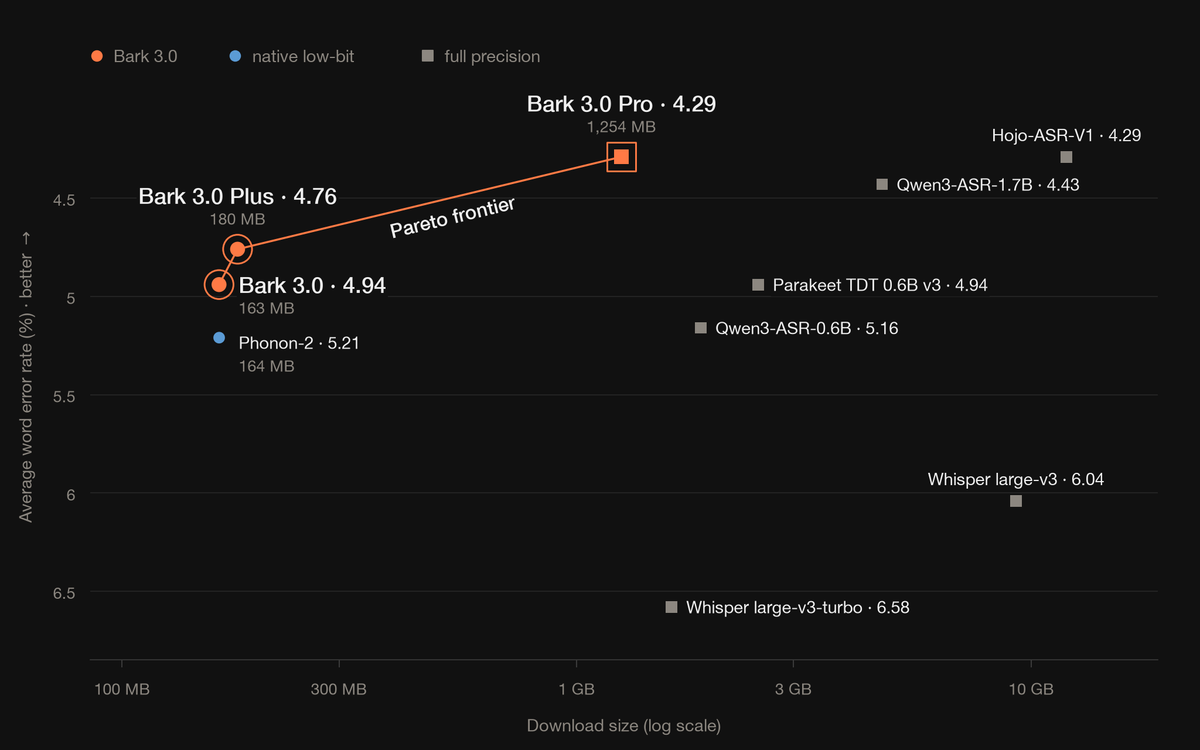
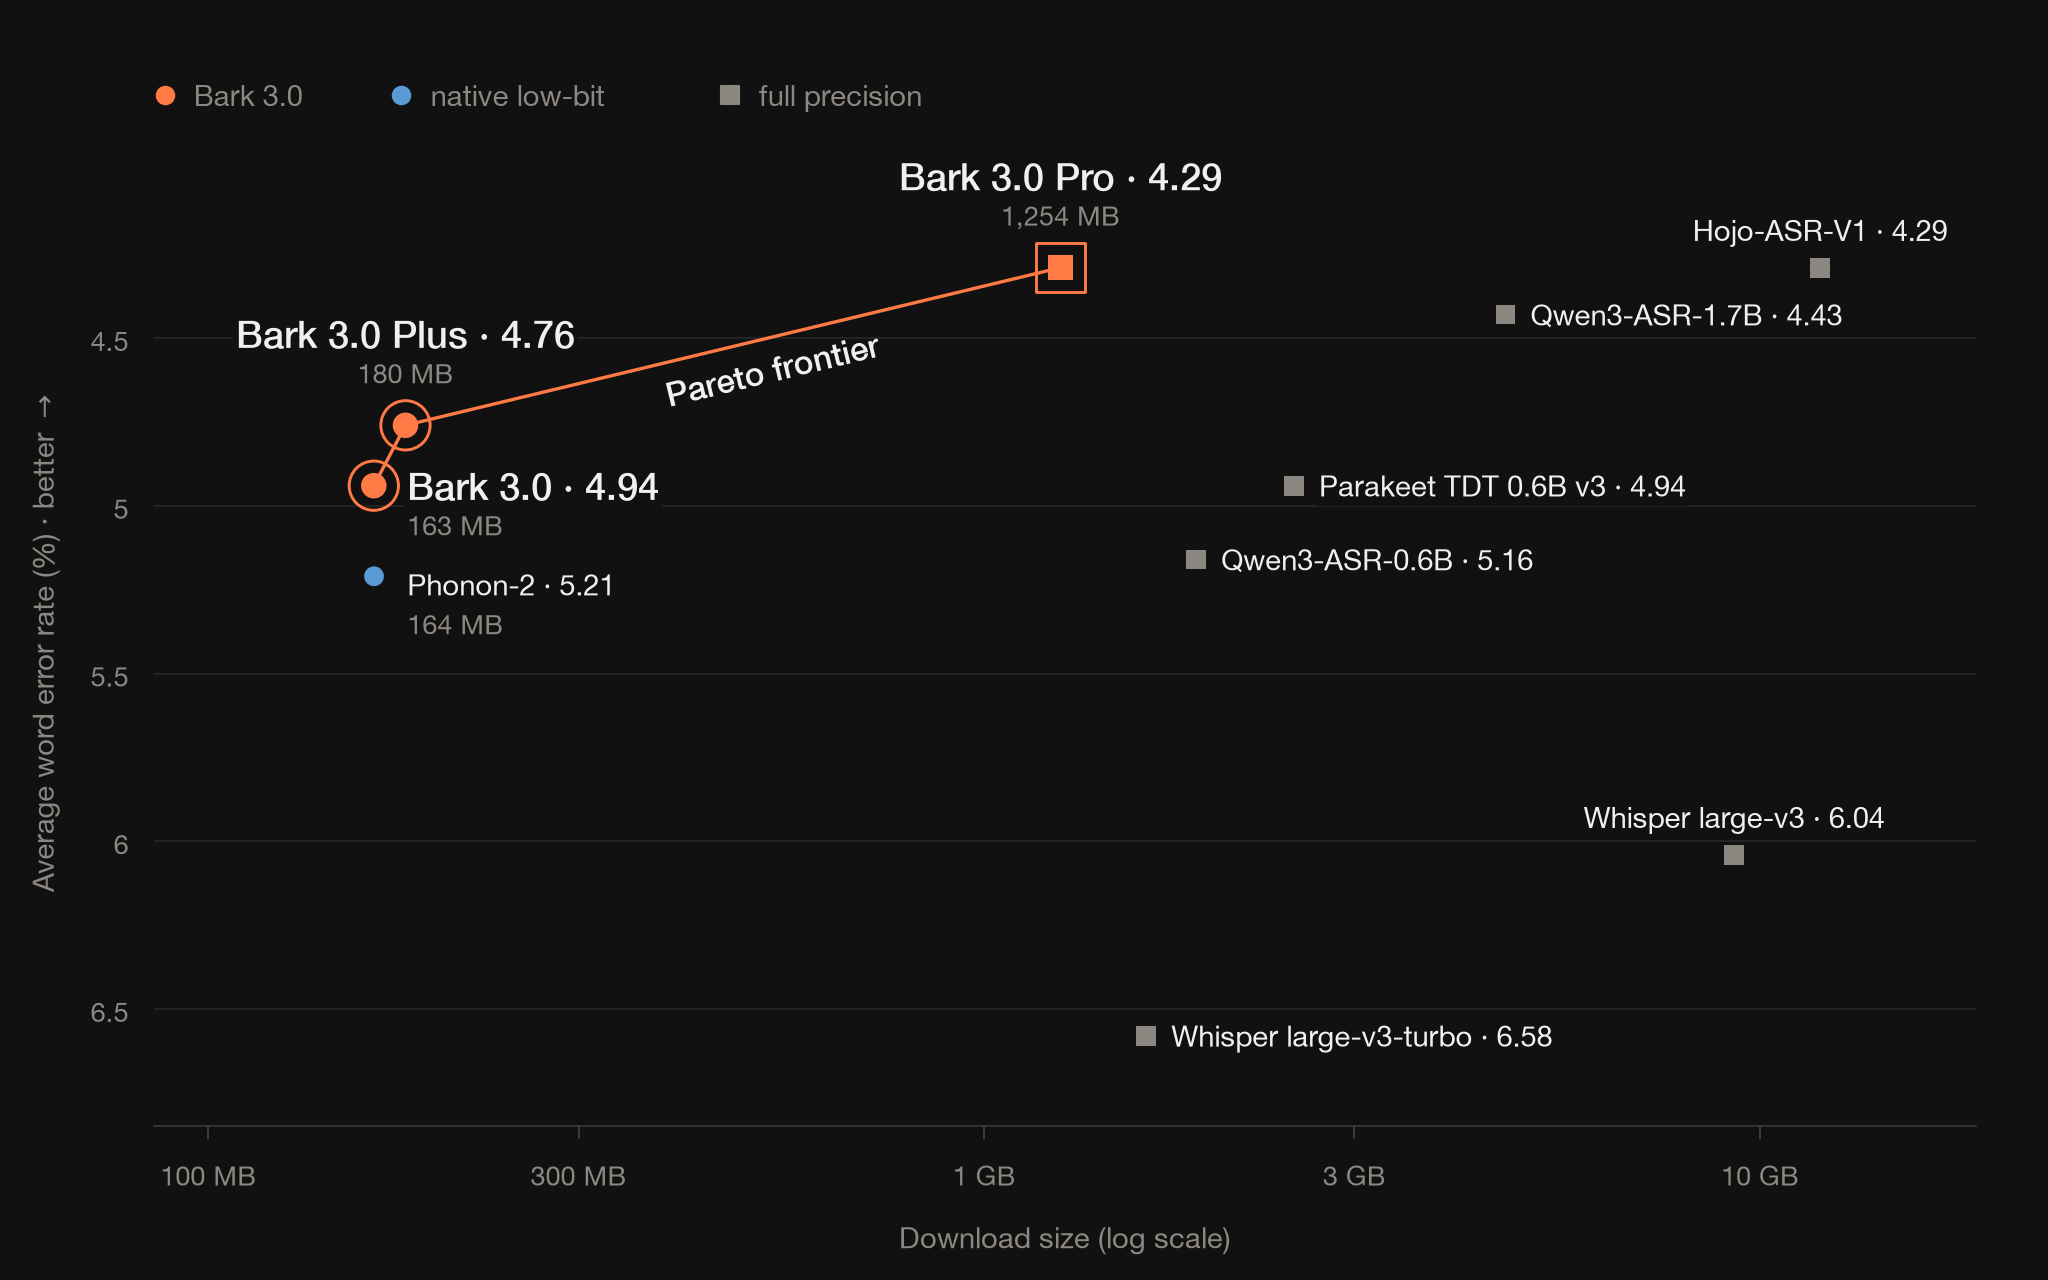
Underdog Bark 3.0 在 2026 年 10 月 21 日上午(台灣時間)由 Underdog 官方帳號推上 X,貼文稱它是「第一名前沿語音模型」,只有 163 MB,準確度和大 15 倍的 NVIDIA Parakeet 相同。
語音辨識模型負責把聲音轉成文字,檔案小,手機和筆電才比較容易在本機執行,不必把音檔傳上雲端。所以「163 MB」加上「和 Parakeet 一樣準」,對想做本機聽寫的人很有吸引力,但「第一名」與「一樣準」都要先問,是用哪組測試、誰算的。
官方頁面和 Hugging Face 模型卡其實交代得相當完整。Bark 3.0 在七組英文測試集的平均詞錯率是 4.94%,Parakeet 同樣是 4.94%,兩者只差 0.004 個百分點,所以「相同」成立,但七組裡 Bark 只有三組比 Parakeet 低。
「第一名」的口徑,是在檔案大小與準確度之間畫出的最佳曲線,而不是單看準確度。依我對 Underdog 比較表的排序,只看平均詞錯率的話,Bark 3.0 本體在 16 列中排第 10。
另一件容易漏掉的事,是 Bark 3.0 以 NVIDIA 的 Parakeet 為底座,經由 Moondream 的 parakeet-ultra,再由 Conway Research 後訓練並壓縮,所以授權也沿用 CC-BY 4.0。
我的判斷是,Bark 適合想在 Mac 上做英文聽寫與會議逐字稿、在意隱私與檔案大小的人。需要中文、字詞時間戳或說話者標記的人,現階段不適合。
要把這些數字放回脈絡,得先看它是什麼模型,又為什麼會出現在一個叫 Underdog 的 App 裡。
Underdog Bark 3.0 是什麼?Underdog App 內建的 163 MB 英文語音辨識
Bark 是 Underdog 這個本機 AI 助理 App 裡的語音模型,負責把你按住 fn 鍵說的話,或錄下的會議,在 Mac 上轉成文字。
Underdog 主打在自己的裝置上處理 email、行事曆、會議筆記與聽寫。服務條款寫明 Underdog 免費。
依官方網站,Underdog 目前標示為邀請制測試版,提供 Mac 版、App Store 的 iPhone 與 iPad 版,以及 Windows beta 版。
這則 X 貼文來自公司自己的帳號,用來推廣自家 App 與開源模型,沒有付費合作標示。貼文末尾導向 Underdog 官方的 Bark 頁面。
官方頁面標示的發布日期是 2026 年 10 月 15 日,Hugging Face 上的 Bark 3.0 倉庫也是 10 月 15 日建立。X 貼文寫的「今天釋出」落在 10 月 21 日,所以 Bark 3.0 不是當天才出現的新模型,而是公開約一週後再被推廣。
Underdog 在 App 裡直接載入 model.bark 這個封裝檔,用 Swift 與 MLX 執行,不需要 Python。官方說明,展開後的權重與測量成績時用的權重完全相同,所以表上的分數對應的就是使用者下載的那一份檔案。
Bark 3.0 其實是一個家族,依下載大小與用途分成四個成員。以下我把官方頁面的比較表整理出來,詞錯率為七組英文測試集的平均,數字越低越好。
| 型號 | 下載大小 | 平均詞錯率 | 特色與取得方式 |
|---|---|---|---|
| Bark 3.0 Clean | 180 MB | 5.83(對逐字稿計分) | 刪掉「um」等贅詞,Underdog 聽寫與會議筆記的預設 |
| Bark 3.0 | 163 MB | 4.94 | 逐字轉寫,最小的檔案 |
| Bark 3.0 Plus | 180 MB | 4.76 | 逐字轉寫,錯誤更少 |
| Bark 3.0 Pro | 1.25 GB | 4.29 | 完整精度,只放在 Hugging Face |
表格裡的 Clean 分數偏高並不代表它比較差,原因會在後面的 Clean 一節說明。四個型號都放在 Hugging Face 的 ConwayResearch 組織下,授權為 CC-BY 4.0。
CC-BY 4.0 允許修改與商用,但必須署名。模型卡另附 NOTICE 檔,列出 NVIDIA 與 Moondream 的歸屬聲明,並註明由 Conway Research 後訓練與壓縮,所以使用時要一併保留。
這個模型家族的出發點很清楚,就是用最小的檔案換到接近大模型的準確度。這個「接近」到底多接近,要看逐組成績。
Bark 3.0 對上 Parakeet 與 Whisper:平均一樣,逐組勝負不同
官方比較表以 Open ASR Leaderboard 的七組英文測試集計算詞錯率。詞錯率是辨識結果中錯誤字數占全部字數的比例,所以越低越好。
七組涵蓋有聲書、會議、財報電話、Podcast 與影片、金融電話和議會演講。以下我把 Bark 3.0 與兩個被拿來比較的模型逐組列出,數字取自模型卡的表格。
| 測試集 | 場景 | Bark 3.0 | Parakeet TDT 0.6B v3 | Whisper large-v3 |
|---|---|---|---|---|
| LibriSpeech clean | 朗讀有聲書 | 1.89 | 1.52 | 1.56 |
| LibriSpeech other | 較難的有聲書 | 4.08 | 3.13 | 3.52 |
| AMI | 多人會議 | 7.82 | 9.42 | 13.63 |
| Earnings-22 | 財報電話 | 7.05 | 5.85 | 7.99 |
| GigaSpeech | Podcast 與影片 | 7.95 | 7.99 | 8.35 |
| SPGISpeech | 金融電話 | 3.72 | 3.63 | 2.71 |
| VoxPopuli | 議會演講 | 2.05 | 3.05 | 4.53 |
| 七組平均 | 全部 | 4.94 | 4.94 | 6.04 |
| 下載大小 | 檔案 | 163 MB | 2,508 MB | 9,261 MB |
表格顯示,Bark 對 Parakeet 只在 AMI、GigaSpeech 與 VoxPopuli 三組較低,其餘四組較高。所以「和 Parakeet 一樣準」只在平均成立,並不是每一組都一樣。
貼文挑了 AMI 會議這一組強調,Bark 得 7.82%,Parakeet 得 9.42%。這剛好是 Bark 領先幅度最大的一組,差了 1.6 個百分點,另外兩組領先的幅度只有 1.0 和 0.04 個百分點。
對 Whisper large-v3,Bark 在 AMI、Earnings-22、GigaSpeech 與 VoxPopuli 四組較低。在 LibriSpeech 兩組和 SPGISpeech 則較高。
平均上 4.94 對 6.04,差了 1.10 個百分點。
這張表最實用的讀法,是找出自己的音檔最像哪一組。如果你常處理多人會議,AMI 那一列最有參考價值,Bark 3.0 在那裡明顯領先 Parakeet 與 Whisper。
如果是朗讀稿或乾淨錄音,LibriSpeech 兩列顯示 Parakeet 與 Whisper 反而略好。
不過「會議領先」只限於這兩個對手。同一張官方表裡,Cohere Transcribe 的 AMI 是 7.02,Granite Speech 4.1 2B 是 7.06,都比 Bark 的 7.82 低,只是下載檔大了 25 到 30 倍(依官方表格相除)。
「小 57 倍」也要看計法。Bark 表格把 Whisper large-v3 記為 9,261 MB,但 Hugging Face 上該倉庫的主要權重檔 model.safetensors 約 3.09 GB,用它換算約 19 倍。
我比對檔案清單,9,261 MB 剛好等於 model.safetensors 的 3,087 MB 加上 flax 格式檔的 6,174 MB。
同一張表裡,Parakeet 與 Whisper large-v3-turbo 的大小都只取 model.safetensors。這是我的推算,表格沒有說明算法,所以 57 倍和 19 倍都說得通,但差很多。
另外,Underdog 自己也承認 Bark 只支援英文,其他語言在 App 的聽寫功能裡仍提供 Whisper Large v3 Turbo。所以兩者並不是互相取代的關係。
比完逐組成績,下一個問題是「第一名」這個說法怎麼來的。
「第一名前沿語音模型」怎麼算?排名、官方榜與不同廠商的數字
這裡的「前沿」指的是 Pareto 前緣,也就是在同樣檔案大小下準確度最高的那條曲線。模型卡寫的是「在 163 MB 這個大小最準的開放語音辨識模型」,並沒有說 Bark 3.0 是所有模型中最準的。
如果把 Underdog 比較表的 16 列依平均詞錯率排序,第一名是 Bark 3.0 Pro 與 11,957 MB 的 Hojo-ASR-V1,兩者四捨五入都是 4.29,模型卡給的三位小數是 4.286 與 4.291。
Bark 3.0 本體排第 10,Parakeet 緊接在後,兩者在小數第二位同為 4.94。
所以「第一」要加上限定詞,才算準確。它是 163 MB 這個級距的第一,不是整體準確度的第一。
另一個條件是榜單來源。模型卡明確寫,Bark 的數字用 Open ASR Leaderboard 的計分程式自行計算,還沒有出現在官方榜單上。其他模型則引用榜單截至 2026 年 10 月 9 日的公布值。
表格裡混著自測與官方公布,所以要把它當作廠商的比較表。
榜單本身的總平均也是另一回事。榜單頁面預設的平均涵蓋 11 組資料集,除了這七組,還有 URGENT24、Voice Arena Monsoon 與兩組私有測試集。我用 Parakeet 的各欄成績驗算,榜單上的 6.18 確實是這 11 欄的平均。
我在 10 月 21 日查看榜單頁面載入的資料表,共 56 列,Parakeet TDT 0.6B v3 排第 28,表中沒有 Bark。所以 Bark 的 4.94 只是七組子集的平均,不能和榜單總平均直接比。
不同廠商的數字更不能直接互比。Bark 卡片記錄 NVIDIA Parakeet TDT 0.6B v3 的七組平均是 4.94。
Fluid Speech Mini 卡片自行重跑八組得到 4.86,Moondream 的 parakeet-ultra 卡片以自己的流程得到 6.26。
同一個模型,三張表差了 1.4 個百分點。Moondream 卡片的逐組成績裡,LibriSpeech 兩組與 SPGISpeech 和 Bark 表完全相同,差異全在 AMI、Earnings-22、GigaSpeech 與 VoxPopuli 四組。
這四組正是 Bark 卡片說使用清理版本的資料集,所以資料版本很可能是主因,但兩張卡片都沒有逐項說明。
因此比較時,同一張表內的相對順序比絕對數字可靠。要跨表比較,就得自己用同一批音檔重跑。
排名與準確度的口徑清楚了,速度又是另一套條件。
延伸閱讀:FluidVoice 主打免費本機語音輸入:Fluid-1 改寫與語音辨識,差在哪裡?
Bark 3.0 的速度與裝置條件:595 倍、41 倍與 iPhone 說法
速度也有三種數字,條件各不相同。官方頁面說,在 Underdog App 裡的 M5 Max MacBook Pro 上,5 分鐘音檔轉寫只要半秒,約為即時速度的 595 倍。
Hugging Face 模型卡則寫,用公開的 mlx-audio 範例在 Apple M2 筆電上,一分鐘音檔約需 1.5 秒,也就是 41 倍。X 貼文的「一分鐘少於 0.25 秒」和頁面的 595 倍量級一致,但貼文沒有寫明機型。
兩者的條件不同:晶片是 M5 Max 對 M2,執行環境是 App 內的原生 Swift 對公開的 Python 套件。官方沒有拆解各自貢獻多少,所以自己照模型卡跑,速度比較可能落在 41 倍那一端。
記憶體也有限制。模型卡說,公開範例一次處理整個檔案,在 16 GB 的 M2 上,10 分鐘的錄音峰值約占 15 GB,建議在 8 或 16 GB 的 Mac 上把長錄音切成幾分鐘一段。
Mac 上另有 Core ML 路徑,分成 GPU 與神經網路引擎兩種,需要 Apple Silicon、macOS 15 與 Python 3.11。模型卡提醒,第一次載入與編譯可能花上數分鐘,所以重複使用時要讓轉寫程式常駐。
Windows 路徑則是 PyTorch 執行環境,載入器會把壓縮的權重展開成 FP32 放進記憶體,模型卡明說下載大小不等於記憶體需求。CUDA 路徑已在搭載 NVIDIA 顯卡的 Windows 上測試。
至於貼文說的「手機也能跑」,官方有 iPhone 與 iPad 版 App,Clean 模型卡也寫它在 Mac 或 iPhone 上轉寫。
但 Bark 3.0 模型卡的 iOS 段落同時寫著「尚未在 iPhone 或 iPad 上測試」,指的是第三方 App 自行移植 Core ML 檔案的路徑。
所以自行開發 iOS 應用的人,要把這條路當作未驗證。Bark 3.0 Pro 才附完整的 Core ML 流程與 iOS 說明,但下載大小是 1.23 GB。
功能限制也要先知道:只支援英文、沒有字詞時間戳、沒有說話者名稱,自訂詞彙清單目前只支援舊的 Bark 1.0。Core ML 路徑對長錄音的分段也還沒有驗證。
條件都確認後,還剩下版本要選,Clean 與逐字版的取捨最容易被分數誤導。
Bark 3.0 Clean 與逐字版怎麼選:會議紀錄不能刪的字
Clean 是 Plus 的清理版,會刪掉「um」「uh」、「you know」這類填充詞、說到一半的重來與重複字,是 Underdog 聽寫與會議筆記的預設。
官方用 DisfluencySpeech 測試,這是 250 段即興對話,裡面充滿贅詞。Clean 對照「清理後的稿」詞錯率是 4.08%,對照「逐字稿」是 13.85%。
逐字版的 Bark 3.0 剛好相反,對照清理稿是 16.53%,對照逐字稿是 3.15%。
這組數字說明兩種模型在做不同的事。Clean 刪贅詞,所以對逐字稿來說每個被刪的字都算錯。Clean 在七組標準測試的平均是 5.83,原因也一樣,因為官方榜的參考稿是逐字的。
所以 5.83 和 4.94 不能放在一起比較誰更準,它們衡量的是不同目標。
實務上,寫 email 或筆記的聽寫適合 Clean,因為讀起來更乾淨。訪談逐字稿、客服錄音、需要留下原話的會議,應該用 Bark 3.0 或 Plus,這樣才不會遺失說話者的猶豫與修正。
這裡有一個實務提醒:Clean 會自行判斷哪些字不算內容,這個判斷可能出錯。法律、醫療或研究用途要保留原文時,留一份逐字版當底稿比較保險。接下來把這些條件整理成試用前的檢查。
適合誰、不適合誰:試用 Bark 3.0 前的檢查
Bark 3.0 適合在 Mac 上做英文聽寫與會議記錄、重視資料不離開裝置的個人,也適合想把小型語音辨識模型放進自己 App 的開發者。
它不適合需要中文或多語言的人,也不適合需要字詞時間戳、說話者分離或自訂詞彙的工作流程。如果你需要在公開榜單上證明排名,依模型卡與我 10 月 21 日查看的榜單頁面,現在還沒有這筆紀錄。
試用前可以先準備 10 段自己的錄音,涵蓋你常見的口音、麥克風與背景噪音。同一批音檔交給 Bark 3.0、Plus、Parakeet 與 Whisper large-v3 Turbo,再記錄專有名詞錯誤與漏字。
下載時要從官方的 Hugging Face 組織取得,並核對檔案大小。模型卡說 Underdog 自己會用固定的檔案大小與 SHA-256 檢查下載內容,自行部署也可以照這個做法。
模型卡附的安裝指令會執行 Python 腳本,建議先讀過內容、在虛擬環境中固定版本再執行,不要直接貼上不明來源的一行指令。
隱私方面,Underdog 官方頁面寫語音轉文字時「不會傳送到任何地方」,服務條款也寫錄音不會離開你的電腦。
依其 2026 年 10 月 14 日生效的隱私政策,iPhone 與 iPad 版沒有帳號,不連到 Underdog 的伺服器,下載模型時才連到 Hugging Face。
Mac 版則不同,它有帳號,會收集電子郵件與會員狀態,並每天送出一次使用次數統計與簽到紀錄,使用統計可在設定中關閉。政策寫明這些資料不含音檔、逐字稿與聽寫文字。以上都是官方說法,我沒有做過網路流量檢查。
延伸閱讀:Voxtral 3 是什麼?Mistral 語音轉錄、語音生成與代理 API 的價格與限制
Bark 3.0 常見問題
Bark 3.0 真的和 Parakeet 一樣準嗎?
七組平均相同,都是 4.94%,Bark 是 4.937,Parakeet 是 4.941。但逐組看,Bark 只在 AMI、GigaSpeech 與 VoxPopuli 三組較低。
Bark 3.0 可以商用嗎?
模型授權為 CC-BY 4.0,允許商用但必須署名並保留 NOTICE。Underdog App 本身是另一份服務條款,和模型授權分開。正式上線前仍建議自行確認授權文字。
Bark 3.0 支援中文嗎?
不支援。模型卡與官方頁面都寫英文限定,Underdog 在其他語言仍提供 Whisper Large v3 Turbo。
Bark 3.0 Clean 的 5.83 為什麼比 4.94 高?
因為 Clean 會刪掉贅詞,而官方榜的參考稿保留贅詞,被刪的字都算錯。它的目標是可直接使用的文字,不是逐字紀錄。
163 MB 就是需要的記憶體嗎?
不是。163 MB 是下載大小,Clean 模型卡說展開後約占 1.25 GB 記憶體,Windows 路徑則會展開成 FP32。實際需求要看你的執行方式。
先用自己的錄音比一次,再決定要不要換
Bark 的價值在於,用 163 MB 就能在英文聽寫上追上 2.5 GB 的 Parakeet 平均成績,並且在會議與議會這類場景領先。這讓離線語音輸入的門檻又降了一階。
但「第一名」是檔案大小級距內的第一,「一樣準」是平均相同、逐組不同,分數也還沒有進入官方榜單。如果你的音檔是英文會議,值得排進測試名單,其他語言或需要時間戳的人先觀望。
想持續追蹤本機語音與小型模型的新進展,可免費訂閱 AI 郵報,引用分數時再回到官方模型卡核對。
資料來源
- Underdog Bark 3.0 官方頁面:https://underdog.ai/bark
- Underdog Bark 3.0 模型卡(Hugging Face):https://huggingface.co/ConwayResearch/Underdog-Bark-3.0
- Underdog Bark 3.0 Clean 模型卡(Hugging Face):https://huggingface.co/ConwayResearch/Underdog-Bark-3.0-Clean
- Underdog 隱私政策:https://underdog.ai/privacy
- Underdog 服務條款:https://underdog.ai/terms
- Open ASR Leaderboard(Hugging Face):https://huggingface.co/spaces/hf-audio/open_asr_leaderboard
- NVIDIA Parakeet TDT 0.6B v3(Hugging Face):https://huggingface.co/nvidia/parakeet-tdt-0.6b-v3
- OpenAI Whisper large-v3(Hugging Face):https://huggingface.co/openai/whisper-large-v3
- Moondream parakeet-ultra(Hugging Face):https://huggingface.co/moondream/parakeet-ultra
- Fluid Speech Mini Core ML 模型卡(Hugging Face):https://huggingface.co/FluidVoice-Labs/fluid-speech-mini-coreml
- X 貼文(Underdog 官方帳號,熱度線索):https://x.com/UnderdogAI/status/2112733007484518470