Wafer 分享 CUDA 效能指南:AI 變慢時,先找出 GPU 在等什麼
Wafer 以 NVIDIA CUDA Programming Guide 解說 AI 效能瓶頸。本文用資料搬移、CPU 啟動與快取的角度,說明為何改善推論速度要先量測,而不是只看 GPU 使用率。

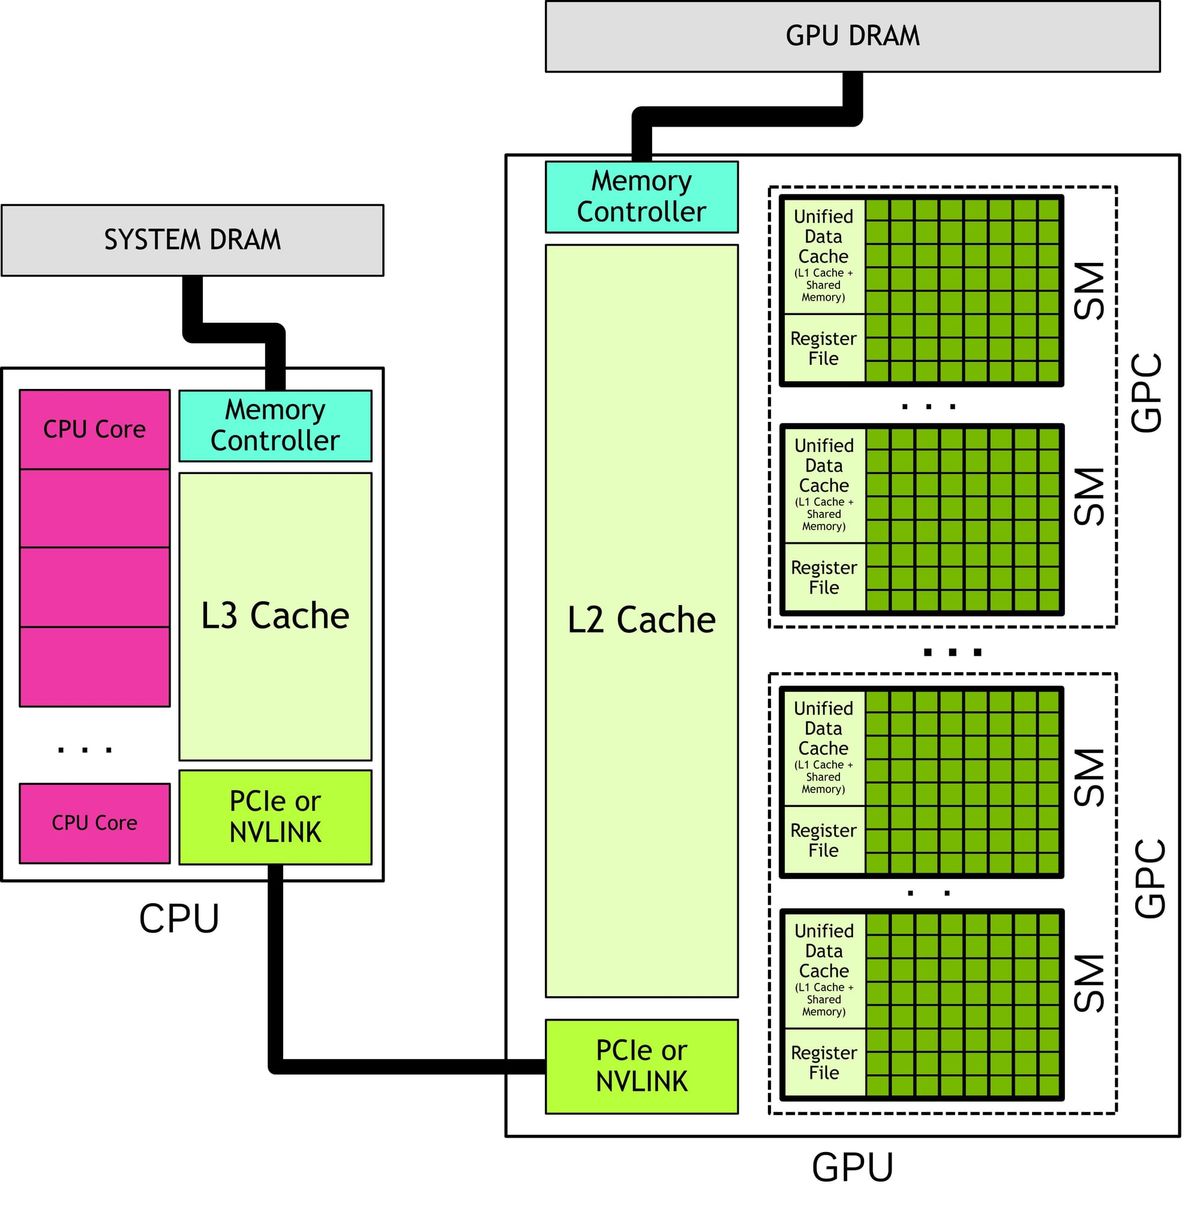
AI 服務回得慢,未必是 GPU 算得不夠快。
有時它在等資料,有時它在等下一個工作被啟動。
Wafer 在 10 月 8 日分享 CUDA Programming Guide,提醒開發者先理解運算在哪裡等待。
CUDA 是 NVIDIA GPU 執行平行運算的軟體平臺。
這份官方指南是學習與分析效能的資料,並不是新晶片或新的固定加速方案。
對想改善 AI 服務的人,起點應是把一次請求的時間分清楚。
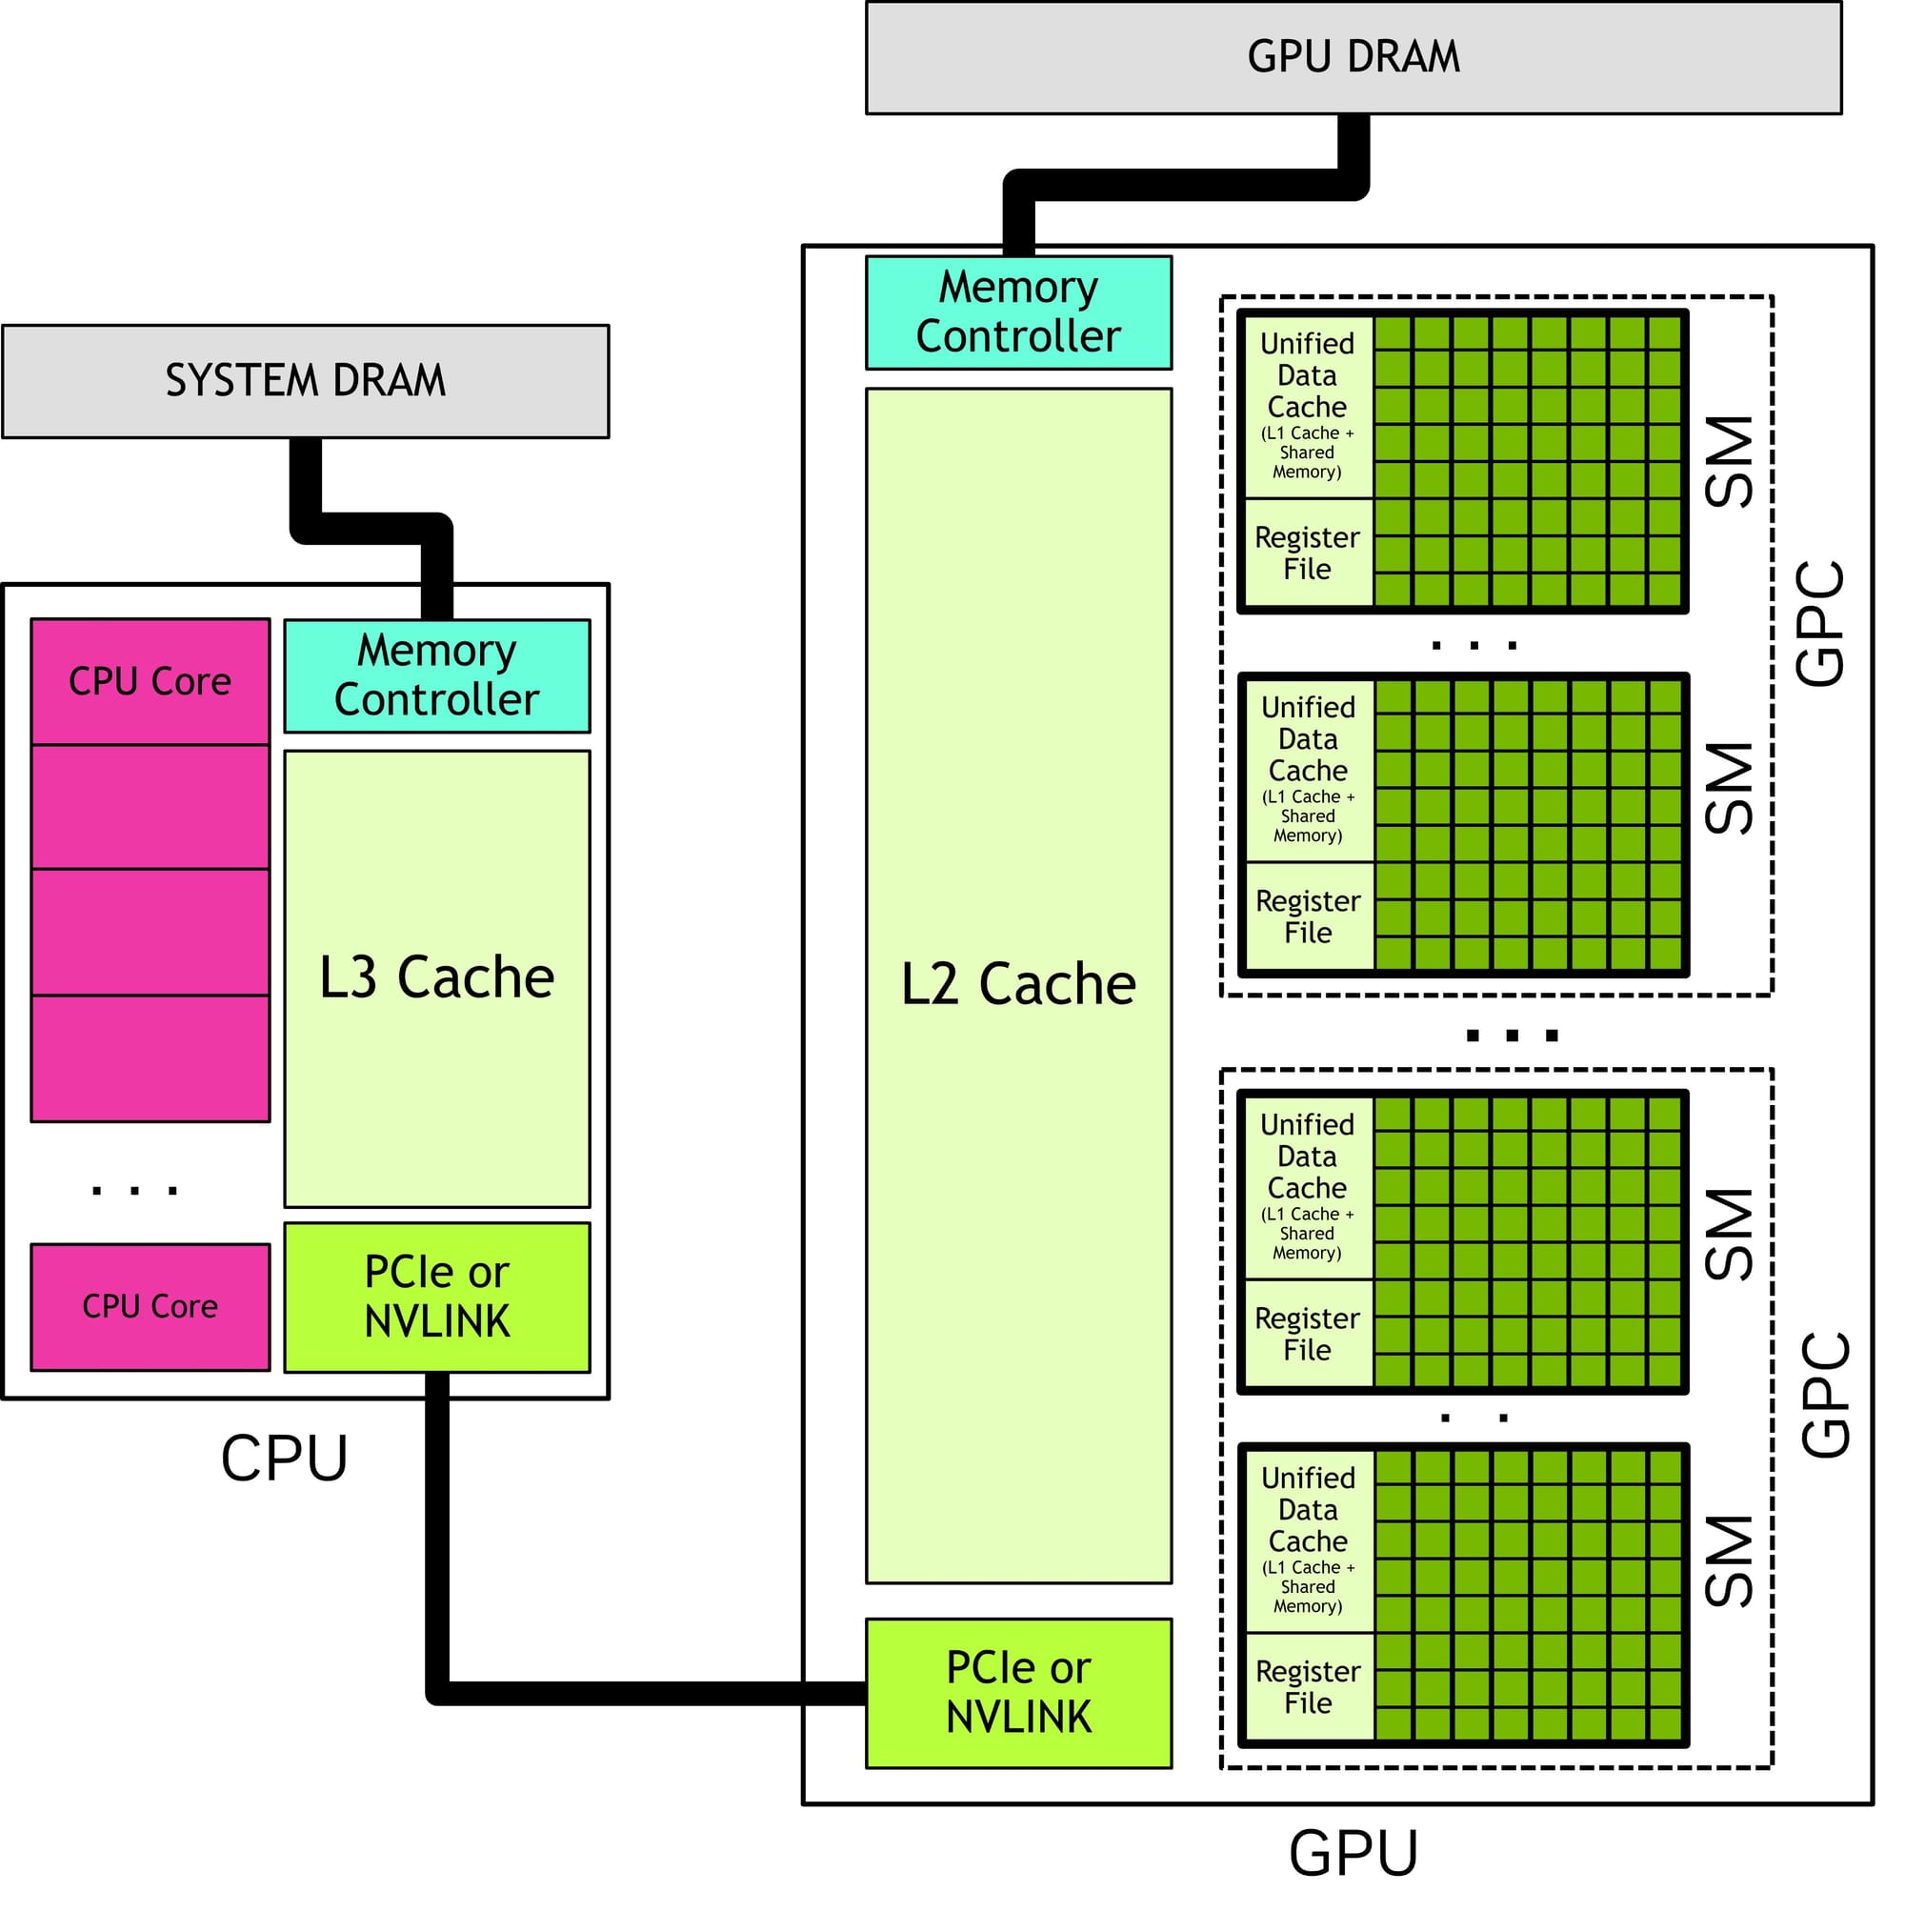
GPU 等待,可能發生在不同層次
一個 AI 請求會經過資料準備、模型運算與結果回傳,任何環節都可能拉長等待。
在運算核心裡,計算可能需要等待下一批資料進入合適的記憶體位置。
在服務系統裡,GPU 則可能等 CPU 啟動下一個工作,或等排程器把請求送進來。
運算核心是實際在 GPU 執行的程式片段。服務系統則負責把使用者請求組織成可執行的工作。
兩種問題的改善方式不同。加快資料搬移,不一定會解決啟動工作的空檔。
因此,不能只看到使用率偏低,就推定需要換更大的 GPU。
記憶體安排,影響資料要走多遠
GPU 有不同層次的記憶體,取用成本與容量並不相同。
CUDA 指南介紹執行與記憶體模型,讓開發者理解工作如何分配,以及資料如何被不同執行單元使用。
若多個計算重複使用相同資料,合理安排資料位置可能減少來回搬移。
但把資料放得更靠近計算,也會佔用有限資源。某個核心更快,可能同時讓可並行的工作變少。
所以優化不能只看單一核心的時間,還要看它放回整個模型與服務後是否有改善。
這也是指南的用途:提供理解機制的語言,讓量測結果有比較清楚的解釋。
服務延遲,還要看請求如何被組成
互動服務的使用者,通常先感受到第一個結果多久出現。
批次處理則更關心一段時間能完成多少工作。兩種目標可能需要不同的排程方式。
例如把更多請求一起處理,可能提高整體吞吐量,卻讓個別請求等得更久。
長前文、短問答與多輪對話,也會產生不同的運算與快取需求,不宜只用一組短提示詞評估。
Wafer 的貼文提到 CUDA Graphs、快取與其他機制,這些方法各自處理不同等待來源。
CUDA Graphs 先記錄一組反覆執行的 GPU 工作,減少每次由 CPU 重新啟動的額外成本。
CPU 是負責一般運算與安排工作的處理器。是否改善延遲,仍取決於工作負載。
是否適合自己的服務,需要用相符的請求資料測試,沒有一項機制能自動解決所有瓶頸。
一次有用的效能實驗,應保留哪些資料?
先固定模型、硬體、套件版本與一份能重複執行的測試資料。
再記錄資料準備、第一個輸出與整個請求完成的時間,區分冷啟動和已經準備好模型的狀態。
若服務面對多人使用,還應模擬相近的請求量,觀察等待時間是否在負載提高後明顯惡化。
每次只改一個主要條件,例如批次大小或快取設定,讓結果比較容易歸因。
輸出品質也要一起檢查。若調整數值格式讓速度提高,卻造成內容或工具參數錯誤,改善就不完整。
這種方法不需要一開始就修改底層核心,但能先找出最值得投入的環節。
常見問題
CUDA 指南是 AI 專用加速工具嗎?
它是 NVIDIA 的 GPU 程式設計文件,提供運算與記憶體機制的說明。實際加速還需要相應實作與測試。
GPU 使用率低,一定代表程式寫不好嗎?
不一定。資料準備、請求量與 CPU 排程都可能造成等待,需要分段量測。
新手需要先寫自己的運算核心嗎?
通常可以先理解與量測現有流程,找出明確瓶頸後,再決定是否需要更深入的底層優化。
結語
Wafer 分享的重點,是把「AI 很慢」拆成可觀察的等待。先量清楚資料、啟動與運算各花多少時間,才能知道哪個改善會真正縮短使用者等待。
延伸閱讀:llama.cpp 接上 Windows ML:本機 AI 專案怎麼選 CPU、GPU 與 NPU?
延伸閱讀:AI 開始優化 GPU 核心:Databricks 排行榜成果,怎麼看才有意義?