小米 MiMo-V2.6 是什麼?Pro、Flash 效能、價格與開源重點完整解析
MiMo-V2.6 Pro 在第三方指數拿到 46 分,但不代表全面超越 Claude、GPT。本文解析模型差異、API 價格、開放權重與部署門檻。
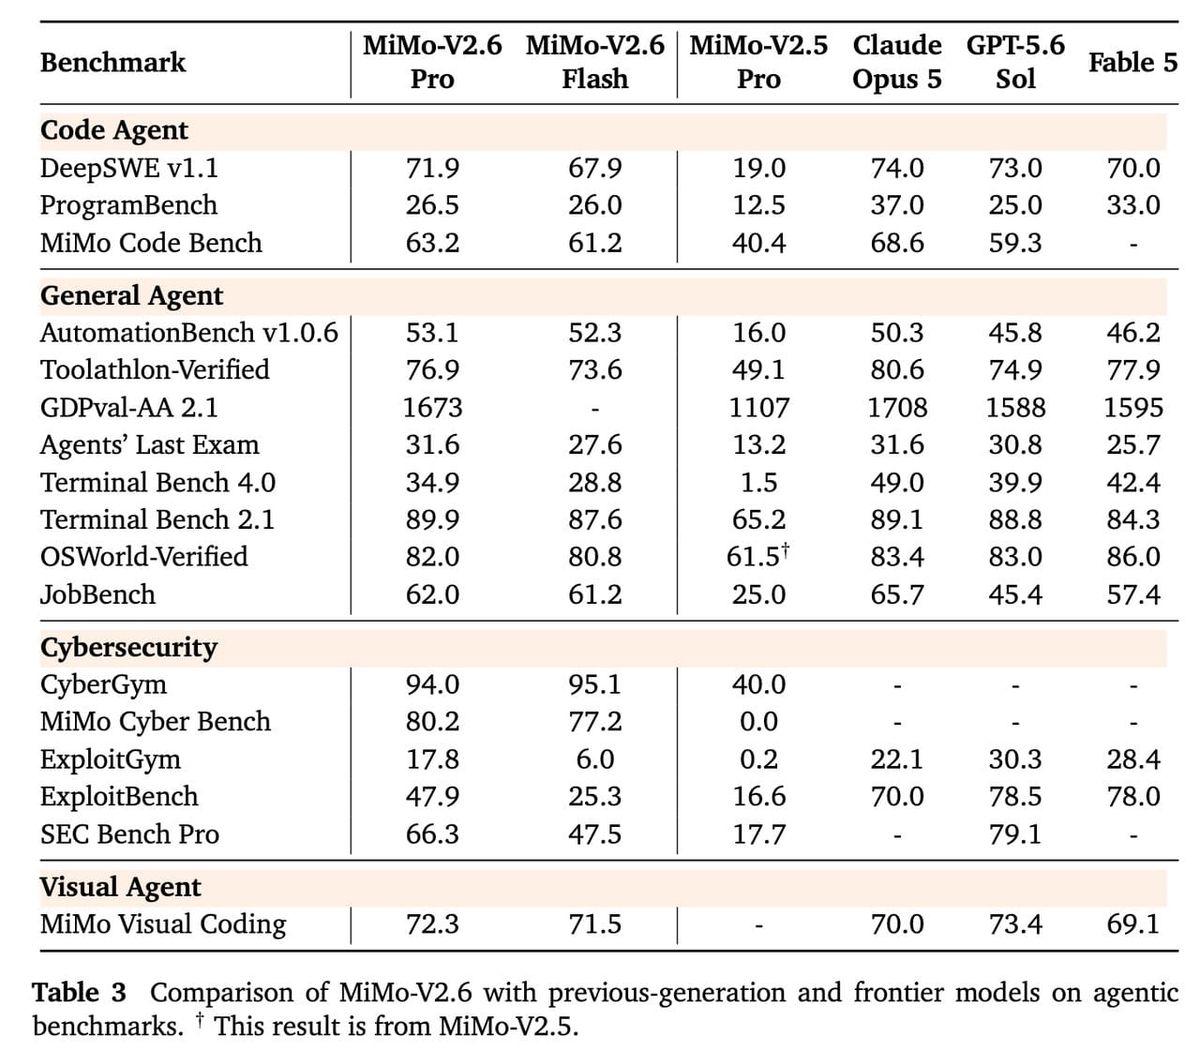
小米在台灣時間 2026 年 9 月 22 日發布 MiMo-V2.6 系列。官方最醒目的說法,是旗艦版 Pro 在多項 AI 代理評測中可與 Claude Opus 5、GPT-5.6 Sol 相比,還在 Artificial Analysis Intelligence Index 拿到 46 分,成為當時分數最高的開放權重模型。
這些成績讓 MiMo-V2.6 很難再被當成手機品牌的附屬 AI 實驗,但「單項分數領先」也不等於所有任務都勝過閉源模型。小米公布的完整表格裡,MiMo-V2.6 Pro 有領先項目,也在部分程式開發與資安測試落後。
本文會從一般使用者真正需要知道的問題切入:MiMo-V2.6 是什麼、Pro 與 Flash 差在哪裡、評測成績應該怎麼讀,以及該用 API(應用程式介面,讓其他軟體呼叫模型)、下載權重,還是先從小型模型開始。
MiMo-V2.6 是什麼?
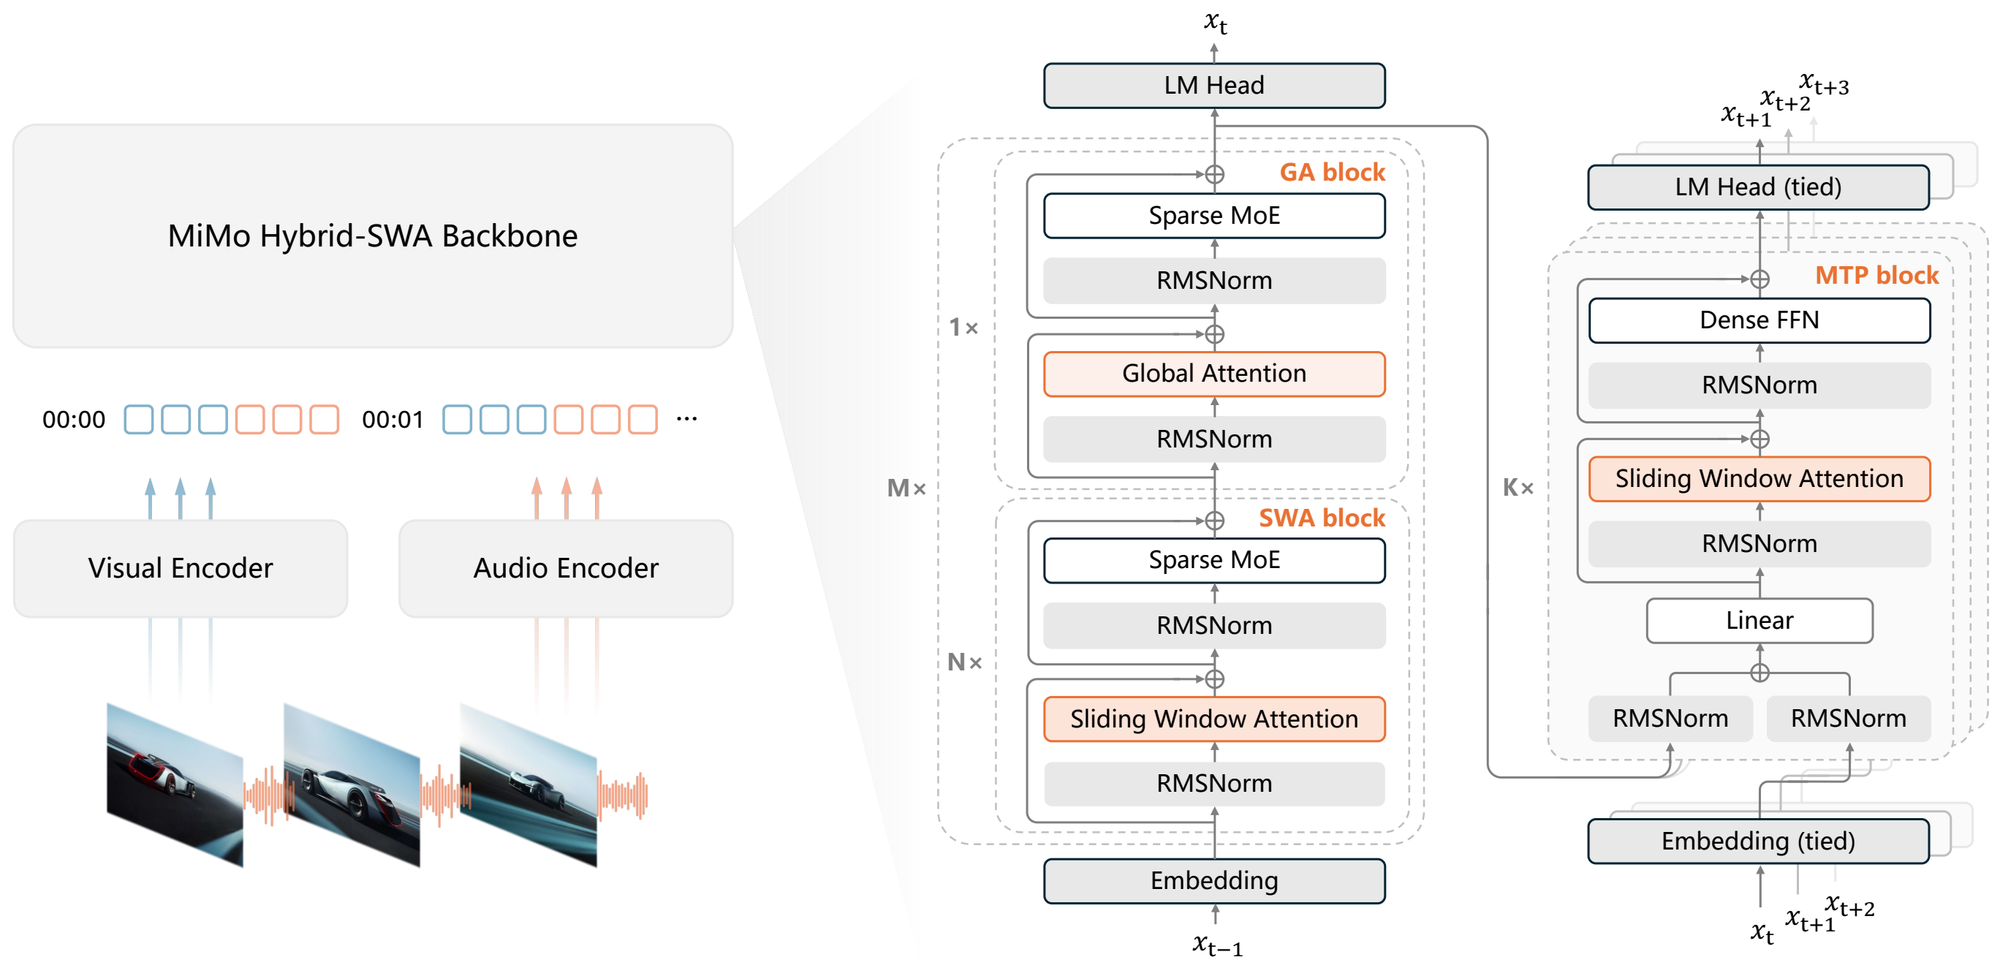
MiMo-V2.6 是小米推出的全模態 AI 模型系列。「全模態」在這裡代表同一個模型可以讀取文字、圖片、影片與音訊,不必為每種輸入另外串接一套模型。官方目前列出的輸出仍以文字為主,因此它不是能直接產生圖片、影片或語音的全能生成工具。
系列主力分成 MiMo-V2.6 Pro 與 MiMo-V2.6 Flash。Pro 追求較高的複雜任務能力,Flash 則把成本與速度放在更前面。小米開放平台另提供 Pro-UltraSpeed,官方把它定位成效能接近 Pro、速度最高可達 20 倍的低延遲版本,但沒有在首發模型卡中公開獨立權重。
三個版本都能透過小米 API 使用。Pro 與 Flash 的模型權重也已放上 Hugging Face,並標示 MIT 授權。這代表開發者可以下載、自行部署及進行商業使用,但仍要自行負責硬體、安全測試與應用合規。
Pro、Flash 與 UltraSpeed 有什麼差別?
MiMo-V2.6 採用混合專家模型(Mixture of Experts,MoE)。它像把不同專長的子模型放進同一個系統,每次處理 token 時只叫用其中一小部分,所以總參數很多,不代表每次推理都要動用全部參數。
| 版本 | 官方定位 | 總參數/啟用參數 | 上下文 | 適合情境 |
|---|---|---|---|---|
| MiMo-V2.6 Pro | 旗艦推理模型 | 1.02 兆/420 億 | 100 萬 token | 長流程代理、複雜程式、研究與高難度工作 |
| MiMo-V2.6 Flash | 效能與成本平衡 | 3,090 億/150 億 | 100 萬 token | 高頻 API 呼叫、批次任務、日常工作流程 |
| MiMo-V2.6 Pro-UltraSpeed | 低延遲 Pro | 官方未公布權重規格 | API 文件未另列差異 | 即時互動與延遲敏感服務 |
上下文視窗是模型單次可接收的資料量。100 萬 token 足以容納大型程式庫、長篇文件與多輪工具紀錄,卻不代表模型一定能在每個位置精準找回資訊。真正部署時,仍要用自己的長文件、工具鏈與錯誤恢復流程測試。
對多數使用 API 的團隊,我會先選 Flash 做概念驗證。它在小米官方代理評測中與 Pro 的差距常只有幾個百分點,海外 API 的輸入與輸出價格卻只有 Pro 的約三分之一。只有當實際任務證明 Pro 的成功率能抵銷成本差距,才值得升級。
MiMo-V2.6 的核心突破:把多種代理任務放在同一輪訓練
大型語言模型通常先學會預測文字,再透過強化學習(Reinforcement Learning,RL)從任務結果獲得回饋。MiMo-V2.6 的重點不只是增加訓練量,而是把程式開發、一般辦公、視覺操作與資安任務混在同一輪強化學習裡。
小米把這套方法稱為「You Only RL Once」。模型不是為每個領域分別訓練,而是在多種任務與代理框架中反覆探索。技術報告顯示,每個訓練步驟會處理 1,568 個提示、各產生 16 條嘗試路徑,合計約 27 億至 37 億 token。這麼大的批次讓模型能比較不同解法,不只判斷任務有沒有完成。
傳統的成功或失敗分數,無法區分兩個都通過測試的答案哪一個更短、更穩定。MiMo-V2.6 加入代理評分器,讓它在同組解法中比較品質,再把較高的學習權重給更好的路徑。這種訓練方向真正有價值的地方,是希望模型在長流程工作中少繞路,而不是只把最終答對率推高。
但「朝自我改進前進」不等於模型已能不受控制地升級自己。它仍是在小米設計的環境、評分器與訓練流程中更新。技術報告也記錄了記憶體不足、路由失衡和評分器中斷等失敗,顯示這套方法仍需要大量工程防護。
MiMo-V2.6 真的追上 Claude Opus 5、GPT-5.6 Sol 嗎?
答案是:在部分代理評測中已進入同一競爭區間,但不能寫成全面追平。
小米在技術報告中把所有可調整推理強度的對照模型設為最高推理等級。MiMo-V2.6 Pro 在 AutomationBench 得到 53.1,超過 Claude Opus 5 的 50.3 與 GPT-5.6 Sol 的 45.8。它在 Terminal Bench 2.1 也以 89.9 小幅領先兩者。
另一面是,Pro 在 ProgramBench 只有 26.5,落後 Claude Opus 5 的 37.0。它在 Terminal Bench 4.0 得到 34.9,也低於 Claude 的 49.0 與 GPT 的 39.9。資安測試的差距更明顯,ExploitBench 為 47.9,而 GPT-5.6 Sol 為 78.5。
| 代表性評測 | MiMo-V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol | 怎麼解讀 |
|---|---|---|---|---|
| AutomationBench | 53.1 | 50.3 | 45.8 | MiMo 在模擬軟體工作流程領先 |
| Terminal Bench 2.1 | 89.9 | 89.1 | 88.8 | 三者接近,MiMo 小幅領先 |
| ProgramBench | 26.5 | 37.0 | 25.0 | 介於兩者之間,未全面勝出 |
| Terminal Bench 4.0 | 34.9 | 49.0 | 39.9 | 複雜終端任務仍落後 |
| ExploitBench | 47.9 | 70.0 | 78.5 | 進階資安能力差距明顯 |
這份比較還有兩個限制。第一,MiMo Code Bench、MiMo Cyber Bench 與 MiMo Visual Coding 是小米內部評測,外界無法只靠表格完整重現。第二,模型發表時的評測容易受到提示、代理框架、工具版本與 token 預算影響。企業若要採用,應用自己的任務跑相同流程,而不是把五個不同測試的高分平均成「誰最聰明」。
46 分代表什麼?第三方評測支持了多少說法
Artificial Analysis 的第三方頁面顯示,MiMo-V2.6 Pro 在 Intelligence Index v4.3.2 得到 46 分。這個綜合指數包含專業工作、終端操作、科學程式、長上下文與推理等 10 類測試。在同級開放權重模型比較中,MiMo-V2.6 Pro 發布時排名第一。
第三方結果支持「MiMo-V2.6 已是第一線開放權重模型」這個判斷,也記錄到小米 API 約每秒輸出 130 個 token。可是它沒有證明 MiMo 在每種工作都超過所有閉源模型。綜合分數適合用來篩選候選模型,採購與部署仍要看自己的成功率、輸出長度、延遲和錯誤成本。
因此,我對 MiMo-V2.6 的能力評價是中性偏多。最強的證據來自第三方綜合評測與多項公開代理測試。若後續獨立測試顯示它對不同工具鏈不穩定,或必須消耗明顯更多 token 才取得相近分數,我就會下調這個評價。
MiMo-V2.6 API 價格多少?
小米在 2026 年 9 月 21 日更新海外隨用隨付價格,計價單位為每 100 萬 token。輸入快取命中,是系統重複使用已處理過的提示前綴,因此價格會比首次輸入低很多。
| API 模型 | 快取命中輸入 | 一般輸入 | 輸出 |
|---|---|---|---|
| MiMo-V2.6 Pro | US$0.0036 | US$0.435 | US$0.87 |
| MiMo-V2.6 Flash | US$0.0028 | US$0.14 | US$0.28 |
| MiMo-V2.6 Pro-UltraSpeed | US$0.036 | US$4.35 | US$8.70 |
批次 API 的 Pro 與 Flash 價格再減半,適合不要求立即回覆的離線任務。UltraSpeed 的價格是 Pro 的 10 倍,代表它賣的是延遲,而不是較便宜的運算。如果工作可以排隊處理,選它通常沒有成本優勢。
價格表也揭露一個很實際的產品策略:Flash 才是大量導入的主力,Pro 是複雜任務的升級選項,UltraSpeed 則服務願意為即時性付費的少數場景。這比單看模型參數更能幫助團隊選版本。
開放權重不代表一般電腦就能跑
MiMo-V2.6 Pro 與 Flash 的 Hugging Face 頁面標示 MIT 授權,模型權重可以下載。小米同時釋出技術報告、約 7,000 個程式/資安/一般/視覺強化學習任務,以及一個從 MiMo 蒸餾而來的 90 億參數模型 MiMo-V2.6-Distill-Qwen-9B。
「蒸餾」是用大型模型產生的經驗與資料訓練小模型,讓小模型用較低成本學到部分能力。技術報告顯示,這個 9B 模型再接受領域強化學習後,在報告列出的 11 項評測全部比只做監督式微調時更高。這項開放內容對研究者的價值,可能比 1.02 兆參數的 Pro 權重還大,因為更多團隊有機會實際重現訓練。
相較之下,Pro 官方 SGLang 部署範例使用兩台節點,並在每台配置 16 路張量或專家平行。Flash 範例也需要多 GPU 平行。這已說明兩個主模型不是一般消費級電腦的本機工具。想先試用的人應從 AI Studio、Desktop 或 API 開始。研究訓練流程的團隊,才適合從 9B 蒸餾版切入。
MiMo-V2.6 適合誰?怎麼選版本?
如果只是想測試文字、圖片、音訊與影片理解,先用 MiMo Studio 或 API,不必一開始就下載權重。需要大量分類、摘要、程式輔助與批次工作流程的團隊,Flash 通常是比較合理的起點。
長流程代理、複雜研究或高價值程式任務,可以把 Pro 納入同一套評測。重點是比較「完成一個可接受任務的總成本」,而不是只比較每百萬 token 單價。Pro 若能減少重試,總成本可能更低。若成功率沒有明顯提升,Flash 會更划算。
UltraSpeed 只適合語音助理、即時客服或互動式開發環境等延遲直接影響體驗的工作。至於本機部署,除非團隊已具備多 GPU 基礎設施與模型維運能力,否則 API 的門檻低得多。
FAQ
MiMo-V2.6 是小米手機內建的 AI 嗎?
MiMo-V2.6 是小米的通用 AI 模型系列,不只服務手機功能。開發者可以透過 MiMo Studio、Desktop、API 或公開權重使用,應用範圍包含程式、辦公流程、視覺理解與代理任務。
MiMo-V2.6 可以直接生成圖片、影片和語音嗎?
官方模型卡列出的能力是接收文字、圖片、影片與音訊,再輸出文字。它能理解多種媒體,不代表主模型可以直接產生圖片、影片或音訊檔案。
MiMo-V2.6 是開源模型嗎?
較準確的說法是開放權重模型。Pro、Flash 與 9B 蒸餾版的權重已公開,Hugging Face 頁面標示 MIT 授權,小米也公開部分訓練環境與框架。完整預訓練資料並未隨權重一併公開,因此「開放權重」比「所有內容完全開源」更精確。
MiMo-V2.6 能取代 Claude 或 GPT 嗎?
它已在部分代理評測達到相近或更高成績,但也在其他測試落後。是否能取代既有模型,要看實際工具鏈、錯誤率、延遲、token 用量與資料部署要求,不能只靠單一榜單決定。
一般使用者應該選 Pro 還是 Flash?
先選 Flash。它的價格較低,官方表格中的多項日常代理成績又與 Pro 接近。只有當自己的測試顯示 Pro 在關鍵任務有足夠高的成功率提升,再為 Pro 的較高費用買單。
結論:MiMo-V2.6 的意義,在於開放模型開始競爭完整代理工作
MiMo-V2.6 最重要的訊號,不是某一張榜單超過 Claude 或 GPT,而是開放權重模型開始同時競爭程式開發、桌面操作、視覺工作與長流程工具使用。46 分與多項公開評測證明它值得進入企業候選名單,MIT 授權、公開訓練環境與 9B 蒸餾版則降低了研究門檻。
目前我會把 MiMo-V2.6 評為「值得測試,但不宜只看宣傳就全面換模」。一般 API 工作先用 Flash,複雜高價值任務再與 Pro 做同題比較。只有低延遲真的能轉化為收入或體驗時,才考慮 UltraSpeed。若後續獨立實測能重現小米公布的跨工具穩定性,而且 token 消耗沒有顯著膨脹,MiMo-V2.6 才算真正把開放權重代理模型推進到前沿。