【深度專題】4DV.AI 帶你親身走進電影場景:一篇文看懂「4D 潑灑技術」
4DV.AI打造出能「自由視角重看」的4D影片技術,結合3D高斯與4D神經體素,讓你用一張RTX 3090就能即時渲染動態場景,重建聲音、畫面與運動的全貌。

想像重看《神隱少女》時,你不必跟著宮崎駿安排的鏡頭走;你可以站在湯婆婆辦公室俯瞰整個湯屋、跟在無臉男身後看他如何默默跟蹤千尋、甚至登上那班神秘夜車,選擇任何座位感受不同的離別氛圍。
這種「想看哪就看哪」的觀影自由,已經實現了。
這是中國AI新創 4DV.AI 所實踐的技術突破「4D Gaussian Splatting」,簡稱 4D-GS:讓每部影片都變成可以自由探索的4D時空舞台。讓你從影片的旁觀者,變成場景的參與者。
如果 NeRF 開啟了用 2D 照片重建 3D 世界的序幕,那麼 4D-GS 就是走向下一個維度的篇章。
什麼是 4D Gaussian Splatting?
目前我們看影片時,只能被動接受導演安排的視角。
傳統影片就像一面牆,觀眾只能站在固定位置觀看畫面,無法移動、也無法深入。即便 3D Gaussian Splatting 技術,也只能針對靜態畫面做新視角渲染,一旦遇到角色移動、物體變形、光影閃爍等動態變化時,也束手無策。
4D-GS,打破了這個限制:把「時間」正式納入建模,從 3D 邁向 4D。
換句話說,它讓影片不再只是「播放內容」,而是轉化為一個隨時間變化的虛擬空間——觀眾可以自由移動視角、調整觀看時間,像走進一座影像劇場一樣,體驗每個角落、每個瞬間。
不是單純按下播放,而是像打開一個舞台,你可以從任何角度進入、觀察,甚至自由移動時間軸。
4D Gaussian Splatting 讓影片變成一個開放式空間、一個「舞台」,觀眾不再是旁觀者,而是能自由移動視角的參與者。
這項技術的核心,來自兩個關鍵要素的結合:
1. 3D Gaussians:用霧狀粒子構成空間
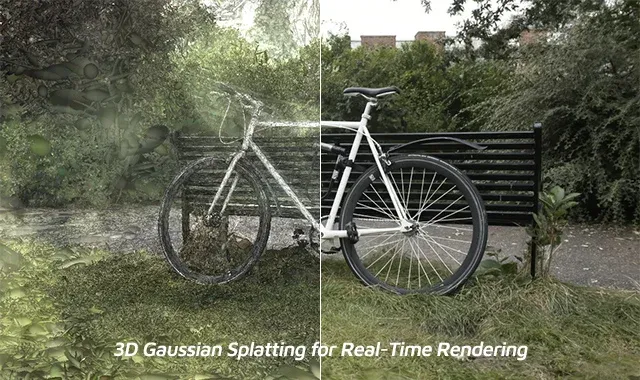
所謂的 3D 高斯橢球,其實就是一種模糊但有彈性的粒子表示方式。你可以把它想像成空氣中漂浮的小霧球,每顆霧球帶有顏色、透明度、形狀等資訊,組合起來就能構成立體的人臉、建築、場景,甚至動態中的光影紋理。
這些粒子不像傳統電腦圖像那樣硬邦邦,而是具有模糊與過渡的柔性,可以更自然地捕捉影像細節,就像用一群「可調光的微型燈泡」畫出整個世界。
2. 4D Neural Voxels:把時間塞進像素裡
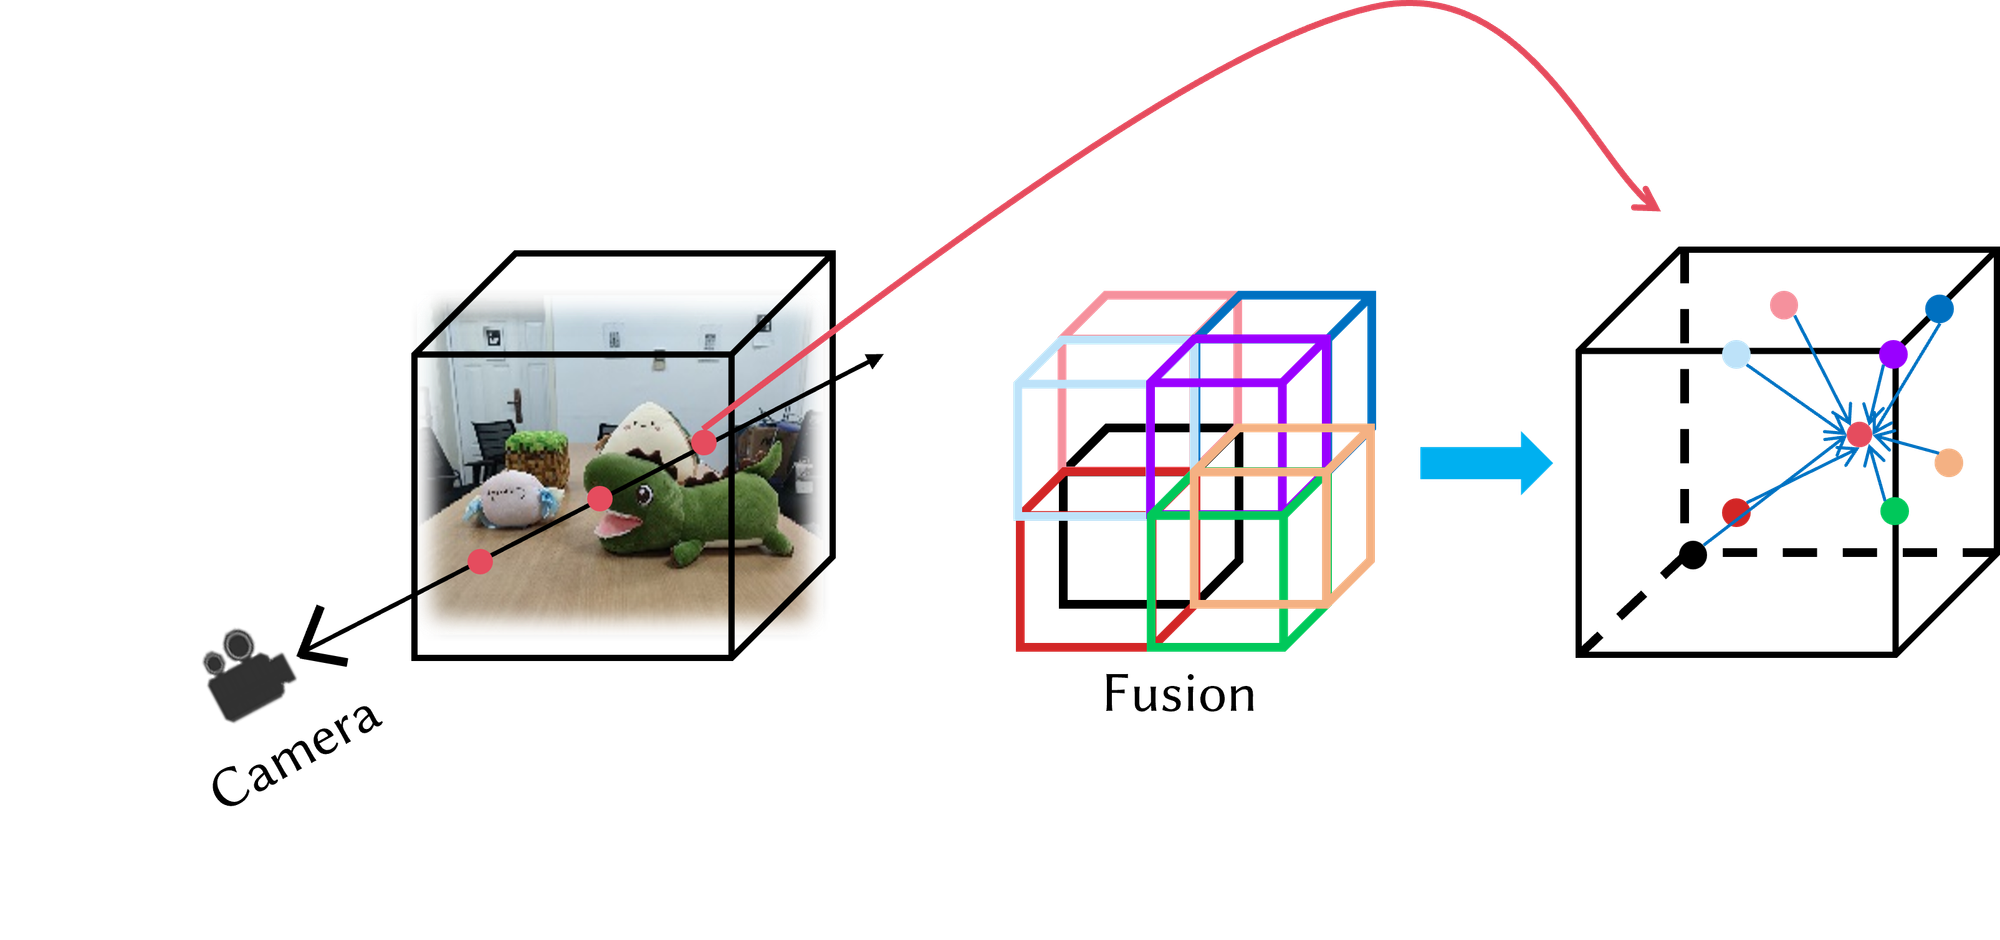
「體素」就像是 3D 空間裡的像素方塊,而加上「時間」這一維度,就變成了 4D Neural Voxels。這意味著,系統不僅知道每個粒子在哪裡,還知道它在什麼時間點、怎麼移動、怎麼變形,甚至能預測接下來的狀態變化。
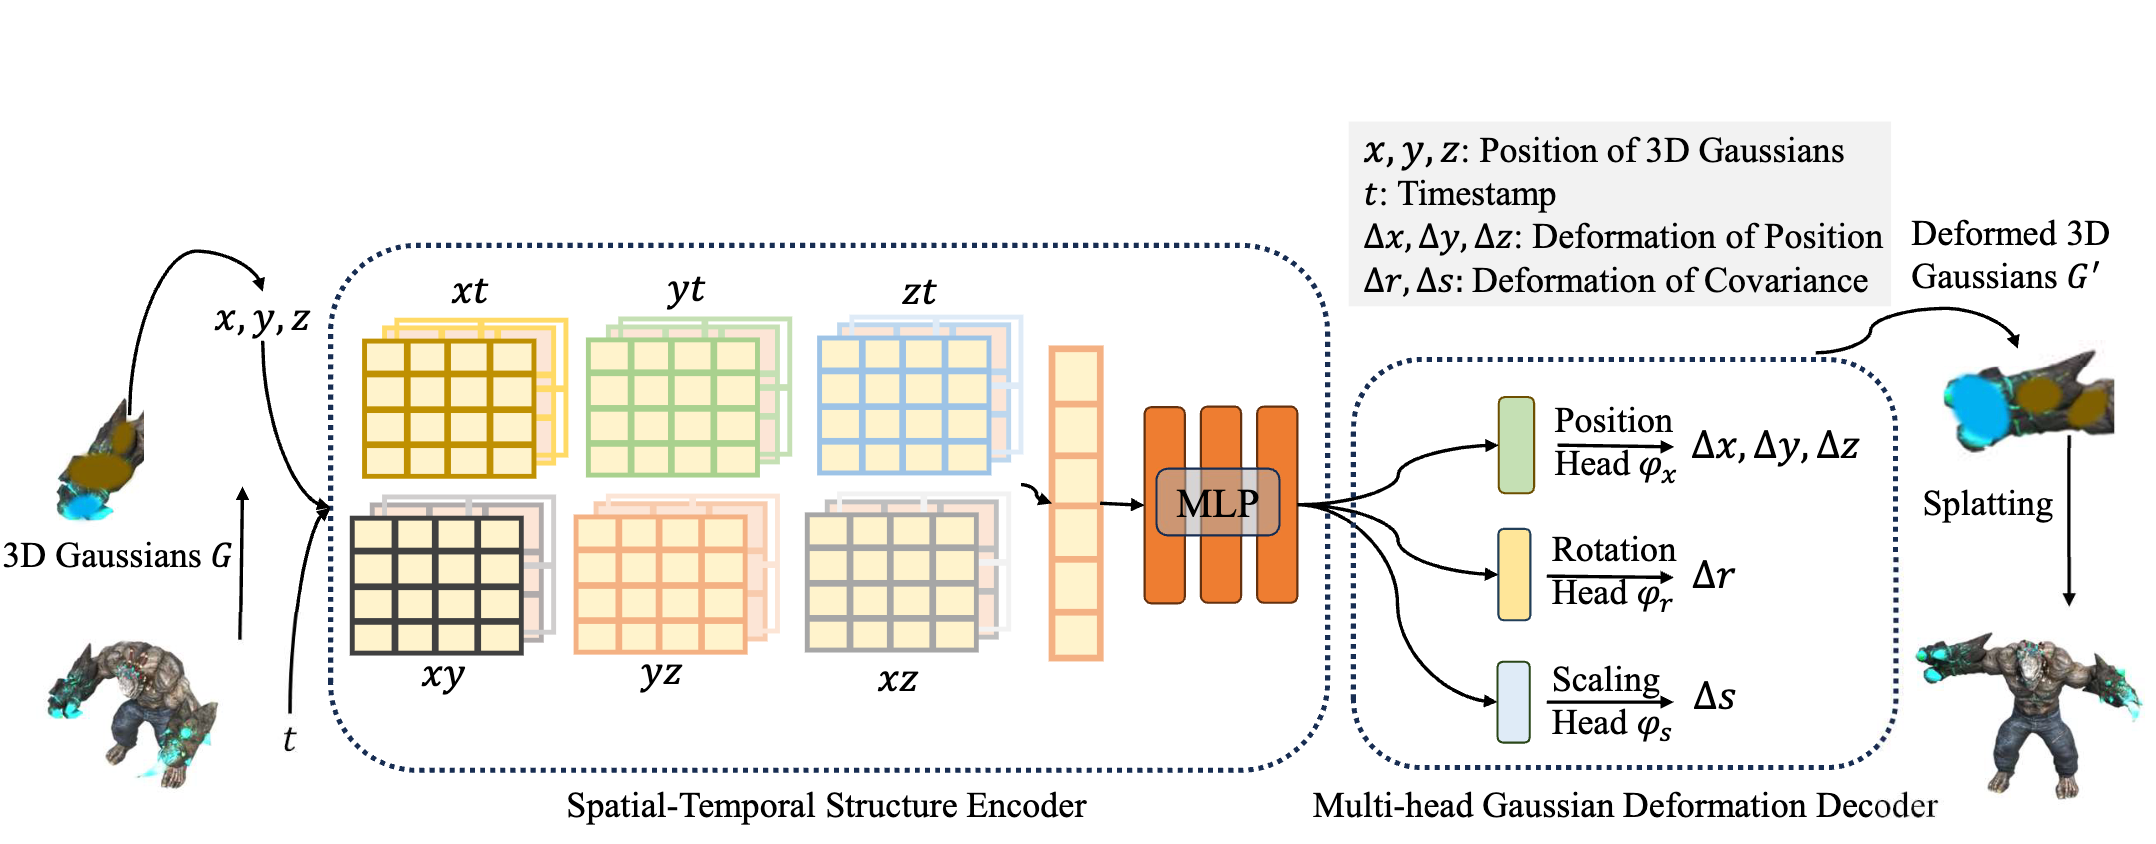
4D-GS 將這些時空資料餵進一個神經網路,結合受 HexPlane 啟發的體素編碼方式,配上一個小巧但聰明的 MLP 解碼器,讓每一顆高斯粒子都能根據時間即時變形,反映出畫面中人物的動作、環境的光影、甚至物理上的遮擋與遮蔽。
最後,這些變形後的高斯粒子會透過differentiable splatting(可微潑濺)方式,快速渲染到畫面上,讓整個流程達到高品質、即時、動態、可互動的完美平衡。
性能與突破:真的能跑起來嗎?
最令人驚訝的是,這一切不是在超級電腦上運算——而是在單張 RTX 3090 顯示卡上即時跑出來的。
- 渲染速度高達 82FPS(800x800 解析度)
- 支援動態音效與任意視角切換
- 訓練與儲存比傳統 NeRF 更快、更省資源
這代表著:一段普通的手機影片,不需要任何特效或深度鏡頭,也能被轉成「可自由探索的虛擬空間」,而且不需要等很久,也不需要專業設備。
技術背景來自頂尖學術論文
這項技術不是一時話題,而是扎扎實實地來自 CVPR 電腦視覺頂會的論文,解決了 NeRF 的三個瓶頸:
- 無法即時渲染(太慢)
- 動態畫面模糊、不穩(動作處理差)
- 資料需求龐大(耗能、難部署)
研究團隊提出「統一式場景表示法」,不再每一幀重新重建,而是用一套完整的 4D 資料結構,搭配一個輕量神經網路(MLP)即時預測每個高斯點的變化。
他們在各大 benchmark 上展現出極強成績,圖像清晰度指標(PSNR、SSIM、LPIPS)全面超越現有主流方法,包括 TiNeuVox、HexPlane、K-Planes 等。
這不只是學術上的突破,更是為「真實世界可部署」邁出的一大步。
媒體互動的未來,從「播放」走向「參與」
這項技術代表了什麼?我們或許可以用一個比喻來總結:
NeRF 是一張立體的畫;
4D Gaussian Splatting 則是一場你能自由走進的戲劇。
對於電影、遊戲、VR、教學、甚至社群媒體而言,這都將是一場重塑形式與敘事的革新。以下幾個場景,可能在不遠未來成真:
- 電影成為舞台劇:不再只是坐著看,而是走進去看。
- 遊戲變成影片重組器:你可以用現實影片拍素材,拼出互動遊戲場景。
- 社群媒體的「3D Reels」:貼文不再只是影片,而是一段可轉可拉的互動體驗。
目前技術雖強,但仍有挑戰:
- 大動作場景(如體育賽事)容易失真;
- 單鏡頭輸入在訓練上容易過擬合;
- 真實應用上仍需整合攝影、光線處理與 AI 推論模型。
當「影片當世界重建」的想法正在被實現,背後不只是模型表現強,更是一種媒體觀的轉變。
我們將不再只是觀眾,而是影像世界的探索者
你過去看影片,是導演給你一段故事;
未來你看影片,是走進一個場景,由你自己選擇怎麼觀看。
4D-GS 不只加速了演算法,而是提出一種全新的觀看邏輯與媒體架構,讓影片的本質從記錄轉變成體驗與重現。
不管你是電影導演、遊戲開發者、VR 創作者,甚至只是喜歡拍生活短片的創作者,這項技術都會改變你的敘事方式。
我們已經從影片的觀眾,走向影片的「探索者」。
4D-GS 的技術讓人意識到,影片不該只是一段從A點播到B點的內容,而可以是一個空間、一場舞台、一個時間軸上的數位宇宙。
當影片可以被探索、重新組裝、甚至互動控制,我們對「內容」的想像也將跟著轉變。未來我們觀看的,不是別人拍好的故事,而是我們能自由探索的「記憶實境」。
下一次你說要「重看一遍」時,也許真正的意思是,從另一個角度,重新體驗一次。
source: 影視颶風, 4DV.ai, 4D Gaussian Splatting