AgentBug-Smith 是什麼?把 AI 代理框架錯誤變成可重現的測試
AgentBug-Smith 自動重現真實 AI 代理框架錯誤,建立含 200 個案例的 Live-Harness-Bench。本文解釋重現與修復的差別,以及為什麼執行框架也需要獨立的品質評估。

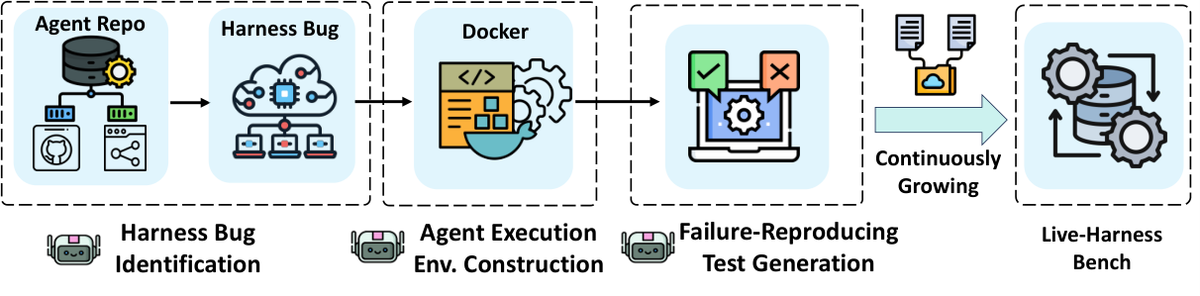
AgentBug-Smith 是自動重現 AI 代理框架錯誤的研究工具。代理框架負責安排模型、工具、對話狀態與任務流程;這一層出錯,即使模型能正確回答,也可能讓整個工作無法完成。
研究於 2026 年 9 月 29 日公開,近期在 X 被分享。它將開源專案中的錯誤報告轉成可以執行的案例,讓團隊能用相同條件檢查問題,而不必每次都從一段模糊描述開始。
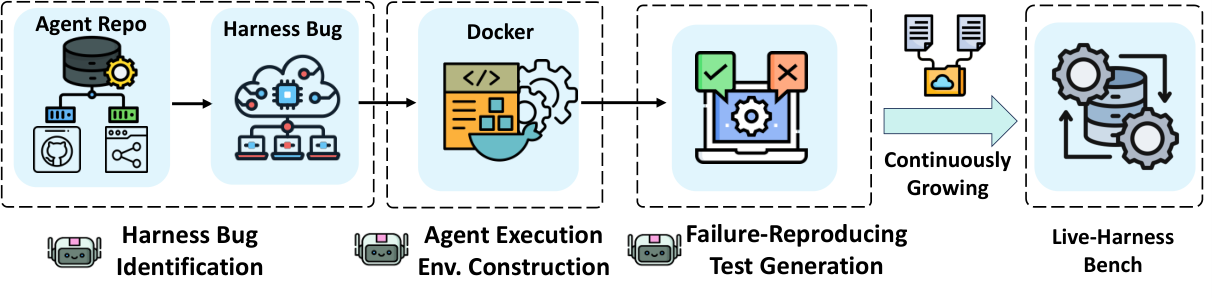
Harness 為什麼會影響代理表現
Harness 常譯為代理執行框架,負責把模型放進實際工作環境。例如模型要求搜尋檔案後,框架要呼叫工具、處理結果,再把資料交回模型。
如果工具結果沒有正確傳遞,或多個步驟的狀態不同步,模型可能讀不到已完成的工作。這類問題看起來像 AI 判斷錯誤,原因卻可能在周邊程式。
依原始論文,真實框架錯誤具有特殊性,一般軟體修復評測提供的案例不足,人工整理可執行資料又需要大量時間。AgentBug-Smith 因此從真實開源系統持續取得問題。
重現錯誤,和修好錯誤是兩件事
錯誤重現是建立一個流程,讓問題在指定環境下再次出現。修復則需要修改程式,並確認原本失敗的行為恢復正常。
AgentBug-Smith 的主要工作是把報告中的線索轉成可執行案例,包括環境與觸發步驟。研究報告在不同基礎模型下,重現框架錯誤的成功率優於比較方法。
這個成果不能直接寫成「自動修好所有代理錯誤」。重現提供的是可靠起點,後續修復仍要確認改動是否處理真正原因,以及是否影響其他行為。
Live-Harness-Bench 如何成為評測資料
研究者用 AgentBug-Smith 建立 Live-Harness-Bench,論文版本包含 200 個可重現的框架錯誤。它是一個可持續擴充的評測集,之後新增案例時,總數也可能改變。
| 階段 | 產出 | 能回答的問題 |
|---|---|---|
| 蒐集報告 | 真實問題與線索 | 哪些框架行為失敗 |
| 重現 | 可執行的錯誤案例 | 問題能否穩定出現 |
| 修復評估 | 修改與驗證結果 | 程式代理能否處理原因 |
| 知識整理 | 可重用的修復經驗 | 類似問題如何更快定位 |
研究再用這些案例評估軟體代理,發現修復真實框架錯誤仍有明顯限制。這讓評測更接近代理產品每天面對的整合問題。
為什麼真實案例比漂亮示範更有用
示範通常選擇能成功的路徑,錯誤報告卻包含使用者真的遇到的中斷、相容性或狀態問題。把它們整理成測試,能讓新的模型或框架版本接受同樣挑戰。
評測仍需要鎖定版本、相依套件與外部條件。如果每次環境不同,成功或失敗就不容易比較。持續擴充資料也要保留案例版本,避免把新舊結果直接當成同一張排行榜。
我的判斷是,這項研究對代理開發團隊的價值,在於把故障轉成能重跑的知識。與其只留下聊天紀錄,保存最小重現案例更能支持後續修復與回歸檢查。
常見問題
200 個案例都是模型推理錯誤嗎?
它們針對代理執行框架的真實錯誤,涵蓋周邊系統行為,不能全部歸因於模型。
重現成功代表修復成功嗎?
不代表。重現證明問題可觸發,修復還需要修改後的驗證。
程式與資料在哪裡?
官方儲存庫 提供專案與評測資料入口,使用時應記錄所採用的版本。
結語:讓故障成為可以反覆驗證的證據
AgentBug-Smith 與 Live-Harness-Bench 將代理系統的真實錯誤整理成可執行案例。當修復能依同一套條件反覆檢查,團隊才比較容易知道系統是否真的改善。