RLVR 與 GRPO 怎麼訓練推理模型?Sebastian Raschka 公開教學再受關注
Sebastian Raschka 分享推理模型訓練教學,示範 RLVR 與 GRPO。本文解釋可驗證獎勵、群組比較與小模型實作,說明教學成果和正式大型模型部署的差別。

RLVR 是使用可驗證獎勵的強化學習,讓模型依答案是否符合可檢查條件得到訓練訊號。GRPO 則是一種比較同題多個候選答案的訓練方法,能把候選結果的差異用來調整模型。
AI 教育作者 Sebastian Raschka 近日在 X 分享約 87 分鐘的實作教學,查詢時已有超過 6 萬次瀏覽。這個教學把抽象的推理模型訓練拆成程式步驟,適合想理解模型如何從回答問題進一步學習解題的人。
推理模型的教學從哪裡開始
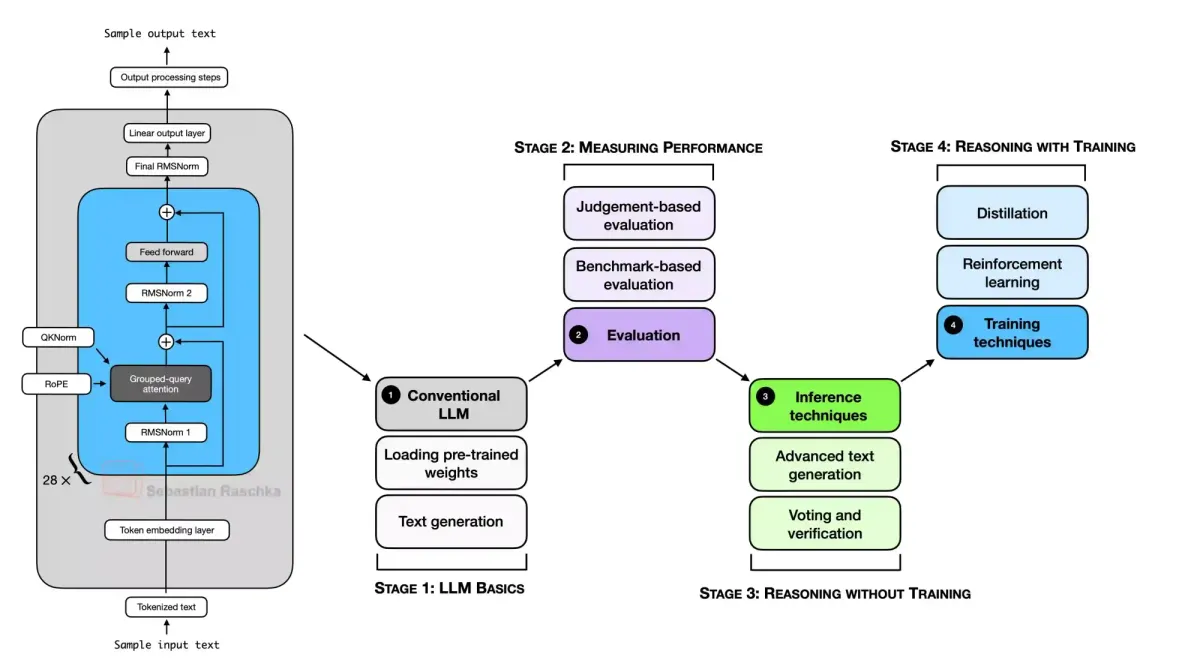
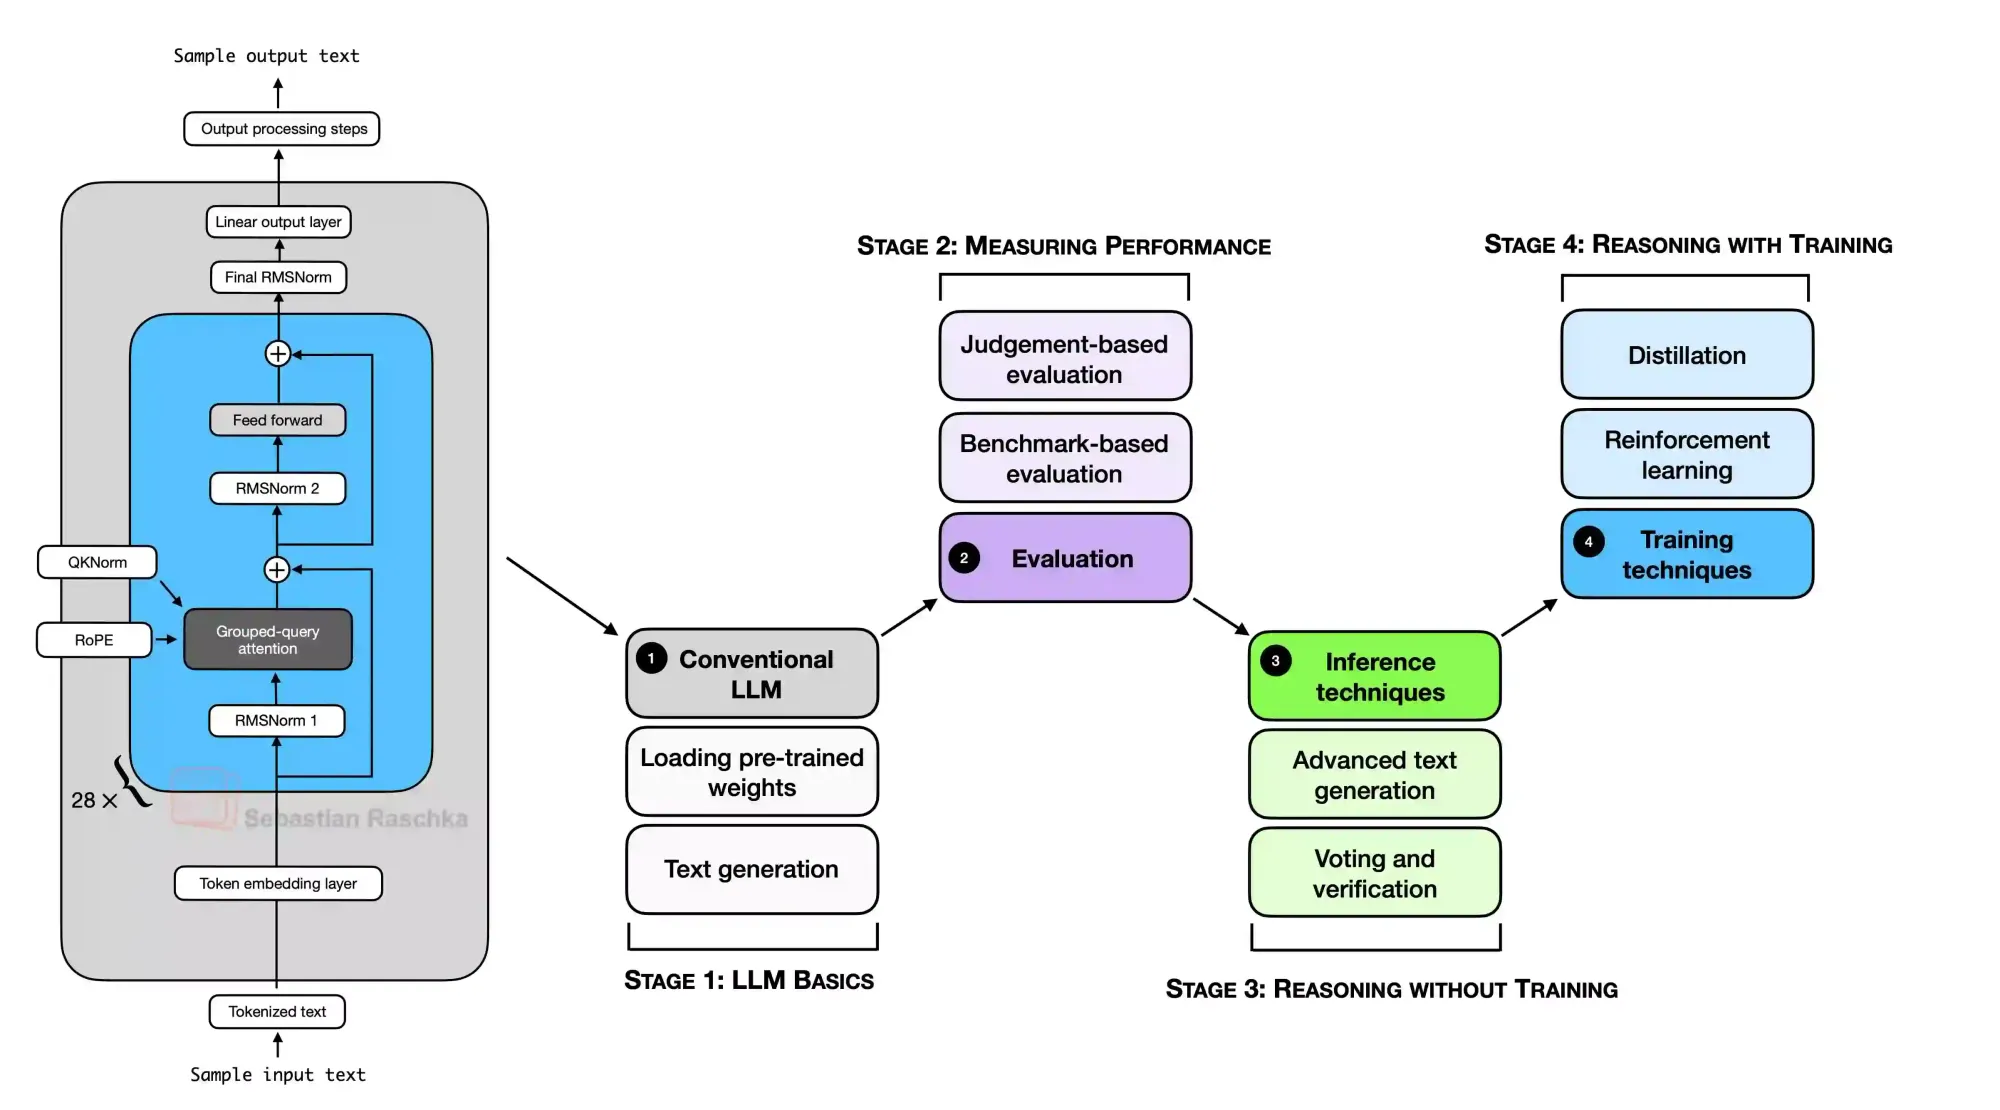
官方程式儲存庫 是《Build a Reasoning Model (From Scratch)》的配套資料。作者使用已預訓練的基礎模型,逐步加入推理相關的方法,目標是建立小型、可運作的教育示例。
基礎模型已具備語言生成能力。後續訓練則讓它在特定任務上調整行為,例如產生解題過程與可檢查答案。這條路徑有助於把預訓練、後訓練與推論時的不同工作分開理解。
教學示例的規模、資料與資源,和大型商用推理模型不同。它的價值在可讀的實作與概念驗證,不能直接當成正式產品的能力保證。
RLVR 的獎勵怎麼驗證
強化學習會根據結果給獎勵,再調整模型之後產生相似行為的機率。RLVR 使用能以程式檢查的條件,例如數學答案是否正確,或程式是否通過指定測試。
這種方法減少每個答案都需要人打分的負擔,但驗證器也要可靠。若只檢查最後一個數字,可能無法知道中間推導是否合理;如果測試太少,程式也可能只碰巧通過範例。
因此,獎勵規則決定模型被鼓勵做什麼。設定清楚的題目與驗證範圍,是訓練之前的重要工作。
GRPO 為什麼要一次產生多個答案
GRPO 會針對同一個問題產生一組候選答案,計算各自獎勵,再比較候選在群組中的表現。相對表現較好的答案,提供模型調整的方向。
| 概念 | 作用 | 需要留意 |
|---|---|---|
| 多個候選 | 觀察不同解法 | 生成本身需要資源 |
| 可驗證獎勵 | 評估答案條件 | 規則可能有盲點 |
| 群組比較 | 建立相對訓練訊號 | 全部同分時訊號有限 |
| 訓練後評估 | 檢查能力是否改善 | 要用未拿來訓練的題目 |
群組比較可以減少對額外價值模型的需求,但仍有資料、計算與訓練穩定性問題。理解方法,和能有效訓練出強模型之間,還需要實驗證據。
初學者如何使用這份教材
先看一次資料如何流動:問題進來、模型產生候選、驗證器計算獎勵,再更新模型。理解這條流程後,再讀每個程式元件,會比較容易知道它在解決哪個問題。
開始時可以使用小資料集和少量步驟,確認輸出、獎勵與評估是否一致。不要只盯著訓練獎勵上升,也要檢查保留題目的成功率,以及錯誤答案是否變得更有自信。
我的判斷是,這份教材適合用來建立對推理訓練的具體理解。它能幫助讀者看懂模型發布中的術語,再用可重現的程式與評估確認自己的想法。
常見問題
RLVR 和 RLHF 有什麼差別?
RLVR 使用可程式驗證的獎勵;RLHF 通常依人類偏好資料建立獎勵訊號。實際訓練也可能結合多種方法。
寫出長推理就代表答案更正確嗎?
推理長度和正確性需要分開評估。更長的輸出也可能包含錯誤或多餘步驟。
影片在哪裡?
作者在 X 公開的教學影片 提供完整示範,配套程式則在官方儲存庫。
結語:先看獎勵如何影響行為
RLVR 與 GRPO 把答案評估變成模型學習的來源。從小型實作開始,對照訓練與未見題目的結果,能更清楚理解推理模型真正學到了什麼。