殺入人類同傳 2.3 秒極限區間!阿里發表 Qwen3.8-LiveTranslate:Interleave 交錯架構、Thinker-Talker 雙模、多人語音分離與端到端即時翻譯深度解析
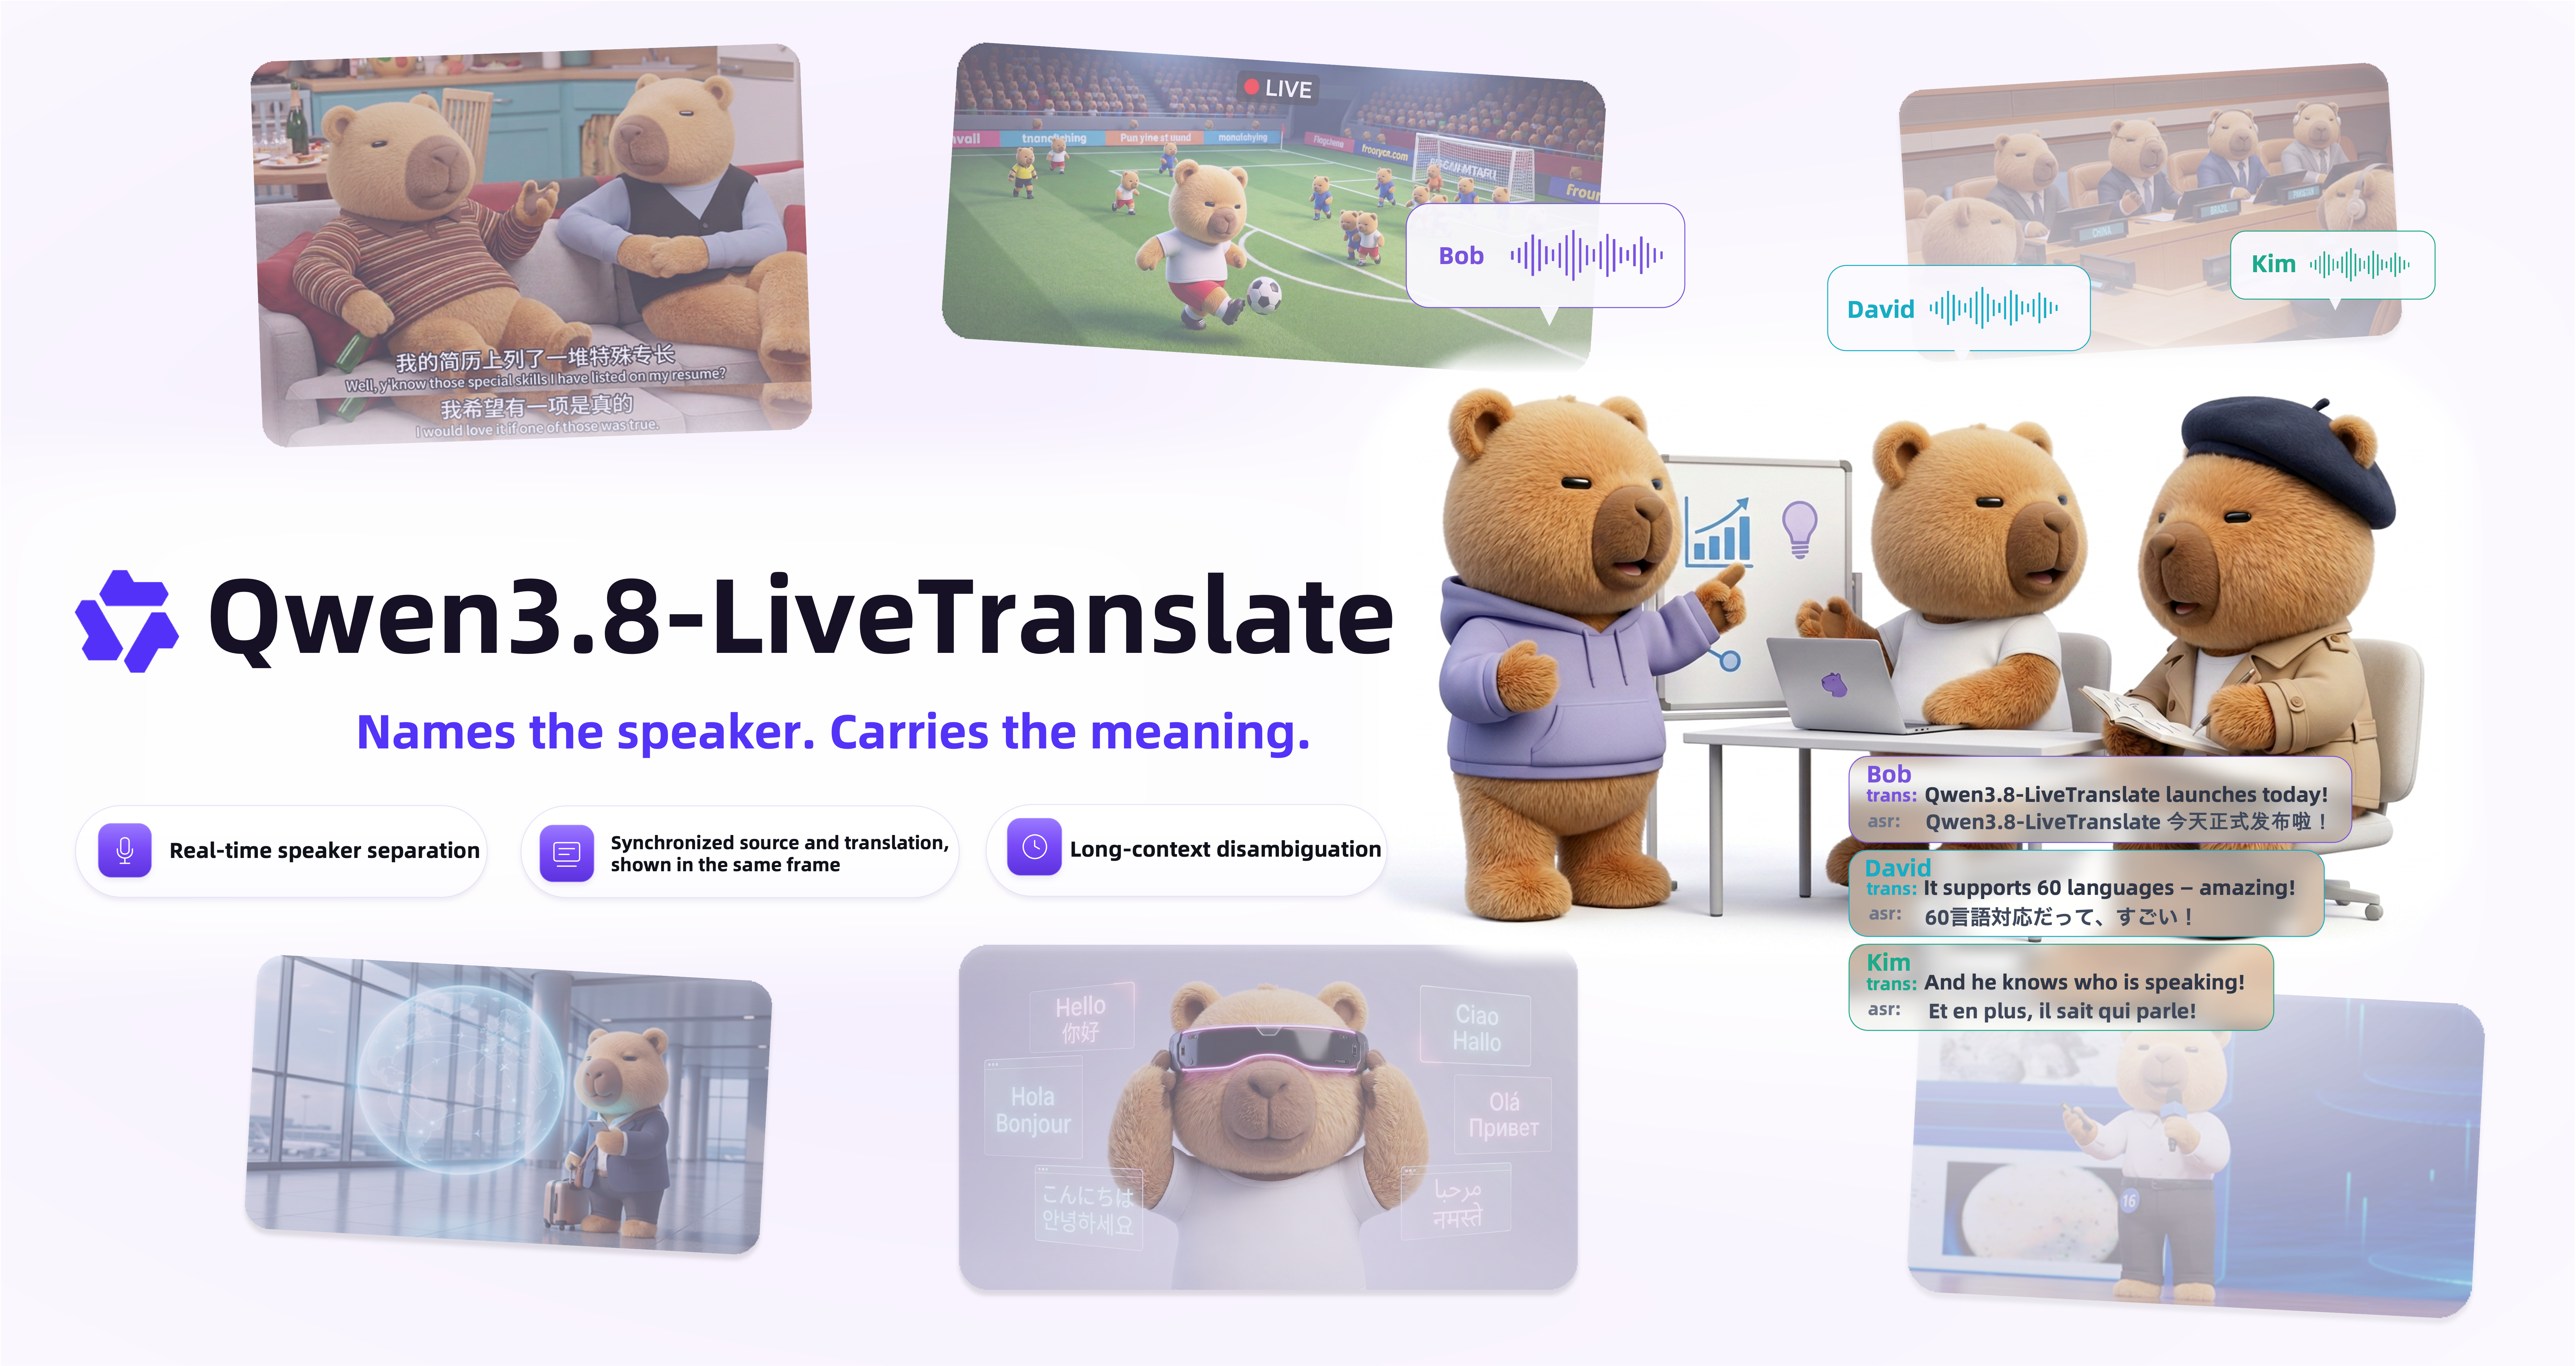
阿里巴巴通義千問團隊正式發表新一代即時同聲傳譯模型 Qwen3.8-LiveTranslate!採用 Interleave 交錯因果架構與 Thinker-Talker 雙模設計,字均延遲突破至 2.3 秒殺入人類專業同傳區間,支援 60 種語言、多人語音分離與雙語同屏流式對齊。
「Simultaneous interpretation is not just translating words; it is the ultimate synchronization of human cognition, listening, anticipating, and speaking concurrently.
With Qwen3.8-LiveTranslate, we reconstruct the interpretation paradigm into a unified audio-text interleaved sequence, breaking the barrier to a 2.3-second average lagging.」
—— 阿里巴巴通義千問團隊(Qwen Team),於官方技術部落格正式宣布(2026 年 9 月 19 日)
2026 年 9 月,全球人工智慧領域的戰火正在以令人屏息的速度,從純文字對話框徹底蔓延至「即時端到端音訊互動」的新大陸。
短短不到十天之內,科技巨頭接連打出底牌:
- 9 月 10 日,OpenAI 官方宣布將旗艦語音模型 GPT-Live-1 全面登陸 API,以每分鐘 0.05 美元的價格祭出「邊聽邊說、任務委派」的全雙工架構;
- 9 月 15 日,Google DeepMind 由 Logan Kilpatrick 領軍重磅發表 Gemini 3.8 Live 與 Extended Thinking,以 82.6% 登頂語音 SOTA,並祭出每小時 0.84 美元的價格屠刀與非同步工具調用;
- 2026 年 9 月 19 日,阿里巴巴通義千問(Qwen)團隊投下震撼彈:正式發布新一代旗艦即時同聲傳譯模型——Qwen3.8-LiveTranslate!(API 識別碼:
qwen3.8-livetranslate-flash-realtime)
如果說 GPT-Live-1 與 Gemini 3.8 Live 解決的是「人機自然對話的停頓與節奏感」,那麼 Qwen3.8-LiveTranslate 鎖定的,則是整個人工智慧語音領域中最難攻克、對即時性與語義保真度要求最為嚴苛的「聖杯場景」——專業即時同聲傳譯(Simultaneous Interpretation)。
在過去,AI 同傳始終面臨難堪的技術死穴:要麼等講者說完一句才翻譯(延遲高達 3~5 秒,淪為「交替傳譯」);要麼生硬切片翻譯(導致語序倒裝、語義割裂、人名與代名詞群魔亂舞)。
這一次,Qwen3.8-LiveTranslate 帶來了顛覆性的架構變革:
- Interleave 交錯因果架構:拋棄傳統拼裝流水線與固定時間分塊,將音訊輸入與文字/語音輸出編排進單一自回歸序列,由模型自主學習「何時聽、何時等、何時譯、何時說」;
- Thinker–Talker 雙模設計(Hybrid-MoE):大腦思考與發音器官解耦並行,Thinker 掌管語意跨模態對齊,Talker 專注極速流式語音合成與零樣本音色復刻;
- 字均延遲(LAAL)縮短至 2.3 秒:相較前代 2.8 秒大幅降低近 18%,正式踩入聯合國頂級同傳譯員的黃金反應時間(Ear-Voice Span);
- 三大新增工程落地能力:即時多說話人分離(Diarization)、雙語同屏幀對齊流式輸出、長上下文語境消歧(人名、術語與代名詞精準還原);
- 廣泛的多語言矩陣:支援全球 60 種語言互譯,其中 29 種提供「語音進、語音出」的完整端到端傳譯。
▲ 阿里巴巴通義千問官方即時同傳實測影片:展示端到端流式因果序列、2.3 秒極限延遲(LAAL)、雙語同屏對齊與說話人音色零樣本復刻。(影片來源:通義千問官方發布)
本文將帶你深入技術底層、架構演變、延遲數學模型與開發者 API 實作,全面解析這場重塑全球跨語言溝通的同傳技術革命。
一、傳統同傳的三大死穴:為什麼 AI 以前做不好同聲傳譯?
要理解 Qwen3.8-LiveTranslate 的含金量,我們必須先明白:即時同聲傳譯(Simultaneous Interpretation)與一般語音助理聊天,在技術維度上完全不是同一個量級的挑戰。
一般語音對話是「你說完了換我說」,屬於交替式的輪流發言(Turn-taking);但同聲傳譯卻要求系統在講者持續發言不停歇的狀態下,一邊接收後續語音、一邊理解消化、一邊將前面講過的內容翻譯成另一種語言輸出。
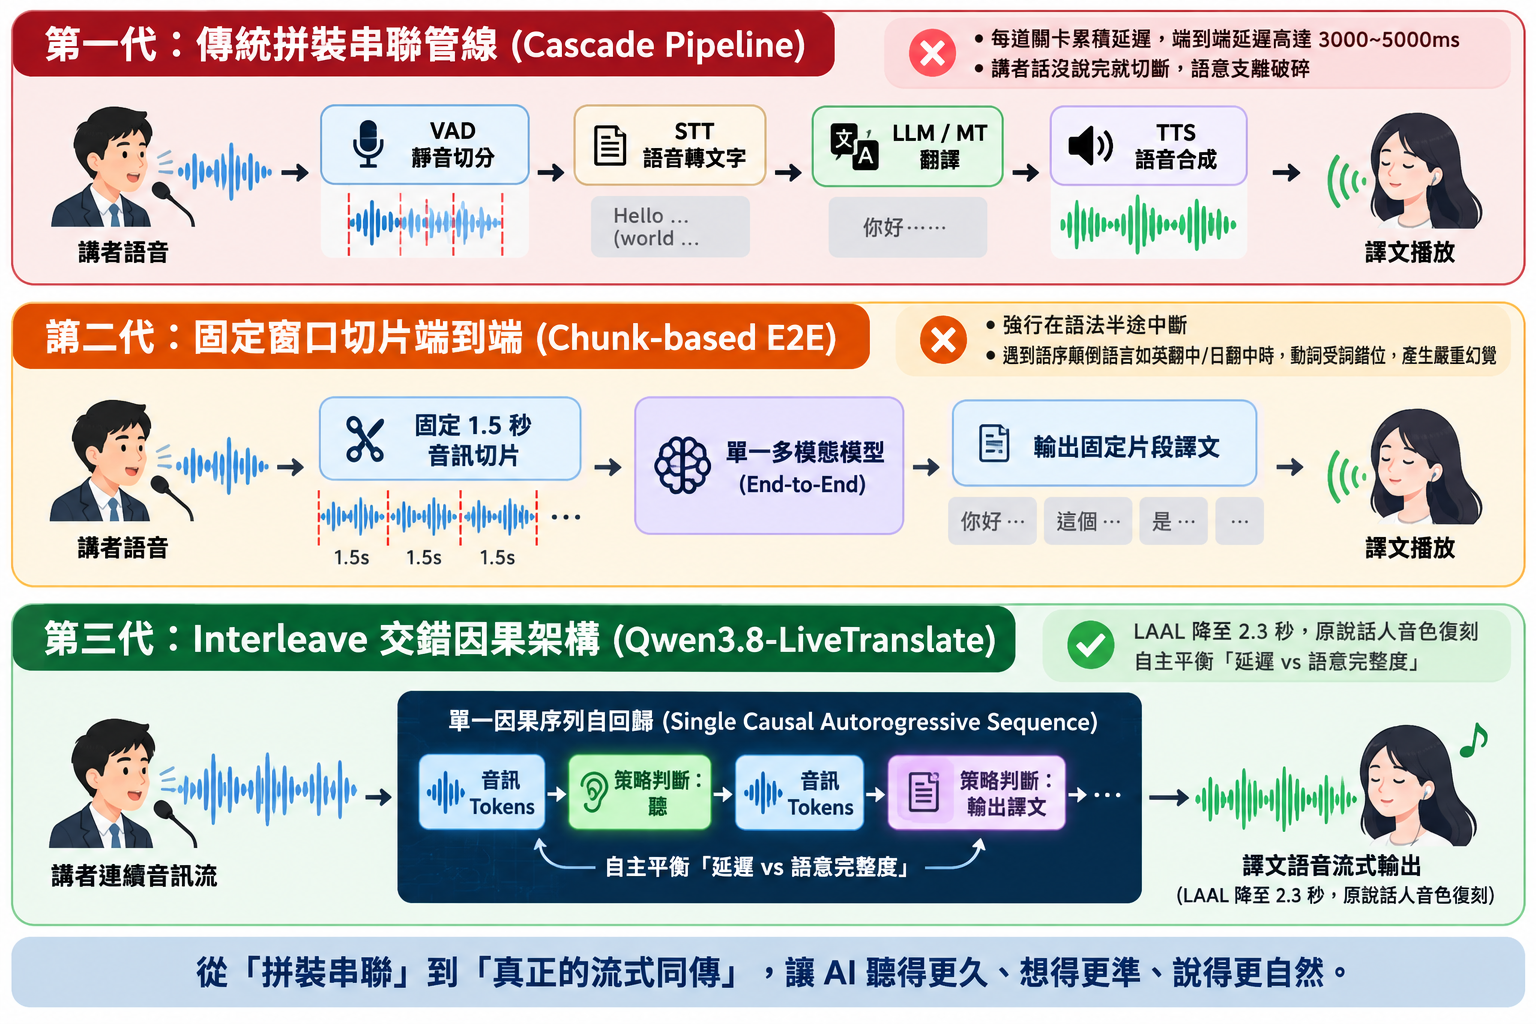
在 Qwen3.8-LiveTranslate 出現前,產業界主要採用兩種方案,但兩者皆有致命缺陷:
死穴 1:語序倒裝帶來的「語意等待僵局」
不同語言之間的語法結構存在巨大差異。例如德語常將動詞放在句尾(SOV),日語也是動詞在後,而英語和中文則是主謂賓結構(SVO)。 如果同傳系統像對講機一樣死板地每隔 1 秒切片翻譯,遇到講者說「I yesterday with my colleague at the headquarters conference room met...」時,AI 在聽到句尾的 met 之前,根本不可能猜出講者到底在會議室做了什麼。 傳統切片模型要麼猜測導致嚴重的幻覺(Hallucination),要麼只能硬生生卡住等待,導致延遲累積崩潰。
死穴 2:串聯管線的「延遲滾雪球效應」
傳統的「STT + 翻譯 + TTS」串聯管線中,每個模組都有自己的內部緩衝區(Buffer)。語音辨識要累積一定幀數才出字,翻譯大模型要累積一定上下文才生成 token,語音合成又要累積數個詞才送進聲學模型算波形。 一來一回,端到端延遲(Latency)輕鬆突破 3 秒到 4 秒。當聽眾聽到的翻譯落後講者整整兩句話時,現場的投影片、肢體語言與即時笑點早已完全錯位。
死穴 3:機器人般的「無差別扁平音色」
在多人對談、圓桌辯論或商務談判中,每位講者有不同的性別、語調、年齡與情緒。傳統同傳產出的往往是一個冷酷、單一的機械播音員嗓音。聽眾閉上眼睛聽翻譯,根本分不清楚現在這句話是買方代表說的、還是賣方律師反駁的。
二、架構革命:Interleave 交錯因果序列與策略學習
為了從底層打破上述困局,阿里巴巴通義千問團隊在 Qwen3.8-LiveTranslate 中全面捨棄了「固定分塊(Chunking)」的思維,引進了Interleave(音訊文字交錯因果序列)架構。
1. 單一自回歸序列中的多模態編排
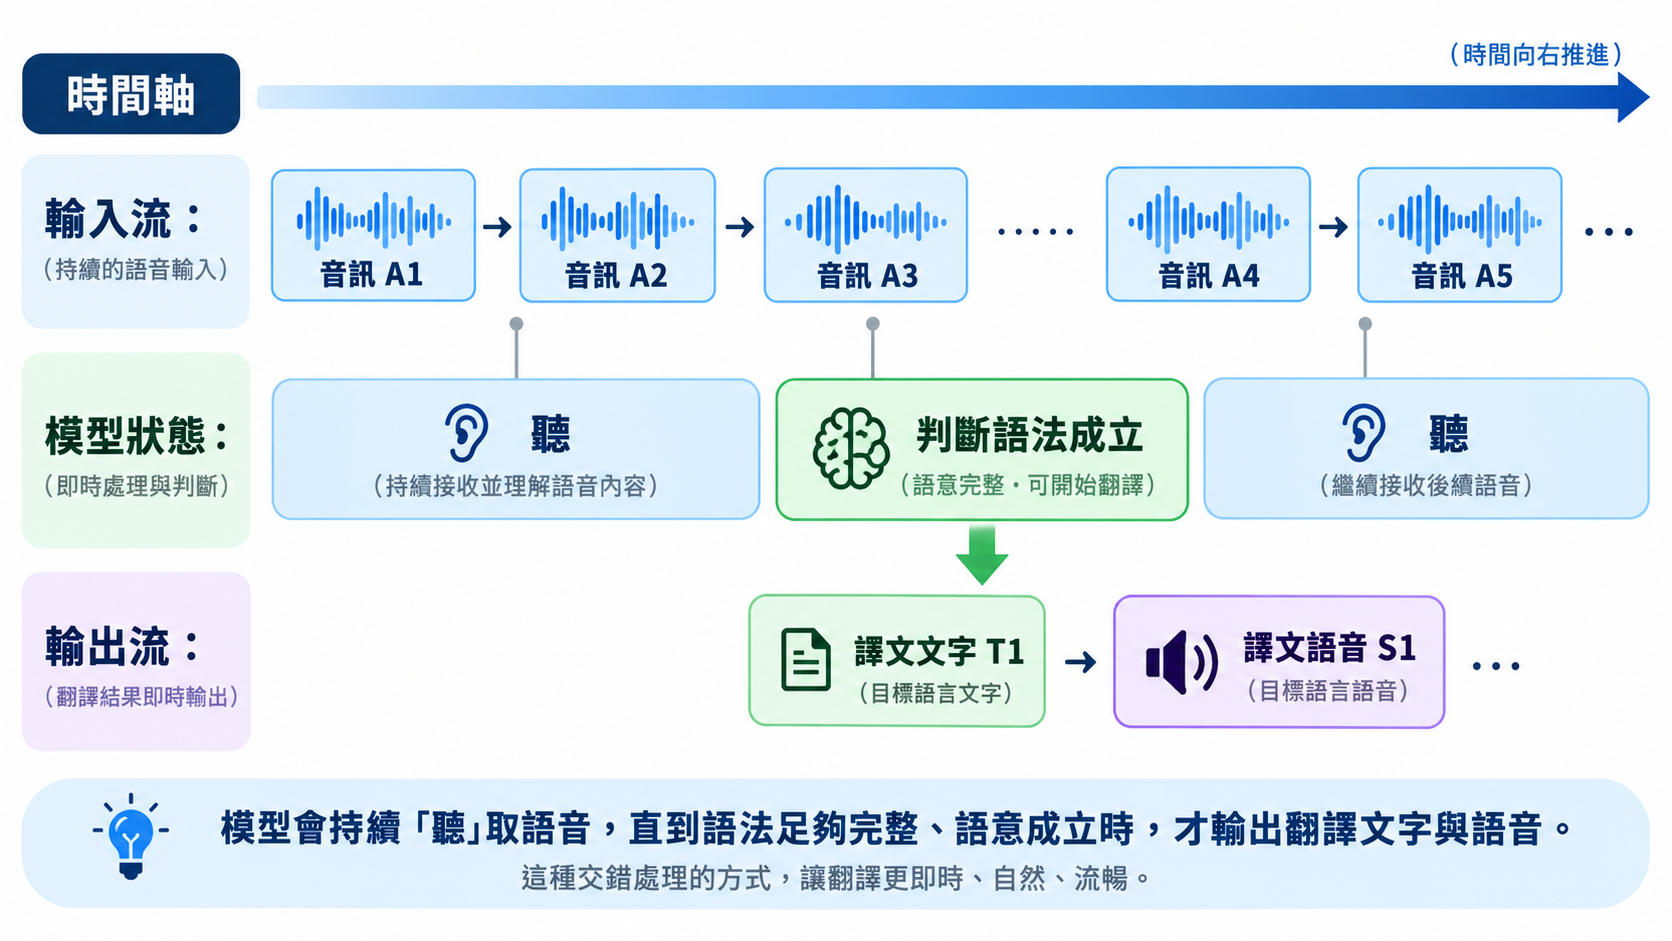
在 Interleave 架構下,系統不再將語音辨識、文本翻譯與語音合成切分成獨立的系統邊界,而是將連續輸入的音訊編碼 Tokens、即時產生的翻譯文字 Tokens、以及待生成的目標語音聲學 Tokens,統整編排進同一條因果注意力(Causal Attention)序列中。
這意味著:
- 模型在「讀取」上一秒鐘的輸入音訊時,其自注意力機制(Self-Attention)可以同時存取幾毫秒前自己剛生成的譯文;
過去生成的譯文與過去聽到的原文,在模型內部形成了一個統一的語義快取(Context Cache),模型不需要反覆在不同模組之間做文字序列化與反序列化。
2. 可學習策略(Learnable Policy):自主權衡「聽 vs 譯」
人類頂級同傳譯員最厲害的本領,不是背字典,而是掌控開口時機(Timing Strategy)——遇到簡單的開場白,可以在聽見 1 秒內立刻跟進;遇到複雜的倒裝長句,則會刻意放慢半拍,等待關鍵動詞出現後再以高度概括的語言平穩切入。
Qwen3.8-LiveTranslate 將這項能力數學化。模型透過大規模優質同傳語料與強化學習(RL),訓練出了一套內生決策策略(In-model Policy):
- 模型在處理每一個時間步(Time Step)時,會自主預測一個「行動標籤」:是繼續維持靜默聆聽(READ),還是開始生成下一個翻譯單元(WRITE);
- 這項機制徹底取代了工程師手動編寫的硬性閾值,使模型能夠在**翻譯忠實度(Faithfulness)、語義流暢度(Fluency)與延遲(Latency)**三者之間達到最佳動態平衡。
三、雙核驅動:Thinker–Talker 雙模設計與音色復刻
在端到端即時語音模型中,業界長期面臨一個算力矛盾:如果要進行深層語意理解,模型參數量必須夠大;但如果模型太大,每秒生成語音波形的推論延遲就會爆炸。
為了解開這個死結,Qwen3.8-LiveTranslate 採用了基於 Hybrid-MoE(混合專家架構)的「Thinker–Talker(思考者與表達者)」雙模設計。
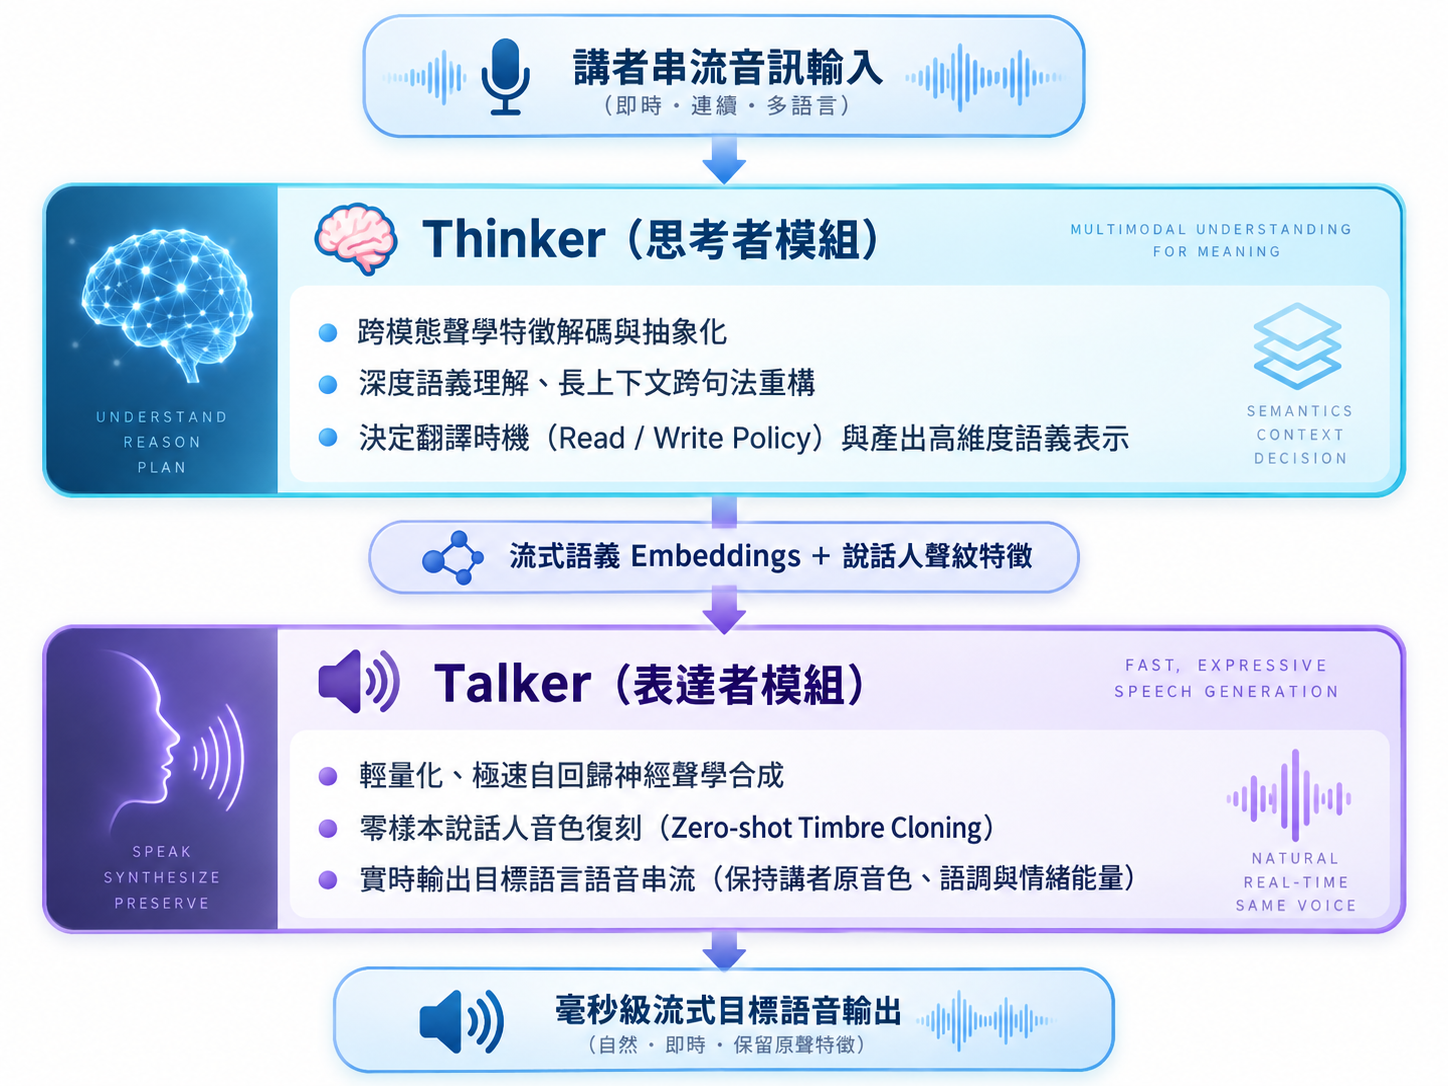
1. Thinker:專注於多模態因果理解與策略
Thinker 模組相當於同傳譯員的「大腦皮層」。它接收經過音訊編碼器處理後的連續頻譜特徵,結合歷史上下文進行多輪語意推導。
- 負責維護長達數千 tokens 的全對話歷史記憶;
- 負責消除歧義,判斷句型骨架,並將語意轉化為高維特徵流;
- 不需要直接計算最終的音訊採樣點,因此可以維持極高的計算效率。
2. Talker:專注於極速聲學生成與音色復刻
Talker 模組相當於譯員的「發音器官與聲帶」。它直接掛載在 Thinker 產出的語義特徵之上:
- 採用專門針對低延遲設計的流式神經聲學解碼架構;
- 零樣本說話人音色復刻(Zero-shot Voice Timbre Cloning):Talker 在接收語意特徵的同時,持續從 Thinker 提取講者的聲紋特徵向量(Speaker Embedding)。當 Talker 開口說英語或法語時,輸出的聲音依然保留了原中文發言者的音色厚度、性別特徵甚至語速節奏;
- 雙模之間採用非阻塞式管線調度(Pipelined Concurrency),確保聲音輸出的平穩連貫,杜絕了語音卡頓與抖動。
四、2.3 秒 LAAL 延遲深潛:AI 首次踏入人類同傳黃金區間
在即時翻譯領域,評估延遲不能只看「首字等待時間(TTFT)」,因為講者說話是一個連續過程。業界最權威的衡量指標是 LAAL(Length-Adaptive Average Lagging,長度自適應平均延遲)。
什麼是 LAAL?
簡而言之,LAAL 衡量的是:在保證翻譯完整度的前提下,系統輸出的譯文相較於講者發言內容,平均在時間軸上落後了多少秒。
$$\text{LAAL} \approx \text{講者說出某個語義核心的時間點} - \text{系統輸出對應翻譯的時間點}$$
如果 LAAL 太小(例如 0.5 秒),系統在還沒聽清主詞動詞前就胡亂搶翻,錯誤率必定飆升;如果 LAAL 太大(例如超過 3.5 秒),聽眾就會感受到明顯的資訊滯後,無法進行即時眼神交流與互動。
| 指標 / 模型 | 前代 Qwen3.5-LiveTranslate | Qwen3.8-LiveTranslate | 業界傳統拼裝方案 (Cascade) | 聯合國頂級人類同傳員 (EVS) |
|---|---|---|---|---|
| 平均延遲 (LAAL) | ~2.8 秒 | 2.3 秒(大幅降低近 18%) | 3.5 ~ 5.0 秒 | 2.0 ~ 3.5 秒 |
| 延遲波動標準差 | ±0.7 秒 | ±0.3 秒(極度平穩) | ±1.5 秒(經常因切分不均卡頓) | 動態自適應調節 |
| 跨語言語法適應 | 中等 | 極高(自主辨識倒裝) | 差(需人工調整 VAD 閾值) | 專家級預判 |
| 端到端音色保留 | 單一預設嗓音 | 原生即時音色復刻 | 需額外串接 TTS 音色模型 | 保持原人語意,但由譯員發音 |
為什麼 2.3 秒是關鍵里程碑?
在口譯翻譯學中,有一個經典概念叫做 Ear-Voice Span(EVS,耳音差 / 法文稱為 Décalage)。無數實證研究顯示,一名受過嚴格訓練的專業同傳譯員,其標準的耳音差通常維持在 2.0 秒至 3.5 秒 之間。
- 低於 2 秒:人類譯員也無法預判語義走向,容易造成錯譯重翻;
- 高於 3.5 秒:譯員的工作記憶(Working Memory)會被超載的原文塞滿,導致嚴重的聽覺過載與漏譯。
Qwen3.8-LiveTranslate 將平均延遲壓制在 2.3 秒,標誌著 AI 第一次在工業級部署環境下,真正達到了與人類資深口譯員相同節奏的「認知同頻區間」。
五、三大新增殺手鐧功能:解決真實商務場景的最後一哩路
除了延遲的大幅下降,Qwen3.8-LiveTranslate 這次最受企業與開發者矚目的,是三個專門針對真實會議與直播痛點開發的核心功能:
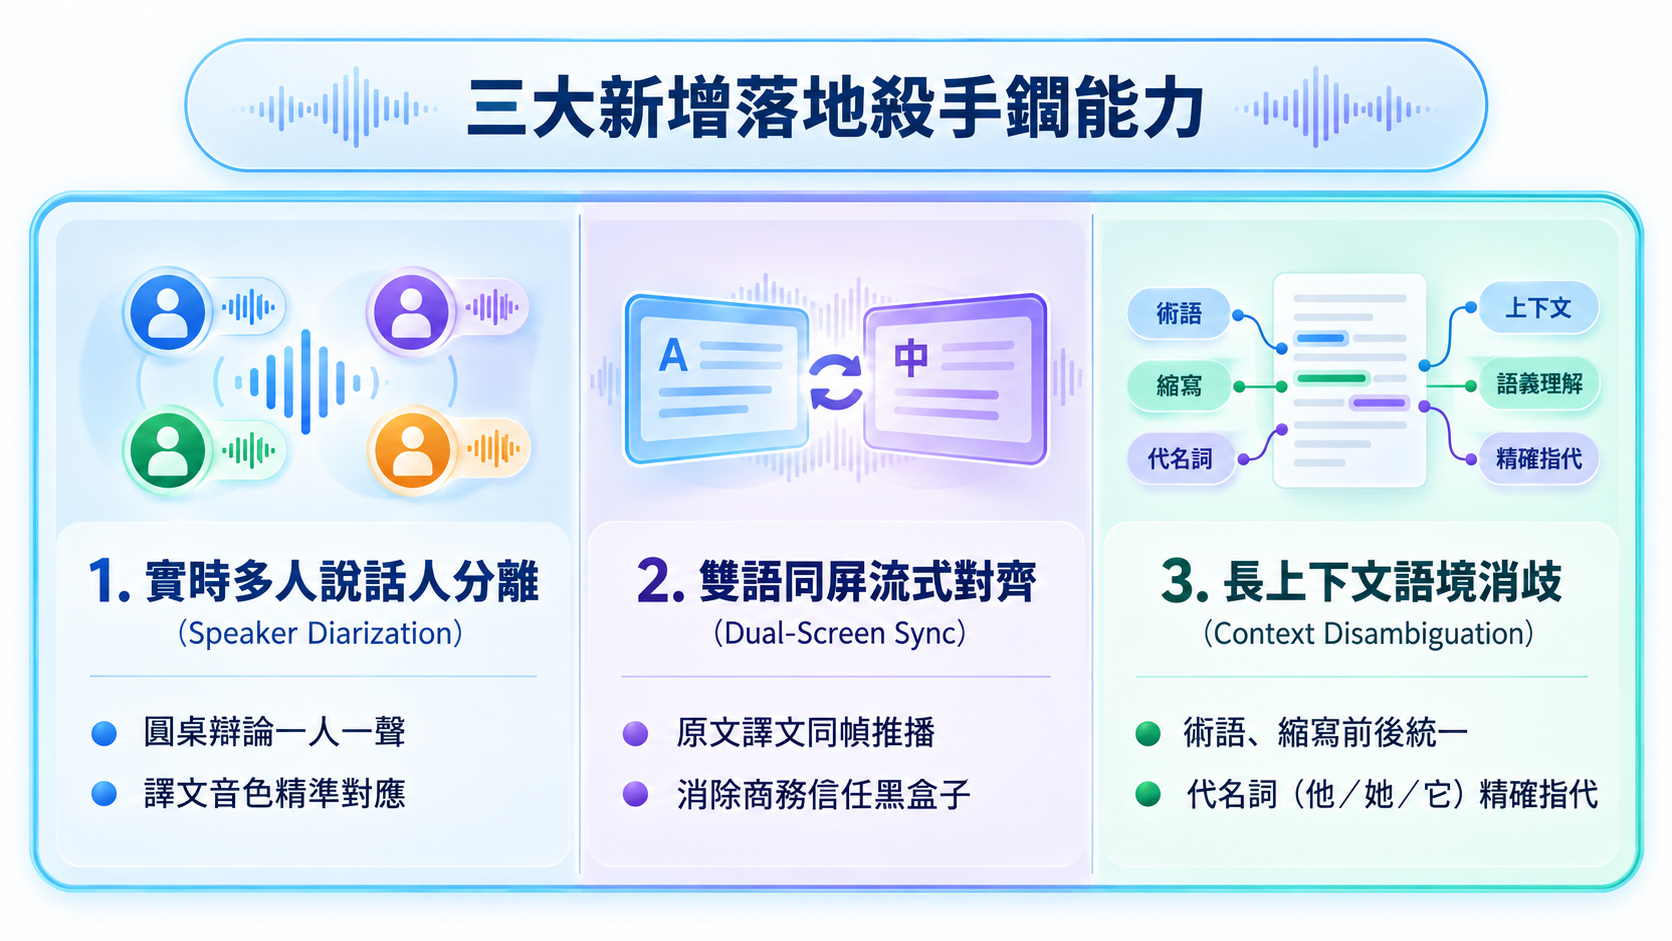
1. 實時說話人分離(Speaker Diarization)與音色分軌
在多方電話會議、法庭聆訊或投資人電話會中,常出現多人交替發言甚至輕微重疊。 Qwen3.8-LiveTranslate 內建了即時說話人聚類演算法:
- 當系統偵測到講者從「發言者 A(男性、低沉嗓音)」切換為「發言者 B(女性、明亮嗓音)」時,Thinker 會在因果序列中打上說話人標記;
- 隨後,Talker 會在毫秒級時間內動態切換聲紋參數,使輸出的目標語言即時變換為對應的男聲與女聲;
- 這徹底告別了過去「全場只聽一個 AI 播音員分不清誰在說話」的混亂局面。
2. 雙語同屏同幀流式輸出(Synchronized Dual-Screen Stream)
在跨國商業併購談判或醫療會診等高風險場合,聽眾往往不只想要「聽」譯文,還需要「看」原文以供核對。 Qwen3.8-LiveTranslate 在 WebSocket 協議中原生支援雙軌數據推播:
- 原文字幕串流(Source ASR Stream)與譯文字幕串流(Target MT Stream)具備完全一致的時間戳錨點(Timestamp Anchors);
- 終端顯示介面可以實現完美的「左右對照、逐詞流式高亮」,大幅降低國際商務溝通中的信任成本。
3. 長上下文語境消歧(Long-Context Disambiguation)
傳統即時翻譯模型最大的笑話,往往出現在代名詞與專有名詞上:
- 前文剛說「Dr. Sarah Chen is presenting her research...」,後半句出現「She said...」,因為句子被切斷,傳統翻譯模型往往翻譯成「他說」或丟失性別;
- 又例如科技公司的特定專案代號(如 Project Titan、Bailian)或專業醫學術語,切片模型往往會直譯成字面意思(如「泰坦專案」、「白蓮」)。 Qwen3.8-LiveTranslate 維護了一個高效的對話歷史狀態快取,能將前幾分鐘建立的實體知識圖譜(Entity Knowledge)持續注入當前的即時推論中,使術語與人名保持高度一致。
六、語言支援與模態矩陣:覆蓋 60 種全球主流語言
Qwen3.8-LiveTranslate 在語言版圖上延續了阿里生態的全球化佈局,總計支援 60 種語言 的跨語言互譯能力,並在輸出端區分為兩種模態層級:
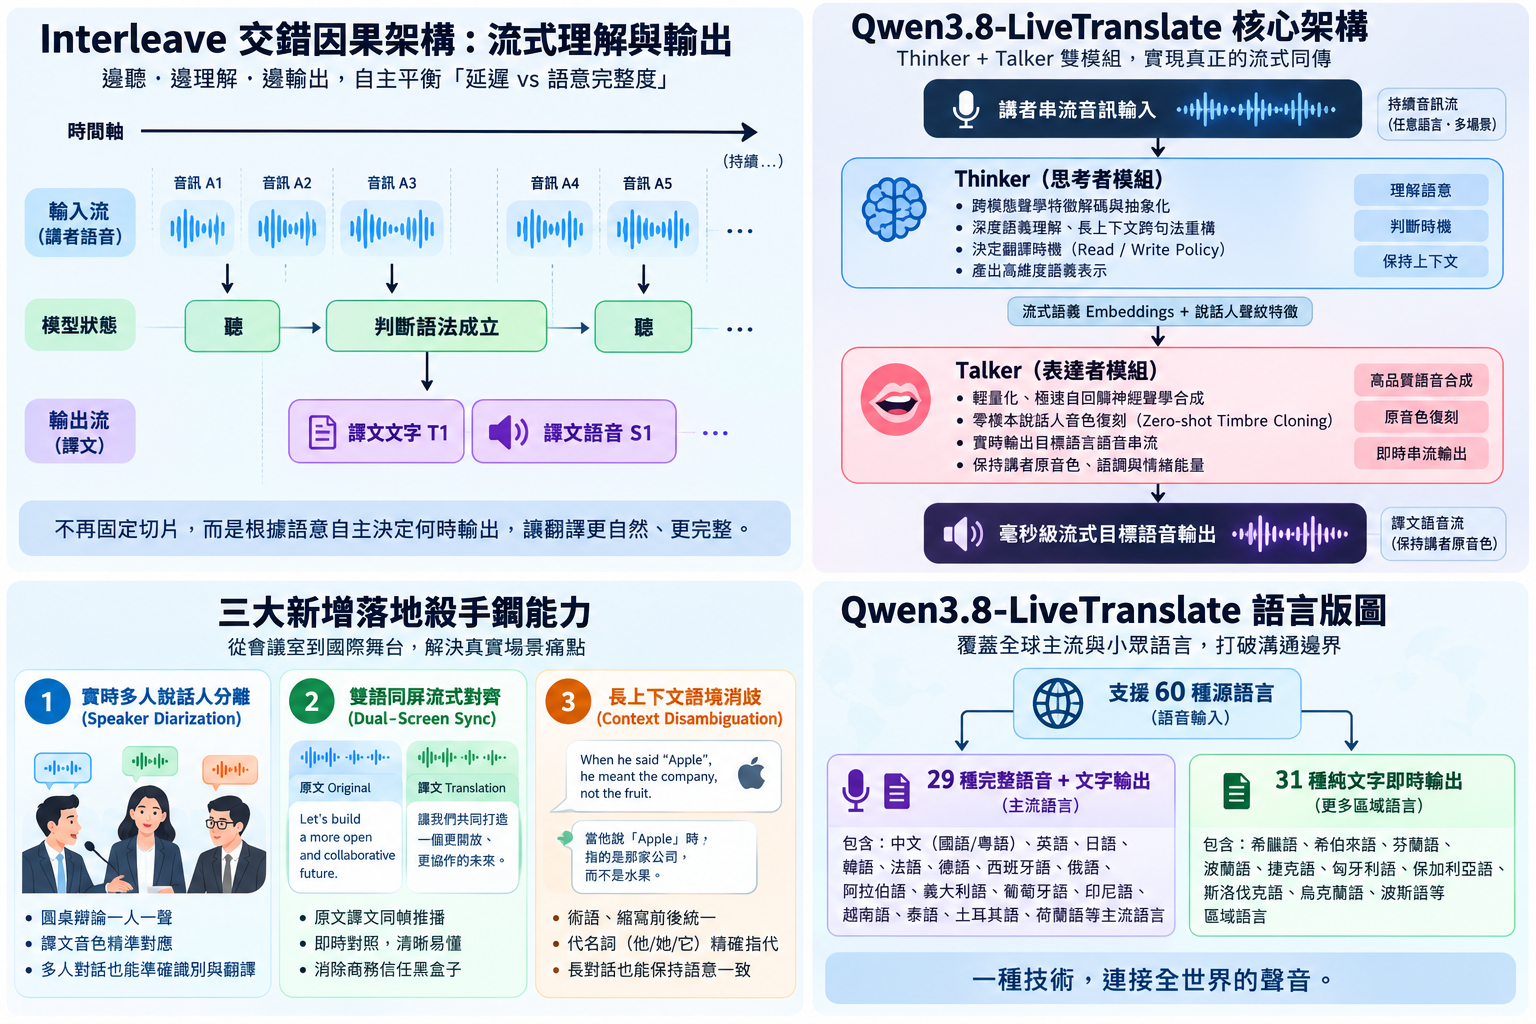
對於全球化出海企業而言,29 種語音雙向支援已經涵蓋了全球超過 92% 的跨國貿易與商務對話場景,特別是東南亞(泰語、越南語、印尼語)與中東(阿拉伯語)市場的覆蓋,具備極高的實用價值。
七、開發者指南:WebSocket API 架構與生產環境部署
Qwen3.8-LiveTranslate 目前已正式上架至**阿里云百煉(Model Studio / Bailian)**平台,API 模型名稱為 qwen3.8-livetranslate-flash-realtime。
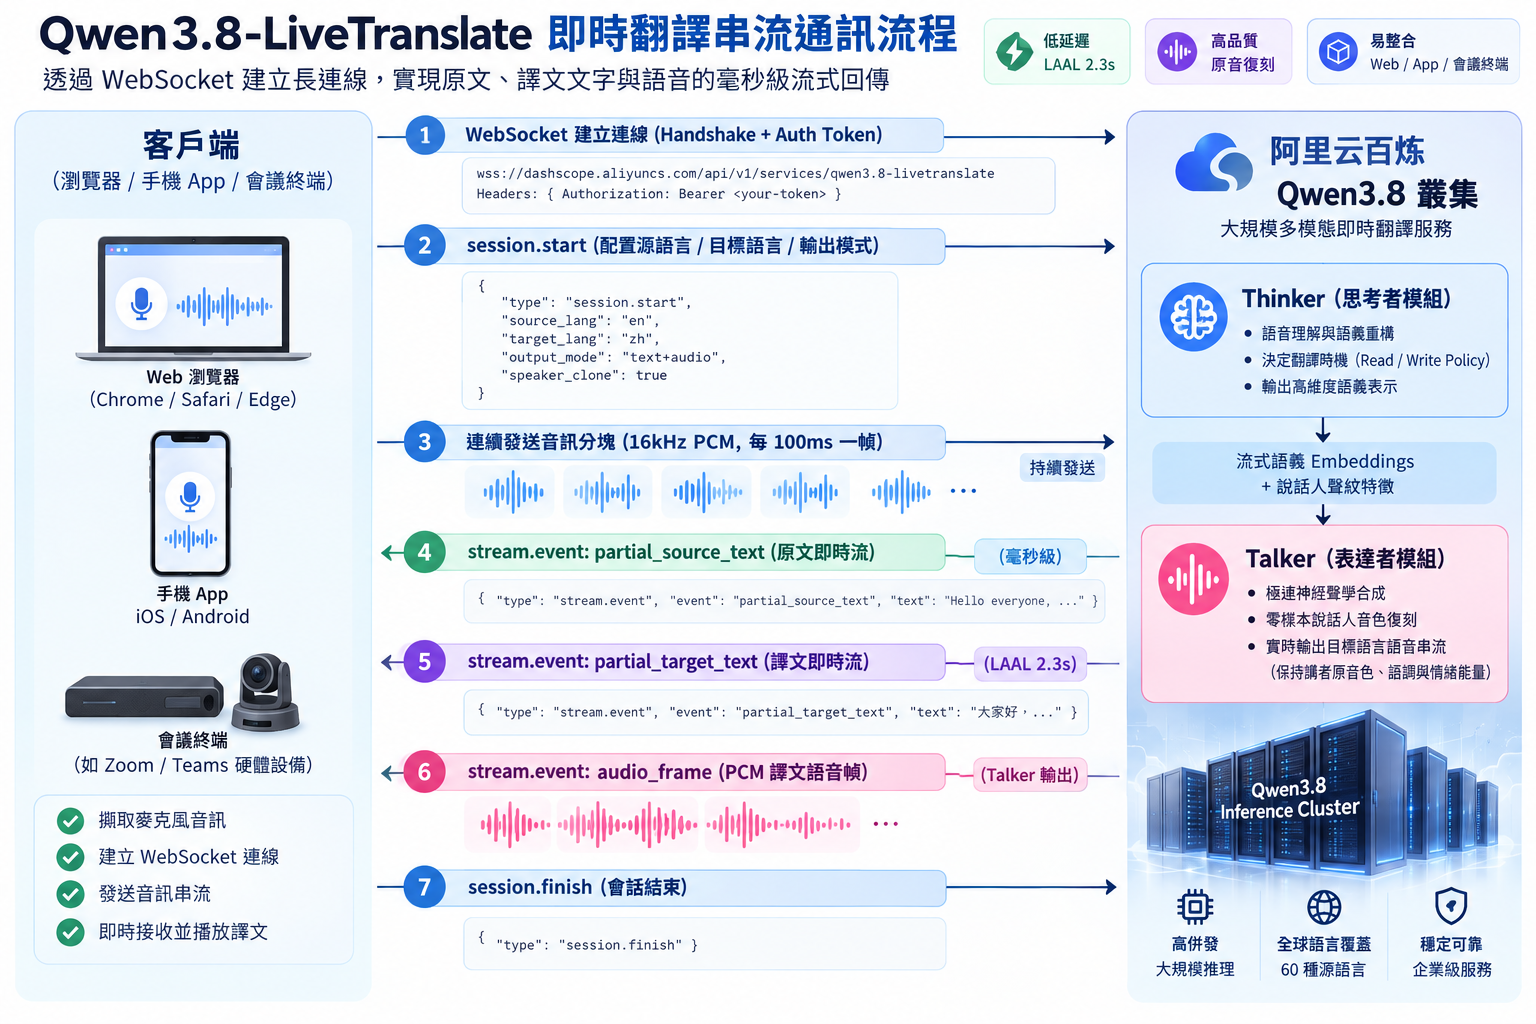
該模型採用標準全雙工 WebSocket 協議進行雙向串流通訊。
1. 雙向資料傳輸流程圖解
2. 生產環境 Python 串接範例骨架
以下是使用 Python websockets 函式庫串接 qwen3.8-livetranslate-flash-realtime 的標準核心流程:
import asyncio
import json
import websockets

BAILIAN_WS_URL = "wss://dashscope.aliyuncs.com/api-ws/v1/inference/"
API_KEY = "YOUR_BAILIAN_API_KEY"

async def live_translate_session(audio_stream_generator):
    headers = {
        "Authorization": f"Bearer {API_KEY}",
        "X-DashScope-DataInspection": "enable"
    }

    async with websockets.connect(BAILIAN_WS_URL, extra_headers=headers) as ws:
        # 1. 發送會話初始化配置
        init_payload = {
            "header": {
                "action": "run-task",
                "task_id": "qwen-live-session-001"
            },
            "payload": {
                "model": "qwen3.8-livetranslate-flash-realtime",
                "parameters": {
                    "source_language": "zh",      # 源語言:中文
                    "target_language": "en",      # 目標語言:英語
                    "output_modalities": ["text", "audio"], # 雙語文字 + 語音
                    "voice_clone": True,          # 啟用講者音色復刻
                    "enable_diarization": True    # 啟用多人說話人分離
                }
            }
        }
        await ws.send(json.dumps(init_payload))

        # 2. 定義接收協程:接收原文、譯文與語音幀
        async def receive_worker():
            async for message in ws:
                data = json.loads(message)
                event_type = data.get("header", {}).get("event")

                if event_type == "result-generated":
                    payload = data.get("payload", {})
                    # 雙語同步字幕
                    src_text = payload.get("source_text", "")
                    tgt_text = payload.get("target_text", "")
                    speaker_id = payload.get("speaker_id", "0")
                    if tgt_text:
                        print(f"[{speaker_id}] 譯文: {tgt_text}")

                elif event_type == "audio-generated":
                    # 目標語音 PCM 數據(音色復刻)
                    audio_chunk = data.get("payload", {}).get("audio_data")
                    # 直接送入本地揚聲器或音訊傳輸隊列

                elif event_type == "task-finished":
                    print("傳譯會話正常結束")
                    break

        # 3. 定義發送協程:以 100ms 為間隔流式推送麥克風採樣
        async def send_worker():
            async for chunk in audio_stream_generator:
                await ws.send(chunk)
            # 發送結束標記
            await ws.send(json.dumps({"header": {"action": "finish-task"}}))

        # 雙向並行執行
        await asyncio.gather(receive_worker(), send_worker())
八、全球即時語音三巨頭橫評:Qwen、OpenAI 與 Google 的路線大對決
2026 年 9 月的這三場發布,宣告了 AI 語音正式進入「三國鼎立」的全新時代。但深入觀察會發現,三家科技巨頭的架構哲學與核心戰略完全不同:
| 維度 / 模型 | 阿里 Qwen3.8-LiveTranslate | OpenAI GPT-Live-1 | Google Gemini 3.8 Live |
|---|---|---|---|
| 發布時間 | 2026 年 9 月 19 日 | 2026 年 9 月 10 日 | 2026 年 9 月 15 日 |
| 核心定位 | 專業同聲傳譯與跨語言流式翻譯 | 通用對話式語音 Agent 前端 | 全能多模態邊想邊聊與工具調用 |
| 架構本質 | Interleave 因果交錯序列 + Thinker–Talker | 解耦式語音層 + Agent Harness 後端 | 原生雙工多模態 + Extended Thinking |
| 延遲表現 | LAAL 2.3 秒(同傳黃金反應區) | 交互延遲 150~250ms(非同傳對話) | 語音回應延遲 ~300ms |
| 說話人處理 | 原生多說話人分離 + 各自音色復刻 | 單一用戶即時傾聽打斷(Backchanneling) | 單一用戶無縫語言切換(97 國) |
| 字幕對齊 | 雙語同屏同幀毫秒級對齊 | 僅輸出助手回覆文字 | 雙向對話文字記錄 |
| 語言深度 | 60 國語言,針對跨語言語法重構優化 | 主要針對主流語言口語流暢對話優化 | 97 國語言自由切換,語義理解強 |
| 商業殺手場景 | 跨國會議、海外直播、商務談判、跨境電商 | 電話客服、語言學習教練、智慧穿戴設備 | 金融分析、複雜任務代理、多步驟研究助理 |
核心戰略解讀:
- OpenAI 走的是「分層委派路線」:前端用極低成本的 GPT-Live-1 專注於伺候好使用者的耳朵與嘴巴,有髒活累活再丟給後端的 GPT-6 Astra;
- Google 走的是「全能巨獸路線」:依託 TPU 算力優勢,將 Extended Thinking 深度思考融入語音,主打「又聰明又會說」;
- 阿里通義千問 則採取了極其老練的「垂直場景降維打擊」:同聲傳譯是企業出海與全球貿易最願意掏錢買單的剛需。阿里直接將 Interleave 架構押注在同傳上,用 2.3 秒延遲與多人音色復刻,建立起極難被一般語音助理取代的專業護城河。
九、總結:同傳流水線的終結,與因果語音時代的黎明
回顧機器翻譯的發展史: 從最早的規則庫,到統計機器翻譯(SMT),再到 Transformer 掀起的神經機器翻譯(NMT),人類在「文字對文字」的翻譯上早已跨過基準線。 然而,在最具挑戰性的「語音對語音即時同傳」上,過去十幾年我們始終停留在「把 STT、MT、TTS 拿膠水黏在一起」的拼裝玩具時代。
Qwen3.8-LiveTranslate 的誕生,正式宣告了「拼裝同傳流水線(Cascade Pipeline)」的終結。
透過 Interleave 交錯因果架構,AI 第一次學會像人類同傳大師一樣,將聽覺認知、語意拆解、時機決策與聲帶發音,融合成一條行雲流水的思維洪流;而 2.3 秒的 LAAL 突破,更意味著人工智慧正式踏入了人類語言轉換的生理極限區間。
對於全球企業與開發者而言,跨國溝通的門檻正在被這場技術巨浪徹底抹平。當未來每一場跨國視訊會議、每一次海外商務談判,耳機裡都能毫秒級傳來對方母語音色的即時翻譯時,我們所處的世界,已經迎來了真正的「巴別塔倒塌時刻」。
FAQ:關於 Qwen3.8-LiveTranslate 的常見疑問
Q1:Qwen3.8-LiveTranslate 與一般的語音對話大模型有何不同?
語音對話模型(如 ChatGPT Voice 或 Gemini Live)是交替發言(Turn-taking)——你說完一段,模型回答一段。而 Qwen3.8-LiveTranslate 是即時同聲傳譯(Simultaneous Translation)——在講者滔滔不絕說話的同時,模型不中斷地以 2.3 秒的微小耳音差同步產出譯文語音,兩者在架構設計、上下文流動機制與延遲優化上有本質差異。
Q2:什麼是 LAAL(Length-Adaptive Average Lagging)?為什麼不只看延遲毫秒數?
即時同傳不能只看單純的網絡往返時間(RTT)。講者說一句話需要時間,如果模型太早開口,往往因資訊不足而翻譯錯誤;太晚開口,又會導致聽眾體驗滯後。LAAL 是專門評估同傳「落後講者進度平均秒數」的嚴謹數學指標,2.3 秒意味著模型能緊咬講者節奏,兼顧語法完整與即時性。
Q3:模型如何做到在翻譯語音中保留原說話人的音色?
Qwen3.8-LiveTranslate 採用 Thinker–Talker 雙模設計。在 Thinker 提取語意的同時,會同步抽取原講者的聲紋特徵向量(Speaker Embedding)並即時傳遞給 Talker 解碼器。Talker 在合成目標語言音訊時,會以該聲紋特徵進行聲學渲染,達到零樣本(Zero-shot)音色復刻。
Q4:多人同時發言時,模型如何處理?
模型內建即時說話人分離(Diarization)模組,能在音訊頻譜中識別不同聲音特徵並劃分發言軌道。輸出時會在原文字幕、譯文字幕與合成語音中分開標記並套用不同的音色,避免發言混淆。
Q5:開發者現在可以在哪裡接入該模型?
該模型已正式在阿里云百煉(Model Studio)平台上線,模型標識符為 qwen3.8-livetranslate-flash-realtime。開發者可以透過申請百煉 API Key,使用標準 WebSocket 協議進行流式雙向通訊接入。