Jev 模型是什麼?新手完整教學:3 種判斷類型、程式實作、適合場景與限制
從客服分流範例看懂 Jev 的 Choice、Score、Noul,完成第一次 API 呼叫,並學會正確解讀 confidence、官方效能數字與產品限制。
如果你要 AI 寫信、整理報告或陪你聊天,Jev 不適合。當你的程式只需要判斷「這張客服單該交給哪個部門」「這段內容風險多高」「這位客戶是否要求退款」,才是 Jev 想解決的問題。
Jev 是 TypeSafe AI 推出的第一款 System One Model。這個名稱借用「快速、直覺判斷」的概念:它不產生自由文字,而是從開發者事先定義的答案中選擇,並回傳機率。換句話說,Jev 比較像一個能看懂語意的 if 判斷,而不是另一個 ChatGPT。
這篇文章會先解釋 Jev 與一般大型語言模型有何不同,再用客服分流範例帶你認識 Choice、Score、Noul 三種題型,最後完成第一個 API 呼叫。你也會看到官方速度與成本數字該怎麼讀,以及哪些工作不該交給 Jev。
Jev 是什麼?先把它想成「會看語意的判斷函式」
一般大型語言模型(LLM)會逐字產生文字。這讓它可以寫文章、回答開放式問題,也代表輸出可能多一句解釋、少一個欄位,甚至產生程式沒有預期的答案。
Jev 採用不同介面。開發者先提供一份 state,也就是要判斷的文字或 JSON 資料,再列出問題與允許的答案。模型只回傳固定型別的結果與機率,不會寫出一段文章。
例如,客服訊息是:「我改完密碼後無法登入,重設信也一直沒收到。」你可以要求 Jev 從 account、billing、technical、other 四個選項中選一個。程式拿到 account 後,就能直接把工單送往帳號支援隊伍,不必再從一段自然語言裡挖出關鍵字。
| 比較項目 | 一般 LLM | Jev |
|---|---|---|
| 主要工作 | 對話、寫作、解題、產生程式碼 | 分類、評分、是非判斷 |
| 輸出 | 自由文字或結構化文字 | 預先定義的固定型別 |
| 適合開放式問題 | 是 | 否 |
| 可直接接程式分支 | 需要解析與驗證 | 是 |
| 能否寫回覆給客戶 | 可以 | 不行 |
| 不確定性 | 可要求模型描述,但不一定校準 | 回傳選項機率,Choice、Score 另有 confidence |
真正的差別不在於「Jev 比所有 LLM 更聰明」。它主動放棄寫作能力,換取更窄、更容易被軟體消化的輸出。需要創作與推理時仍要用 LLM。需要大量、快速、固定格式的語意判斷時,才輪到 Jev。
TypeSafe AI 為什麼要做一個不會聊天的模型?
TypeSafe AI 創辦人 Diogo Almeida 曾參與讓語言模型更能遵循人類指令的研究。2026 年 9 月,公司走出隱身模式並推出 Jev,同時宣布由 DCVC 領投的 4,000 萬美元種子輪融資。
公司的核心判斷是:聊天介面方便人類,但自由文字不一定是軟體之間最可靠的介面。客服分流、內容審核、履歷篩選與風險評級等工作,通常不需要漂亮文章,只需要程式可以立即採用的選項、分數與機率。
TypeSafe 稱這類模型為 System One Model,並用 Reinforcement Learning for Calibrated Decisions(RLCD,校準決策強化學習)訓練模型。白話來說,訓練目標放在讓預測機率盡可能反映實際把握程度,不追求人類最喜歡的文字回答。
After co-inventing ChatGPT, I kept asking myself: why have superhuman chat models not led to AGI?
— Diogo Almeida (@CompleteSkeptic) September 15, 2026
I’ve spent the last 2 years in stealth building a new way to train models (RLCD), and a new type of frontier AI model that we are releasing today: Jev
• 20-200x faster
• 40-400x… pic.twitter.com/JSybNG2BKJ
這仍是一家剛公開產品的新公司。RLCD 的完整技術細節、第三方大規模驗證與長期生產表現,目前都不如成熟 LLM 生態完整。現階段比較合理的態度,是把 Jev 當成值得測試的新型決策元件,而不是已經證明能取代既有 AI 系統的通用解答。
Jev 的 3 種題型:Choice、Score 與 Noul
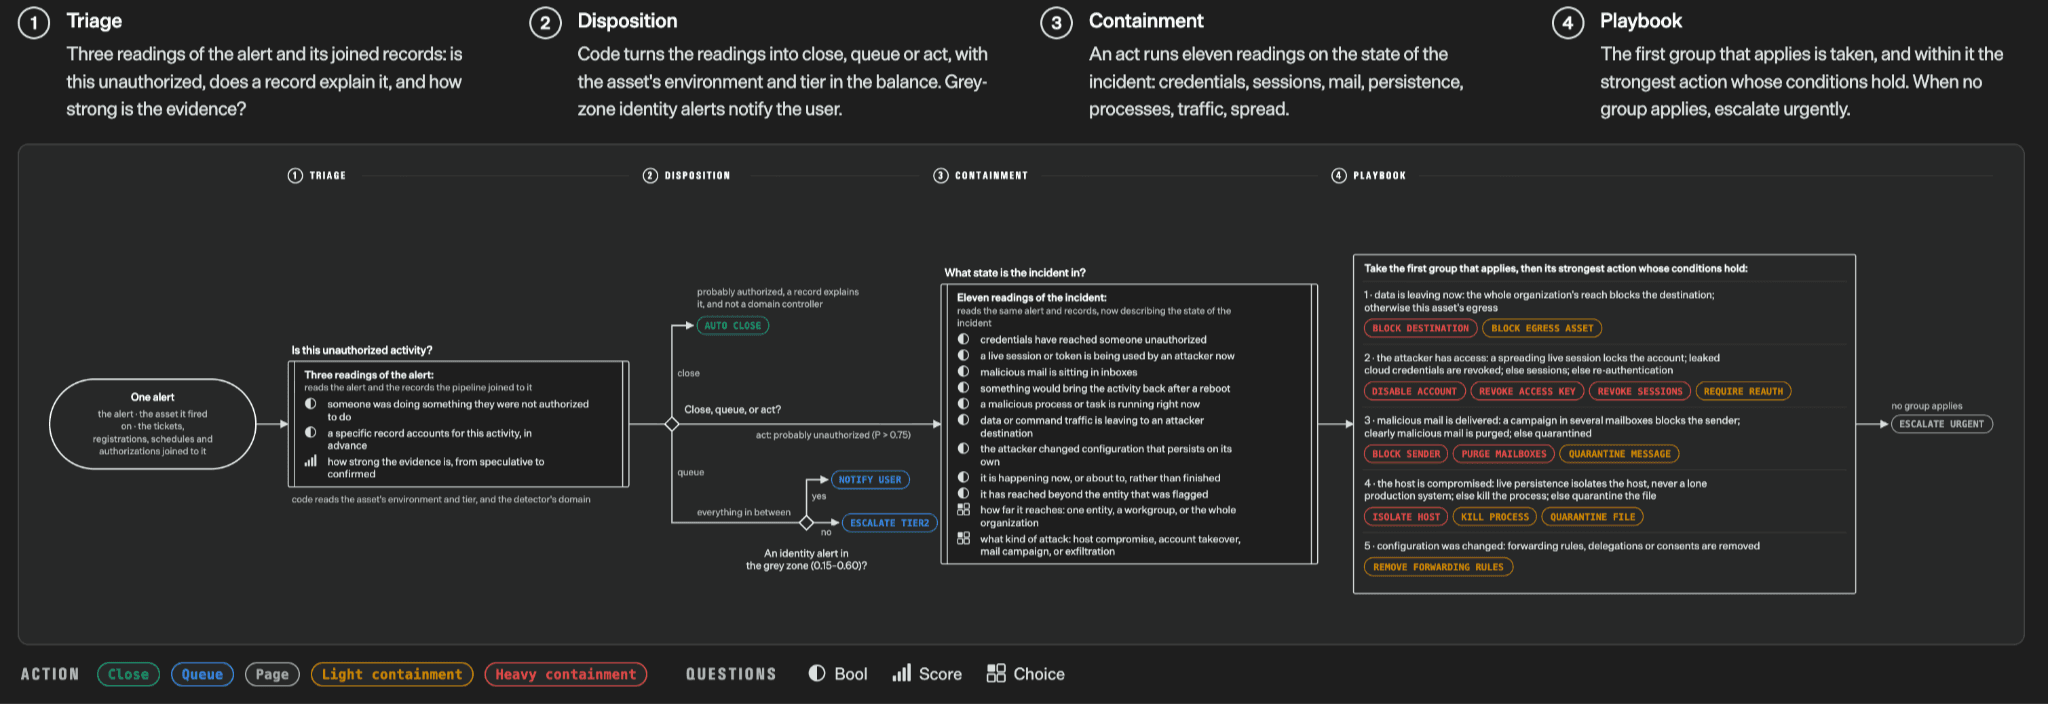
Jev 每次會讀取同一份 state,再回答一個或多個彼此獨立的問題。官方提供三種基礎題型。
Choice:從固定選項中選一個
Choice 適合沒有先後順序的分類,例如客服部門、文件類型或程式語言。它會回傳選中的答案、每個選項的機率,以及彙整後的 confidence。
如果選項不一定涵蓋所有情況,應加入 other 或 none_of_the_above。否則模型即使遇到不合適的輸入,也只能被迫從錯誤選項中挑一個。
Score:沿著一把有明確刻度的尺評分
Score 適合有順序的程度判斷,例如客戶情緒、錯誤嚴重度或候選人經驗。每一級都要用具體情境描述,不要只寫「低、中、高」。
例如,錯誤嚴重度可以定義成「只影響外觀」「主要功能失效但有替代方式」「核心流程完全無法使用」。模型可能回傳 1.3,代表結果主要靠近第二級,也有一部分機率落在第三級。
Noul:判斷一件事為真的機率
Noul 是 TypeSafe 對是非題的名稱。它回傳 0 到 1 的 noul 值,代表「答案為是」的機率。接近 1 表示強烈偏向是,接近 0 表示強烈偏向否,接近 0.5 則代表難以判斷。
Noul 沒有另一個 confidence 欄位,因為它本身的數值已經是一個二元事件的機率。不要把 0.5 解讀成「中等程度」。若要衡量程度,應改用 Score。
| 題型 | 最適合問 | 主要回傳值 |
|---|---|---|
| Choice | 哪一個? | 選項、各選項機率、confidence |
| Score | 程度落在哪一級? | 分數、各級機率、confidence |
| Noul | 這件事是真的嗎? | 為真的機率 |
Jev 新手教學:用客服分流完成第一次 API 呼叫
最簡單的開始方式,是登入 TypeSafe Playground,把客服訊息貼進 state,再加入一個 Noul 問題。若要接進自己的程式,可以使用 HTTP API 或 Python SDK。TypeSafe 官方文件顯示,Python SDK 需要 Python 3.10 以上。
步驟一:取得 API key
登入 TypeSafe Console,在控制台建立 API key。TypeSafe 仍處於早期開放階段,帳號是否立即取得額度,以控制台顯示為準。
把金鑰放進環境變數,不要直接寫進程式碼或上傳到 GitHub:
export TYPESAFE_API_KEY="你的_API_KEY"
步驟二:先用 cURL 看懂請求結構
下面範例把一則客服訊息同時交給三種題型。state 是模型要看的材料,questions 則是希望它做的判斷。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
{
  "model": "jev-latest",
  "state": "I changed my password and now I cannot log in. The reset email never arrives, and I need access today.",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this request?",
      "criteria": {
        "account": "Login, password, profile, or security issues",
        "billing": "Charges, invoices, refunds, or subscriptions",
        "technical": "Product bugs, outages, or integrations",
        "other": "Requests that do not fit the other categories"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated does the customer appear?",
      "criteria": [
        "Calm and only stating facts",
        "Concerned but still civil",
        "Very angry or using strong language"
      ]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "Does the message express urgency or time sensitivity?"
    }
  }
}
EOF
官方快速入門範例的回傳會包含 answers 與 usage。程式應讀取 department.choice 決定路由,讀取 department.confidence 判斷是否能自動處理,再用 is_urgent.noul 決定是否提高優先順序。
步驟三:用 Python SDK 接進程式
先安裝 SDK:
pip install typesafe-sdk
接著建立同一組問題:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "I changed my password and now I cannot log in. "
    "The reset email never arrives, and I need access today."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "department": Choice(
                instructions="Which team should handle this request?",
                criteria={
                    "account": "Login, password, profile, or security issues",
                    "billing": "Charges, invoices, refunds, or subscriptions",
                    "technical": "Product bugs, outages, or integrations",
                    "other": "Anything outside the other categories",
                },
            ),
            "frustration": Score(
                instructions="How frustrated does the customer appear?",
                criteria=[
                    "Calm and only stating facts",
                    "Concerned but still civil",
                    "Very angry or using strong language",
                ],
            ),
            "is_urgent": Noul(
                instructions="Does the message express urgency or time sensitivity?"
            ),
        },
    )

department = response.answers["department"]
urgent_probability = response.answers["is_urgent"].noul

if department.confidence < 0.60:
    route = "human_review"
else:
    route = department.choice

print(route, urgent_probability)
這段程式最重要的是最後的路由規則。呼叫 API 只會取得判斷,真正要不要自動執行,仍由你的程式決定。
confidence 不是正確率保證:門檻要依風險設定
Choice 與 Score 的 confidence 是從答案的機率分布計算而來。某個選項明顯領先其他選項時,confidence 會較高。多個選項勢均力敵時,confidence 會降低。
這個數字可用來建立三段式流程:
- 高把握、低風險的案件自動處理。
- 中間區間要求使用者確認或補充資料。
- 低把握案件轉人工或交給較強的推理模型。
但門檻不能直接從官方範例照抄。把客服單送錯部門通常可以修正,門檻可以較低。核准退款、封鎖帳號或拒絕求職者的代價更高,就需要更嚴格的人工覆核。正確做法是用自己的歷史資料測試不同門檻下的準確率、漏判率與人工量,再決定正式規則。
Jev 真的快 193.6 倍、便宜 444.6 倍嗎?
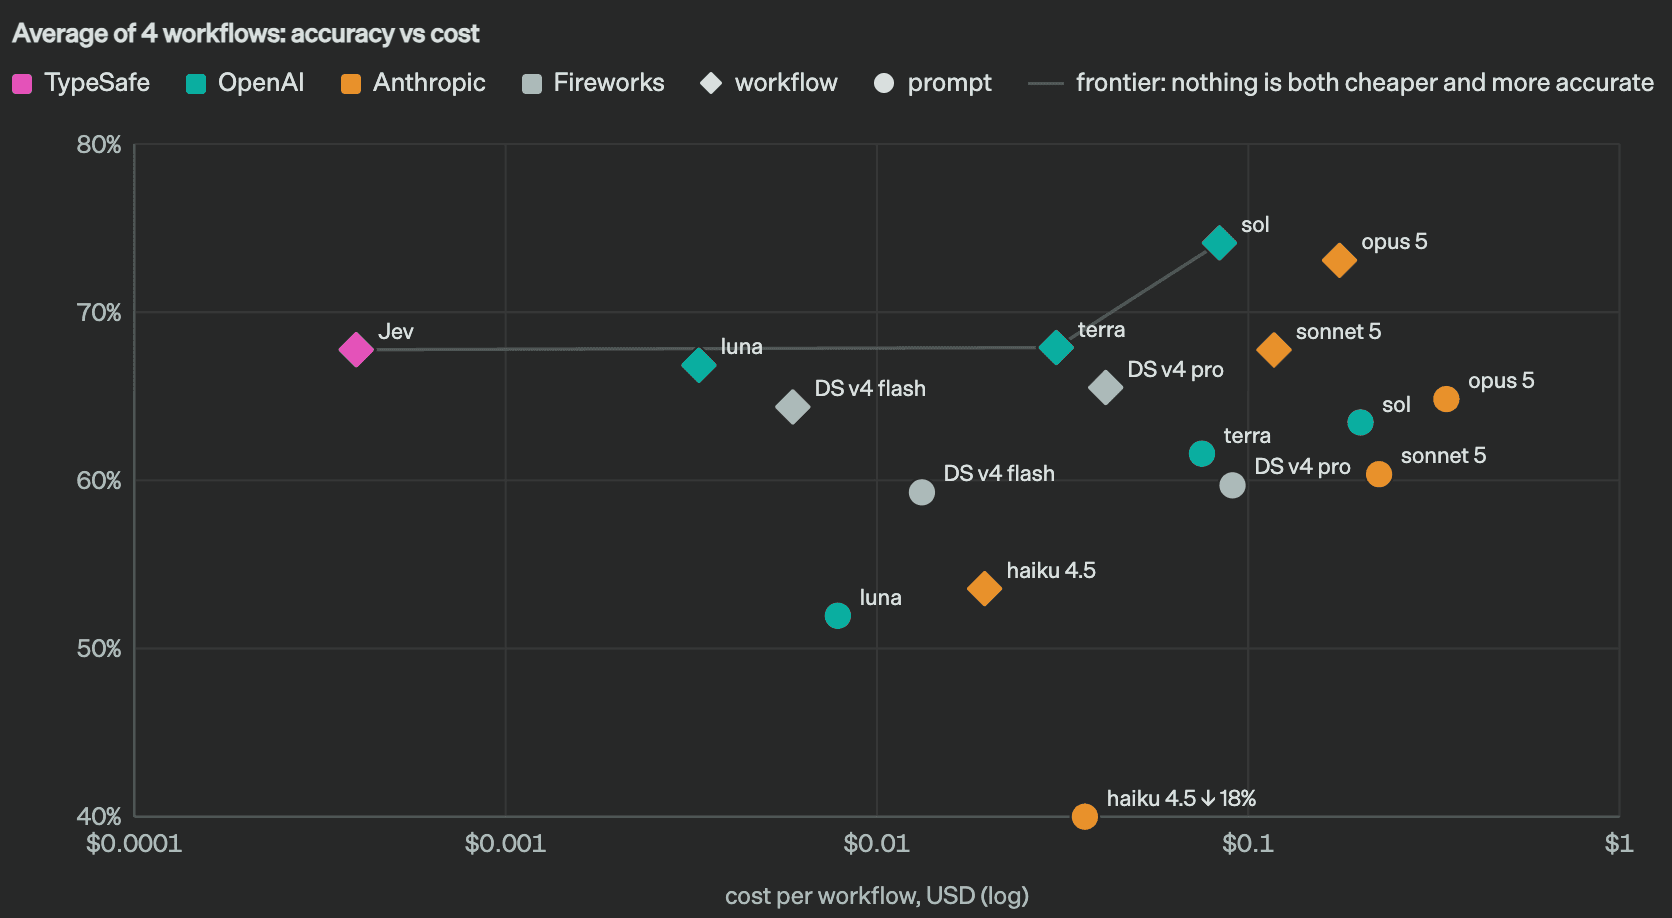
TypeSafe 官網列出 Jev 在自家 workflow eval 中達到 193.6 倍速度、444.6 倍成本優勢。官方部落格則用較寬的範圍描述為約 40 至 200 倍更快。Jev 1.13 的定價是每百萬輸入 token 0.042 美元,輸出 token 不另計費,官方列出的端到端延遲範圍為 70 至 500 毫秒。
這些數字不能解讀成 Jev 在任何任務都比大型語言模型快 193.6 倍。TypeSafe 自己說明,這組 workflow eval 是由內部能力團隊製作,可能存在偏差,而且官網的倍數屬於較高端的實際增益。更重要的是,Jev 與 LLM 提供的能力不同:一個只做固定型別判斷,另一個可以生成文字與進行長鏈推理。
The gains aren’t free: Jev can't generate text
— Diogo Almeida (@CompleteSkeptic) September 15, 2026
Comparing Jev vs LLMs side-by-side makes the trade-off clear
Fun fact: replacing sequential computation with parallel is the same way Transformers leapfrogged RNNs pic.twitter.com/ockGnenCPP
TypeSafe 官方模型競速示範,畫面比較 Jev 與多個大型語言模型在固定工作流中的執行方式與時間。這是官方設定下的產品展示,不能推論所有任務都會得到相同倍數。影片來源:TypeSafe AI 官方部落格。
因此,速度與成本數字最適合拿來形成測試假設,不能直接寫入採購效益。若你的工作是大批文字分類、同一份資料同時回答許多獨立問題,Jev 的架構優勢可能明顯。若任務需要搜尋、計算、寫作或多步推理,再便宜也無法代替 LLM。
「零幻覺」不等於「不會判斷錯」
TypeSafe 強調 Jev 不會產生型別錯誤。這項保證的範圍是:若你要求模型從 account、billing、technical、other 中選一個,它不會突然回傳第五個不存在的部門,也不會夾帶一段自由文字讓程式無法解析。
但固定格式仍可能裝著錯誤答案。模型可能把帳號問題誤判成技術問題,也可能對模糊資料給出過高機率。官方首頁使用「Zero Hallucinations」描述產品,技術文章則把這項主張連結到 schema matching,也就是輸出一定符合預設結構。對實務系統來說,最安全的理解是「零型別幻覺」,不是「零語意錯誤」。
Jev 也有幾項明確限制:
- 目前只接受文字。圖片、音訊與影片要先轉成文字或結構化欄位。
- 英文是主要訓練語言。官方表示中文等 CJK 文字可以使用,但準確度較低,必須用自己的中文資料驗證。
- Jev 1.13 的
state加上最長問題有 32K token 限制,整個請求的總預算為 64K token。 jev-latest會隨新版本更新。已調整好門檻的正式系統,應固定版本 ID 並記錄每次回應的模型版本。- 官方表示一般客戶請求不會用來訓練 Jev,但企業級零資料保留仍應依合約與資料處理協議確認。
哪些工作適合 Jev?哪些工作仍要交給 LLM?
Jev 最適合答案空間可以事先定義、單次判斷不需要長篇推理,而且呼叫量很大的工作。
| 工作 | Jev 是否適合 | 原因 |
|---|---|---|
| 客服分流與優先級 | 適合 | 部門與等級可預先定義 |
| 內容風險分類 | 適合,但高風險案件要人工覆核 | 可拆成辱罵、詐騙、個資等小問題 |
| 履歷是否符合明確條件 | 可用於初步輔助 | 就業決策有偏誤與合規風險,不能全自動淘汰 |
| 檢查另一個 AI 的引用是否受原文支持 | 適合 | 可以把原文與主張一起放進 state |
| 撰寫客服回覆 | 不適合 | Jev 不生成文字 |
| 複雜數學、研究或多步規劃 | 不適合 | 需要慢速推理與工具使用 |
| 圖片或語音直接辨識 | 目前不適合 | 只接受文字輸入 |
更實用的架構通常會讓兩者分工。Jev 負責快速分類、打分與判斷是否要升級,LLM 負責處理真正需要解釋、生成或深入推理的少數案件。
社群已經開始把 Jev 放進遊戲與代理工作流。例如一個 Doom 實驗讓 Jev 選擇動作,再由 LLM 回顧結果並規劃下一輪。這類影片很適合理解「快速決策模型+慢速推理模型」的分工,但它是社群原型,不是生產可靠性的證明。
i got jev + an llm playing doom, with a twist: try several futures, then keep playing from the best outcome.
— toks (@toksdotdev) September 18, 2026
jev picks the moves. a custom harness uses @microsandbox to run attempts in parallel from the same checkpoint. the llm reviews what happened and guides what to try next.… pic.twitter.com/YvLTYDXSUP
新手最容易踩的 5 個坑
1. 把大問題整包丟給模型
「這位客戶要怎麼處理?」包含分類、情緒、退款資格與風險等不同判斷。應拆成多個小問題,再由程式組合答案。
2. 選項沒有 other
若分類永遠可能出現例外,卻沒有其他選項,模型只會在錯誤答案中選一個。先設計答案空間,再談模型準確率。
3. 把模糊形容詞當評分標準
「低、中、高」對不同人意思不同。改成可觀察的情境,例如「不影響使用」「主要功能失效但可繞過」「核心流程完全中斷」。
4. 一開始就讓模型做不可逆動作
先讓系統只做標記、排序或建議。等離線測試與人工覆核證明門檻合理,再逐步開放低風險自動化。
5. 直接用英文成果推估中文準確度
官方已明說英文效果最佳。台灣團隊應準備真實繁體中文樣本,分別測試正式、口語、錯字與中英混雜內容,而不是只跑幾個乾淨範例。
FAQ:Jev 模型常見問題
Jev 可以像 ChatGPT 一樣聊天嗎?
不行。Jev 不產生自由文字,只回傳固定型別的選項、分數與機率。若產品需要對使用者說明原因或撰寫回覆,仍要搭配 LLM 或固定模板。
Jev 與一般 LLM 的 JSON mode 有什麼不同?
JSON mode 或 structured outputs 仍是語言模型產生結構化文字。Jev 從模型介面開始就只做固定答案空間內的判斷,不逐字生成內容。兩者都能讓程式取得結構化資料,但能力範圍、速度、成本與錯誤模式不同。
Jev 的 Choice、Score、Noul 該怎麼選?
從多個無順序類別選一個,用 Choice。衡量有順序的程度,用 Score。判斷一件事為真的機率,用 Noul。若你想問「Python 能力是中等嗎」,先把「能力」拆成有明確描述的 Score 級別,通常比模糊的是非題更好。
Jev 支援中文嗎?
支援文字輸入,也能處理 CJK 字元,但官方表示英文準確度最佳,其他語言並非同等表現。中文正式導入前,需要用自己的資料集測試,並保留人工覆核路徑。
Jev 會出錯嗎?
會。它可以保證輸出符合預設型別,不能保證每次語意判斷都正確。機率與 confidence 是路由訊號,不是正確率保證。
Jev 現在的價格是多少?
截至 2026 年 9 月 19 日,官方文件列出的 Jev 1.13 價格為每百萬輸入 token 0.042 美元,輸出 token 不另計費。價格與速率限制可能調整,實際使用仍應以控制台與最新官方文件為準。
結語:Jev 的位置,是 AI 工作流裡的新零件
Jev 最值得注意的地方,並非它會不會「打敗 LLM」。它把 AI 的用途從產生內容縮小成一個可以放進程式流程的判斷元件。
如果你只是想體驗,先從 Playground 的客服分類開始。如果你準備做產品,先挑一個答案空間明確、錯誤可恢復的任務,建立自己的測試集與人工覆核門檻。等這一小段流程可靠,再擴大自動化範圍。
這也決定了現階段對 Jev 最合理的判斷:它很可能替大量分類、評分與守門工作降低延遲和成本,但官方效能倍數仍需要更多獨立驗證,高風險決策也不能因為輸出格式穩定就跳過人工責任。